GPT-Realtime-2 API-Tutorial: Drei Tests, drei Urteile
Lerne, wie sich OpenAIs gpt-realtime-2, gpt-realtime-translate und gpt-realtime-whisper unterscheiden, und teste jedes Modell mit funktionierendem Python-WebSocket-Code.
Unser Überblicksartikel zu GPT-Realtime-2 behandelte den Launch, die Benchmark-Aussagen und warum OpenAI Echtzeit-Sprachfunktionen auf eine kleine Modellfamilie aufgeteilt hat. Dieses Tutorial setzt dort an, wo der Artikel aufgehört hat: Verbindung zur API, Audio senden und sehen, was sich im Code ändert.
Die Aufteilung ist in der Praxis wichtig. Test 1 nutzt gpt-realtime-whisper für Transkription, Test 2 nutzt gpt-realtime-translate für Live-Übersetzung, und Test 3 nutzt gpt-realtime-2 für einen Sprachassistenten. Das Hauptmodell kann auch einfachere Aufgaben wie Übersetzung oder Transkription übernehmen, aber du würdest für mehr Reasoning und Antwortmodi zahlen, die nicht nötig sind – also überdimensioniert.
Einrichtung der GPT-Realtime-2 API in Python
Vor den Tests hilft es, Transport, Authentifizierung und Audioformat zu trennen. Diese Details bleiben in den Beispielen weitgehend gleich. Die Modell-Endpunkte und Ereignisnamen sind das, was sich ändert, wenn der Artikel von Textausgabe zu übersetzter Sprache und dann zu einer vollständigen Sprachschleife wechselt.
Entscheidung zwischen WebRTC und WebSocket
Die OpenAI-Dokumentation gibt eine einfache Regel: Nutze WebRTC für Browser- und Mobile-Clients und WebSockets für serverseitige Anwendungen. WebRTC übernimmt Jitter-Pufferung und Audiotransport. WebSockets sind sinnvoll, wenn das Backend bereits Roh-Audio von einem Telefonieanbieter oder einer Mediapipeline empfängt.
Zwei Transportpfade für die Realtime API. Bild: Autor.
Aus diesem Grund verwenden alle drei Python-Tests WebSockets. Dieser Pfad zeigt die Ereignisnamen direkt, sodass die Modelldifferenzen im Code sichtbar sind. Für einen Browser-Build solltest du flüchtige Client-Secrets nutzen, damit dein API-Schlüssel niemals das Frontend erreicht.
Python-Umgebung und Pakete
Nutze Python 3.9 oder neuer. Der vollständige Code für alle vier Skripte ist unter github.com/KhalidAbdelaty/gpt-realtime-api verfügbar. Klone das Repo zuerst und installiere dann die Abhängigkeiten:
git clone https://github.com/KhalidAbdelaty/gpt-realtime-api.git
cd gpt-realtime-api
pip install websocket-client sounddevice numpy python-dotenvBereitgestellt von
websocket-client steuert den Socket, sounddevice zeichnet Mikrofon-Audio auf, numpy konvertiert den Puffer, und python-dotenv lädt den API-Schlüssel. Unter macOS brauchst du eventuell brew install portaudio, bevor sounddevice funktioniert. Unter Linux installiere portaudio19-dev.
import os
from dotenv import load_dotenv

load_dotenv()
OPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")Bereitgestellt von
Authentifizierung und die WebSocket-URL
Serverseitige Verbindungen nutzen einen Authorization: Bearer-Header beim WebSocket-Handshake. Füge OpenAI-Safety-Identifier hinzu, wenn die App einzelne Nutzer nachverfolgt. Diese Pfade werden in den Tests später verwendet:
# Voice-Agent
wss://api.openai.com/v1/realtime?model=gpt-realtime-2# Translation
wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate
# Transcription
wss://api.openai.com/v1/realtime?intent=transcriptionBereitgestellt von
Dieser Übersetzungspfad ist in Test 2 wichtig, weil es der eine Endpunkt ist, der nicht direkt /v1/realtime nutzt.
Test 1: Echtzeit-Audiotranskription mit GPT-Realtime-Whisper
Transkription ist ein typischer Ort für Overengineering. Wenn die Ausgabe nur Text ist, reicht das Transkriptionsmodell.
Was wir testen
gpt-realtime-whisper nimmt Audio entgegen und gibt Transkript-Deltas aus. Es führt kein Reasoning aus, ruft keine Tools auf und spricht nicht zurück. Dieser kleinere Umfang ist der Grund, warum es nach Audiodauer abgerechnet wird – anders als das Tokenmodell von gpt-realtime-2. Im Kostenabschnitt kommen wir darauf zurück.
Code-Walkthrough
Das Schlüsselfeld ist session.type: "transcription". Das weist die API an, Assistentenantworten zu überspringen und nur Transkript-Events zu senden. Das vollständige Skript behandelt außerdem Mikrofonaufnahme und Threads. Dieser Teil ändert das Realtime-Sitzungsverhalten:
session_config ={"type":"session.update","session":{"type":"transcription","audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":None}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"input_audio_buffer.append","audio": audio_b64
}))
ws.send(json.dumps({"type":"input_audio_buffer.commit"}))Bereitgestellt von
Nutze 24 kHz PCM16 Mono-Audio, base64-codiert. Anders als in der Voice-Agent-Sitzung commitet das Skript den Eingabepuffer manuell per Timer statt server_vad für Turn Detection zu verwenden. Leere Commits werfen input_audio_buffer_commit_empty, daher commitet das vollständige Skript erst nach echtem Audioeingang.
Transkript-Deltas treffen Wort für Wort in Echtzeit ein. Bild: Autor.
Beobachtetes Verhalten
In meinen lokalen Tests erschienen Transkriptergebnisse innerhalb des Commit-Fensters, etwa 3 bis 4 Sekunden nach Beginn der Sprache. Da dieses Setup auf manuelle Commits statt VAD setzt, hängt die Latenz am Commit-Intervall.
Achte außerdem auf die Reihenfolge: Completion-Events aus überlappenden Turns können außer der Reihe eintreffen, deshalb solltest du bei einem UI um den Stream per item_id zusammenführen.
Transkription wird durch periodische manuelle Commits ausgelöst, nicht durch Still-Erkennung. Bild: Autor.
Urteil: Bestanden. Für serverseitige Live-Transkription lieferte gpt-realtime-whisper das, was dieser Test brauchte. Ich würde dennoch mit echten Mikrofonen, Akzenten und Raumgeräuschen testen, bevor ich ein Latenzziel setze.
Test 2: Echtzeit-Übersetzung mit GPT-Realtime-Translate
Live-Sprachübersetzung ähnelt auf den ersten Blick der Transkription, aber der Sitzungszyklus unterscheidet sich. Der Übersetzungsendpunkt entfernt die Assistentenantwortschleife, was das Beispiel kürzer macht.
Was wir testen
Übersetzungssitzungen haben keine Assistenten-Turn-Schleife und kein response.create. Das Modell arbeitet wie ein Live-Dolmetscher, nicht wie ein Konversationsagent. Für Q&A, Tools oder Konversationszustand wechselt der Artikel in Test 3 zu gpt-realtime-2.
Übersetzungssitzungen nutzen einen eigenen, separaten Endpunkt. Bild: Autor.
Das Modell unterstützt über 70 Eingabesprachen und 13 Ausgabesprachen. Du setzt das Ziel mit session.audio.output.language; die Erkennung der Ausgangssprache erfolgt automatisch. Die Grenzen sind klar: kein Custom Prompting, keine Stimmwahl, keine Fachglossare.
Code-Walkthrough
Wie erwähnt, verwendet die Übersetzung die /translations-WebSocket-URL. Zwei weitere Details ändern sich ebenfalls: das Zielfeld session.audio.output.language und der Ereignisname session.input_audio_buffer.append. Beachte das Präfix session.. Übersetzungssitzungen nutzen es hier.
url ="wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate"
session_config ={"type":"session.update","session":{"audio":{"output":{"language":"es"},"input":{"transcription":{"model":"gpt-realtime-whisper"},"noise_reduction":{"type":"near_field"}}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"session.input_audio_buffer.append","audio": audio_b64
}))Bereitgestellt von
Übersetztes Audio kommt über session.output_audio.delta, und die Audio-Bytes stehen in event[\"delta\"], nicht in event[\"audio\"]. Quell- und Übersetzungs-Transkripte kommen getrennt an:
if event_type =="session.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))elif event_type =="session.input_transcript.delta":print("[EN]", event.get("delta",""), end="")elif event_type =="session.output_transcript.delta":print("[ES]", event.get("delta",""), end="")Bereitgestellt von
Ein Randfall: Wenn das Quellaudio bereits in der Zielsprache ist, kann das Modell Stille produzieren statt es durchzureichen.
Beobachtetes Verhalten
Bei kurzen Englisch-Spanisch-Phrasen begann das übersetzte Audio, bevor die Quelläußerung fertig war. Im Terminal waren verschachtelte [EN]- und [ES]-Zeilen zu sehen, während Deltas eintrafen. Entfernt liegende Sprachpaare warten ggf. länger auf Kontext. Ich konnte der übersetzten Stimme gut folgen, aber eigene Stimmwahl ist nicht verfügbar.
Urteil: Bestanden, mit Einschränkung.gpt-realtime-translate funktionierte für direkte Live-Übersetzung. Weniger geeignet ist es, wenn Terminologiekontrolle oder Stimmbranding wichtig sind.
Test 3: Aufbau eines Sprachassistenten mit Turn-Taking und Barge-In
Dies ist der gpt-realtime-2-Test: ein Sprachagent, der zuhört, spricht, Kontext hält und Tools aufrufen kann. Hier wird auch der Client-Code wichtiger, da Wiedergabe und Turn-Zustand aus dem Takt geraten können.
Was wir testen
gpt-realtime-2 ist ein Speech-to-Speech-Reasoning-Modell. Es vermeidet eine separate STT-zu-LLM-zu-TTS-Pipeline, und sein 128K-Kontextfenster gibt längeren Sitzungen mehr Spielraum. Reasoning steuerst du mit reasoning.effort; starte mit low, außer die Aufgabe braucht mehr Reasoning, denn höhere Stufen erhöhen die Latenz.
Code-Walkthrough
Das folgende Setup nutzt semantic_vad, das Sprachhinweise statt nur Stille betrachtet. eagerness steuert, wie schnell das Modell entscheidet, dass der Nutzer fertig ist. Beachte Modellname, Audioausgabesettings, manuelles response.create und den Audio-Ereignisnamen des Assistenten:
session_config ={"type":"session.update","session":{"type":"realtime","model":"gpt-realtime-2","output_modalities":["audio"],"audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":{"type":"semantic_vad","eagerness":"medium","create_response":False,"interrupt_response":True}},"output":{"format":{"type":"audio/pcm","rate":24000},"voice":"marin"}},"instructions":"You are a helpful voice assistant. Keep answers short.","reasoning":{"effort":"low"}}}Bereitgestellt von
Wenn das Nutzertranskript abgeschlossen ist, erstellt der Client die Assistentenantwort. Assistenten-Audio kommt dann als response.output_audio.delta an, nicht als response.audio.delta.
if event_type =="conversation.item.input_audio_transcription.completed":
ws.send(json.dumps({"type":"response.create"}))elif event_type =="response.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))Bereitgestellt von
Barge-In handhaben
Die Unterbrechungssequenz lässt sich leicht falsch machen. Wenn der Nutzer dem Assistenten ins Wort fällt, sendet der Server input_audio_buffer.speech_started. Der Client stoppt die Wiedergabe, merkt sich, wie viel Audio bereits abgespielt wurde, und sendet conversation.item.truncate mit audio_end_ms, um den Cut-off zu markieren. Andernfalls transkribiert der Server weiter Text, den der Nutzer nie gehört hat, und die nächste Runde wirkt daneben.
if current_response_item_id and playback_position_ms >0:
ws.send(json.dumps({"type":"conversation.item.truncate","item_id": current_response_item_id,"content_index":0,"audio_end_ms": playback_position_ms
}))Bereitgestellt von
Ein praktisches Problem mit Laptop-Lautsprechern: Das Mikro kann die Assistentenausgabe aufnehmen und ans Modell zurücksenden. Das Beispielskript nutzt MUTE_MIC_DURING_ASSISTANT = True, um den Eingabestream stummzuschalten, während der Assistent spricht, plus kurze Abkühlzeit. Setze es nur auf False, wenn du Kopfhörer nutzt und Unterbrechungen möchtest.
Trunkierung hält Server und Client synchron. Bild: Autor.
WebRTC und SIP übernehmen mehr von dieser Pufferung. Beim in diesem Tutorial genutzten WebSocket-Pfad liegt sie beim Client. Der Zähler im Beispielskript reicht für eine Demo; Produktionscode sollte Zeitstempel aus dem Audioausgabestream nachverfolgen.
Preambles für Reasoning-Latenz konfigurieren
Wenn reasoning.effort über low liegt, wird Stille hörbar. Kurze gesprochene Preambles lassen sich im Systemprompt ergänzen:
# Preambles
Use a short spoken update before longer tasks.
Keep preambles under five seconds.
Skip preambles for short factual questions.Bereitgestellt von
Dieses Verhalten ist für gpt-realtime-2 dokumentiert.
Beobachtetes Verhalten
Turn-Taking funktionierte mit den Standardwerten in einem ruhigen Raum. Mit Laptop-Lautsprechern brauchte ich Mic-Muting; ohne hörte das Modell seine eigene Ausgabe und startete eine Echospirale.
In lauteren Räumen waren VAD-Settings und Mikrofonplatzierung wichtiger. Konversationsgedächtnis blieb über einen Zehn-Minuten-Test konsistent, aber ich würde keine längere App ohne Reconnect-Plan ausliefern.
Urteil: Bestanden für die Kern-Sprachschleife.gpt-realtime-2 bewältigte in meinem Test einen Assistenten mit geringem Reasoning-Bedarf. Die Zusatzarbeit liegt beim Client: Wiedergabe, Unterbrechungshandling, Reconnects und Toolaufrufe, falls nötig.
Streamlit-Demo: Drei Modelle in einer Oberfläche
Die Streamlit-App packt die Tests hinter einen Tab-Umschalter. Du kannst Audio aufnehmen, eine Zielsprache wählen und Modellpfade vergleichen, ohne Skripte zu bearbeiten. Ich habe das als Demo-App belassen statt als Hauptlernweg, da die Terminalskripte die Events direkter zeigen.
Drei Modelle in einer Tab-Oberfläche. Bild: Autor.
Das Demovideo unten zeigt die Tabs mit einem Live-API-Schlüssel. Jeder Tab nutzt echte Realtime-WebSocket-Aufrufe.
Starte die App aus demselben Ordner wie die Skripte:
Dein API-Schlüssel kommt in die Seitenleiste und wird nirgends gespeichert. Für eine öffentliche App lege ihn stattdessen in den Streamlit Secrets ab.
GPT-Realtime-2: Kosten und Latenz in der Praxis
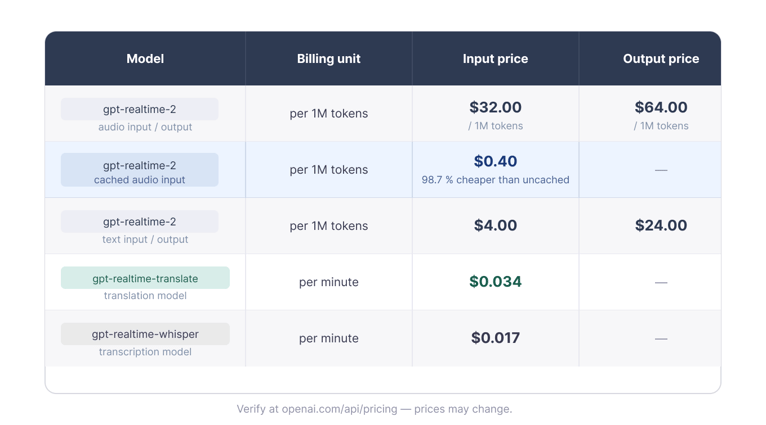
Wie in Test 1 erwähnt, teilt sich die Preisgestaltung in zwei Gruppen: gpt-realtime-2 wird nach Tokens abgerechnet, Übersetzung und Transkription nach Minuten.
Token- und Minutenabrechnung je Modell. Bild: Autor.
Bei Transkription und Übersetzung skaliert der Preis mit der Dauer. Zum Zeitpunkt des Schreibens kosten dreißig Minuten etwa 0,51 $ auf gpt-realtime-whisper und etwa 1,02 $ auf gpt-realtime-translate.
Sprachagenten sind schwerer zu schätzen, da auf beiden Seiten des Gesprächs Audiotokens anfallen. Sitzungsdauer, Sprechanteil, Reasoning-Einstellung und Kontextgröße spielen eine Rolle. Prompt-Caching kann Kosten senken, wenn frühere Gesprächsbeiträge stabil bleiben.
Ein REST-Transkriptionsaufruf plus TTS ist ein anderer Vergleich, sofern keine Live-Interaktion nötig ist. whisper-1 ist für Dateien günstiger, aber es ist nicht dieselbe Art von API.
GPT-Realtime-2 API: Limits, Audiovorgaben und Troubleshooting
Das sind die Limits, die meine ersten Testruns beeinflusst haben. Die meisten Fehler kamen von Audioformatierung oder Fehlern im Sitzungszyklus, nicht vom Modell selbst.
Transport- und Audiobeschränkungen
Wie im ersten Test notiert, sollte WebSocket-Audio PCM16 bei 24 kHz, mono und base64-codiert sein. Jedes input_audio_buffer.append-Event ist auf 15 MB begrenzt, daher bleiben 50-Millisekunden-Chunks klar unter dem Limit. G.711 wird für Telefonie ebenfalls unterstützt.
Realtime-Sitzungen enden nach 60 Minuten bei OpenAI und 30 Minuten bei Azure OpenAI. Längere Apps brauchen einen Reconnect-Plan und eine Möglichkeit, den Zustand wiederherzustellen. Die Stimme muss außerdem vor der ersten Audioausgabe gewählt werden; ein Wechsel während der Sitzung ist nicht möglich.
Ratenlimits und Quoten
Ratenlimits sind stufenbasiert und projektspezifisch. Tier 1 listet derzeit 200 Requests pro Minute und 40.000 Tokens pro Minute für gpt-realtime-2. Die Free-Stufe wird nicht unterstützt.
Häufige Fehler und Stolpersteine
Die häufigsten Fehler waren leere Buffer-Commits und falsche Audioformatierung. Bei Sprachagenten solltest du außerdem Rückkopplungsschleifen beobachten, wenn das Mikro die Lautsprecherausgabe des Assistenten aufnimmt. Nutze Kopfhörer, Echounterdrückung oder Mic-Muting.
Für lange Sitzungen solltest du rund bei Minute 55 reconnecten statt auf das Ablaufende zu warten. Eine kleine Doku-Unschärfe: Die Modellseite zu gpt-realtime-2 zeigt eine generische Zeile „Streaming: Not supported“, während die Realtime-Guides die Nutzung von /v1/realtime dokumentieren. Diese Zeile bezieht sich auf Chat-Completions-Streaming, nicht auf das Verhalten der Realtime API.
Abschließendes Urteil
Dasselbe Muster zeigt sich in allen drei Tests: Jede Aufgabe hat ihr eigenes Modell und ihren eigenen Endpunkt. Diese Aufteilung beeinflusst, was das Modell kann, wie abgerechnet wird und wie viel Client-Code du selbst verantwortest.
Wie gezeigt, deckt gpt-realtime-whisper Live-Text ab, gpt-realtime-translate direkte Sprachübersetzung und gpt-realtime-2 das Assistentenverhalten mit Sprache, Reasoning und Kontext.
Der Code zeigt nicht, dass ein Modell die anderen ersetzt. Er zeigt, dass Realtime-Sprachapps von der Sitzungsarchitektur abhängen. Mein Startpunkt wäre das kleinste Modell, das zur Aufgabe passt – den restlichen Entwicklungsaufwand würde ich in Audioqualität, Turn-Taking, Reconnects und Clientzustand stecken.
Mehr Hintergrund liefern unsere Tutorials zu verwandten Audio- und Realtime-API-Themen:
Ich bin Dateningenieur und Community-Builder und arbeite mit Datenpipelines, Cloud- und KI-Tools. Außerdem schreibe ich praktische, super nützliche Tutorials für DataCamp und angehende Entwickler.
Lerne die wichtigsten Arten von KI-Agenten kennen, wie sie mit ihrer Umgebung interagieren und wie sie in verschiedenen Branchen eingesetzt werden. Verstehe einfache reflexive, modellbasierte, zielbasierte, nutzenbasierte, lernende Agenten und mehr.
Lerne, wie man mit JSON in Python arbeitet, einschließlich Serialisierung, Deserialisierung, Formatierung, Leistungsoptimierung, Umgang mit APIs und Verständnis der Einschränkungen und Alternativen von JSON.








Unser Überblicksartikel zu GPT-Realtime-2 behandelte den Launch, die Benchmark-Aussagen und warum OpenAI Echtzeit-Sprachfunktionen auf eine kleine Modellfamilie aufgeteilt hat. Dieses Tutorial setzt dort an, wo der Artikel aufgehört hat: Verbindung zur API, Audio senden und sehen, was sich im Code ändert.
Die Aufteilung ist in der Praxis wichtig. Test 1 nutzt
gpt-realtime-whisperfür Transkription, Test 2 nutztgpt-realtime-translatefür Live-Übersetzung, und Test 3 nutztgpt-realtime-2für einen Sprachassistenten. Das Hauptmodell kann auch einfachere Aufgaben wie Übersetzung oder Transkription übernehmen, aber du würdest für mehr Reasoning und Antwortmodi zahlen, die nicht nötig sind – also überdimensioniert.Einrichtung der GPT-Realtime-2 API in Python
Vor den Tests hilft es, Transport, Authentifizierung und Audioformat zu trennen. Diese Details bleiben in den Beispielen weitgehend gleich. Die Modell-Endpunkte und Ereignisnamen sind das, was sich ändert, wenn der Artikel von Textausgabe zu übersetzter Sprache und dann zu einer vollständigen Sprachschleife wechselt.
Entscheidung zwischen WebRTC und WebSocket
Die OpenAI-Dokumentation gibt eine einfache Regel: Nutze WebRTC für Browser- und Mobile-Clients und WebSockets für serverseitige Anwendungen. WebRTC übernimmt Jitter-Pufferung und Audiotransport. WebSockets sind sinnvoll, wenn das Backend bereits Roh-Audio von einem Telefonieanbieter oder einer Mediapipeline empfängt.
Zwei Transportpfade für die Realtime API. Bild: Autor.
Aus diesem Grund verwenden alle drei Python-Tests WebSockets. Dieser Pfad zeigt die Ereignisnamen direkt, sodass die Modelldifferenzen im Code sichtbar sind. Für einen Browser-Build solltest du flüchtige Client-Secrets nutzen, damit dein API-Schlüssel niemals das Frontend erreicht.
Python-Umgebung und Pakete
Nutze Python 3.9 oder neuer. Der vollständige Code für alle vier Skripte ist unter github.com/KhalidAbdelaty/gpt-realtime-api verfügbar. Klone das Repo zuerst und installiere dann die Abhängigkeiten:
websocket-clientsteuert den Socket,sounddevicezeichnet Mikrofon-Audio auf,numpykonvertiert den Puffer, undpython-dotenvlädt den API-Schlüssel. Unter macOS brauchst du eventuellbrew install portaudio, bevorsounddevicefunktioniert. Unter Linux installiereportaudio19-dev.Lege eine
.env-Datei im Projektroot an:Dann lädst du sie in jedem Skript:
Authentifizierung und die WebSocket-URL
Serverseitige Verbindungen nutzen einen
Authorization: Bearer-Header beim WebSocket-Handshake. FügeOpenAI-Safety-Identifierhinzu, wenn die App einzelne Nutzer nachverfolgt. Diese Pfade werden in den Tests später verwendet:Dieser Übersetzungspfad ist in Test 2 wichtig, weil es der eine Endpunkt ist, der nicht direkt
/v1/realtimenutzt.Test 1: Echtzeit-Audiotranskription mit GPT-Realtime-Whisper
Transkription ist ein typischer Ort für Overengineering. Wenn die Ausgabe nur Text ist, reicht das Transkriptionsmodell.
Was wir testen
gpt-realtime-whispernimmt Audio entgegen und gibt Transkript-Deltas aus. Es führt kein Reasoning aus, ruft keine Tools auf und spricht nicht zurück. Dieser kleinere Umfang ist der Grund, warum es nach Audiodauer abgerechnet wird – anders als das Tokenmodell vongpt-realtime-2. Im Kostenabschnitt kommen wir darauf zurück.Code-Walkthrough
Das Schlüsselfeld ist
session.type: "transcription". Das weist die API an, Assistentenantworten zu überspringen und nur Transkript-Events zu senden. Das vollständige Skript behandelt außerdem Mikrofonaufnahme und Threads. Dieser Teil ändert das Realtime-Sitzungsverhalten:Nutze 24 kHz PCM16 Mono-Audio, base64-codiert. Anders als in der Voice-Agent-Sitzung commitet das Skript den Eingabepuffer manuell per Timer statt
server_vadfür Turn Detection zu verwenden. Leere Commits werfeninput_audio_buffer_commit_empty, daher commitet das vollständige Skript erst nach echtem Audioeingang.Transkript-Deltas treffen Wort für Wort in Echtzeit ein. Bild: Autor.
Beobachtetes Verhalten
In meinen lokalen Tests erschienen Transkriptergebnisse innerhalb des Commit-Fensters, etwa 3 bis 4 Sekunden nach Beginn der Sprache. Da dieses Setup auf manuelle Commits statt VAD setzt, hängt die Latenz am Commit-Intervall.
Achte außerdem auf die Reihenfolge: Completion-Events aus überlappenden Turns können außer der Reihe eintreffen, deshalb solltest du bei einem UI um den Stream per
item_idzusammenführen.Transkription wird durch periodische manuelle Commits ausgelöst, nicht durch Still-Erkennung. Bild: Autor.
Urteil: Bestanden. Für serverseitige Live-Transkription lieferte
gpt-realtime-whisperdas, was dieser Test brauchte. Ich würde dennoch mit echten Mikrofonen, Akzenten und Raumgeräuschen testen, bevor ich ein Latenzziel setze.Test 2: Echtzeit-Übersetzung mit GPT-Realtime-Translate
Live-Sprachübersetzung ähnelt auf den ersten Blick der Transkription, aber der Sitzungszyklus unterscheidet sich. Der Übersetzungsendpunkt entfernt die Assistentenantwortschleife, was das Beispiel kürzer macht.
Was wir testen
Übersetzungssitzungen haben keine Assistenten-Turn-Schleife und kein
response.create. Das Modell arbeitet wie ein Live-Dolmetscher, nicht wie ein Konversationsagent. Für Q&A, Tools oder Konversationszustand wechselt der Artikel in Test 3 zugpt-realtime-2.Übersetzungssitzungen nutzen einen eigenen, separaten Endpunkt. Bild: Autor.
Das Modell unterstützt über 70 Eingabesprachen und 13 Ausgabesprachen. Du setzt das Ziel mit
session.audio.output.language; die Erkennung der Ausgangssprache erfolgt automatisch. Die Grenzen sind klar: kein Custom Prompting, keine Stimmwahl, keine Fachglossare.Code-Walkthrough
Wie erwähnt, verwendet die Übersetzung die
/translations-WebSocket-URL. Zwei weitere Details ändern sich ebenfalls: das Zielfeldsession.audio.output.languageund der Ereignisnamesession.input_audio_buffer.append. Beachte das Präfixsession.. Übersetzungssitzungen nutzen es hier.Übersetztes Audio kommt über
session.output_audio.delta, und die Audio-Bytes stehen inevent[\"delta\"], nicht inevent[\"audio\"]. Quell- und Übersetzungs-Transkripte kommen getrennt an:Ein Randfall: Wenn das Quellaudio bereits in der Zielsprache ist, kann das Modell Stille produzieren statt es durchzureichen.
Beobachtetes Verhalten
Bei kurzen Englisch-Spanisch-Phrasen begann das übersetzte Audio, bevor die Quelläußerung fertig war. Im Terminal waren verschachtelte
[EN]- und[ES]-Zeilen zu sehen, während Deltas eintrafen. Entfernt liegende Sprachpaare warten ggf. länger auf Kontext. Ich konnte der übersetzten Stimme gut folgen, aber eigene Stimmwahl ist nicht verfügbar.Urteil: Bestanden, mit Einschränkung.
gpt-realtime-translatefunktionierte für direkte Live-Übersetzung. Weniger geeignet ist es, wenn Terminologiekontrolle oder Stimmbranding wichtig sind.Test 3: Aufbau eines Sprachassistenten mit Turn-Taking und Barge-In
Dies ist der
gpt-realtime-2-Test: ein Sprachagent, der zuhört, spricht, Kontext hält und Tools aufrufen kann. Hier wird auch der Client-Code wichtiger, da Wiedergabe und Turn-Zustand aus dem Takt geraten können.Was wir testen
gpt-realtime-2ist ein Speech-to-Speech-Reasoning-Modell. Es vermeidet eine separate STT-zu-LLM-zu-TTS-Pipeline, und sein 128K-Kontextfenster gibt längeren Sitzungen mehr Spielraum. Reasoning steuerst du mitreasoning.effort; starte mitlow, außer die Aufgabe braucht mehr Reasoning, denn höhere Stufen erhöhen die Latenz.Code-Walkthrough
Das folgende Setup nutzt
semantic_vad, das Sprachhinweise statt nur Stille betrachtet.eagernesssteuert, wie schnell das Modell entscheidet, dass der Nutzer fertig ist. Beachte Modellname, Audioausgabesettings, manuellesresponse.createund den Audio-Ereignisnamen des Assistenten:Wenn das Nutzertranskript abgeschlossen ist, erstellt der Client die Assistentenantwort. Assistenten-Audio kommt dann als
response.output_audio.deltaan, nicht alsresponse.audio.delta.Barge-In handhaben
Die Unterbrechungssequenz lässt sich leicht falsch machen. Wenn der Nutzer dem Assistenten ins Wort fällt, sendet der Server
input_audio_buffer.speech_started. Der Client stoppt die Wiedergabe, merkt sich, wie viel Audio bereits abgespielt wurde, und sendetconversation.item.truncatemitaudio_end_ms, um den Cut-off zu markieren. Andernfalls transkribiert der Server weiter Text, den der Nutzer nie gehört hat, und die nächste Runde wirkt daneben.Ein praktisches Problem mit Laptop-Lautsprechern: Das Mikro kann die Assistentenausgabe aufnehmen und ans Modell zurücksenden. Das Beispielskript nutzt
MUTE_MIC_DURING_ASSISTANT = True, um den Eingabestream stummzuschalten, während der Assistent spricht, plus kurze Abkühlzeit. Setze es nur aufFalse, wenn du Kopfhörer nutzt und Unterbrechungen möchtest.Trunkierung hält Server und Client synchron. Bild: Autor.
WebRTC und SIP übernehmen mehr von dieser Pufferung. Beim in diesem Tutorial genutzten WebSocket-Pfad liegt sie beim Client. Der Zähler im Beispielskript reicht für eine Demo; Produktionscode sollte Zeitstempel aus dem Audioausgabestream nachverfolgen.
Preambles für Reasoning-Latenz konfigurieren
Wenn
reasoning.effortüberlowliegt, wird Stille hörbar. Kurze gesprochene Preambles lassen sich im Systemprompt ergänzen:Dieses Verhalten ist für
gpt-realtime-2dokumentiert.Beobachtetes Verhalten
Turn-Taking funktionierte mit den Standardwerten in einem ruhigen Raum. Mit Laptop-Lautsprechern brauchte ich Mic-Muting; ohne hörte das Modell seine eigene Ausgabe und startete eine Echospirale.
In lauteren Räumen waren VAD-Settings und Mikrofonplatzierung wichtiger. Konversationsgedächtnis blieb über einen Zehn-Minuten-Test konsistent, aber ich würde keine längere App ohne Reconnect-Plan ausliefern.
Urteil: Bestanden für die Kern-Sprachschleife.
gpt-realtime-2bewältigte in meinem Test einen Assistenten mit geringem Reasoning-Bedarf. Die Zusatzarbeit liegt beim Client: Wiedergabe, Unterbrechungshandling, Reconnects und Toolaufrufe, falls nötig.Streamlit-Demo: Drei Modelle in einer Oberfläche
Die Streamlit-App packt die Tests hinter einen Tab-Umschalter. Du kannst Audio aufnehmen, eine Zielsprache wählen und Modellpfade vergleichen, ohne Skripte zu bearbeiten. Ich habe das als Demo-App belassen statt als Hauptlernweg, da die Terminalskripte die Events direkter zeigen.
Drei Modelle in einer Tab-Oberfläche. Bild: Autor.
Das Demovideo unten zeigt die Tabs mit einem Live-API-Schlüssel. Jeder Tab nutzt echte Realtime-WebSocket-Aufrufe.