Hướng dẫn API GPT-Realtime-2: Ba bài kiểm thử, ba kết luận
Tìm hiểu sự khác nhau giữa gpt-realtime-2, gpt-realtime-translate và gpt-realtime-whisper của OpenAI, rồi kiểm thử từng cái với mã WebSocket Python hoạt động thực tế.
Bài tổng quan về GPT-Realtime-2 của chúng tôi đã bao quát lễ ra mắt, các tuyên bố benchmark và lý do OpenAI tách giọng nói thời gian thực thành một họ mô hình nhỏ. Hướng dẫn này bắt đầu từ nơi bài viết đó dừng lại: kết nối với API, gửi âm thanh và xem thay đổi trong mã.
Việc tách mô hình thực sự quan trọng khi triển khai. Bài kiểm thử 1 dùnggpt-realtime-whisper để ghi âm thành văn bản, Bài kiểm thử 2 dùnggpt-realtime-translatecho dịch trực tiếp, và Bài kiểm thử 3 dùng gpt-realtime-2cho trợ lý giọng nói. Mô hình chính cũng xử lý được các tác vụ đơn giản như dịch hay ghi âm thành văn bản, nhưng bạn sẽ phải trả phí cho mức độ lý luận và các chế độ phản hồi không cần thiết, nên sẽ là dư thừa.
Thiết lập API GPT-Realtime-2 trong Python
Trước khi kiểm thử, nên tách biệt phần truyền tải, xác thực và định dạng âm thanh. Những chi tiết này hầu như giữ nguyên giữa các ví dụ. Điểm cuối mô hình và tên sự kiện là phần thay đổi khi bài viết chuyển từ đầu ra văn bản sang giọng nói đã dịch và sau đó là một vòng thoại đầy đủ.
Chọn giữa WebRTC và WebSocket
Tài liệu OpenAI đưa ra một quy tắc rõ ràng: dùng WebRTC cho trình duyệt và thiết bị di động, và dùng WebSockets cho ứng dụng phía máy chủ. WebRTC xử lý bộ đệm jitter và truyền tải âm thanh. WebSocket hợp lý khi backend đã nhận âm thanh thô từ nhà cung cấp thoại hoặc pipeline media.
Hai tuyến truyền tải cho Realtime API. Hình do Tác giả thực hiện.
Vì lý do đó, cả ba bài kiểm thử Python đều dùng WebSocket. Tuyến này hiển thị trực tiếp tên sự kiện, nên sự khác nhau giữa các mô hình sẽ thấy rõ trong mã. Với bản dựng cho trình duyệt, hãy dùng khóa khách hàng tạm thời để API key của bạn không bao giờ chạm tới frontend.
git clone https://github.com/KhalidAbdelaty/gpt-realtime-api.git
cd gpt-realtime-api
pip install websocket-client sounddevice numpy python-dotenvĐược hỗ trợ bởi
websocket-clientxử lý socket. sounddevicethu âm từ micro, numpychuyển đổi bộ đệm, vàpython-dotenv tải API key. Trên macOS, bạn có thể cần brew install portaudio trước khi sounddevice hoạt động. Trên Linux, cài portaudio19-dev.
import os
from dotenv import load_dotenv

load_dotenv()
OPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")Được hỗ trợ bởi
Xác thực và URL WebSocket
Kết nối phía máy chủ dùng header Authorization: Bearer trong bắt tay WebSocket. ThêmOpenAI-Safety-Identifiernếu ứng dụng theo dõi người dùng riêng lẻ. Đây là các tuyến được dùng sau trong bài kiểm thử:
Tuyến dịch này quan trọng ở Bài kiểm thử 2, vì đây là endpoint duy nhất không dùng trực tiếp /v1/realtime.
Bài kiểm thử 1: Ghi âm thời gian thực với GPT-Realtime-Whisper
Ghi âm thành văn bản là nơi dễ làm quá mức cần thiết. Nếu đầu ra chỉ là văn bản, mô hình ghi âm là đủ.
Chúng ta đang kiểm thử gì
gpt-realtime-whisper nhận âm thanh vào và phát ra các phần delta của bản chép lời. Nó không lý luận, không gọi công cụ, cũng không phản hồi bằng giọng. Công việc nhỏ hơn này là lý do nó được tính phí theo thời lượng âm thanh thay vì cùng mô hình token như gpt-realtime-2. Phần chi phí sẽ quay lại các mức giá đó.
Đi qua mã
Trường then chốt làsession.type: "transcription". Nó báo API bỏ qua phản hồi của trợ lý và chỉ phát sự kiện bản chép lời. Script đầy đủ cũng xử lý thu âm từ micro và luồng riêng. Đây là phần thay đổi hành vi phiên Realtime:
session_config ={"type":"session.update","session":{"type":"transcription","audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":None}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"input_audio_buffer.append","audio": audio_b64
}))
ws.send(json.dumps({"type":"input_audio_buffer.commit"}))Được hỗ trợ bởi
Dùng âm thanh PCM16 mono 24 kHz, mã hóa base64. Khác với phiên trợ lý giọng nói, script sẽ commit bộ đệm đầu vào thủ công theo bộ đếm thời gian thay vì dùng phát hiện lượt nói server_vad. Commit rỗng sẽ phát sinh input_audio_buffer_commit_empty, vì vậy script đầy đủ chỉ commit sau khi đã gửi âm thanh thực.
Các delta bản chép lời đến theo từng từ trong thời gian thực. Hình do Tác giả thực hiện.
Hành vi quan sát được
Trong thử nghiệm cục bộ của tôi, kết quả bản chép lời xuất hiện trong cửa sổ commit, khoảng 3 đến 4 giây sau khi bắt đầu nói. Vì thiết lập này dựa vào commit thủ công thay vì VAD, độ trễ gắn với khoảng commit.
Ngoài ra, chú ý thứ tự: các sự kiện hoàn tất từ những lượt nói chồng lấp có thể đến không theo thứ tự, vì vậy hãy đối chiếu theo item_id nếu bạn xây UI quanh luồng này.
Ghi âm được kích hoạt bởi commit thủ công định kỳ, không phải phát hiện khoảng lặng. Hình do Tác giả thực hiện.
Kết luận: Đạt. Với ghi âm trực tiếp phía máy chủ, gpt-realtime-whisper đáp ứng đúng nhu cầu kiểm thử này. Tôi vẫn sẽ thử nghiệm với micro thực, giọng khác nhau và tiếng ồn phòng trước khi đặt mục tiêu độ trễ.
Bài kiểm thử 2: Dịch thời gian thực với GPT-Realtime-Translate
Dịch giọng nói trực tiếp lúc đầu trông giống ghi âm, nhưng vòng đời phiên lại khác. Endpoint dịch loại bỏ vòng phản hồi của trợ lý, làm ví dụ ngắn gọn hơn.
Chúng ta đang kiểm thử gì
Phiên dịch không có vòng lượt của trợ lý và không có response.create. Mô hình hoạt động như một phiên dịch trực tiếp, không phải một tác nhân hội thoại. Với Hỏi & Đáp, công cụ hay trạng thái hội thoại, bài viết chuyển sang gpt-realtime-2 ở Bài kiểm thử 3.
Phiên dịch dùng một endpoint riêng, tách biệt. Hình do Tác giả thực hiện.
Mô hình hỗ trợ hơn 70 ngôn ngữ đầu vào và 13 ngôn ngữ đầu ra. Bạn đặt ngôn ngữ đích bằng session.audio.output.language; phát hiện ngôn ngữ nguồn là tự động. Giới hạn rất rõ: không tùy biến prompt, không chọn giọng, không có glossary theo lĩnh vực.
Đi qua mã
Như đã đề cập, dịch dùng URL WebSocket /translations. Hai chi tiết khác cũng thay đổi: trường đích session.audio.output.language và tên sự kiện session.input_audio_buffer.append. Lưu ý tiền tố session.. Phiên dịch dùng tiền tố này ở đây.
Âm thanh đã dịch đến trên session.output_audio.delta, và byte âm thanh nằm trong event["delta"], không phải event["audio"]. Bản chép lời nguồn và bản dịch đến tách biệt:
if event_type =="session.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))elif event_type =="session.input_transcript.delta":print("[EN]", event.get("delta",""), end="")elif event_type =="session.output_transcript.delta":print("[ES]", event.get("delta",""), end="")Được hỗ trợ bởi
Một trường hợp biên: nếu âm thanh nguồn đã ở ngôn ngữ đích, mô hình có thể tạo ra khoảng lặng thay vì chuyển tiếp nguyên trạng.
Hành vi quan sát được
Với các cụm ngắn Anh → Tây Ban Nha, âm thanh dịch bắt đầu trước khi câu nguồn kết thúc. Terminal hiển thị xen kẽ các dòng [EN] và [ES] khi delta được stream vào. Cặp ngôn ngữ xa hơn có thể đợi lâu hơn để lấy ngữ cảnh. Tôi có thể theo kịp giọng nói đã dịch mà không gặp khó khăn, nhưng hiện không hỗ trợ chọn giọng tuỳ chỉnh.
Kết luận: Đạt, có lưu ý.gpt-realtime-translate hoạt động tốt cho dịch trực tiếp. Nó kém hữu ích khi cần kiểm soát thuật ngữ hoặc định danh giọng nói thương hiệu.
Bài kiểm thử 3: Xây trợ lý giọng nói với luân phiên lượt nói và ngắt lời
Đây là bài kiểm thử gpt-realtime-2: một tác nhân giọng nói biết lắng nghe, nói, giữ ngữ cảnh và có thể gọi công cụ. Đây cũng là điểm mà mã phía khách bắt đầu quan trọng hơn, vì phát lại và trạng thái lượt nói có thể bị lệch nhịp.
Chúng ta đang kiểm thử gì
gpt-realtime-2 là mô hình lý luận từ giọng nói tới giọng nói. Nó tránh pipeline tách biệt STT → LLM → TTS, và cửa sổ ngữ cảnh 128K cho phép phiên dài có nhiều không gian hơn. Mức độ lý luận được điều khiển bằng reasoning.effort; hãy bắt đầu ở low trừ khi tác vụ cần nhiều lý luận hơn, vì thiết lập cao sẽ thêm độ trễ.
Đi qua mã
Thiết lập dưới đây dùng semantic_vad, vốn dựa trên tín hiệu lời nói chứ không chỉ khoảng lặng. eagerness điều khiển mức nhanh mà mô hình quyết định người dùng đã nói xong. Những phần cần chú ý là tên mô hình, thiết lập đầu ra âm thanh, response.create thủ công và tên sự kiện âm thanh của trợ lý:
session_config ={"type":"session.update","session":{"type":"realtime","model":"gpt-realtime-2","output_modalities":["audio"],"audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":{"type":"semantic_vad","eagerness":"medium","create_response":False,"interrupt_response":True}},"output":{"format":{"type":"audio/pcm","rate":24000},"voice":"marin"}},"instructions":"You are a helpful voice assistant. Keep answers short.","reasoning":{"effort":"low"}}}Được hỗ trợ bởi
Khi bản chép lời của người dùng hoàn tất, client tạo phản hồi của trợ lý. Âm thanh của trợ lý sau đó đến dưới dạng response.output_audio.delta, không phải response.audio.delta.
if event_type =="conversation.item.input_audio_transcription.completed":
ws.send(json.dumps({"type":"response.create"}))elif event_type =="response.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))Được hỗ trợ bởi
Xử lý ngắt lời
Chuỗi ngắt lời rất dễ làm sai. Khi người dùng nói chồng lên trợ lý, máy chủ gửi input_audio_buffer.speech_started. Client dừng phát lại, ghi nhận lượng âm thanh đã phát, và gửi conversation.item.truncate với audio_end_ms để đánh dấu vị trí bị cắt. Nếu không, máy chủ sẽ tiếp tục chép lại phần văn bản mà người dùng chưa từng nghe, và lượt kế tiếp sẽ lệch nhịp.
if current_response_item_id and playback_position_ms >0:
ws.send(json.dumps({"type":"conversation.item.truncate","item_id": current_response_item_id,"content_index":0,"audio_end_ms": playback_position_ms
}))Được hỗ trợ bởi
Một vấn đề thực tế với loa laptop: micro có thể thu lại âm thanh của trợ lý và gửi ngược về mô hình. Script mẫu dùng MUTE_MIC_DURING_ASSISTANT = True để tắt luồng đầu vào khi trợ lý đang nói và thêm một khoảng hạ nhiệt ngắn sau đó. Chỉ đặt False nếu bạn dùng tai nghe và muốn hỗ trợ ngắt lời.
Việc cắt gọn giữ cho máy chủ và client đồng bộ. Hình do Tác giả thực hiện.
WebRTC và SIP xử lý nhiều phần đệm hơn. Với tuyến WebSocket dùng trong hướng dẫn này, client phải tự đảm nhận. Bộ đếm trong script mẫu là đủ cho bản demo; mã sản xuất nên theo dõi timestamp từ luồng đầu ra âm thanh.
Cấu hình preamble để giảm độ trễ do lý luận
Khi reasoning.effort trên low, khoảng lặng trở nên đáng chú ý. Có thể thêm các preamble ngắn bằng lời vào system prompt:
# Preambles
Use a short spoken update before longer tasks.
Keep preambles under five seconds.
Skip preambles for short factual questions.Được hỗ trợ bởi
Hành vi này được ghi lại cho gpt-realtime-2.
Hành vi quan sát được
Luân phiên lượt nói hoạt động ở thiết lập mặc định trong phòng yên tĩnh. Với loa laptop, tôi cần tắt mic; nếu không, mô hình nghe chính âm thanh của mình và bắt đầu vòng vọng.
Trong phòng ồn hơn, thiết lập VAD và vị trí micro quan trọng hơn. Bộ nhớ hội thoại ổn định trong bài thử mười phút, nhưng tôi sẽ không phát hành ứng dụng dài hơn nếu thiếu kế hoạch reconnect.
Kết luận: Đạt cho vòng thoại cốt lõi.gpt-realtime-2 xử lý tốt trợ lý với mức lý luận thấp trong thử nghiệm của tôi. Phần việc thêm nằm ở client: phát lại, xử lý ngắt lời, reconnect, và gọi công cụ nếu ứng dụng cần.
Demo Streamlit: Ba mô hình trong một giao diện
Ứng dụng Streamlit đặt các bài kiểm thử sau bộ chọn thẻ. Nó cho phép bạn ghi âm, chọn ngôn ngữ đích và so sánh các tuyến mô hình mà không cần sửa script. Tôi giữ nó như ứng dụng demo thay vì con đường chính để dạy, vì các script terminal hiển thị sự kiện trực quan hơn.
Ba mô hình trong một giao diện dạng thẻ. Hình do Tác giả thực hiện.
Video demo dưới đây cho thấy các thẻ hoạt động với API key thật. Mỗi thẻ dùng các cuộc gọi Realtime WebSocket thực.
API key của bạn được nhập ở sidebar và không được lưu ở đâu cả. Với ứng dụng công khai, hãy đặt nó trong Streamlit Secrets.
Chi phí và độ trễ của GPT-Realtime-2 trong thực tế
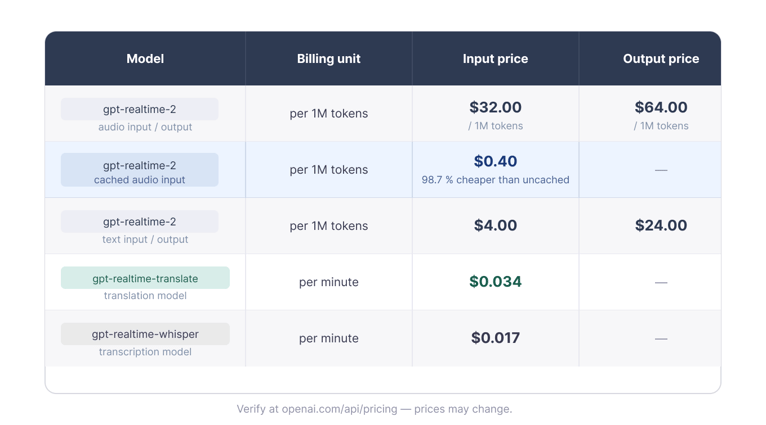
Như đã đề cập ở Bài kiểm thử 1, giá tách thành hai nhóm: gpt-realtime-2 tính theo token, trong khi dịch và ghi âm tính theo phút.
Tính phí theo token và theo phút tuỳ mô hình. Hình do Tác giả thực hiện.
Với ghi âm và dịch, chi phí tỷ lệ với thời lượng. Tại thời điểm viết bài, ba mươi phút khoảng 0,51 USD trên gpt-realtime-whisper và khoảng 1,02 USD trên gpt-realtime-translate.
Trợ lý giọng nói khó ước tính hơn vì token âm thanh tích luỹ ở cả hai phía hội thoại. Độ dài phiên, tỷ lệ nói, mức lý luận và kích thước ngữ cảnh đều quan trọng. Bộ nhớ đệm prompt có thể giảm chi phí khi các lượt hội thoại trước đó ổn định.
Gọi REST để ghi âm cộng với TTS là một so sánh khác trừ khi yêu cầu tương tác trực tiếp. whisper-1 rẻ hơn cho tệp, nhưng đó không phải cùng loại API.
Giới hạn API GPT-Realtime-2, yêu cầu âm thanh và khắc phục sự cố
Đây là những giới hạn ảnh hưởng đến các lần chạy thử đầu tiên của tôi. Hầu hết lỗi đến từ định dạng âm thanh hoặc sai sót vòng đời phiên, không phải từ bản thân mô hình.
Ràng buộc truyền tải và âm thanh
Như đã nêu ở bài kiểm thử đầu tiên, âm thanh qua WebSocket nên là PCM16 ở 24 kHz, mono và mã hóa base64. Mỗi sự kiện input_audio_buffer.append bị giới hạn 15 MB, nên các khối 50 mili-giây thì dư sức nằm dưới ngưỡng. Cũng hỗ trợ G.711 cho thoại.
Phiên Realtime kết thúc sau 60 phút trên OpenAI và 30 phút trên Azure OpenAI. Ứng dụng dài hơn cần kế hoạch reconnect và cách dựng lại trạng thái. Giọng nói cũng phải chọn trước lần phát âm thanh đầu tiên; không thể đổi giữa phiên.
Giới hạn tốc độ và hạn ngạch
Giới hạn tốc độ theo tier và theo dự án. Hiện Tier 1 liệt kê 200 yêu cầu mỗi phút và 40.000 token mỗi phút cho gpt-realtime-2. Không hỗ trợ gói Free.
Lỗi thường gặp và điểm còn thô
Lỗi tôi gặp nhiều nhất là commit bộ đệm rỗng và định dạng âm thanh sai. Với trợ lý giọng nói, cũng cần lưu ý vòng phản hồi khi micro thu âm thanh từ loa của trợ lý. Hãy dùng tai nghe, khử vọng hoặc tắt mic.
Với phiên dài, hãy reconnect khoảng phút 55 thay vì chờ hết hạn. Một điểm lắt léo trong tài liệu: trang mô hình gpt-realtime-2 có hàng "Streaming: Không hỗ trợ" dạng chung, trong khi các hướng dẫn Realtime lại ghi chép cách dùng /v1/realtime. Hàng đó nói về streaming của Chat Completions, không phải hành vi của Realtime API.
Kết luận cuối
Cùng một mô thức lặp lại ở cả ba bài kiểm thử: mỗi công việc có mô hình và endpoint riêng. Việc tách này ảnh hưởng đến khả năng của mô hình, cách tính phí và lượng mã phía khách bạn phải tự quản.
Như đã trình bày, gpt-realtime-whisper phụ trách văn bản trực tiếp, gpt-realtime-translate phụ trách dịch giọng nói trực tiếp, và gpt-realtime-2 phụ trách hành vi trợ lý với giọng nói, lý luận và ngữ cảnh.
Mã không cho thấy một mô hình thay thế các mô hình còn lại. Nó cho thấy ứng dụng giọng nói thời gian thực phụ thuộc vào thiết kế phiên. Điểm khởi đầu của tôi sẽ là mô hình nhỏ nhất phù hợp công việc, với thời gian kỹ thuật còn lại dành cho chất lượng âm thanh, luân phiên lượt nói, reconnect và trạng thái client.
Nếu bạn quan tâm đến một mô hình đối thủ tập trung vào tương tác trực tiếp, tôi khuyên đọc hướng dẫn của chúng tôi về TML-Interaction-Small của Thinking Machines Lab. Để có thêm bối cảnh về các mô hình âm thanh của OpenAI, các hướng dẫn của chúng tôi bao quát các chủ đề audio và Realtime API liên quan:
Tôi là một kỹ sư dữ liệu và người xây dựng cộng đồng, làm việc với pipeline dữ liệu, đám mây và công cụ AI, đồng thời viết các hướng dẫn thực hành, tác động cao cho DataCamp và các nhà phát triển mới nổi.



Bài tổng quan về GPT-Realtime-2 của chúng tôi đã bao quát lễ ra mắt, các tuyên bố benchmark và lý do OpenAI tách giọng nói thời gian thực thành một họ mô hình nhỏ. Hướng dẫn này bắt đầu từ nơi bài viết đó dừng lại: kết nối với API, gửi âm thanh và xem thay đổi trong mã.
Việc tách mô hình thực sự quan trọng khi triển khai. Bài kiểm thử 1 dùng
gpt-realtime-whisperđể ghi âm thành văn bản, Bài kiểm thử 2 dùnggpt-realtime-translatecho dịch trực tiếp, và Bài kiểm thử 3 dùnggpt-realtime-2cho trợ lý giọng nói. Mô hình chính cũng xử lý được các tác vụ đơn giản như dịch hay ghi âm thành văn bản, nhưng bạn sẽ phải trả phí cho mức độ lý luận và các chế độ phản hồi không cần thiết, nên sẽ là dư thừa.Thiết lập API GPT-Realtime-2 trong Python
Trước khi kiểm thử, nên tách biệt phần truyền tải, xác thực và định dạng âm thanh. Những chi tiết này hầu như giữ nguyên giữa các ví dụ. Điểm cuối mô hình và tên sự kiện là phần thay đổi khi bài viết chuyển từ đầu ra văn bản sang giọng nói đã dịch và sau đó là một vòng thoại đầy đủ.
Chọn giữa WebRTC và WebSocket
Tài liệu OpenAI đưa ra một quy tắc rõ ràng: dùng WebRTC cho trình duyệt và thiết bị di động, và dùng WebSockets cho ứng dụng phía máy chủ. WebRTC xử lý bộ đệm jitter và truyền tải âm thanh. WebSocket hợp lý khi backend đã nhận âm thanh thô từ nhà cung cấp thoại hoặc pipeline media.
Hai tuyến truyền tải cho Realtime API. Hình do Tác giả thực hiện.
Vì lý do đó, cả ba bài kiểm thử Python đều dùng WebSocket. Tuyến này hiển thị trực tiếp tên sự kiện, nên sự khác nhau giữa các mô hình sẽ thấy rõ trong mã. Với bản dựng cho trình duyệt, hãy dùng khóa khách hàng tạm thời để API key của bạn không bao giờ chạm tới frontend.
Môi trường và gói Python
Dùng Python 3.9 trở lên. Toàn bộ mã cho cả bốn script có sẵn tại github.com/KhalidAbdelaty/gpt-realtime-api. Hãy clone trước, rồi cài đặt phụ thuộc:
websocket-clientxử lý socket.sounddevicethu âm từ micro,numpychuyển đổi bộ đệm, vàpython-dotenvtải API key. Trên macOS, bạn có thể cầnbrew install portaudiotrước khisounddevicehoạt động. Trên Linux, càiportaudio19-dev.Tạo tệp
.envở thư mục gốc của dự án:Sau đó tải nó trong mỗi script:
Xác thực và URL WebSocket
Kết nối phía máy chủ dùng header
Authorization: Bearertrong bắt tay WebSocket. ThêmOpenAI-Safety-Identifiernếu ứng dụng theo dõi người dùng riêng lẻ. Đây là các tuyến được dùng sau trong bài kiểm thử:Tuyến dịch này quan trọng ở Bài kiểm thử 2, vì đây là endpoint duy nhất không dùng trực tiếp
/v1/realtime.Bài kiểm thử 1: Ghi âm thời gian thực với GPT-Realtime-Whisper
Ghi âm thành văn bản là nơi dễ làm quá mức cần thiết. Nếu đầu ra chỉ là văn bản, mô hình ghi âm là đủ.
Chúng ta đang kiểm thử gì
gpt-realtime-whispernhận âm thanh vào và phát ra các phần delta của bản chép lời. Nó không lý luận, không gọi công cụ, cũng không phản hồi bằng giọng. Công việc nhỏ hơn này là lý do nó được tính phí theo thời lượng âm thanh thay vì cùng mô hình token nhưgpt-realtime-2. Phần chi phí sẽ quay lại các mức giá đó.Đi qua mã
Trường then chốt là
session.type: "transcription". Nó báo API bỏ qua phản hồi của trợ lý và chỉ phát sự kiện bản chép lời. Script đầy đủ cũng xử lý thu âm từ micro và luồng riêng. Đây là phần thay đổi hành vi phiên Realtime:Dùng âm thanh PCM16 mono 24 kHz, mã hóa base64. Khác với phiên trợ lý giọng nói, script sẽ commit bộ đệm đầu vào thủ công theo bộ đếm thời gian thay vì dùng phát hiện lượt nói
server_vad. Commit rỗng sẽ phát sinhinput_audio_buffer_commit_empty, vì vậy script đầy đủ chỉ commit sau khi đã gửi âm thanh thực.Các delta bản chép lời đến theo từng từ trong thời gian thực. Hình do Tác giả thực hiện.
Hành vi quan sát được
Trong thử nghiệm cục bộ của tôi, kết quả bản chép lời xuất hiện trong cửa sổ commit, khoảng 3 đến 4 giây sau khi bắt đầu nói. Vì thiết lập này dựa vào commit thủ công thay vì VAD, độ trễ gắn với khoảng commit.
Ngoài ra, chú ý thứ tự: các sự kiện hoàn tất từ những lượt nói chồng lấp có thể đến không theo thứ tự, vì vậy hãy đối chiếu theo
item_idnếu bạn xây UI quanh luồng này.Ghi âm được kích hoạt bởi commit thủ công định kỳ, không phải phát hiện khoảng lặng. Hình do Tác giả thực hiện.
Kết luận: Đạt. Với ghi âm trực tiếp phía máy chủ,
gpt-realtime-whisperđáp ứng đúng nhu cầu kiểm thử này. Tôi vẫn sẽ thử nghiệm với micro thực, giọng khác nhau và tiếng ồn phòng trước khi đặt mục tiêu độ trễ.Bài kiểm thử 2: Dịch thời gian thực với GPT-Realtime-Translate
Dịch giọng nói trực tiếp lúc đầu trông giống ghi âm, nhưng vòng đời phiên lại khác. Endpoint dịch loại bỏ vòng phản hồi của trợ lý, làm ví dụ ngắn gọn hơn.
Chúng ta đang kiểm thử gì
Phiên dịch không có vòng lượt của trợ lý và không có
response.create. Mô hình hoạt động như một phiên dịch trực tiếp, không phải một tác nhân hội thoại. Với Hỏi & Đáp, công cụ hay trạng thái hội thoại, bài viết chuyển sanggpt-realtime-2ở Bài kiểm thử 3.Phiên dịch dùng một endpoint riêng, tách biệt. Hình do Tác giả thực hiện.
Mô hình hỗ trợ hơn 70 ngôn ngữ đầu vào và 13 ngôn ngữ đầu ra. Bạn đặt ngôn ngữ đích bằng
session.audio.output.language; phát hiện ngôn ngữ nguồn là tự động. Giới hạn rất rõ: không tùy biến prompt, không chọn giọng, không có glossary theo lĩnh vực.Đi qua mã
Như đã đề cập, dịch dùng URL WebSocket
/translations. Hai chi tiết khác cũng thay đổi: trường đíchsession.audio.output.languagevà tên sự kiệnsession.input_audio_buffer.append. Lưu ý tiền tốsession.. Phiên dịch dùng tiền tố này ở đây.Âm thanh đã dịch đến trên
session.output_audio.delta, và byte âm thanh nằm trongevent["delta"], không phảievent["audio"]. Bản chép lời nguồn và bản dịch đến tách biệt:Một trường hợp biên: nếu âm thanh nguồn đã ở ngôn ngữ đích, mô hình có thể tạo ra khoảng lặng thay vì chuyển tiếp nguyên trạng.
Hành vi quan sát được
Với các cụm ngắn Anh → Tây Ban Nha, âm thanh dịch bắt đầu trước khi câu nguồn kết thúc. Terminal hiển thị xen kẽ các dòng
[EN]và[ES]khi delta được stream vào. Cặp ngôn ngữ xa hơn có thể đợi lâu hơn để lấy ngữ cảnh. Tôi có thể theo kịp giọng nói đã dịch mà không gặp khó khăn, nhưng hiện không hỗ trợ chọn giọng tuỳ chỉnh.Kết luận: Đạt, có lưu ý.
gpt-realtime-translatehoạt động tốt cho dịch trực tiếp. Nó kém hữu ích khi cần kiểm soát thuật ngữ hoặc định danh giọng nói thương hiệu.Bài kiểm thử 3: Xây trợ lý giọng nói với luân phiên lượt nói và ngắt lời
Đây là bài kiểm thử
gpt-realtime-2: một tác nhân giọng nói biết lắng nghe, nói, giữ ngữ cảnh và có thể gọi công cụ. Đây cũng là điểm mà mã phía khách bắt đầu quan trọng hơn, vì phát lại và trạng thái lượt nói có thể bị lệch nhịp.Chúng ta đang kiểm thử gì
gpt-realtime-2là mô hình lý luận từ giọng nói tới giọng nói. Nó tránh pipeline tách biệt STT → LLM → TTS, và cửa sổ ngữ cảnh 128K cho phép phiên dài có nhiều không gian hơn. Mức độ lý luận được điều khiển bằngreasoning.effort; hãy bắt đầu ởlowtrừ khi tác vụ cần nhiều lý luận hơn, vì thiết lập cao sẽ thêm độ trễ.Đi qua mã
Thiết lập dưới đây dùng
semantic_vad, vốn dựa trên tín hiệu lời nói chứ không chỉ khoảng lặng.eagernessđiều khiển mức nhanh mà mô hình quyết định người dùng đã nói xong. Những phần cần chú ý là tên mô hình, thiết lập đầu ra âm thanh,response.createthủ công và tên sự kiện âm thanh của trợ lý:Khi bản chép lời của người dùng hoàn tất, client tạo phản hồi của trợ lý. Âm thanh của trợ lý sau đó đến dưới dạng
response.output_audio.delta, không phảiresponse.audio.delta.Xử lý ngắt lời
Chuỗi ngắt lời rất dễ làm sai. Khi người dùng nói chồng lên trợ lý, máy chủ gửi
input_audio_buffer.speech_started. Client dừng phát lại, ghi nhận lượng âm thanh đã phát, và gửiconversation.item.truncatevớiaudio_end_msđể đánh dấu vị trí bị cắt. Nếu không, máy chủ sẽ tiếp tục chép lại phần văn bản mà người dùng chưa từng nghe, và lượt kế tiếp sẽ lệch nhịp.Một vấn đề thực tế với loa laptop: micro có thể thu lại âm thanh của trợ lý và gửi ngược về mô hình. Script mẫu dùng
MUTE_MIC_DURING_ASSISTANT = Trueđể tắt luồng đầu vào khi trợ lý đang nói và thêm một khoảng hạ nhiệt ngắn sau đó. Chỉ đặtFalsenếu bạn dùng tai nghe và muốn hỗ trợ ngắt lời.Việc cắt gọn giữ cho máy chủ và client đồng bộ. Hình do Tác giả thực hiện.
WebRTC và SIP xử lý nhiều phần đệm hơn. Với tuyến WebSocket dùng trong hướng dẫn này, client phải tự đảm nhận. Bộ đếm trong script mẫu là đủ cho bản demo; mã sản xuất nên theo dõi timestamp từ luồng đầu ra âm thanh.
Cấu hình preamble để giảm độ trễ do lý luận
Khi
reasoning.efforttrênlow, khoảng lặng trở nên đáng chú ý. Có thể thêm các preamble ngắn bằng lời vào system prompt:Hành vi này được ghi lại cho
gpt-realtime-2.Hành vi quan sát được
Luân phiên lượt nói hoạt động ở thiết lập mặc định trong phòng yên tĩnh. Với loa laptop, tôi cần tắt mic; nếu không, mô hình nghe chính âm thanh của mình và bắt đầu vòng vọng.
Trong phòng ồn hơn, thiết lập VAD và vị trí micro quan trọng hơn. Bộ nhớ hội thoại ổn định trong bài thử mười phút, nhưng tôi sẽ không phát hành ứng dụng dài hơn nếu thiếu kế hoạch reconnect.
Kết luận: Đạt cho vòng thoại cốt lõi.
gpt-realtime-2xử lý tốt trợ lý với mức lý luận thấp trong thử nghiệm của tôi. Phần việc thêm nằm ở client: phát lại, xử lý ngắt lời, reconnect, và gọi công cụ nếu ứng dụng cần.Demo Streamlit: Ba mô hình trong một giao diện
Ứng dụng Streamlit đặt các bài kiểm thử sau bộ chọn thẻ. Nó cho phép bạn ghi âm, chọn ngôn ngữ đích và so sánh các tuyến mô hình mà không cần sửa script. Tôi giữ nó như ứng dụng demo thay vì con đường chính để dạy, vì các script terminal hiển thị sự kiện trực quan hơn.
Ba mô hình trong một giao diện dạng thẻ. Hình do Tác giả thực hiện.
Video demo dưới đây cho thấy các thẻ hoạt động với API key thật. Mỗi thẻ dùng các cuộc gọi Realtime WebSocket thực.