GPT-Realtime-2 API ट्यूटोरियल: तीन टेस्ट, तीन फैसले
जानें कि OpenAI के gpt-realtime-2, gpt-realtime-translate, और gpt-realtime-whisper में क्या अंतर है, फिर हर एक को काम करने वाले Python WebSocket कोड के साथ टेस्ट करें।
हमारा GPT-Realtime-2 पर ओवरव्यू आर्टिकल लॉन्च, बेंचमार्क दावे, और क्यों OpenAI ने रियलटाइम वॉइस को एक छोटे मॉडल परिवार में बाँटा—इन सबको कवर किया था। यह ट्यूटोरियल वहीं से शुरू होता है जहाँ वह लेख रुका था: API से कनेक्ट करना, ऑडियो भेजना, और कोड में होने वाले बदलाव देखना।
यह विभाजन व्यवहार में मायने रखता है। टेस्ट 1gpt-realtime-whisper को ट्रांसक्रिप्शन के लिए उपयोग करता है, टेस्ट 2 gpt-realtime-translateको लाइव अनुवाद के लिए, और टेस्ट 3 gpt-realtime-2को वॉइस असिस्टेंट के लिए। मुख्य मॉडल सरल कार्यों जैसे अनुवाद या ट्रांसक्रिप्शन के लिए भी काम करता है, लेकिन तब आप ऐसी रीजनिंग और रेस्पॉन्स मोडलिटीज़ के लिए भुगतान करेंगे जो आवश्यक नहीं हैं—यानि ओवरकिल होगा।
Python में GPT-Realtime-2 API सेट करना
टेस्ट से पहले, ट्रांसपोर्ट, ऑथेंटिकेशन, और ऑडियो फ़ॉर्मेट को अलग समझना मददगार है। ये विवरण उदाहरणों में लगभग समान रहते हैं। मॉडल एंडपॉइंट्स और इवेंट नाम बदलते हैं—जैसे-जैसे लेख टेक्स्ट आउटपुट से अनुवादित स्पीच और फिर पूर्ण वॉइस लूप की ओर बढ़ता है।
WebRTC और WebSocket में चयन
OpenAI डॉक्यूमेंटेशन एक सीधा नियम देता है: ब्राउज़र और मोबाइल क्लाइंट्स के लिए WebRTC उपयोग करें, और सर्वर-साइड एप्लिकेशन्स के लिए WebSockets। WebRTC जिटर बफ़रिंग और ऑडियो ट्रांसपोर्ट को संभालता है। जब बैकएंड पहले से टेलीफोनी प्रोवाइडर या मीडिया पाइपलाइन से रॉ ऑडियो प्राप्त करता है, तब WebSockets समझ में आते हैं।
Realtime API के लिए दो ट्रांसपोर्ट पथ। छवि: लेखक द्वारा।
इसी कारण, तीनों Python टेस्ट WebSockets का उपयोग करते हैं। यह पथ इवेंट नाम सीधे दिखाता है, इसलिए मॉडल अंतरों को कोड में देखा जा सकता है। ब्राउज़र बिल्ड के लिए, एपhemerल क्लाइंट सीक्रेट्स उपयोग करें ताकि आपका API key फ्रंटएंड तक न पहुँचे।
Python वातावरण और पैकेज
Python 3.9 या नया संस्करण उपयोग करें। सभी चार स्क्रिप्ट्स का पूरा कोड github.com/KhalidAbdelaty/gpt-realtime-api पर उपलब्ध है। पहले इसे क्लोन करें, फिर डिपेंडेंसीज़ इंस्टॉल करें:
git clone https://github.com/KhalidAbdelaty/gpt-realtime-api.git
cd gpt-realtime-api
pip install websocket-client sounddevice numpy python-dotenvसंचालित द्वारा
websocket-clientसॉकेट को हैंडल करता है। sounddeviceमाइक्रोफ़ोन ऑडियो कैप्चर करता है, numpyबफ़र को कन्वर्ट करता है, और python-dotenv API key लोड करता है। macOS पर, sounddevice चलने से पहले आपको brew install portaudio की ज़रूरत हो सकती है। Linux पर portaudio19-dev इंस्टॉल करें।
import os
from dotenv import load_dotenv

load_dotenv()
OPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")संचालित द्वारा
ऑथेंटिकेशन और WebSocket URL
सर्वर-साइड कनेक्शन्स WebSocket हैंडशेक पर Authorization: Bearer हेडर का उपयोग करते हैं। यदि ऐप व्यक्तिगत उपयोगकर्ताओं को ट्रैक करता है, तो OpenAI-Safety-Identifierजोड़ें। आगे के टेस्ट में ये पाथ उपयोग होंगे:
# Voice agent
wss://api.openai.com/v1/realtime?model=gpt-realtime-2# Translation
wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate
# Transcription
wss://api.openai.com/v1/realtime?intent=transcriptionसंचालित द्वारा
वह ट्रांसलेशन पाथ टेस्ट 2 में इसलिए मायने रखता है क्योंकि यह एकमात्र एंडपॉइंट है जो सीधे /v1/realtime का उपयोग नहीं करता।
टेस्ट 1: GPT-Realtime-Whisper के साथ रियल-टाइम ऑडियो ट्रांसक्रिप्शन
ट्रांसक्रिप्शन वह जगह है जहाँ अक्सर ज़रूरत से ज़्यादा बनाया जाता है। यदि आउटपुट केवल टेक्स्ट है, तो ट्रांसक्रिप्शन मॉडल पर्याप्त है।
हम क्या परख रहे हैं
gpt-realtime-whisper ऑडियो लेता है और ट्रांसक्रिप्ट डेल्टाज़ निकालता है। यह न तो रीजनिंग करता है, न टूल्स कॉल करता है, न जवाब देकर बोलता है। यही छोटा काम इसे gpt-realtime-2 के टोकन मॉडल के बजाय ऑडियो अवधि के आधार पर बिल किए जाने तक सीमित रखता है। लागत अनुभाग में इन दरों पर वापस आएँगे।
कोड वॉकथ्रू
मुख्य फ़ील्ड है session.type: "transcription"। यह API को असिस्टेंट रेस्पॉन्सेस छोड़कर केवल ट्रांसक्रिप्ट इवेंट्स देने को कहता है। पूरी स्क्रिप्ट माइक्रोफ़ोन कैप्चर और थ्रेडिंग संभालती है। यह वह हिस्सा है जो Realtime सत्र के व्यवहार को बदलता है:
session_config ={"type":"session.update","session":{"type":"transcription","audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":None}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"input_audio_buffer.append","audio": audio_b64
}))
ws.send(json.dumps({"type":"input_audio_buffer.commit"}))संचालित द्वारा
24 kHz PCM16 मोनो ऑडियो का उपयोग करें, जिसे base64 में एन्कोड किया गया हो। वॉइस एजेंट सत्र के विपरीत, स्क्रिप्ट server_vad टर्न डिटेक्शन के बजाय टाइमर पर इनपुट बफ़र को मैन्युअली कमिट करती है। खाली कमिट्स input_audio_buffer_commit_empty उठाते हैं, इसलिए पूरी स्क्रिप्ट केवल वास्तविक ऑडियो भेजे जाने के बाद ही कमिट करती है।
ट्रांसक्रिप्ट डेल्टाज़ रियल टाइम में शब्द दर शब्द आते हैं। छवि: लेखक द्वारा।
देखा गया व्यवहार
मेरे लोकल टेस्ट में, ट्रांसक्रिप्ट परिणाम कमिट विंडो के भीतर आए—लगभग बोलना शुरू होने के 3 से 4 सेकंड बाद। क्योंकि यह सेटअप VAD के बजाय मैन्युअल कमिट्स पर निर्भर है, लेटेंसी कमिट इंटरवल से बँधी रहती है।
साथ ही, ऑर्डरिंग पर ध्यान दें: ओवरलैपिंग टर्न्स के कम्प्लीशन इवेंट्स क्रम से बाहर आ सकते हैं, इसलिए यदि आप स्ट्रीम के चारों ओर UI बनाते हैं तो item_id से मिलान करें।
ट्रांसक्रिप्शन साइलेंस डिटेक्शन से नहीं, बल्कि आवधिक मैन्युअल कमिट से ट्रिगर होता है। छवि: लेखक द्वारा।
फैसला: पास। सर्वर-साइड लाइव ट्रांसक्रिप्शन के लिए, gpt-realtime-whisper ने इस टेस्ट की ज़रूरत पूरी की। फिर भी, लेटेंसी लक्ष्य तय करने से पहले मैं वास्तविक माइक्रोफ़ोन, उच्चारण, और कमरे के शोर पर टेस्ट करूँगा।
टेस्ट 2: GPT-Realtime-Translate के साथ रियल-टाइम अनुवाद
लाइव स्पीच ट्रांसलेशन पहली नज़र में ट्रांसक्रिप्शन जैसा लगता है, लेकिन सत्र का जीवनचक्र अलग है। ट्रांसलेशन एंडपॉइंट असिस्टेंट रेस्पॉन्स लूप हटा देता है, जिससे उदाहरण छोटा हो जाता है।
हम क्या परख रहे हैं
ट्रांसलेशन सत्रों में न असिस्टेंट टर्न लूप होता है, न response.create। मॉडल एक लाइव इंटरप्रेटर की तरह काम करता है, न कि एक संवादात्मक एजेंट की तरह। Q&A, टूल्स, या बातचीत की स्थिति के लिए, लेख टेस्ट 3 में gpt-realtime-2 पर शिफ्ट होता है।
ट्रांसलेशन सत्र एक समर्पित, अलग एंडपॉइंट का उपयोग करते हैं। छवि: लेखक द्वारा।
मॉडल 70 से अधिक इनपुट भाषाओं और 13 आउटपुट भाषाओं का समर्थन करता है। आप टारगेट session.audio.output.language से सेट करते हैं; स्रोत भाषा डिटेक्शन स्वतः होता है। सीमाएँ साफ़ हैं: कस्टम प्रॉम्प्टिंग नहीं, वॉइस चयन नहीं, और डोमेन ग्लॉसरीज़ नहीं।
कोड वॉकथ्रू
जैसा पहले बताया गया, ट्रांसलेशन /translations WebSocket URL का उपयोग करता है। दो और बातें बदलती हैं: session.audio.output.language टारगेट फ़ील्ड और session.input_audio_buffer.append इवेंट नाम। session. प्रीफ़िक्स पर ध्यान दें। ट्रांसलेशन सत्र यहाँ इसका उपयोग करते हैं।
url ="wss://api.openai.com/v1/realtime/translations?model=gpt-realtime-translate"
session_config ={"type":"session.update","session":{"audio":{"output":{"language":"es"},"input":{"transcription":{"model":"gpt-realtime-whisper"},"noise_reduction":{"type":"near_field"}}}}}
ws.send(json.dumps(session_config))
ws.send(json.dumps({"type":"session.input_audio_buffer.append","audio": audio_b64
}))संचालित द्वारा
ट्रांसलेटेड ऑडियो session.output_audio.delta पर आता है, और ऑडियो बाइट्स event["delta"] में होते हैं, event["audio"] में नहीं। स्रोत और अनुदित ट्रांसक्रिप्ट अलग-अलग आते हैं:
if event_type =="session.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))elif event_type =="session.input_transcript.delta":print("[EN]", event.get("delta",""), end="")elif event_type =="session.output_transcript.delta":print("[ES]", event.get("delta",""), end="")संचालित द्वारा
एक किनारी स्थिति: यदि स्रोत ऑडियो पहले से टारगेट भाषा में है, तो मॉडल पास-थ्रू करने के बजाय साइलेंस पैदा कर सकता है।
देखा गया व्यवहार
छोटे अंग्रेज़ी-से-स्पेनिश वाक्यांशों के लिए, ट्रांसलेटेड ऑडियो स्रोत उच्चारण खत्म होने से पहले शुरू हो गया। टर्मिनल में डेल्टाज़ स्ट्रीम होते समय [EN] और [ES] लाइनें इंटरलीव्ड दिखीं। अधिक दूर की भाषा जोड़ियों को संदर्भ के लिए अधिक इंतज़ार करना पड़ सकता है। मैं अनुदित आवाज़ को बिना समस्या के फ़ॉलो कर सका, लेकिन कस्टम वॉइस चयन उपलब्ध नहीं है।
फैसला: पास, एक सावधानी के साथ।gpt-realtime-translate सीधे लाइव अनुवाद के लिए काम आया। जब शब्दावली नियंत्रण या वॉइस ब्रांडिंग मायने रखती है, तब इसकी उपयोगिता कम हो जाती है।
टेस्ट 3: टर्न-टेकिंग और बार्ज-इन के साथ वॉइस असिस्टेंट बनाना
यह gpt-realtime-2 का टेस्ट है: एक वॉइस एजेंट जो सुनता है, बोलता है, संदर्भ रखता है, और टूल्स कॉल कर सकता है। यहीं से क्लाइंट कोड और महत्व रखता है, क्योंकि प्लेबैक और टर्न स्टेट आउट-ऑफ-सिंक हो सकते हैं।
हम क्या परख रहे हैं
gpt-realtime-2 एक स्पीच-टू-स्पीच रीजनिंग मॉडल है। यह अलग STT-से-LLM-से-TTS पाइपलाइन से बचता है, और इसका 128K कॉन्टेक्स्ट विंडो लंबी सेशन्स के लिए अधिक जगह देता है। रीजनिंग को reasoning.effort से नियंत्रित किया जाता है; तब तक low से शुरू करें जब तक कार्य को अधिक रीजनिंग की आवश्यकता न हो, क्योंकि उच्च सेटिंग्स लेटेंसी बढ़ाती हैं।
코ड वॉकथ्रू
नीचे का सेटअप semantic_vad का उपयोग करता है, जो केवल साइलेंस के बजाय स्पीच संकेतों को देखता है। eagerness नियंत्रित करता है कि मॉडल कितनी जल्दी मानता है कि उपयोगकर्ता बोल चुका है। ध्यान देने योग्य हिस्से हैं: मॉडल नाम, ऑडियो आउटपुट सेटिंग्स, मैन्युअल response.create, और असिस्टेंट ऑडियो इवेंट नाम:
session_config ={"type":"session.update","session":{"type":"realtime","model":"gpt-realtime-2","output_modalities":["audio"],"audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":{"type":"semantic_vad","eagerness":"medium","create_response":False,"interrupt_response":True}},"output":{"format":{"type":"audio/pcm","rate":24000},"voice":"marin"}},"instructions":"You are a helpful voice assistant. Keep answers short.","reasoning":{"effort":"low"}}}संचालित द्वारा
जब उपयोगकर्ता का ट्रांसक्रिप्ट पूरा होता है, तो क्लाइंट असिस्टेंट रेस्पॉन्स बनाता है। असिस्टेंट ऑडियो फिर response.output_audio.delta के रूप में आता है, response.audio.delta के रूप में नहीं।
if event_type =="conversation.item.input_audio_transcription.completed":
ws.send(json.dumps({"type":"response.create"}))elif event_type =="response.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))संचालित द्वारा
बार्ज-इन को संभालना
इंटरप्शन सीक्वेंस को गलत करना आसान है। जब उपयोगकर्ता असिस्टेंट के ऊपर बोलता है, तो सर्वर input_audio_buffer.speech_started भेजता है। क्लाइंट प्लेबैक रोकता है, जितना ऑडियो चलाया गया उसे रिकॉर्ड करता है, और conversation.item.truncate के साथ audio_end_ms भेजता है ताकि जहाँ कट-ऑफ हुआ वह ट्रैक हो सके। अन्यथा, सर्वर उस टेक्स्ट का ट्रांसक्रिप्शन करता रहता है जिसे उपयोगकर्ता ने कभी सुना ही नहीं, और अगला टर्न बिगड़ा हुआ लग सकता है।
if current_response_item_id and playback_position_ms >0:
ws.send(json.dumps({"type":"conversation.item.truncate","item_id": current_response_item_id,"content_index":0,"audio_end_ms": playback_position_ms
}))संचालित द्वारा
लैपटॉप स्पीकर्स की एक व्यावहारिक दिक्कत: माइक्रोफ़ोन असिस्टेंट का ऑडियो पिक कर सकता है और उसे मॉडल को वापस भेज सकता है। सैंपल स्क्रिप्ट MUTE_MIC_DURING_ASSISTANT = True का उपयोग करती है ताकि असिस्टेंट के बोलते समय और थोड़ी कूलडाउन अवधि के लिए इनपुट स्ट्रीम को साइलेंस किया जाए। इसे केवल तभी False करें जब आप हेडफ़ोन उपयोग कर रहे हों और इंटरप्शन सपोर्ट चाहते हों।
ट्रंकेशन सर्वर और क्लाइंट को सिंक में रखता है। छवि: लेखक द्वारा।
WebRTC और SIP इस बफ़रिंग का अधिक हिस्सा संभालते हैं। इस ट्यूटोरियल में उपयोग किए गए WebSocket पथ पर, यह क्लाइंट की ज़िम्मेदारी है। सैंपल स्क्रिप्ट का काउंटर डेमो के लिए पर्याप्त है; प्रोडक्शन कोड को ऑडियो आउटपुट स्ट्रीम से टाइमस्टैम्प्स ट्रैक करने चाहिए।
रीजनिंग लेटेंसी के लिए प्रीएम्बल कॉन्फ़िगर करना
जब reasoning.effortlow से ऊपर होता है, साइलेंस महसूस होने लगता है। सिस्टम प्रॉम्प्ट में छोटे बोले जाने वाले प्रीएम्बल जोड़े जा सकते हैं:
# Preambles
Use a short spoken update before longer tasks.
Keep preambles under five seconds.
Skip preambles for short factual questions.संचालित द्वारा
यह व्यवहार gpt-realtime-2 के लिए प्रलेखित है।
देखा गया व्यवहार
एक शांत कमरे में डिफ़ॉल्ट सेटिंग्स पर टर्न-टेकिंग ठीक से काम की। लैपटॉप स्पीकर्स के साथ, मुझे माइक म्यूटिंग की ज़रूरत पड़ी; उसके बिना, मॉडल अपनी ही आउटपुट सुनकर इको लूप शुरू कर देता था।
ज़्यादा शोर वाले कमरों में, VAD सेटिंग्स और माइक्रोफ़ोन की पोजिशनिंग ज़्यादा मायने रखती थीं। दस मिनट के टेस्ट में बातचीत की मेमोरी सुसंगत रही, लेकिन बिना रीकनेक्ट प्लान के मैं इससे लंबा ऐप शिप नहीं करूँगा।
फैसला: कोर वॉइस लूप के लिए पास।gpt-realtime-2 ने मेरे टेस्ट में लो-रीजनिंग-एफ़र्ट असिस्टेंट को संभाला। अतिरिक्त काम क्लाइंट पर है: प्लेबैक, इंटरप्शन हैंडलिंग, रीकनेक्ट्स, और जरुरत हो तो टूल कॉल्स।
Streamlit डेमो: एक इंटरफ़ेस में तीनों मॉडल
Streamlit ऐप टैब सेलेक्टर के पीछे टेस्ट रखता है। यह आपको ऑडियो रिकॉर्ड करने, टारगेट भाषा चुनने, और स्क्रिप्ट्स एडिट किए बिना मॉडल पाथ्स की तुलना करने देता है। मैंने इसे मुख्य शिक्षण पथ के बजाय डेमो ऐप के रूप में रखा, क्योंकि टर्मिनल स्क्रिप्ट्स इवेंट्स को अधिक सीधे दिखाती हैं।
एक टैब्ड इंटरफ़ेस में तीन मॉडल। छवि: लेखक द्वारा।
नीचे दिया गया डेमो वीडियो एक लाइव API key के साथ टैब्स दिखाता है। प्रत्येक टैब वास्तविक Realtime WebSocket कॉल्स का उपयोग करता है।
आपका API key साइडबार में जाता है और कहीं भी स्टोर नहीं होता। पब्लिक ऐप के लिए, इसे Streamlit Secrets में रखें।
व्यवहार में GPT-Realtime-2 की लागत और लेटेंसी
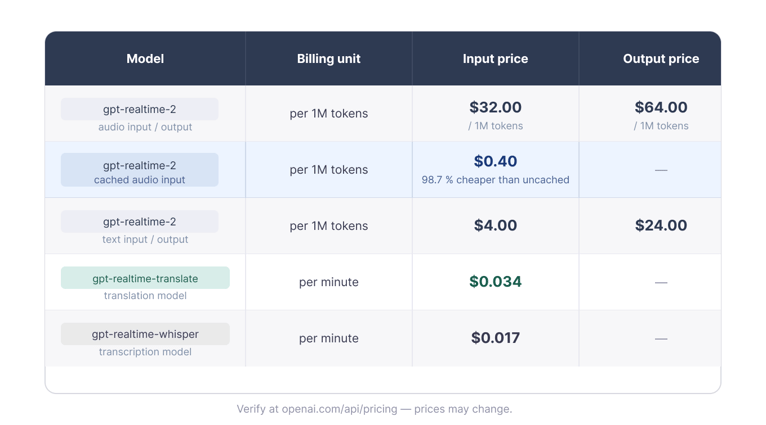
जैसा कि टेस्ट 1 में उल्लेख किया गया, प्राइसिंग दो समूहों में बँटती है: gpt-realtime-2 टोकन के हिसाब से बिल होता है, जबकि ट्रांसलेशन और ट्रांसक्रिप्शन मिनट के हिसाब से।
मॉडल के अनुसार टोकन और मिनट बिलिंग। छवि: लेखक द्वारा।
ट्रांसक्रिप्शन और ट्रांसलेशन के लिए, लागत अवधि के साथ स्केल होती है। लिखते समय, तीस मिनट की लागत gpt-realtime-whisper पर लगभग $0.51 और gpt-realtime-translate पर लगभग $1.02 है।
वॉइस एजेंट्स का अनुमान लगाना कठिन है क्योंकि ऑडियो टोकन बातचीत के दोनों पक्षों पर जुड़ते हैं। सत्र की लंबाई, बोलने का अनुपात, रीजनिंग प्रयास, और संदर्भ का आकार सभी मायने रखते हैं। जब बातचीत के शुरुआती टर्न स्थिर रहते हैं, तो प्रॉम्प्ट कैशिंग लागत कम कर सकती है।
REST ट्रांसक्रिप्शन कॉल प्लस TTS एक अलग तुलना है—जब तक लाइव इंटरैक्शन आवश्यक न हो। फ़ाइलों के लिए whisper-1 सस्ता है, लेकिन यह उसी तरह का API नहीं है।
GPT-Realtime-2 API सीमाएँ, ऑडियो आवश्यकताएँ, और ट्रबलशूटिंग
ये वे सीमाएँ हैं जिन्होंने मेरे शुरुआती टेस्ट रन को प्रभावित किया। अधिकतर विफलताएँ मॉडल से नहीं, बल्कि ऑडियो फ़ॉर्मेटिंग या सत्र जीवनचक्र की गलतियों से आईं।
ट्रांसपोर्ट और ऑडियो बाधाएँ
पहले टेस्ट में नोट किया गया था कि WebSocket ऑडियो PCM16, 24 kHz, मोनो, और base64-एन्कोडेड होना चाहिए। प्रत्येक input_audio_buffer.append इवेंट 15 MB पर कैप्ड है, इसलिए 50-मिलीसेकंड के चंक्स इस सीमा से काफी नीचे रहते हैं। टेलीफोनी के लिए G.711 भी समर्थित है।
Realtime सत्र OpenAI पर 60 मिनट और Azure OpenAI पर 30 मिनट के बाद समाप्त हो जाते हैं। लंबे ऐप्स को रीकनेक्ट प्लान और स्टेट को फिर से बनाने का तरीका चाहिए। वॉइस भी पहली ऑडियो आउटपुट से पहले चुनी जानी चाहिए; सत्र के मध्य में इसे बदला नहीं जा सकता।
रेट लिमिट्स और कोटा
रेट लिमिट्स टियर-आधारित और प्रोजेक्ट-विशिष्ट हैं। टियर 1 में वर्तमान में gpt-realtime-2 के लिए प्रति मिनट 200 रिक्वेस्ट और प्रति मिनट 40,000 टोकन्स सूचीबद्ध हैं। फ्री टियर समर्थित नहीं है।
आम त्रुटियाँ और खुरदुरे किनारे
मेरे द्वारा सबसे अधिक देखी गई त्रुटियाँ खाली बफ़र कमिट्स और गलत ऑडियो फ़ॉर्मेटिंग थीं। वॉइस एजेंट्स के लिए, फ़ीडबैक लूप्स पर भी नज़र रखें जहाँ माइक्रोफ़ोन असिस्टेंट के स्पीकर आउटपुट को सुन लेता है। हेडफ़ोन, इको कैंसलेशन, या माइक म्यूटिंग का उपयोग करें।
लंबे सत्रों के लिए, समाप्ति का इंतज़ार करने के बजाय लगभग 55 मिनट पर रीकनेक्ट करें। एक डॉक्यूमेंटेशन पेचीदगी: gpt-realtime-2 मॉडल पेज पर एक सामान्य "Streaming: Not supported" पंक्ति है, जबकि Realtime गाइड्स /v1/realtime उपयोग प्रलेखित करते हैं। वह पंक्ति Chat Completions स्ट्रीमिंग के बारे में है, न कि Realtime API व्यवहार के।
अंतिम फैसला
तीनों टेस्ट में एक ही पैटर्न दिखता है: हर काम का अपना मॉडल और एंडपॉइंट है। यह विभाजन प्रभावित करता है कि मॉडल क्या कर सकता है, बिलिंग कैसे होती है, और आपको कितना क्लाइंट कोड संभालना पड़ता है।
जैसा ऊपर दिखाया गया, gpt-realtime-whisper लाइव टेक्स्ट को कवर करता है, gpt-realtime-translate सीधा स्पीच ट्रांसलेशन को, और gpt-realtime-2 स्पीच, रीजनिंग, और संदर्भ के साथ असिस्टेंट व्यवहार को।
कोड यह नहीं दिखाता कि एक मॉडल बाकी को बदल देता है। यह दिखाता है कि रियलटाइम वॉइस ऐप्स सत्र डिज़ाइन पर निर्भर करते हैं। मेरा शुरुआती बिंदु वही सबसे छोटा मॉडल होगा जो काम से मेल खाता हो, और बाकी इंजीनियरिंग समय ऑडियो गुणवत्ता, टर्न-टेकिंग, रीकनेक्ट्स, और क्लाइंट स्टेट पर लगेगा।
यदि आप लाइव इंटरैक्शन पर केंद्रित किसी प्रतिस्पर्धी मॉडल में रुचि रखते हैं, तो मैं हमारे Thinking Machines Lab के TML-Interaction-Small पर गाइड पढ़ने की सिफारिश करता हूँ। OpenAI ऑडियो मॉडलों की पृष्ठभूमि के लिए, हमारे ट्यूटोरियल संबंधित ऑडियो और रियलटाइम API विषयों को कवर करते हैं:
मैं एक डेटा इंजीनियर और कम्युनिटी बिल्डर हूँ, जो डेटा पाइपलाइनों, क्लाउड, और AI टूलिंग के साथ काम करता/करती हूँ, साथ ही DataCamp और उभरते डेवलपर्स के लिए व्यावहारिक, असरदार ट्यूटोरियल लिखता/लिखती हूँ।



हमारा GPT-Realtime-2 पर ओवरव्यू आर्टिकल लॉन्च, बेंचमार्क दावे, और क्यों OpenAI ने रियलटाइम वॉइस को एक छोटे मॉडल परिवार में बाँटा—इन सबको कवर किया था। यह ट्यूटोरियल वहीं से शुरू होता है जहाँ वह लेख रुका था: API से कनेक्ट करना, ऑडियो भेजना, और कोड में होने वाले बदलाव देखना।
यह विभाजन व्यवहार में मायने रखता है। टेस्ट 1
gpt-realtime-whisperको ट्रांसक्रिप्शन के लिए उपयोग करता है, टेस्ट 2gpt-realtime-translateको लाइव अनुवाद के लिए, और टेस्ट 3gpt-realtime-2को वॉइस असिस्टेंट के लिए। मुख्य मॉडल सरल कार्यों जैसे अनुवाद या ट्रांसक्रिप्शन के लिए भी काम करता है, लेकिन तब आप ऐसी रीजनिंग और रेस्पॉन्स मोडलिटीज़ के लिए भुगतान करेंगे जो आवश्यक नहीं हैं—यानि ओवरकिल होगा।Python में GPT-Realtime-2 API सेट करना
टेस्ट से पहले, ट्रांसपोर्ट, ऑथेंटिकेशन, और ऑडियो फ़ॉर्मेट को अलग समझना मददगार है। ये विवरण उदाहरणों में लगभग समान रहते हैं। मॉडल एंडपॉइंट्स और इवेंट नाम बदलते हैं—जैसे-जैसे लेख टेक्स्ट आउटपुट से अनुवादित स्पीच और फिर पूर्ण वॉइस लूप की ओर बढ़ता है।
WebRTC और WebSocket में चयन
OpenAI डॉक्यूमेंटेशन एक सीधा नियम देता है: ब्राउज़र और मोबाइल क्लाइंट्स के लिए WebRTC उपयोग करें, और सर्वर-साइड एप्लिकेशन्स के लिए WebSockets। WebRTC जिटर बफ़रिंग और ऑडियो ट्रांसपोर्ट को संभालता है। जब बैकएंड पहले से टेलीफोनी प्रोवाइडर या मीडिया पाइपलाइन से रॉ ऑडियो प्राप्त करता है, तब WebSockets समझ में आते हैं।
Realtime API के लिए दो ट्रांसपोर्ट पथ। छवि: लेखक द्वारा।
इसी कारण, तीनों Python टेस्ट WebSockets का उपयोग करते हैं। यह पथ इवेंट नाम सीधे दिखाता है, इसलिए मॉडल अंतरों को कोड में देखा जा सकता है। ब्राउज़र बिल्ड के लिए, एपhemerल क्लाइंट सीक्रेट्स उपयोग करें ताकि आपका API key फ्रंटएंड तक न पहुँचे।
Python वातावरण और पैकेज
Python 3.9 या नया संस्करण उपयोग करें। सभी चार स्क्रिप्ट्स का पूरा कोड github.com/KhalidAbdelaty/gpt-realtime-api पर उपलब्ध है। पहले इसे क्लोन करें, फिर डिपेंडेंसीज़ इंस्टॉल करें:
websocket-clientसॉकेट को हैंडल करता है।sounddeviceमाइक्रोफ़ोन ऑडियो कैप्चर करता है,numpyबफ़र को कन्वर्ट करता है, औरpython-dotenvAPI key लोड करता है। macOS पर,sounddeviceचलने से पहले आपकोbrew install portaudioकी ज़रूरत हो सकती है। Linux परportaudio19-devइंस्टॉल करें।प्रोजेक्ट की रूट में एक
.envफ़ाइल बनाएं:फिर हर स्क्रिप्ट में इसे लोड करें:
ऑथेंटिकेशन और WebSocket URL
सर्वर-साइड कनेक्शन्स WebSocket हैंडशेक पर
Authorization: Bearerहेडर का उपयोग करते हैं। यदि ऐप व्यक्तिगत उपयोगकर्ताओं को ट्रैक करता है, तोOpenAI-Safety-Identifierजोड़ें। आगे के टेस्ट में ये पाथ उपयोग होंगे:वह ट्रांसलेशन पाथ टेस्ट 2 में इसलिए मायने रखता है क्योंकि यह एकमात्र एंडपॉइंट है जो सीधे
/v1/realtimeका उपयोग नहीं करता।टेस्ट 1: GPT-Realtime-Whisper के साथ रियल-टाइम ऑडियो ट्रांसक्रिप्शन
ट्रांसक्रिप्शन वह जगह है जहाँ अक्सर ज़रूरत से ज़्यादा बनाया जाता है। यदि आउटपुट केवल टेक्स्ट है, तो ट्रांसक्रिप्शन मॉडल पर्याप्त है।
हम क्या परख रहे हैं
gpt-realtime-whisperऑडियो लेता है और ट्रांसक्रिप्ट डेल्टाज़ निकालता है। यह न तो रीजनिंग करता है, न टूल्स कॉल करता है, न जवाब देकर बोलता है। यही छोटा काम इसेgpt-realtime-2के टोकन मॉडल के बजाय ऑडियो अवधि के आधार पर बिल किए जाने तक सीमित रखता है। लागत अनुभाग में इन दरों पर वापस आएँगे।कोड वॉकथ्रू
मुख्य फ़ील्ड है
session.type: "transcription"। यह API को असिस्टेंट रेस्पॉन्सेस छोड़कर केवल ट्रांसक्रिप्ट इवेंट्स देने को कहता है। पूरी स्क्रिप्ट माइक्रोफ़ोन कैप्चर और थ्रेडिंग संभालती है। यह वह हिस्सा है जो Realtime सत्र के व्यवहार को बदलता है:24 kHz PCM16 मोनो ऑडियो का उपयोग करें, जिसे base64 में एन्कोड किया गया हो। वॉइस एजेंट सत्र के विपरीत, स्क्रिप्ट
server_vadटर्न डिटेक्शन के बजाय टाइमर पर इनपुट बफ़र को मैन्युअली कमिट करती है। खाली कमिट्सinput_audio_buffer_commit_emptyउठाते हैं, इसलिए पूरी स्क्रिप्ट केवल वास्तविक ऑडियो भेजे जाने के बाद ही कमिट करती है।ट्रांसक्रिप्ट डेल्टाज़ रियल टाइम में शब्द दर शब्द आते हैं। छवि: लेखक द्वारा।
देखा गया व्यवहार
मेरे लोकल टेस्ट में, ट्रांसक्रिप्ट परिणाम कमिट विंडो के भीतर आए—लगभग बोलना शुरू होने के 3 से 4 सेकंड बाद। क्योंकि यह सेटअप VAD के बजाय मैन्युअल कमिट्स पर निर्भर है, लेटेंसी कमिट इंटरवल से बँधी रहती है।
साथ ही, ऑर्डरिंग पर ध्यान दें: ओवरलैपिंग टर्न्स के कम्प्लीशन इवेंट्स क्रम से बाहर आ सकते हैं, इसलिए यदि आप स्ट्रीम के चारों ओर UI बनाते हैं तो
item_idसे मिलान करें।ट्रांसक्रिप्शन साइलेंस डिटेक्शन से नहीं, बल्कि आवधिक मैन्युअल कमिट से ट्रिगर होता है। छवि: लेखक द्वारा।
फैसला: पास। सर्वर-साइड लाइव ट्रांसक्रिप्शन के लिए,
gpt-realtime-whisperने इस टेस्ट की ज़रूरत पूरी की। फिर भी, लेटेंसी लक्ष्य तय करने से पहले मैं वास्तविक माइक्रोफ़ोन, उच्चारण, और कमरे के शोर पर टेस्ट करूँगा।टेस्ट 2: GPT-Realtime-Translate के साथ रियल-टाइम अनुवाद
लाइव स्पीच ट्रांसलेशन पहली नज़र में ट्रांसक्रिप्शन जैसा लगता है, लेकिन सत्र का जीवनचक्र अलग है। ट्रांसलेशन एंडपॉइंट असिस्टेंट रेस्पॉन्स लूप हटा देता है, जिससे उदाहरण छोटा हो जाता है।
हम क्या परख रहे हैं
ट्रांसलेशन सत्रों में न असिस्टेंट टर्न लूप होता है, न
response.create। मॉडल एक लाइव इंटरप्रेटर की तरह काम करता है, न कि एक संवादात्मक एजेंट की तरह। Q&A, टूल्स, या बातचीत की स्थिति के लिए, लेख टेस्ट 3 मेंgpt-realtime-2पर शिफ्ट होता है।ट्रांसलेशन सत्र एक समर्पित, अलग एंडपॉइंट का उपयोग करते हैं। छवि: लेखक द्वारा।
मॉडल 70 से अधिक इनपुट भाषाओं और 13 आउटपुट भाषाओं का समर्थन करता है। आप टारगेट
session.audio.output.languageसे सेट करते हैं; स्रोत भाषा डिटेक्शन स्वतः होता है। सीमाएँ साफ़ हैं: कस्टम प्रॉम्प्टिंग नहीं, वॉइस चयन नहीं, और डोमेन ग्लॉसरीज़ नहीं।कोड वॉकथ्रू
जैसा पहले बताया गया, ट्रांसलेशन
/translationsWebSocket URL का उपयोग करता है। दो और बातें बदलती हैं:session.audio.output.languageटारगेट फ़ील्ड औरsession.input_audio_buffer.appendइवेंट नाम।session.प्रीफ़िक्स पर ध्यान दें। ट्रांसलेशन सत्र यहाँ इसका उपयोग करते हैं।ट्रांसलेटेड ऑडियो
session.output_audio.deltaपर आता है, और ऑडियो बाइट्सevent["delta"]में होते हैं,event["audio"]में नहीं। स्रोत और अनुदित ट्रांसक्रिप्ट अलग-अलग आते हैं:एक किनारी स्थिति: यदि स्रोत ऑडियो पहले से टारगेट भाषा में है, तो मॉडल पास-थ्रू करने के बजाय साइलेंस पैदा कर सकता है।
देखा गया व्यवहार
छोटे अंग्रेज़ी-से-स्पेनिश वाक्यांशों के लिए, ट्रांसलेटेड ऑडियो स्रोत उच्चारण खत्म होने से पहले शुरू हो गया। टर्मिनल में डेल्टाज़ स्ट्रीम होते समय
[EN]और[ES]लाइनें इंटरलीव्ड दिखीं। अधिक दूर की भाषा जोड़ियों को संदर्भ के लिए अधिक इंतज़ार करना पड़ सकता है। मैं अनुदित आवाज़ को बिना समस्या के फ़ॉलो कर सका, लेकिन कस्टम वॉइस चयन उपलब्ध नहीं है।फैसला: पास, एक सावधानी के साथ।
gpt-realtime-translateसीधे लाइव अनुवाद के लिए काम आया। जब शब्दावली नियंत्रण या वॉइस ब्रांडिंग मायने रखती है, तब इसकी उपयोगिता कम हो जाती है।टेस्ट 3: टर्न-टेकिंग और बार्ज-इन के साथ वॉइस असिस्टेंट बनाना
यह
gpt-realtime-2का टेस्ट है: एक वॉइस एजेंट जो सुनता है, बोलता है, संदर्भ रखता है, और टूल्स कॉल कर सकता है। यहीं से क्लाइंट कोड और महत्व रखता है, क्योंकि प्लेबैक और टर्न स्टेट आउट-ऑफ-सिंक हो सकते हैं।हम क्या परख रहे हैं
gpt-realtime-2एक स्पीच-टू-स्पीच रीजनिंग मॉडल है। यह अलग STT-से-LLM-से-TTS पाइपलाइन से बचता है, और इसका 128K कॉन्टेक्स्ट विंडो लंबी सेशन्स के लिए अधिक जगह देता है। रीजनिंग कोreasoning.effortसे नियंत्रित किया जाता है; तब तकlowसे शुरू करें जब तक कार्य को अधिक रीजनिंग की आवश्यकता न हो, क्योंकि उच्च सेटिंग्स लेटेंसी बढ़ाती हैं।코ड वॉकथ्रू
नीचे का सेटअप
semantic_vadका उपयोग करता है, जो केवल साइलेंस के बजाय स्पीच संकेतों को देखता है।eagernessनियंत्रित करता है कि मॉडल कितनी जल्दी मानता है कि उपयोगकर्ता बोल चुका है। ध्यान देने योग्य हिस्से हैं: मॉडल नाम, ऑडियो आउटपुट सेटिंग्स, मैन्युअलresponse.create, और असिस्टेंट ऑडियो इवेंट नाम:जब उपयोगकर्ता का ट्रांसक्रिप्ट पूरा होता है, तो क्लाइंट असिस्टेंट रेस्पॉन्स बनाता है। असिस्टेंट ऑडियो फिर
response.output_audio.deltaके रूप में आता है,response.audio.deltaके रूप में नहीं।बार्ज-इन को संभालना
इंटरप्शन सीक्वेंस को गलत करना आसान है। जब उपयोगकर्ता असिस्टेंट के ऊपर बोलता है, तो सर्वर
input_audio_buffer.speech_startedभेजता है। क्लाइंट प्लेबैक रोकता है, जितना ऑडियो चलाया गया उसे रिकॉर्ड करता है, औरconversation.item.truncateके साथaudio_end_msभेजता है ताकि जहाँ कट-ऑफ हुआ वह ट्रैक हो सके। अन्यथा, सर्वर उस टेक्स्ट का ट्रांसक्रिप्शन करता रहता है जिसे उपयोगकर्ता ने कभी सुना ही नहीं, और अगला टर्न बिगड़ा हुआ लग सकता है।लैपटॉप स्पीकर्स की एक व्यावहारिक दिक्कत: माइक्रोफ़ोन असिस्टेंट का ऑडियो पिक कर सकता है और उसे मॉडल को वापस भेज सकता है। सैंपल स्क्रिप्ट
MUTE_MIC_DURING_ASSISTANT = Trueका उपयोग करती है ताकि असिस्टेंट के बोलते समय और थोड़ी कूलडाउन अवधि के लिए इनपुट स्ट्रीम को साइलेंस किया जाए। इसे केवल तभीFalseकरें जब आप हेडफ़ोन उपयोग कर रहे हों और इंटरप्शन सपोर्ट चाहते हों।ट्रंकेशन सर्वर और क्लाइंट को सिंक में रखता है। छवि: लेखक द्वारा।
WebRTC और SIP इस बफ़रिंग का अधिक हिस्सा संभालते हैं। इस ट्यूटोरियल में उपयोग किए गए WebSocket पथ पर, यह क्लाइंट की ज़िम्मेदारी है। सैंपल स्क्रिप्ट का काउंटर डेमो के लिए पर्याप्त है; प्रोडक्शन कोड को ऑडियो आउटपुट स्ट्रीम से टाइमस्टैम्प्स ट्रैक करने चाहिए।
रीजनिंग लेटेंसी के लिए प्रीएम्बल कॉन्फ़िगर करना
जब
reasoning.effortlowसे ऊपर होता है, साइलेंस महसूस होने लगता है। सिस्टम प्रॉम्प्ट में छोटे बोले जाने वाले प्रीएम्बल जोड़े जा सकते हैं:यह व्यवहार
gpt-realtime-2के लिए प्रलेखित है।देखा गया व्यवहार
एक शांत कमरे में डिफ़ॉल्ट सेटिंग्स पर टर्न-टेकिंग ठीक से काम की। लैपटॉप स्पीकर्स के साथ, मुझे माइक म्यूटिंग की ज़रूरत पड़ी; उसके बिना, मॉडल अपनी ही आउटपुट सुनकर इको लूप शुरू कर देता था।
ज़्यादा शोर वाले कमरों में, VAD सेटिंग्स और माइक्रोफ़ोन की पोजिशनिंग ज़्यादा मायने रखती थीं। दस मिनट के टेस्ट में बातचीत की मेमोरी सुसंगत रही, लेकिन बिना रीकनेक्ट प्लान के मैं इससे लंबा ऐप शिप नहीं करूँगा।
फैसला: कोर वॉइस लूप के लिए पास।
gpt-realtime-2ने मेरे टेस्ट में लो-रीजनिंग-एफ़र्ट असिस्टेंट को संभाला। अतिरिक्त काम क्लाइंट पर है: प्लेबैक, इंटरप्शन हैंडलिंग, रीकनेक्ट्स, और जरुरत हो तो टूल कॉल्स।Streamlit डेमो: एक इंटरफ़ेस में तीनों मॉडल
Streamlit ऐप टैब सेलेक्टर के पीछे टेस्ट रखता है। यह आपको ऑडियो रिकॉर्ड करने, टारगेट भाषा चुनने, और स्क्रिप्ट्स एडिट किए बिना मॉडल पाथ्स की तुलना करने देता है। मैंने इसे मुख्य शिक्षण पथ के बजाय डेमो ऐप के रूप में रखा, क्योंकि टर्मिनल स्क्रिप्ट्स इवेंट्स को अधिक सीधे दिखाती हैं।
एक टैब्ड इंटरफ़ेस में तीन मॉडल। छवि: लेखक द्वारा।
नीचे दिया गया डेमो वीडियो एक लाइव API key के साथ टैब्स दिखाता है। प्रत्येक टैब वास्तविक Realtime WebSocket कॉल्स का उपयोग करता है।