OpenAI'nin gpt-realtime-2, gpt-realtime-translate ve gpt-realtime-whisper modellerinin nasıl farklılaştığını öğrenin; her birini çalışan Python WebSocket koduyla test edin.
GPT-Realtime-2 üzerine genel bakış makalemiz, lansmanı, karşılaştırma iddialarını ve OpenAI’nin gerçek zamanlı sesi neden küçük bir model ailesine böldüğünü ele almıştı. Bu eğitim, o makalenin bıraktığı yerden devam ediyor: API’ye bağlanmak, ses göndermek ve kodda nelerin değiştiğini görmek.
Bu ayrım uygulamada önemlidir. Test 1 gpt-realtime-whisper�ı deşifre için, Test 2 gpt-realtime-translatei canlı çeviri için ve Test 3 gpt-realtime-2yi bir sesli asistan için kullanır. Ana model, çeviri veya deşifre gibi daha basit görevlerde de çalışır; ancak gerek olmayan bir muhakeme düzeyi ve yanıt biçimlerine ödeme yaparsınız — bu yüzden aşırı olur.
Python’da GPT-Realtime-2 API’yi Kurma
Testlerden önce, taşıma, kimlik doğrulama ve ses biçimini ayırmak faydalıdır. Bu ayrıntılar örnekler boyunca çoğunlukla aynı kalır. Makale metin çıktısından çevrilmiş konuşmaya, ardından tam bir ses döngüsüne geçerken değişen şey model uç noktaları ve olay adlarıdır.
WebRTC ile WebSocket arasında seçim
OpenAI dokümanları basit bir kural verir: tarayıcı ve mobil istemciler için WebRTC, sunucu tarafı uygulamalar için WebSockets kullanın. WebRTC titreme arabelleğini ve ses taşımayı yönetir. WebSocket’ler, arka uç zaten bir telefon sağlayıcısından veya medya hattından ham ses alıyorsa mantıklıdır.
Realtime API için iki taşıma yolu. Görsel: Yazar.
Bu nedenle, üç Python testi de WebSocket kullanır. Bu yol, olay adlarını doğrudan gösterir; böylece model farkları kodda görünür. Bir tarayıcı derlemesi için, API anahtarınızın ön uca asla ulaşmaması adına kısa ömürlü istemci gizlileri kullanın.
Python ortamı ve paketler
Python 3.9 veya daha yenisini kullanın. Dört betiğin tam kodu github.com/KhalidAbdelaty/gpt-realtime-api adresinde mevcuttur. Önce klonlayın, ardından bağımlılıkları kurun:
import os
from dotenv import load_dotenv

load_dotenv()
OPENAI_API_KEY = os.environ.get("OPENAI_API_KEY")Altyapı:
Kimlik doğrulama ve WebSocket URL’si
Sunucu tarafı bağlantılar, WebSocket el sıkışmasında bir Authorization: Bearer başlığı kullanır. Uygulama bireysel kullanıcıları izliyorsa OpenAI-Safety-Identifierekleyin. Testlerde daha sonra kullanılan yollar şunlardır:
Bu çeviri yolu, Test 2’de önem kazanır; çünkü doğrudan /v1/realtime kullanmayan tek uç noktadır.
Test 1: GPT-Realtime-Whisper ile Gerçek Zamanlı Ses Deşifre
Deşifre, aşırı inşa etmenin yaygın olduğu bir alandır. Çıktı yalnızca metinse, deşifre modeli yeterlidir.
Neyi test ediyoruz
gpt-realtime-whisper sesi alır ve transcript deltaları üretir. Muhakeme yapmaz, araç çağırmaz, geri konuşmaz. Bu daha küçük iş, gpt-realtime-2 ile aynı belirteç modeline göre değil, ses süresine göre ücretlendirilmesinin nedenidir. Ücret kısmında bu oranlara geri dönüyoruz.
Koda genel bakış
Temel alan session.type: "transcription". Bu, API’ye asistan yanıtlarını atlamasını ve yalnızca transcript olayları üretmesini söyler. Tam betik ayrıca mikrofon yakalama ve iş parçacıklarını ele alır. Realtime oturum davranışını değiştiren kısım şudur:
Base64 olarak kodlanmış 24 kHz PCM16 mono ses kullanın. Sesli aracı oturumundan farklı olarak, bu betik giriş arabelleğini server_vad dönüş tespiti yerine bir zamanlayıcıyla manuel olarak onaylar. Boş onaylar input_audio_buffer_commit_empty hatası verir; bu yüzden tam betik yalnızca gerçek ses gönderildikten sonra onaylar.
Transcript deltaları sözcük sözcük gerçek zamanlı gelir. Görsel: Yazar.
Gözlenen davranış
Yerel testlerimde, transcript sonuçları konuşma başladıktan sonra yaklaşık 3 ila 4 saniye içinde, onay penceresi dahilinde göründü. Bu kurulum VAD yerine manuel onaylara dayandığından, gecikme onay aralığına bağlıdır.
Ayrıca sıralamaya dikkat edin: çakışan turlardan gelen tamamlama olayları sırayla gelmeyebilir; akış etrafında bir UI kuruyorsanız item_id ile uzlaştırın.
Deşifre, sessizlik tespitiyle değil, periyodik manuel onayla tetiklenir. Görsel: Yazar.
Hüküm: Başarılı. Sunucu tarafı canlı deşifre için gpt-realtime-whisper bu testin ihtiyaçlarını karşıladı. Yine de bir gecikme hedefi belirlemeden önce gerçek mikrofonlar, aksanlar ve oda gürültüsüyle test ederdim.
Test 2: GPT-Realtime-Translate ile Gerçek Zamanlı Çeviri
Canlı konuşma çevirisi ilk bakışta deşifreye benzer görünür; ancak oturum yaşam döngüsü farklıdır. Çeviri uç noktası asistan yanıt döngüsünü kaldırır ve örneği kısaltır.
Neyi test ediyoruz
Çeviri oturumlarının asistan tur döngüsü ve response.create adımı yoktur. Model, bir sohbet ajanı değil, canlı bir tercüman gibi çalışır. Soru-cevap, araçlar veya konuşma durumu için, makale Test 3’te gpt-realtime-2’ye geçer.
Çeviri oturumları için ayrılmış, ayrı bir uç nokta kullanılır. Görsel: Yazar.
Model 70’ten fazla giriş dilini ve 13 çıkış dilini destekler. Hedefi session.audio.output.language ile belirlersiniz; kaynak dil algılaması otomatik yapılır. Sınırlar nettir: özel yönerge yok, ses seçimi yok, alan sözlükleri yok.
Koda genel bakış
Daha önce belirtildiği gibi, çeviri /translations WebSocket URL’sini kullanır. İki ayrıntı daha değişir: hedef alan session.audio.output.language ve olay adı session.input_audio_buffer.append. session. önekine dikkat edin. Çeviri oturumları burada bunu kullanır.
Çevrilmiş ses session.output_audio.delta üzerinde gelir ve ses baytları event["delta"] içindedir; event["audio"] değil. Kaynak ve çevrilmiş transcriptler ayrı ayrı gelir:
Bir uç durum: Kaynak ses zaten hedef dildeyse, model onu geçirmek yerine sessizlik üretebilir.
Gözlenen davranış
Kısa İngilizce-İspanyolca ifadelerde, çevrilmiş ses kaynak cümle bitmeden önce başladı. Terminale deltalar akarken iç içe [EN] ve [ES] satırları göründü. Dil olarak daha uzak çiftler bağlam için daha uzun bekleyebilir. Çevrilen sesi sorunsuz takip edebildim; ancak özel ses seçimi mevcut değil.
Hüküm: Küçük bir çekinceyle başarılı.gpt-realtime-translate doğrudan canlı çeviri için çalıştı. Terminoloji kontrolü veya ses markalaması önemli olduğunda daha az kullanışlıdır.
Test 3: Dönüş Alışverişi ve Söz Kesme ile Bir Sesli Asistan Oluşturma
Bu, gpt-realtime-2 testidir: dinleyen, konuşan, bağlam tutan ve araç çağırabilen bir sesli aracı. Ayrıca istemci kodunun daha önemli hale geldiği noktadır; çünkü oynatma ve dönüş durumu senkron dışına çıkabilir.
Neyi test ediyoruz
gpt-realtime-2, konuşmadan konuşmaya muhakeme modelidir. Ayrı bir STT-to-LLM-to-TTS hattından kaçınır ve 128K bağlam penceresi uzun oturumlara daha fazla alan verir. Muhakeme reasoning.effort ile kontrol edilir; görev daha fazla muhakeme gerektirmedikçe low ile başlayın, çünkü daha yüksek ayarlar gecikme ekler.
Koda genel bakış
Aşağıdaki kurulum, yalnızca sessizliğe değil, konuşma ipuçlarına bakan semantic_vad kullanır. eagerness, modelin kullanıcının işinin bittiğine ne kadar hızlı karar verdiğini kontrol eder. Dikkat edilmesi gereken bölümler model adı, ses çıkışı ayarları, manuel response.create ve asistan ses olayı adıdır:
session_config ={"type":"session.update","session":{"type":"realtime","model":"gpt-realtime-2","output_modalities":["audio"],"audio":{"input":{"format":{"type":"audio/pcm","rate":24000},"transcription":{"model":"gpt-realtime-whisper","language":"en"},"turn_detection":{"type":"semantic_vad","eagerness":"medium","create_response":False,"interrupt_response":True}},"output":{"format":{"type":"audio/pcm","rate":24000},"voice":"marin"}},"instructions":"You are a helpful voice assistant. Keep answers short.","reasoning":{"effort":"low"}}}Altyapı:
Kullanıcının transcripti tamamlandığında, istemci asistan yanıtını oluşturur. Asistan sesi ardından response.output_audio.delta olarak gelir; response.audio.delta değil.
if event_type =="conversation.item.input_audio_transcription.completed":
ws.send(json.dumps({"type":"response.create"}))elif event_type =="response.output_audio.delta":
audio_out_queue.put(base64.b64decode(event["delta"]))Altyapı:
Söz kesmeyi yönetme
Kesinti dizisini yanlış yapmak kolaydır. Kullanıcı asistanın üzerine konuştuğunda, sunucu input_audio_buffer.speech_started gönderir. İstemci oynatmayı durdurur, ne kadar ses çaldığını kaydeder ve audio_end_ms ile conversation.item.truncate göndererek nerede kesildiğini takip eder. Aksi halde sunucu, kullanıcının hiç duymadığı metni deşifre etmeye devam eder ve bir sonraki tur tuhaf gelir.
if current_response_item_id and playback_position_ms >0:
ws.send(json.dumps({"type":"conversation.item.truncate","item_id": current_response_item_id,"content_index":0,"audio_end_ms": playback_position_ms
}))Altyapı:
Dizüstü bilgisayar hoparlörleriyle pratik bir sorun: Mikrofon, asistanın ses çıkışını alıp yeniden modele gönderebilir. Örnek betik, asistan konuşurken ve hemen sonrasında kısa bir soğuma süresi için giriş akışını susturmak üzere MUTE_MIC_DURING_ASSISTANT = True kullanır. Yalnızca kulaklık kullanıyor ve kesinti desteği istiyorsanız False yapın.
Kesme, sunucu ve istemciyi senkron tutar. Görsel: Yazar.
WebRTC ve SIP bu arabelleğin daha fazlasını işler. Bu eğitimde kullanılan WebSocket yolunda sorumluluk istemcidedir. Örnek betikteki sayaç bir demo için yeterlidir; üretim kodu ses çıkış akışından zaman damgalarını izlemelidir.
Muhakeme gecikmesi için önsözleri yapılandırma
reasoning.effortlow üzerinde olduğunda sessizlik fark edilir hale gelir. Sistem istemine kısa konuşulan önsözler eklenebilir:
# Preambles
Use a short spoken update before longer tasks.
Keep preambles under five seconds.
Skip preambles for short factual questions.Altyapı:
Bu davranış gpt-realtime-2 için belgelenmiştir.
Gözlenen davranış
Sessiz bir odada varsayılan ayarlarda dönüş alışverişi çalıştı. Dizüstü hoparlörleriyle mikrofonu susturmam gerekti; aksi halde model kendi çıktısını duyup bir eko döngüsü başlatıyordu.
Daha gürültülü ortamlarda, VAD ayarları ve mikrofon konumu daha fazla önem kazandı. On dakikalık bir testte konuşma belleği tutarlı kaldı; ancak yeniden bağlanma planı olmadan daha uzun bir uygulama yayınlamazdım.
Hüküm: Temel ses döngüsü için başarılı.gpt-realtime-2, testimde düşük muhakeme çabasına sahip bir asistanı sorunsuz yönetti. Ek iş istemcidedir: oynatma, kesinti yönetimi, yeniden bağlanmalar ve gerekirse araç çağrıları.
Streamlit Demosu: Üç Model Tek Arayüzde
Streamlit uygulaması, testleri bir sekme seçicisinin arkasına koyar. Ses kaydetmenize, bir hedef dil seçmenize ve komut dosyalarını düzenlemeden model yollarını karşılaştırmanıza olanak tanır. Olayları daha doğrudan gösterdiği için bunu ana öğretim yolu yerine bir demo uygulaması olarak tuttum.
Tek sekmeli arayüzde üç model. Görsel: Yazar.
Aşağıdaki demo videosu, sekmeleri canlı bir API anahtarıyla gösterir. Her sekme gerçek Realtime WebSocket çağrılarını kullanır.
API anahtarınız kenar çubuğuna girilir ve hiçbir yerde saklanmaz. Genel bir uygulama için, onu Streamlit Secrets’a koyun.
GPT-Realtime-2’nin Pratikte Maliyet ve Gecikmesi
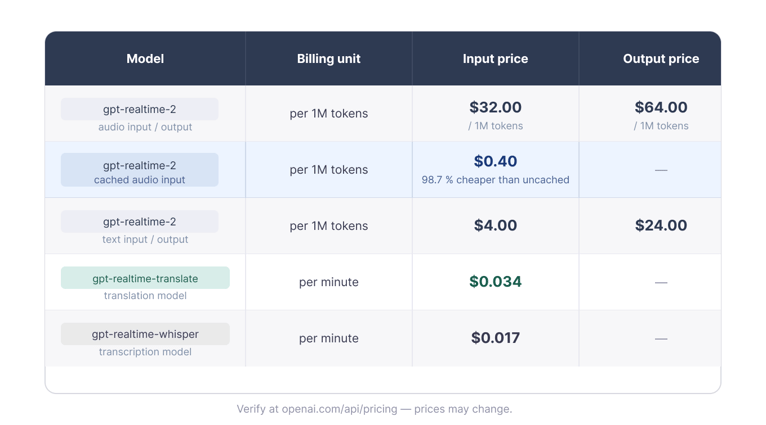
Test 1’de belirtildiği gibi, fiyatlandırma iki gruba ayrılır: gpt-realtime-2 belirteç başına, çeviri ve deşifre ise dakika başına ücretlendirilir.
Modele göre belirteç ve dakika bazlı ücretlendirme. Görsel: Yazar.
Deşifre ve çeviride maliyet süreyle ölçeklenir. Yazım sırasında, otuz dakika gpt-realtime-whisper için yaklaşık 0,51 ABD doları ve gpt-realtime-translate için yaklaşık 1,02 ABD dolarıdır.
Sesli aracılarda tahmin daha zordur; çünkü ses belirteçleri konuşmanın her iki tarafında da birikir. Oturum süresi, konuşma oranı, muhakeme çabası ve bağlam boyutu önemlidir. Ön bellekleme, önceki konuşma turları sabit kaldığında maliyeti azaltabilir.
REST deşifre çağrısı artı TTS, canlı etkileşim gerekmedikçe farklı bir karşılaştırmadır. Dosyalar için whisper-1 daha ucuzdur; ancak aynı türde bir API değildir.
GPT-Realtime-2 API Sınırları, Ses Gereksinimleri ve Sorun Giderme
İlk test çalıştırmalarımı etkileyen sınırlar bunlardı. Hataların çoğu modelden değil, ses biçimlendirmesi veya oturum yaşam döngüsü hatalarından kaynaklandı.
Taşıma ve ses kısıtları
İlk testte belirtildiği gibi, WebSocket sesi 24 kHz’de PCM16, mono ve base64 kodlu olmalıdır. Her input_audio_buffer.append olayı 15 MB ile sınırlıdır; bu nedenle 50 milisaniyelik parçalar sınırın oldukça altında kalır. Telefon için G.711 de desteklenir.
Realtime oturumları OpenAI’de 60 dakika, Azure OpenAI’de 30 dakika sonra sona erer. Daha uzun uygulamalar yeniden bağlanma planına ve durumu yeniden kurma yoluna ihtiyaç duyar. Ses ayrıca ilk ses çıkışından önce seçilmelidir; oturum ortasında değiştirilemez.
Hız sınırları ve kotalar
Hız sınırları katman bazlı ve proje özeldir. 1. Kademe şu anda gpt-realtime-2 için dakikada 200 istek ve dakikada 40.000 belirteç listeler. Ücretsiz katman desteklenmez.
Yaygın hatalar ve pürüzler
En sık karşılaştığım hatalar boş arabellek onayları ve yanlış ses biçimlendirmesiydi. Sesli aracılarda, mikrofonun asistanın hoparlör çıktısını duyarak geri besleme döngüsü yaratmasına da dikkat edin. Kulaklık, yankı iptali veya mikrofon susturma kullanın.
Uzun oturumlarda, sürenin dolmasını beklemek yerine yaklaşık 55. dakikada yeniden bağlanın. Dokümanlarda bir pürüz: gpt-realtime-2 model sayfasında genel bir "Streaming: Desteklenmiyor" satırı varken, Realtime kılavuzları /v1/realtime kullanımını belgeler. O satır Chat Completions akışıyla ilgilidir, Realtime API davranışıyla değil.
Nihai Hüküm
Üç testte de aynı desen görülür: her işin kendi modeli ve uç noktası vardır. Bu ayrım, modelin neler yapabileceğini, nasıl ücretlendirildiğini ve ne kadar istemci koduna sahip olmanız gerektiğini etkiler.
Yukarıda gösterildiği gibi, gpt-realtime-whisper canlı metni, gpt-realtime-translate doğrudan konuşma çevirisini ve gpt-realtime-2 konuşma, muhakeme ve bağlamla asistan davranışını kapsar.
Kod bir modelin diğerlerinin yerini aldığını göstermiyor. Gerçek zamanlı sesli uygulamaların oturum tasarımına bağlı olduğunu gösteriyor. Başlangıç noktam, işle eşleşen en küçük model olurdu; kalan mühendislik süresini ses kalitesine, dönüş alışverişine, yeniden bağlanmalara ve istemci durumuna harcardım.
Canlı etkileşime odaklanan bir rakip modelle ilgileniyorsanız, Thinking Machines Lab’in TML-Interaction-Small rehberimizi okumanızı öneririm. OpenAI ses modelleri hakkında daha fazla arka plan için, eğitimlerimiz ilgili ses ve gerçek zamanlı API konularını kapsar:
Veri hatları, bulut ve YZ araçları üzerinde çalışan; aynı zamanda DataCamp ve gelişmekte olan geliştiriciler için pratik, yüksek etkili eğiticiler yazan bir veri mühendisi ve topluluk inşacısıyım.
Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!








GPT-Realtime-2 üzerine genel bakış makalemiz, lansmanı, karşılaştırma iddialarını ve OpenAI’nin gerçek zamanlı sesi neden küçük bir model ailesine böldüğünü ele almıştı. Bu eğitim, o makalenin bıraktığı yerden devam ediyor: API’ye bağlanmak, ses göndermek ve kodda nelerin değiştiğini görmek.
Bu ayrım uygulamada önemlidir. Test 1
gpt-realtime-whisper�ı deşifre için, Test 2gpt-realtime-translatei canlı çeviri için ve Test 3gpt-realtime-2yi bir sesli asistan için kullanır. Ana model, çeviri veya deşifre gibi daha basit görevlerde de çalışır; ancak gerek olmayan bir muhakeme düzeyi ve yanıt biçimlerine ödeme yaparsınız — bu yüzden aşırı olur.Python’da GPT-Realtime-2 API’yi Kurma
Testlerden önce, taşıma, kimlik doğrulama ve ses biçimini ayırmak faydalıdır. Bu ayrıntılar örnekler boyunca çoğunlukla aynı kalır. Makale metin çıktısından çevrilmiş konuşmaya, ardından tam bir ses döngüsüne geçerken değişen şey model uç noktaları ve olay adlarıdır.
WebRTC ile WebSocket arasında seçim
OpenAI dokümanları basit bir kural verir: tarayıcı ve mobil istemciler için WebRTC, sunucu tarafı uygulamalar için WebSockets kullanın. WebRTC titreme arabelleğini ve ses taşımayı yönetir. WebSocket’ler, arka uç zaten bir telefon sağlayıcısından veya medya hattından ham ses alıyorsa mantıklıdır.
Realtime API için iki taşıma yolu. Görsel: Yazar.
Bu nedenle, üç Python testi de WebSocket kullanır. Bu yol, olay adlarını doğrudan gösterir; böylece model farkları kodda görünür. Bir tarayıcı derlemesi için, API anahtarınızın ön uca asla ulaşmaması adına kısa ömürlü istemci gizlileri kullanın.
Python ortamı ve paketler
Python 3.9 veya daha yenisini kullanın. Dört betiğin tam kodu github.com/KhalidAbdelaty/gpt-realtime-api adresinde mevcuttur. Önce klonlayın, ardından bağımlılıkları kurun:
websocket-clientsoketi yönetir.sounddevicemikrofon sesini yakalar,numpyarabelleği dönüştürür vepython-dotenvAPI anahtarını yükler. macOS’ta,sounddeviceçalışmadan öncebrew install portaudiogerekebilir. Linux’taportaudio19-devkurun.Projenizin köküne bir
.envdosyası oluşturun:Ardından her betikte yükleyin:
Kimlik doğrulama ve WebSocket URL’si
Sunucu tarafı bağlantılar, WebSocket el sıkışmasında bir
Authorization: Bearerbaşlığı kullanır. Uygulama bireysel kullanıcıları izliyorsaOpenAI-Safety-Identifierekleyin. Testlerde daha sonra kullanılan yollar şunlardır:Bu çeviri yolu, Test 2’de önem kazanır; çünkü doğrudan
/v1/realtimekullanmayan tek uç noktadır.Test 1: GPT-Realtime-Whisper ile Gerçek Zamanlı Ses Deşifre
Deşifre, aşırı inşa etmenin yaygın olduğu bir alandır. Çıktı yalnızca metinse, deşifre modeli yeterlidir.
Neyi test ediyoruz
gpt-realtime-whispersesi alır ve transcript deltaları üretir. Muhakeme yapmaz, araç çağırmaz, geri konuşmaz. Bu daha küçük iş,gpt-realtime-2ile aynı belirteç modeline göre değil, ses süresine göre ücretlendirilmesinin nedenidir. Ücret kısmında bu oranlara geri dönüyoruz.Koda genel bakış
Temel alan
session.type: "transcription". Bu, API’ye asistan yanıtlarını atlamasını ve yalnızca transcript olayları üretmesini söyler. Tam betik ayrıca mikrofon yakalama ve iş parçacıklarını ele alır. Realtime oturum davranışını değiştiren kısım şudur:Base64 olarak kodlanmış 24 kHz PCM16 mono ses kullanın. Sesli aracı oturumundan farklı olarak, bu betik giriş arabelleğini
server_vaddönüş tespiti yerine bir zamanlayıcıyla manuel olarak onaylar. Boş onaylarinput_audio_buffer_commit_emptyhatası verir; bu yüzden tam betik yalnızca gerçek ses gönderildikten sonra onaylar.Transcript deltaları sözcük sözcük gerçek zamanlı gelir. Görsel: Yazar.
Gözlenen davranış
Yerel testlerimde, transcript sonuçları konuşma başladıktan sonra yaklaşık 3 ila 4 saniye içinde, onay penceresi dahilinde göründü. Bu kurulum VAD yerine manuel onaylara dayandığından, gecikme onay aralığına bağlıdır.
Ayrıca sıralamaya dikkat edin: çakışan turlardan gelen tamamlama olayları sırayla gelmeyebilir; akış etrafında bir UI kuruyorsanız
item_idile uzlaştırın.Deşifre, sessizlik tespitiyle değil, periyodik manuel onayla tetiklenir. Görsel: Yazar.
Hüküm: Başarılı. Sunucu tarafı canlı deşifre için
gpt-realtime-whisperbu testin ihtiyaçlarını karşıladı. Yine de bir gecikme hedefi belirlemeden önce gerçek mikrofonlar, aksanlar ve oda gürültüsüyle test ederdim.Test 2: GPT-Realtime-Translate ile Gerçek Zamanlı Çeviri
Canlı konuşma çevirisi ilk bakışta deşifreye benzer görünür; ancak oturum yaşam döngüsü farklıdır. Çeviri uç noktası asistan yanıt döngüsünü kaldırır ve örneği kısaltır.
Neyi test ediyoruz
Çeviri oturumlarının asistan tur döngüsü ve
response.createadımı yoktur. Model, bir sohbet ajanı değil, canlı bir tercüman gibi çalışır. Soru-cevap, araçlar veya konuşma durumu için, makale Test 3’tegpt-realtime-2’ye geçer.Çeviri oturumları için ayrılmış, ayrı bir uç nokta kullanılır. Görsel: Yazar.
Model 70’ten fazla giriş dilini ve 13 çıkış dilini destekler. Hedefi
session.audio.output.languageile belirlersiniz; kaynak dil algılaması otomatik yapılır. Sınırlar nettir: özel yönerge yok, ses seçimi yok, alan sözlükleri yok.Koda genel bakış
Daha önce belirtildiği gibi, çeviri
/translationsWebSocket URL’sini kullanır. İki ayrıntı daha değişir: hedef alansession.audio.output.languageve olay adısession.input_audio_buffer.append.session.önekine dikkat edin. Çeviri oturumları burada bunu kullanır.Çevrilmiş ses
session.output_audio.deltaüzerinde gelir ve ses baytlarıevent["delta"]içindedir;event["audio"]değil. Kaynak ve çevrilmiş transcriptler ayrı ayrı gelir:Bir uç durum: Kaynak ses zaten hedef dildeyse, model onu geçirmek yerine sessizlik üretebilir.
Gözlenen davranış
Kısa İngilizce-İspanyolca ifadelerde, çevrilmiş ses kaynak cümle bitmeden önce başladı. Terminale deltalar akarken iç içe
[EN]ve[ES]satırları göründü. Dil olarak daha uzak çiftler bağlam için daha uzun bekleyebilir. Çevrilen sesi sorunsuz takip edebildim; ancak özel ses seçimi mevcut değil.Hüküm: Küçük bir çekinceyle başarılı.
gpt-realtime-translatedoğrudan canlı çeviri için çalıştı. Terminoloji kontrolü veya ses markalaması önemli olduğunda daha az kullanışlıdır.Test 3: Dönüş Alışverişi ve Söz Kesme ile Bir Sesli Asistan Oluşturma
Bu,
gpt-realtime-2testidir: dinleyen, konuşan, bağlam tutan ve araç çağırabilen bir sesli aracı. Ayrıca istemci kodunun daha önemli hale geldiği noktadır; çünkü oynatma ve dönüş durumu senkron dışına çıkabilir.Neyi test ediyoruz
gpt-realtime-2, konuşmadan konuşmaya muhakeme modelidir. Ayrı bir STT-to-LLM-to-TTS hattından kaçınır ve 128K bağlam penceresi uzun oturumlara daha fazla alan verir. Muhakemereasoning.effortile kontrol edilir; görev daha fazla muhakeme gerektirmedikçelowile başlayın, çünkü daha yüksek ayarlar gecikme ekler.Koda genel bakış
Aşağıdaki kurulum, yalnızca sessizliğe değil, konuşma ipuçlarına bakan
semantic_vadkullanır.eagerness, modelin kullanıcının işinin bittiğine ne kadar hızlı karar verdiğini kontrol eder. Dikkat edilmesi gereken bölümler model adı, ses çıkışı ayarları, manuelresponse.createve asistan ses olayı adıdır:Kullanıcının transcripti tamamlandığında, istemci asistan yanıtını oluşturur. Asistan sesi ardından
response.output_audio.deltaolarak gelir;response.audio.deltadeğil.Söz kesmeyi yönetme
Kesinti dizisini yanlış yapmak kolaydır. Kullanıcı asistanın üzerine konuştuğunda, sunucu
input_audio_buffer.speech_startedgönderir. İstemci oynatmayı durdurur, ne kadar ses çaldığını kaydeder veaudio_end_msileconversation.item.truncategöndererek nerede kesildiğini takip eder. Aksi halde sunucu, kullanıcının hiç duymadığı metni deşifre etmeye devam eder ve bir sonraki tur tuhaf gelir.Dizüstü bilgisayar hoparlörleriyle pratik bir sorun: Mikrofon, asistanın ses çıkışını alıp yeniden modele gönderebilir. Örnek betik, asistan konuşurken ve hemen sonrasında kısa bir soğuma süresi için giriş akışını susturmak üzere
MUTE_MIC_DURING_ASSISTANT = Truekullanır. Yalnızca kulaklık kullanıyor ve kesinti desteği istiyorsanızFalseyapın.Kesme, sunucu ve istemciyi senkron tutar. Görsel: Yazar.
WebRTC ve SIP bu arabelleğin daha fazlasını işler. Bu eğitimde kullanılan WebSocket yolunda sorumluluk istemcidedir. Örnek betikteki sayaç bir demo için yeterlidir; üretim kodu ses çıkış akışından zaman damgalarını izlemelidir.
Muhakeme gecikmesi için önsözleri yapılandırma
reasoning.effortlowüzerinde olduğunda sessizlik fark edilir hale gelir. Sistem istemine kısa konuşulan önsözler eklenebilir:Bu davranış
gpt-realtime-2için belgelenmiştir.Gözlenen davranış
Sessiz bir odada varsayılan ayarlarda dönüş alışverişi çalıştı. Dizüstü hoparlörleriyle mikrofonu susturmam gerekti; aksi halde model kendi çıktısını duyup bir eko döngüsü başlatıyordu.
Daha gürültülü ortamlarda, VAD ayarları ve mikrofon konumu daha fazla önem kazandı. On dakikalık bir testte konuşma belleği tutarlı kaldı; ancak yeniden bağlanma planı olmadan daha uzun bir uygulama yayınlamazdım.
Hüküm: Temel ses döngüsü için başarılı.
gpt-realtime-2, testimde düşük muhakeme çabasına sahip bir asistanı sorunsuz yönetti. Ek iş istemcidedir: oynatma, kesinti yönetimi, yeniden bağlanmalar ve gerekirse araç çağrıları.Streamlit Demosu: Üç Model Tek Arayüzde
Streamlit uygulaması, testleri bir sekme seçicisinin arkasına koyar. Ses kaydetmenize, bir hedef dil seçmenize ve komut dosyalarını düzenlemeden model yollarını karşılaştırmanıza olanak tanır. Olayları daha doğrudan gösterdiği için bunu ana öğretim yolu yerine bir demo uygulaması olarak tuttum.
Tek sekmeli arayüzde üç model. Görsel: Yazar.
Aşağıdaki demo videosu, sekmeleri canlı bir API anahtarıyla gösterir. Her sekme gerçek Realtime WebSocket çağrılarını kullanır.