
I principali risultati:
- Entrambi sono rimasti fisicamente onesti. Nessun braccio ha allungato un link o toccato un ostacolo, incluso durante l\'aggiramento dell\'ostacolo tra i target 2 e 3.
- Entrambi hanno ammesso il target irraggiungibile. Ciascun braccio si è fermato prima del target 4 e ciascun elenco di stato lo ha segnato come mancato, riportando gli altri quattro come raggiunti.
- Entrambi si sono mossi secondo programma. Ognuno ha impiegato 3 secondi di movimento e 1 secondo di fermo per target e si è fermato a 20 secondi.
- La pagina di Hydrogen ti ha detto di più. Ha disegnato una traccia tratteggiata del percorso della punta e ha aggiunto letture in tempo reale della posizione (x, y) della punta del braccio e degli angoli delle giunture in gradi, un tocco carino che nessuno aveva chiesto. Sonnet 5.5 ha disegnato il cerchio di portata del braccio e stampato un auto-check dei propri vincoli. Entrambi leggibili chiaramente da un singolo frame.
Ho assegnato a entrambi 5 su 5 per onestà fisica, qualità del movimento e leggibilità della scena. Le esecuzioni sono costate $0,40 per Sonnet 5.5 e $0,45 per Hydrogen, con Sonnet 5.5 che ha usato 30.491 token di output contro 47.914 di Hydrogen, ragionamento incluso.
Secondo la rubrica, questo test è un pareggio. Entrambe le promesse di coding quotidiano affidabile hanno retto su un task di geometria ben specificato, mentre l\'esecuzione leggermente più economica di Sonnet 5.5, nonostante le tariffe più alte, deriva da un singolo tentativo ciascuno.
Quando due modelli superano tutte le verifiche, l\'asticella va alzata: una versione più difficile di questo test potrebbe, per esempio, aggiungere un target che sulla carta è a portata ma bloccato da un ostacolo.
Quando scegliere Gemini 4 Hydrogen vs Claude Sonnet 5.5
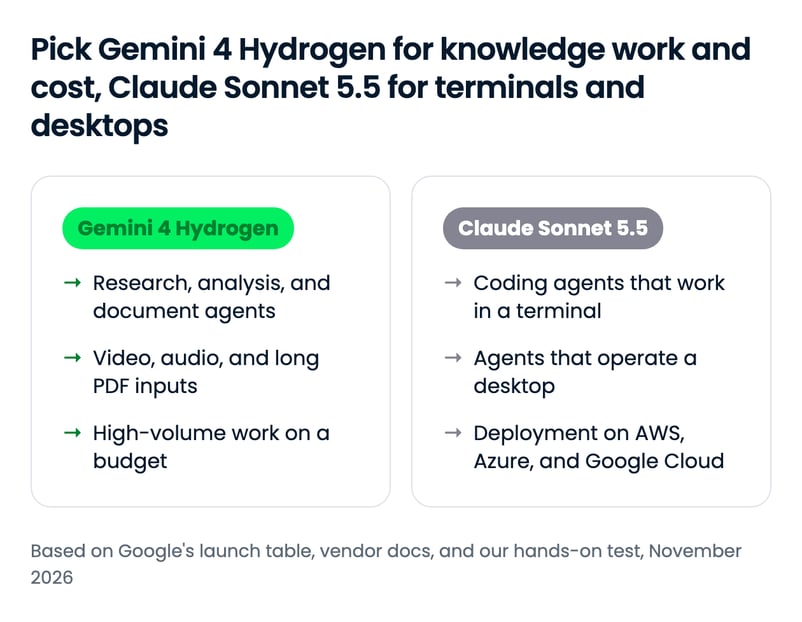
Il bivio è l\'ambiente in cui lavora l\'agente: documenti e dati favoriscono Hydrogen, terminali e desktop favoriscono Sonnet 5.5. Il prezzo favorisce sempre Hydrogen, dello stesso 25%.
Scegli Gemini 4 Hydrogen se...
- I tuoi agenti fanno ricerca, analisi o lavoro documentale. Hydrogen guida tutte le righe dei lavori di conoscenza nella tabella di Google, e il divario è più ampio sui workflow professionali end-to-end.
- I tuoi input sono registrazioni o file visuali lunghi. Legge nativamente video, audio e PDF, cosa che Sonnet 5.5 non fa.
- Il costo per richiesta decide il modello. Ogni tariffa è inferiore del 25% e il livello gratuito copre il prototyping prima di pagare. Assicurati comunque di tracciare il costo per task.
- Costruisci sullo stack di Google. Hydrogen è il default nell\'agente Antigravity e gira come modello di esecuzione sotto Carbon e Argon nell\'Orchestrator di Antigravity.
Scegli Claude Sonnet 5.5 se...
- Il tuo agente di coding lavora in un terminale. Sonnet 5.5 guida ogni lettura di Terminal-Bench, inclusa quella indipendente.
- I tuoi agenti operano un desktop o un browser. Guida OSWorld-2.1 con un margine netto.
- Effettui deployment su più cloud o lavori in Claude Code o GitHub Copilot. Sonnet 5.5 è su Amazon Bedrock, Microsoft Foundry e Google Cloud, e nei principali agenti di coding.
- Vuoi risposte lunghe senza setup extra. Il suo limite standard di output per richiesta è circa il doppio del default di Hydrogen, che ha bisogno del long decode per andare oltre.
Come iniziare con Gemini 4 Hydrogen e Claude Sonnet 5.5
Entrambi i modelli sono generalmente disponibili tramite le API dei rispettivi vendor e su OpenRouter, ma Sonnet 5.5 raggiunge più cloud e agenti di coding.
| Superficie | Gemini 4 Hydrogen | Claude Sonnet 5.5 |
|---|---|---|
| App consumer | App Gemini (selettore del modello; utenti free tramite selezione automatica) e Google Search | App Claude |
| API first-party | Gemini API e Google AI Studio, livelli free e a pagamento | Claude API |
| Piattaforme cloud | Google Cloud Vertex AI e Gemini for business | Amazon Bedrock, Claude Platform su AWS, Google Cloud, Microsoft Foundry |
| Agenti di coding | Google Antigravity (Google AI Pro e Ultra), Cursor, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Router di terze parti | OpenRouter | OpenRouter |
| ID modello API | gemini-4-hydrogen | claude-sonnet-5-5 (anthropic.claude-sonnet-5-5 su Bedrock) |
Gli ID modello sono gemini-4-hydrogen e claude-sonnet-5-5. Il divario più grande è la copertura: Sonnet 5.5 gira su tutti e tre i principali cloud, mentre Hydrogen è prima di tutto su Google Cloud.
Effettuare la tua prima chiamata API
I due modelli usano SDK diversi, quindi cambiare significa cambiare client, non solo la stringa del modello. Su Hydrogen, la Interactions API di Google ha di default il livello di pensiero high:
from google import genai
client = genai.Client()
interaction = client.interactions.create(
model="gemini-4-hydrogen",
input="Find the off-by-one bug in this loop: ...",
)
print(interaction.output_text)Su Sonnet 5.5, l\'adaptive thinking è attivo di default, quindi stampa solo i blocchi di testo:
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-sonnet-5-5",
max_tokens=2048,
messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
print("".join(b.text for b in response.content if b.type == "text"))Per una guida completa, vedi il nostro tutorial sull\'API di Claude Sonnet 5.5.
Considerazioni finali
Gemini 4 Hydrogen e Claude Sonnet 5.5 sono due modelli su un livello di performance simile. Il nostro test pratico ha fatto fatica a distinguerli, e la scelta tra i due dipende dal tuo caso d\'uso.
Gemini 4 Hydrogen è il miglior default per la maggior parte dei lavori di conoscenza, legge più tipi di input e costa un quarto in meno su ogni tariffa. Claude Sonnet 5.5 è la scelta quando l\'agente vive in un terminale o su un desktop, e quando ti serve su ogni cloud.
Se vuoi approfondire, ti consiglio il nostro corso Introduzione ai modelli Claude e, per il lato Google, Costruire agenti AI con Google ADK.
FAQ
Gemini 4 Hydrogen è migliore di Claude Sonnet 5.5?
Dipende dal lavoro. Gemini 4 Hydrogen ottiene punteggi più alti in 7 delle 10 righe nella tabella di lancio di Google, con un vantaggio nei lavori di conoscenza e nei task agentici ricchi di documenti, e costa il 25% in meno. Claude Sonnet 5.5 guida il coding basato su terminale e l\'uso del computer. Nel nostro test pratico con braccio robotico, entrambi hanno ottenuto il punteggio pieno.
Qual è più economico, Gemini 4 Hydrogen o Claude Sonnet 5.5?
Gemini 4 Hydrogen è più economico. Costa $1,50 per milione di token in input e $7,50 per milione di token in output, rispetto a $2 e $10 per Claude Sonnet 5.5. Le letture in cache e le tariffe batch seguono lo stesso rapporto del 75%, e Hydrogen ha anche un livello gratuito con rate limit nella Gemini API e in Google AI Studio. Detto questo, nel nostro test pratico Claude Sonnet è stato leggermente più economico per task ($0,40 vs $0,45) perché Hydrogen ha usato più token di ragionamento.
Gemini 4 Hydrogen o Claude Sonnet 5.5 è migliore per il coding?
Claude Sonnet 5.5 è la scelta più forte per agenti di coding che lavorano in un terminale: guida ogni risultato di Terminal-Bench, inclusa un\'esecuzione indipendente di Artificial Analysis. Gemini 4 Hydrogen guida il benchmark SWE-sweep di riparazione bug di Google e costa meno, ed entrambi i modelli hanno superato con il massimo dei voti il nostro task pratico di build con braccio robotico.
Dove posso usare Gemini 4 Hydrogen e Claude Sonnet 5.5?
Entrambi sono disponibili su OpenRouter, GitHub Copilot, Cursor e Google Cloud Vertex AI. Gemini 4 Hydrogen è nell\'app Gemini, in Google Search, nella Gemini API, in Google AI Studio e in Google Antigravity. Claude Sonnet 5.5 è nelle app Claude, in Claude Code, nella Claude API, su Amazon Bedrock e in Microsoft Foundry.
Quali sono gli ID modello API per Gemini 4 Hydrogen e Claude Sonnet 5.5?
L\'ID modello API di Gemini 4 Hydrogen è gemini-4-hydrogen nella Gemini API e su Vertex AI. Quello di Claude Sonnet 5.5 è claude-sonnet-5-5 sulla Claude API, su Google Cloud e su Microsoft Foundry, e anthropic.claude-sonnet-5-5 su Amazon Bedrock. I due usano SDK diversi, quindi passare dall\'uno all\'altro significa cambiare client oltre che la stringa del modello.

Tom è un Editor di Data Science in DataCamp. Scrive e modifica tutorial sull’IA, confronta le nuove release di LLM e crea flussi di lavoro potenziati dall’IA. In precedenza ha lavorato nella data science presso Deutsche Telekom. Fuori dal lavoro, prevede le partite di calcio con il machine learning.





Google ha rilasciato Gemini 4 Hydrogen il 12 novembre 2026 come membro veloce e a costo inferiore della famiglia Gemini 4 e sostituto di Gemini 3.8 Flash. Nella tabella dei benchmark di lancio, accanto c\'è Claude Sonnet 5.5, il modello di fascia media di Anthropic dal 28 settembre: è quindi Google stesso a impostare questo confronto.
In questo articolo confronterò Gemini 4 Hydrogen e Claude Sonnet 5.5 su coding agentico, lavori di conoscenza, uso del computer e prezzi, e condividerò cosa è successo quando ho eseguito lo stesso task di build su entrambi.
Per restare aggiornato su AI e dati, ti consiglio di iscriverti alla nostra newsletter settimanale, The Median.
TL;DR
Che cos\'è Gemini 4 Hydrogen?
Gemini 4 Hydrogen è il modello Gemini 4 veloce e a costo inferiore di Google DeepMind, rilasciato il 12 novembre 2026 come successore di Gemini 3.8 Flash.
Google lo definisce un daily driver per workflow agentici: funziona da solo oppure come modello di esecuzione sotto Gemini 4 Carbon e Argon, tra i quali il nuovo Orchestrator in Google Antigravity commuta all\'interno della stessa sessione.
La nostra guida a Gemini 4 Hydrogen copre nel dettaglio il lancio.
Che cos\'è Claude Sonnet 5.5?
Claude Sonnet 5.5 è il modello di fascia media di Anthropic, rilasciato il 28 settembre 2026 come secondo modello della famiglia Claude 5.5.
Anthropic lo posiziona come complemento più veloce e più economico a Claude Opus 5.5, più forte su task quotidiani ben circoscritti, correzioni di bug e documenti, slide e fogli di calcolo rifiniti.
La nostra guida a Claude Sonnet 5.5 copre il lancio, e il nostro tutorial sull\'API di Claude Sonnet 5.5 costruisce con esso un agente di riconciliazione.
Gemini 4 Hydrogen vs Claude Sonnet 5.5: confronto diretto
Gemini 4 Hydrogen ottiene punteggi superiori a Claude Sonnet 5.5 in 7 delle 10 righe della tabella di lancio di Google, ma le 3 righe in cui vince Sonnet 5.5 sono quelle in cui il modello lavora dentro un terminale o su un desktop. Hydrogen è anche il più economico dei due su ogni tariffa pubblicata da entrambi i vendor.
highè il defaulthighè il default dell\'APICoding e lavoro agentico
Claude Sonnet 5.5 guida il coding agentico basato su terminale in ogni fonte che riporta entrambi i modelli, mentre Gemini 4 Hydrogen guida il benchmark di riparazione bug di Google. Il numero più utile è quello indipendente: Artificial Analysis ha eseguito in proprio Terminal-Bench 4.0 e ha collocato Sonnet 5.5 al 64% contro il 54% di Hydrogen, un divario vicino a quello nella tabella di Google.
SWE-sweep è la scelta di Google, e in termini assoluti entrambi i punteggi sono bassi, ma è l\'unica riga di coding in cui Hydrogen vince nettamente. Google afferma anche che Hydrogen raggruppa in parallelo letture e ricerche di file quando esplora un repository, e Anthropic dice lo stesso di Sonnet 5.5 rispetto a Sonnet 5, quindi nessun vendor ha l\'esclusiva su questa storia.
Per un agente di coding che vive in una shell, Sonnet 5.5 è la scelta più forte; Hydrogen si avvicina a un costo inferiore, come quantifica la sezione prezzi.
Lavori di conoscenza e ragionamento
Gemini 4 Hydrogen guida tutte le righe di lavori di conoscenza nella tabella di Google, e il divario più ampio è su Agents\' Last Exam v1.1, un benchmark end-to-end di workflow professionali, dove segna 71,6% contro il 60,4% di Sonnet 5.5.
Tutte e cinque le righe provengono dalla tabella di lancio di Google. L\'unica vittoria di Sonnet 5.5 in questo gruppo è il benchmark scientifico che, di nuovo, gira in un terminale. Per ricerca, analisi e agenti ricchi di documenti, Hydrogen è il modello più forte.
Uso del computer e lavoro multimodale
Claude Sonnet 5.5 guida l\'uso del computer, con 83,9% contro 77,6% di Hydrogen sul sottoinsieme offline di OSWorld-2.1 nella tabella di Google. Sulla comprensione multimodale i due sono vicini, con un leggero vantaggio per Hydrogen.
La differenza multimodale più grande è negli input accettati: Hydrogen legge nativamente video, audio e PDF, mentre Sonnet 5.5 accetta testo e immagini. Scegli Sonnet 5.5 per agenti che cliccano attraverso interfacce, e Hydrogen quando gli input sono registrazioni o file visuali lunghi.
Prezzi: quanto paghi davvero
Gemini 4 Hydrogen costa il 75% del prezzo di Claude Sonnet 5.5 su ogni tariffa pubblicata da entrambi i vendor: input, output, letture in cache e batch. Questo singolo multiplo si mantiene in ogni forma di carico qui sotto.
Poiché il multiplo è uniforme, il confronto si riduce a un numero e non a una storia per ogni workload. Le differenze strutturali stanno altrove: Hydrogen ha un livello gratuito e nessuna scrittura cache esplicita.
Tariffe per token affiancate
Entrambi i vendor pubblicano tariffe standard, cached e batch per 1M token.
Google prezza Hydrogen in modo piatto sull\'intera finestra da 1M token e addebita i token di ragionamento alla tariffa di output, quindi salire a
xhighè una decisione di costo tanto quanto di qualità. Hydrogen ha anche un livello gratuito con rate limit nella Gemini API e in Google AI Studio, il che conta più per il prototyping che qualsiasi tariffa per token.Quanto costa un carico reale
Ogni totale è (volume ÷ 1M) × tariffa, sommato tra input e output, alle tariffe standard.
La riga di generazione pesante è dove il divario diventa denaro reale, dato che l\'output è la tariffa più alta per entrambi. La riga della cache presume che ogni lettura sia un cache hit: Sonnet 5.5 paga $2,50 per 1M token per scrivere il prefisso una volta, Hydrogen paga la sua tariffa di input normale sulla prima richiesta, e il divario resta al 25%.
Perché lo stesso task costa cifre diverse
Il grafico dei costi di Terminal-Bench 4.0 di Google è l\'unica figura che uno dei due vendor ha pubblicato con i prezzi di entrambi i modelli sugli stessi task. A circa $2 per task, Hydrogen con l\'impostazione di default
highraggiunge il 57%, mentre Sonnet 5.5 ha bisogno di circa $5 per task per superare quel punteggio. È l\'esecuzione di Google con la metodologia di Google, quindi trattala come un claim del vendor, ma punta nella stessa direzione della tabella delle tariffe: su questo benchmark Hydrogen compra più punti per dollaro, anche laddove Sonnet 5.5 raggiunge un tetto più alto.Come si sono comportati Gemini 4 Hydrogen e Claude Sonnet 5.5
I benchmark di due vendor diversi hanno un raggio d\'azione limitato, quindi ho eseguito un task di build su entrambi i modelli con prompt e strumenti identici.
Il task: una pagina web a file singolo che anima un braccio robotico a tre link che visita cinque target in ordine su un piano con ostacoli rettangolari. Ogni target ha 4 secondi (3 per muoversi, 1 per fermarsi), ogni link deve mantenere la sua esatta lunghezza, nessuna parte del braccio può toccare un ostacolo in nessun momento e un elenco di stato deve riportare se la punta del braccio ha effettivamente raggiunto ciascun target. La pagina doveva essere disegnata in SVG, senza build step, dipendenze o rete.
La scena nasconde due trabocchetti:
Il prompt non menziona nessuno dei due, quindi notarli è il punto. È un controllo compatto sulla promessa che entrambi i vendor fanno per questi modelli: coding quotidiano veloce e affidabile, e sull\'affermazione di Google che Hydrogen riduce le allucinazioni di oltre 5 volte rispetto a Gemini 3.8 Flash.
Entrambi hanno girato in OpenCode con una superficie di tool bloccata (solo lettura, scrittura ed editing di file), a sforzo di ragionamento
high, un tentativo ciascuno, sessione nuova, prompt consegnato byte per byte.highè il terzo di quattro livelli di pensiero su Hydrogen e il terzo di cinque livelli di impegno su Sonnet 5.5, ed è il default dell\'API per entrambi.Ecco i due artefatti prodotti dai modelli, prima Gemini Hydrogen e poi Claude Sonnet.