Corso
Introduzione ai modelli Claude
3 ore
14.7K
Claude Sonnet 5.5 fa parte della famiglia Claude 5.5 di Anthropic. Era appena stato rilasciato quando ho iniziato questo progetto e il suo ID modello API è claude-sonnet-5-5. Secondo la panoramica del modello, ha una finestra di contesto da 1M di token, fino a 128K token di output, pensiero adattivo attivo di default e uno sforzo predefinito high sull'API. I prezzi standard sono 2 $ per milione di token in input e 10 $ per milione di token in output.
La nostra panoramica di Claude Sonnet 5.5 copre benchmark, confronti di prezzo e accesso. Tre delle sue funzionalità API sono nuove in questa release e Rivermark le usa tutte.
Claude Sonnet 5.5 aggiunge tre modi per cambiare una conversazione mentre è in corso. Secondo Novità in Claude Sonnet 5.5, nessuno di questi è disponibile su Claude Sonnet 5:
L'agente Rivermark è un'applicazione Python costruita attorno a una conversazione della Messages API con due livelli di permessi. Durante l'indagine, Claude può leggere ordini, rimborsi, transazioni del processore, la policy di chiusura e il controllo di riconciliazione di Rivermark. Dopo l'approvazione, può registrare solo le rettifiche approvate.
Rivermark usa un loop personalizzato della Messages API invece del Claude Agent SDK perché il gate di approvazione deve stare tra le chiamate agli strumenti di Claude e la loro esecuzione.
Il codice completo e i dati di esempio sono nel repository GitHub di Rivermark.
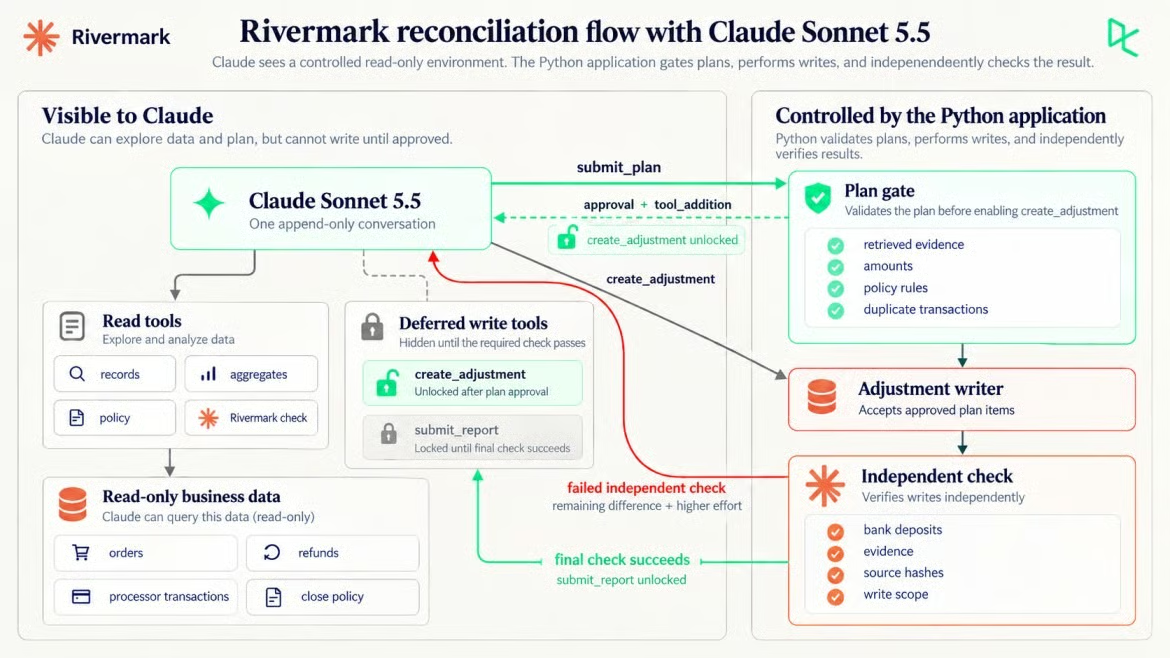
Claude propone, Python concede l'accesso in scrittura. Immagine dell'autore.
Il controllo di Rivermark riporta 3.400,14 $ come payout atteso e 3.251,14 $ come totale calcolato dal processore, una differenza di 149,00 $. Claude deve spiegare la differenza tra i record senza vedere nessuna delle cause nascoste.
Rivermark vende tre piani mensili: Starter a 29 $, Team a 79 $ e Business a 149 $. L'esempio contiene 58 ordini di settembre, 7 record di rimborso e 65 transazioni di settembre del processore. Ogni record del processore ha un importo, una commissione e un valore netto.
Python, non Claude, decide se la riconciliazione è completa:
Il mese è settembre 2026, in base alla data di regolamento del processore.
Il totale dei bonifici bancari di settembre è il target di regolamento indipendente dell'esperimento.
In equilibrio significa payout atteso più rettifiche uguale a quei bonifici al centesimo.
Ogni rettifica cita i txn_ids del processore che Claude ha recuperato e il suo importo eguaglia il loro netto.
Claude può solo aggiungere rettifiche approvate e inviare il report finale.
Le esportazioni grezze sono hashuate prima dell'elaborazione e devono coincidere dopo.
Claude non può ispezionare i registri bancari o il totale target durante la sua indagine iniziale. Dopo un controllo fallito, Python rivela solo il payout atteso, il totale aggregato dei bonifici e la differenza residua, non i registri bancari stessi.
Ti serve Python 3.10 o successivo, che richiede il Python SDK, una chiave API Anthropic e anthropic 1.9.0. Questi comandi PowerShell clonano il progetto, creano l'ambiente e generano i dati di esempio:
git clone https://github.com/KhalidAbdelaty/sonnet-5-5.git
cd sonnet-5-5
python -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env
python build_data.py
Su macOS o Linux, usa source .venv/bin/activate e cp .env.example .env, poi inserisci la tua chiave in .env. La nostra guida alle variabili d'ambiente spiega lo schema.
streamlit run app_streamlit.py apre un'interfaccia web che mostra ogni passaggio della riconciliazione man mano che avviene, e la nostra guida a Streamlit tratta l'installazione.
Se la tua chiave API funziona già, salta la prossima richiesta e passa al pensiero adattivo.
Se oggetti di richiesta e risposta API sono nuovi per te, la nostra guida alle API in Python copre le basi. Una sola domanda sui rimborsi basta per confermare la chiave e ispezionare i blocchi di contenuto restituiti:
import anthropic
from dotenv import load_dotenv

load_dotenv()
client = anthropic.Anthropic()  # reads ANTHROPIC_API_KEY

response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "A refund was requested on August 31 and settled on "
                                          "September 2. Which month's payout should it reduce, and why?"}],
)
print([block.type for block in response.content])
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Nella mia esecuzione, la risposta è iniziata con un blocco thinking. Seleziona i blocchi per type invece di leggere response.content[0]; i token di thinking sono fatturati come output.
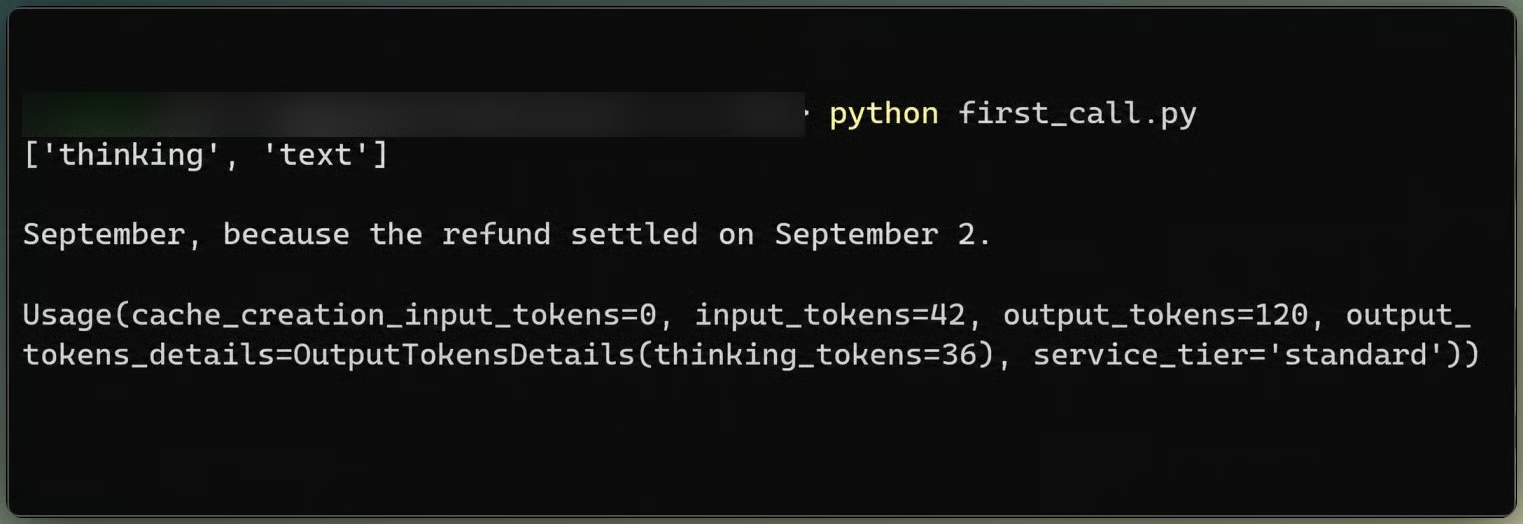
La prima risposta separa thinking dal testo. Immagine dell'autore.
Ogni richiesta invia le stesse impostazioni di alto livello e solo messages cresce:
response = client.beta.messages.create(
    model=MODEL, max_tokens=MAX_TOKENS, system=SYSTEM_PROMPT, tools=TOOLS,
    cache_control={"type": "ephemeral"},               # automatic caching, breakpoint moves forward
    thinking={"type": "adaptive", "display": "updates"},
    output_config={"effort": START_EFFORT},             # never changes: per-message changes do that
    messages=messages, betas=BETAS,
)
Nonostante il high predefinito dell'API, questo workflow parte da medium. La guida allo sforzo di Anthropic dice: "Per coding agentico e uso di strumenti multistep, inizia con medium per compiti ben specificati e passa a high per quelli più difficili o lunghi."
Il thinking resta adattivo perché il cambio di sforzo più avanti dipende da questo. display: "updates" (beta, thinking-display-updates-2026-08-18) restituisce le note che Claude scrive tra le chiamate agli strumenti. Senza questa impostazione, i blocchi di thinking sono vuoti.
Il cache_control di alto livello attiva il caching automatico del prompt, con un breakpoint che si sposta in avanti man mano che la conversazione cresce. La prima richiesta ha scritto 2.080 token in cache, ben al di sopra del minimo di 512 token di Claude Sonnet 5.5.
Un agente di indagine in sola lettura consente a Claude di richiedere prove ma non espone alcuno strumento di scrittura. Rivermark rifiuta anche le chiamate di scrittura non approvate in Python.
Claude ottiene cinque strumenti di lettura e uno di proposta, tutti con strict: true. Le descrizioni dicono cosa restituisce ogni strumento e nulla su dove cercare:
list_sources restituisce fonti, colonne e conteggi delle righe.
query_records restituisce fino a 40 righe da una fonte, con un filtro opzionale e un intervallo di date.
aggregate_records conta le righe e totalizza amount_cents per qualsiasi colonna.
read_policy restituisce la policy di chiusura.
run_reconciliation_check esegue la logica interna esistente di Rivermark, bug inclusi.
submit_plan invia a Python una diagnosi e le rettifiche proposte per la validazione e non scrive nulla.
Altri due strumenti stanno nello stesso array tools, ma defer_loading: true li tiene fuori dalla vista di Claude per ora. Più avanti vedremo come compaiono:
{"name": "run_reconciliation_check", "strict": True,
 "description": "Run Rivermark's current internal reconciliation logic for September 2026, "
                "including adjustments recorded so far.",
 "input_schema": _schema({}, [])},
{"name": "create_adjustment", "strict": True, "defer_loading": True,
 "description": "Record one approved adjustment in the close adjustments ledger. Never edits source files.",
 "input_schema": _schema({...}, ["evidence_txn_ids", "rule", "amount_cents", "memo"])},
Lo schema dello strumento di scrittura è noto già alla prima richiesta, quindi lo strumento è dichiarato in anticipo. La scelta di uno strumento nominato o di any restituisce un errore 400, quindi il prompt specifica quando si applica submit_plan.
La nostra guida a agent harness engineering spiega come Python può gestire loop agent più lunghi. Il loop di Rivermark invia la conversazione, esegue in Python eventuali blocchi tool_use e aggiunge i risultati. Ogni ID di record restituito da uno strumento di lettura va in un set observed che il gate del piano controllerà dopo:
messages.append({"role": "assistant", "content": response.content})  # thinking blocks go back unchanged
if response.stop_reason == "tool_use":
    results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        if block.name in READ_TOOLS:
            out = reads.run(block.name, block.input)  # adds returned IDs to gate.observed
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": dumps(out)})
        ...  # submit_plan goes to the gate; create_adjustment to the executor
    messages.append({"role": "user", "content": results})
Il turno dell'assistente torna esattamente come ricevuto, inclusi i blocchi di thinking vuoti. La guida alla migrazione spiega che Claude Sonnet 5.5 lega i blocchi di thinking ai messaggi precedenti, quindi modificare quella cronologia può restituire un errore 400.
A sforzo medio, l'indagine ha richiesto sei chiamate API e nove chiamate a strumenti di lettura. Claude ha recuperato i rimborsi e ha raggruppato le righe del processore per reporting_category. Ha trovato RF-1043, un rimborso da 149,00 $ per un ordine del 31 agosto regolato il 2 settembre. La regola di policy POL-3 lo colloca a settembre.
Poi ha aperto entrambe le righe della disputa. TXN-50036 contiene un importo principale di -149,00 $, una commissione di 15,00 $ e un effetto di cassa netto di -164,00 $. TXN-50052 restituisce il principale di 149,00 $ senza commissione. Claude ha scritto: "DSP-0077 si azzera e la sua commissione da 15 $ è già registrata correttamente, quindi RF-1043 spiega completamente la varianza."
Claude aveva confuso il principale restituito con l'effetto di cassa al netto delle commissioni:
Il gate ha respinto il primo piano di Claude perché citava l'ordine ORD-20813 senza averlo recuperato. Claude ha recuperato l'ordine, ha ripresentato e PLAN-1 è passato con una rettifica.
Prima di esporre lo strumento di scrittura, il gate controlla da dove provengono le prove e cosa cambierebbe il piano.
Ogni rettifica in un piano cita gli txn_id del processore. Il gate l'accetta solo se ogni riga citata è stata restituita da uno strumento di lettura in questa conversazione e le righe totalizzano l'importo proposto:
def evidence_problems(self, item: dict) -> list[str]:
    """Provenance: every cited line was retrieved, and the lines net to the adjustment."""
    ids = item["evidence_txn_ids"]
    problems = [f"{t} was never returned by a read tool in this conversation."
                for t in ids if t not in self.observed]
    unknown = [t for t in ids if t not in self.lines]
    if unknown or not ids:
        problems.append(f"Evidence must be processor txn_ids; not found: {', '.join(unknown) or 'none given'}.")
    elif sum(self.lines[t]["net_cents"] for t in ids) != item["amount_cents"]:
        problems.append(f"amount_cents {item['amount_cents']} is not the net_cents total of {', '.join(ids)}.")
    return problems
Una rettifica da 15,00 $ che cita solo l'addebito della disputa fallisce perché il netto di quella riga è -164,00 $. Il piano deve citare anche lo storno.
Il gate controlla anche le regole di policy e le transazioni duplicate. Un piano viene respinto, e l'accesso in scrittura resta bloccato, se un elemento fa una di queste cose:
I rifiuti tornano come risultato dello strumento submit_plan, così Claude può approfondire e ripresentare. Il gate ha respinto 2 invii su 4 e Claude ha corretto ciascuno alla chiamata successiva. Anche dopo l'approvazione, create_adjustment accetta solo voci che coincidono esattamente con un elemento approvato.
Una volta che il gate approva un piano, Python aggiunge un messaggio role: "system" con un blocco tool_addition. Il cambiamento richiede l'header beta inline-tools-2026-09-15. L'array tools e ogni messaggio precedente restano invariati, quindi il prefisso in cache coincide ancora. Il testo dell'istruzione viene da Python, non da Claude:
text = UNLOCK_TEXT.format(plan_id=approved_plan)
append_system([{"type": "text", "text": text},
               {"type": "tool_addition", "tool": {"type": "tool_reference",
                                                  "name": "create_adjustment"}}])
gate.write_unlocked = True
Un messaggio di sistema con contenuto deve seguire un turno user, anche uno con blocchi tool_result. Non può stare tra un blocco tool_use e il suo risultato. I messaggi di sistema hanno priorità più alta, quindi non inserire mai in uno il testo del piano di Claude, l'output degli strumenti o i dati. Il blocco tool_addition nomina create_adjustment per riferimento e lo strumento diventa visibile solo dopo l'approvazione del piano.
Il caching è continuato dopo il cambio di strumento. La richiesta ha elaborato 231 token di input non in cache e ne ha letti 6.883 dalla cache.
La prima rettifica era corretta e ha comunque lasciato il lavoro incompiuto. Claude ha registrato ADJ-001, -149,00 $ sotto POL-3, e ha dichiarato finito. Il controllo interno di Rivermark avrebbe concordato, mostrando una varianza di 0,00 $. Sembra finito, ma non lo è.
Il controllo indipendente in Python confronta invece con i bonifici bancari. Il payout atteso dopo le rettifiche era 3.251,14 $, i bonifici 3.236,14 $, e restavano 15,00 $.
Questo scarto è il motivo per cui il controllo di completamento vive in Python, non nel messaggio finale di Claude.
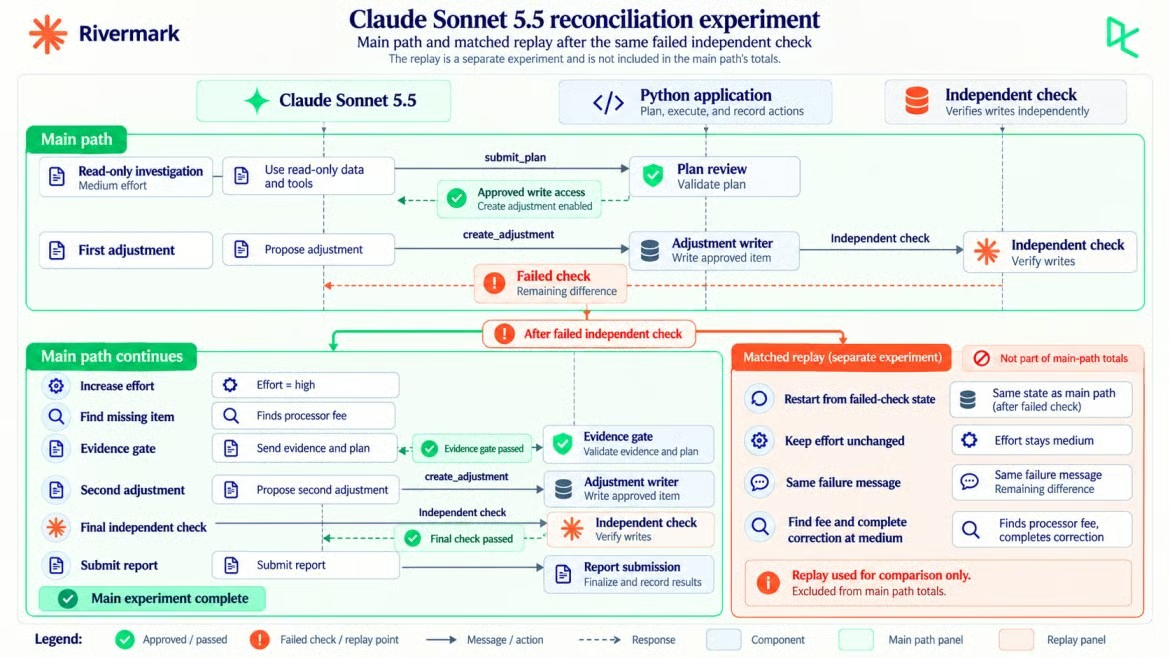
Il replay abbinato si dirama dalla verifica fallita. Immagine dell'autore.
Cambiare sforzo a metà conversazione su Claude Sonnet 5.5 significa aggiungere un messaggio di sistema con content vuoto e un nuovo output_config.effort. Il nuovo livello si applica dal turno user successivo, e tutto ciò che viene prima resta in cache.
Lo sforzo per messaggio è in beta e richiede l'header mid-conversation-output-config-2026-07-01. Richiede anche il thinking adattivo: con between_tools, lo stesso cambiamento restituisce un errore 400. Quando il controllo indipendente fallisce, Python aggiunge la nuova impostazione di sforzo prima del prossimo messaggio utente:
if escalate:
    append_system([], output_config={"effort": ESCALATED_EFFORT})  # effort-only: accepted anywhere
messages.append({"role": "user", "content": (
    f"The harness's independent check failed. Expected payout after adjustments: "
    f"{_cents(result['expected_after_adjustments_cents'])}. Processor deposits for September (bank "
    f"record): {_cents(result['processor_deposits_cents'])}. Residual: {_cents(result['residual_cents'])}. "
    f"Recorded adjustments ({ids}) stay in the ledger. Investigate what the residual is, using the same "
    f"tools, and submit an amended plan that contains only new adjustments.")})
Un cambio di sforzo a livello superiore riavvierebbe la cache, poiché lo sforzo di alto livello fa parte del prompt in cache. La forma per messaggio non lo ha fatto: la prima richiesta ad alto sforzo ha letto 8.012 token dalla cache ed elaborato 4 token non in cache.
La differenza di 15,00 $ dà a Claude un target, ma non prove per una correzione. Il gate richiede ancora gli ID delle transazioni che Claude ha recuperato e i loro net_cents devono totalizzare -15,00 $. Una rettifica proposta di -15,00 $ che cita solo TXN-50036 fallisce comunque perché il netto di quella riga è -164,00 $.
Con sforzo alto, Claude ha raggruppato le righe del processore per payout e per fee_cents, poi ha rieseguito il controllo interno. La sua nota successiva ha portato le righe di commissione a 12.586 centesimi. La commissione della disputa ha portato quel totale a 14.086 centesimi. Il controllo di Rivermark l'aveva esclusa.
Il suo primo piano emendato ha colpito quella regola perché citava solo il debit. Il successivo ha citato entrambe le righe della disputa, PLAN-2 è passato e ADJ-002 ha registrato -15,00 $ sotto POL-4.
Questo esperimento non mostra che high fosse necessario. Un replay separato ha proseguito dallo stesso punto di errore con la stessa cronologia di conversazione e lo stesso messaggio Python, ma è rimasto a medium; ha trovato anche la commissione.
Le sei chiamate a high dello scenario principale hanno prodotto 2.763 token di output (607 di thinking) e sono costate 0,0484 $. Le sei chiamate d'indagine a medium del controllo separato hanno prodotto 2.713 token di output (628 di thinking) e sono costate 0,0464 $, incluso lo stesso rifiuto del gate.
Una chiamata di report finale ha portato il controllo a 7 chiamate e 0,0615 $ in totale. Nessuna di quelle chiamate o costi è inclusa nelle 15 chiamate e 0,1190 $ dello scenario principale.
Entrambi i percorsi hanno ricevuto lo stesso messaggio di controllo fallito; differivano solo per lo sforzo. Un singolo replay non può misurare l'entità di un eventuale effetto dello sforzo, ma mostra che high non era necessario per questo caso. La stessa guida allo sforzo riserva xhigh e max ai casi in cui "le tue valutazioni mostrano un guadagno di qualità". Testa high allo stesso modo prima di selezionarlo.
La verifica finale ripete volutamente 2 controlli del gate: prove e ambito di scrittura. Il gate esamina una proposta prima di scrivere; la verifica finale ispeziona ciò che Python ha effettivamente scritto, poi aggiunge i controlli sui numeri e sui file grezzi.
Dopo ADJ-002, Python ha ricalcolato tutto dai record grezzi, dalle rettifiche approvate e dal totale bancario:
checks = {
    "numbers": adjusted == deposits,
    "provenance": not provenance,
    "raw_unchanged": hash_dir(self.raw) == self.hashes_before,
    "write_scope": set(created) <= ALLOWED_OUTPUTS,
}
Tutti e quattro sono passati. Il payout atteso dopo le rettifiche era 3.236,14 $, corrispondente ai bonifici. Entrambe le rettifiche risalivano a righe recuperate, i dati sorgente grezzi sono rimasti invariati e Python ha scritto solo le voci approvate.
Solo allora inizia la fase di report. L'applicazione aggiunge un messaggio che riporta lo sforzo a medium, un breve turno utente e un messaggio di sistema che scambia gli strumenti:
append_system([{"type": "text", "text": REPORT_TEXT},
               {"type": "tool_removal", "tool": {"type": "tool_reference", "name": "create_adjustment"}},
               {"type": "tool_addition", "tool": {"type": "tool_reference", "name": "submit_report"}}])
Il report è l'ultimo output, non la prova. I suoi suggerimenti di follow-up richiedono comunque una revisione umana. La registrazione qui sotto segue permessi, sforzo, controlli e costo in una sessione Streamlit.
Streamlit segue la riconciliazione dall'inizio. Video dell'autore.
La riconciliazione principale è passata da medium a high, è costata 0,1190 $ su 15 chiamate API e ha richiesto 70,0 secondi, inclusi 69,0 secondi di attesa sull'API. Il replay abbinato separato non è incluso. Ogni cifra proviene da usage della risposta e dalle tariffe di Claude Sonnet 5.5.
Per un'analisi dei costi più ampia, la nostra guida all'API di Claude tratta caching dei prompt e batch processing.
input_tokens conta solo ciò che è arrivato dopo il breakpoint della cache, quindi l'input totale è la somma di tre campi, come spiegano i documenti sul caching del prompt linkati sopra. Le scritture e letture della cache hanno tariffe proprie e i token di thinking sono già inclusi in output_tokens:
cost = (
    usage.input_tokens * 2.00                   # uncached input only
    + cache_creation.ephemeral_5m_input_tokens * 2.50
    + cache_creation.ephemeral_1h_input_tokens * 4.00
    + usage.cache_read_input_tokens * 0.20
    + usage.output_tokens * 10.00               # includes thinking
) / 1_000_000
Durante la riconciliazione, Claude ha letto 105.614 dei 118.308 token di input dalla cache (circa l'89%) e solo 636 sono stati fatturati come input non in cache. Il grafico applica le quattro tariffe dei token all'uso misurato.
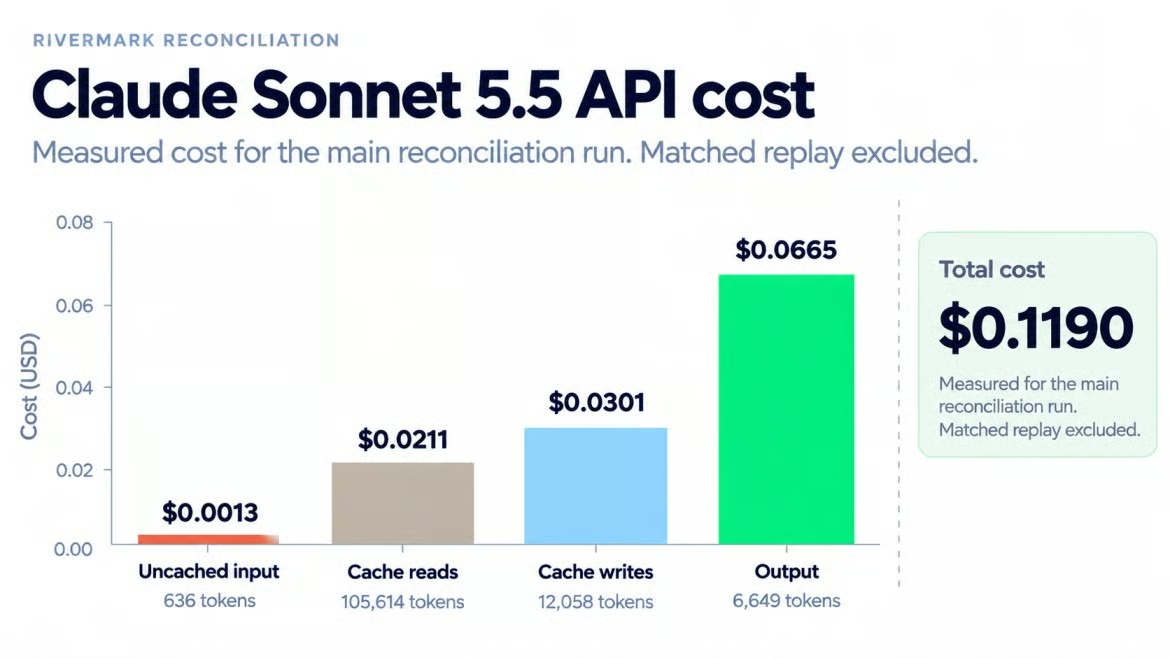
I token di output dominano il costo misurato. Immagine dell'autore.
Rivermark scrive record di rettifica locali, quindi un sistema finance in produzione richiede comunque:
Dati locali e fittizi. Una chiusura reale richiede autenticazione, log di audit, approvazione umana delle registrazioni e una revisione della conservazione dei dati.
Funzionalità beta. Gli header per sforzo per messaggio, cambi di strumenti e aggiornamenti del thinking possono cambiare, quindi testali di nuovo prima del deployment.
Risultati variabili. Claude Sonnet 5.5 rifiuta temperature non predefinite, quindi tentativi ripetuti possono differire. Prova lo schema sui tuoi dati prima di farci affidamento.
Abbiamo costruito un agente di riconciliazione che indaga con strumenti in sola lettura, ottiene uno strumento di scrittura solo dopo che Python approva il piano e termina solo quando passa un controllo indipendente sui bonifici bancari. Claude Sonnet 5.5 ha trovato da solo il rimborso fuori posto, ma è servito quel controllo fallito per rimandarlo alla commissione da 15,00 $ che aveva già letto.
Non generalizzerei un mese fittizio a ogni chiusura. Ciò che si trasferisce è il metodo: nascondi lo strumento di scrittura finché un piano non passa, tieni i registri bancari fuori dal modello, richiedi prove di transazione per ogni correzione e aggiungi cambi di strumenti o sforzo in modo che la cache sopravviva.
Il controllo indipendente è la parte che terrei anche in una versione più piccola di questo progetto. Il cambio di sforzo è la parte che testerei prima di fidarmi, per il motivo trattato nella sezione sullo sforzo.
Scambiare gli strumenti di lettura e il controllo finale consente allo stesso schema di gestire correzioni di pulizia dati, rimborsi di supporto o aggiornamenti controllati di documenti. La mia prima estensione sarebbe un passaggio di approvazione umana prima che ogni rettifica venga scritta, poiché una chiusura reale ne ha bisogno.
Per esercitarti con le basi dell'API Anthropic su cui si fonda questa build, consiglio il nostro corso Introduzione ai modelli Claude.
Impara a usare Claude con DataCamp!
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min