Sei giorni dopo che Anthropic ha messo Claude Opus 5.5 in cima alla sua gamma, il modello di fascia media ha colmato gran parte del divario a metà prezzo. Claude Sonnet 5.5 supera Opus 5.5 in un benchmark e lo segue di soli pochi punti altrove, mantenendo i prezzi di Sonnet 5.
Questo schema l'abbiamo già visto. Claude Sonnet 5 è stato lanciato avvicinandosi ai benchmark agentici di Opus 4.8 a una frazione del costo. Prima ancora, Sonnet 4.6 era arrivato a ridosso di Opus 4.6 con gli stessi presupposti. Ogni volta, un modello di fascia media arriva giorni o settimane dopo il top di gamma e chiude gran parte del divario a metà prezzo.
È così che appare dall'esterno una curva di scalabilità logaritmica. Le prestazioni crescono all'incirca con il log del compute, quindi il costo cresce approssimativamente in modo esponenziale con le prestazioni. Un modello di punta siede in cima a quella curva, dove spende molto per comprare gli ultimi punti. Un modello più economico costruito poche settimane dopo, beneficiando degli stessi progressi sottostanti, deve raggiungere solo un punto inferiore sulla curva per sembrare quasi altrettanto valido. In altre parole, la maggior parte del valore della curva è ancora economico da ottenere, e solo il tratto finale è costoso.
Penso valga la pena chiarirlo perché le aziende leader fanno un po' di magia con PR e branding.
TL;DR
- Sonnet 5.5 è il nuovo modello di fascia media di Anthropic, sostituisce Sonnet 5 allo stesso prezzo.
- Il guadagno principale è nel coding agentico su terminale, dove ora supera di poco Opus 5.5.
- Sul lavoro di conoscenza e l'uso del computer, è appena dietro Opus 5.5 a metà del prezzo per token.
- Impostalo come tuo modello Claude predefinito e tieni Opus 5.5 per lavori aperti e ricchi di giudizio.
Cos'è Claude Sonnet 5.5?
La documentazione del modello di Anthropic descrive Claude Sonnet 5.5 come "il miglior compromesso tra velocità e intelligenza" nell'attuale lineup. È il modello di fascia media della famiglia Claude 5.5 di Anthropic, posizionato tra il top di gamma Claude Opus 5.5 e il prossimo Claude Haiku 5.5. (Ti terremo aggiornato su Haiku 5.5, anche se Haiku 5 non è mai arrivato.)
Rispetto a Sonnet 5, il salto è più grande di quanto suggerisca un “mezzo” numero di versione. Non è sorprendente dopo aver visto che il salto tra Opus 5.5 e Opus 5 è stato più grande del previsto.
Quanto al post di lancio - Anthropic riporta progressi su ogni benchmark pubblicato, con i balzi più grandi nel coding da terminale, nella lettura di grafici e nelle valutazioni sul lavoro di conoscenza.
Curiosamente, Anthropic afferma che questo modello Sonnet è il primo a battere Pokémon Rosso lavorando solo da screenshot. Suona insolito, ma è un test che Anthropic usa come proxy per lavoro a lungo orizzonte e comprensione delle immagini.
Quindi, Opus 5.5 rimane, a detta dell'azienda, chiaramente più forte nei lavori complessi e aperti che richiedono giudizio sostenuto. Ma Sonnet 5.5 è il modello per i compiti in cui sai come appare il "fatto", che è un'utile euristica.
Caratteristiche principali di Claude Sonnet 5.5
La maggior parte delle novità in Sonnet 5.5 riguarda lo svolgere lo stesso lavoro più velocemente e con meno token, più alcune modifiche che gli utenti API devono pianificare.
Ottieni risultati quasi-Opus sui compiti quotidiani alla velocità di Sonnet
Puoi affidare a Sonnet 5.5 il tipo di lavoro che prima richiedeva Opus e riceverlo indietro più rapidamente. Anthropic afferma che la generazione di output è oltre il 30% più veloce di Sonnet 5, e che il modello usa meno token per attività - "fino al 30% in meno per attività" - è la cifra che forniscono.
I primi tester citati nel post di lancio lo confermano con i loro numeri:
- Base44 riporta 3,6 iterazioni per build di app con Sonnet 5.5, contro 7,7 con Opus 5.
- Box ha visto i propri carichi di lavoro andare 2,4 volte più veloci con il 12% di token totali in meno.
- Zendesk ha misurato un'elaborazione ticket più veloce del 20%.
- Slack segnala circa il 14% di token di output in meno.
Sono citazioni di clienti selezionati dal fornitore. Tuttavia, emerge un pattern: meno iterazioni e meno token, che conta sulla bolletta insieme alla tariffa per token.
Esegui agent di coding nel terminale e sul desktop
Sonnet 5.5 è progettato per lavorare come agente: eseguire comandi shell, correggere bug in un repository e usare un desktop tramite screenshot. È disponibile in Claude Code dal lancio, e Anthropic descrive il suo uso del computer come vicino a Opus 5.5.
La conseguenza pratica per molti è che Sonnet 5.5 è ora un predefinito credibile per le sessioni di Claude Code e per i loop agentici che costruisci tu con la nostra guida all'API di Claude.
Produci documenti, slide e interfacce rifinite
Anthropic evidenzia un "occhio attento al design" come punto di forza di Sonnet 5.5. In pratica, dovrebbe tradursi in interfacce utente migliori quando gli chiedi di rifinire codice front-end e in output più finiti quando chiedi slide, fogli di calcolo o documenti lunghi.
La pretesa sul design è quella che necessita di più verifiche indipendenti. È la più difficile da misurare, e il post di lancio la supporta solo con citazioni di clienti.
Aspettati salvaguardie su sicurezza e biologia
Sonnet 5.5 è il primo modello Sonnet a essere lanciato con salvaguardie di cybersicurezza simili a quelle di Opus 5.5. Quando una richiesta è classificata come lavoro di sicurezza a rischio più elevato, la richiesta ricade su Sonnet 5. Le salvaguardie biologiche sono le stesse di Sonnet 5, e Anthropic afferma che la maggior parte dello sviluppo software e del lavoro nelle scienze della vita non sarà influenzata.
È anche il primo Sonnet a essere distribuito con classificatori che bloccano l'estrazione del reasoning, e i blocchi di thinking sono ora legati all'account e alla conversazione che li ha prodotti. Se esegui tool di sicurezza, testa i prompt prima di cambiare una pipeline.
Effettua la migrazione da Sonnet 5 con poche modifiche al codice
Scambiare solo l'ID del modello non basta. La documentazione di Anthropic elenca cinque modifiche breaking per codice già in esecuzione su Sonnet 5:
-
Il thinking adattivo è attivo per impostazione predefinita, e l'impostazione più bassa è
between_tools, che disattiva il thinking iniziale. -
L'uso forzato degli strumenti restituisce un errore.
-
I blocchi di thinking sono legati al modello e alla conversazione che li ha prodotti.
-
Il vecchio strumento di uso del computer
computer_20251124è rifiutato sulla Claude API e su Google Cloud. -
Lo strumento advisor non accetta più Opus 4.8, Opus 4.7 o Sonnet 5 come advisor.
C'è anche una modifica più silenziosa: il testo tra le chiamate agli strumenti ora torna in blocchi di thinking. Un'app che fa streaming di testo agli utenti rimarrà silente tra le chiamate agli strumenti finché non aggiorni la sua impostazione di display. Impostare temperature, top_p o top_k a un valore non predefinito restituisce anche un errore 400. Sono cose specifiche che potresti scoprire.
Come si comporta Claude Sonnet 5.5 nei benchmark?
Claude Sonnet 5.5 supera Sonnet 5 su ogni benchmark pubblicato da Anthropic, batte Opus 5.5 nel coding da terminale e lo segue di pochi punti altrove. Rispetto a GPT-6 Sol di OpenAI, è avanti nelle valutazioni su lavoro di conoscenza e lettura di grafici ma dietro su FrontierCode. Tutte le cifre sotto provengono dal post di lancio di Anthropic.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | Non riportato |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | Non riportato |
| FrontierCode 1.1 (Main) | 46,2% (max effort) | 42,4% | 54,4% | 49,3% (52,1% a xhigh) |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (with tools) | 64,5% | 54,9% | 67,7% | Non riportato |
| OSWorld 2.1 | 80,1% | 57,0% | 81,8% | Non riportato |
| Chartography (no tools) | 61,6% | 15,6% | 64,4% | 53,6% |
La tabella racconta una storia semplice: un grande salto generazionale rispetto a Sonnet 5, e un quasi pareggio con Opus 5.5. Vediamo cosa significa ciascuna area per il tuo lavoro.
Coding agentico
Terminal-Bench 4.0 è dove Sonnet 5.5 si distingue. Segna 70,6%, in salita dal 10,3% di Sonnet 5 e davanti al 66,4% di Opus 5.5. Il benchmark misura se un modello può completare attività reali in un ambiente a riga di comando, come workflow shell multi-step, quindi mappa da vicino l'uso di Claude Code.
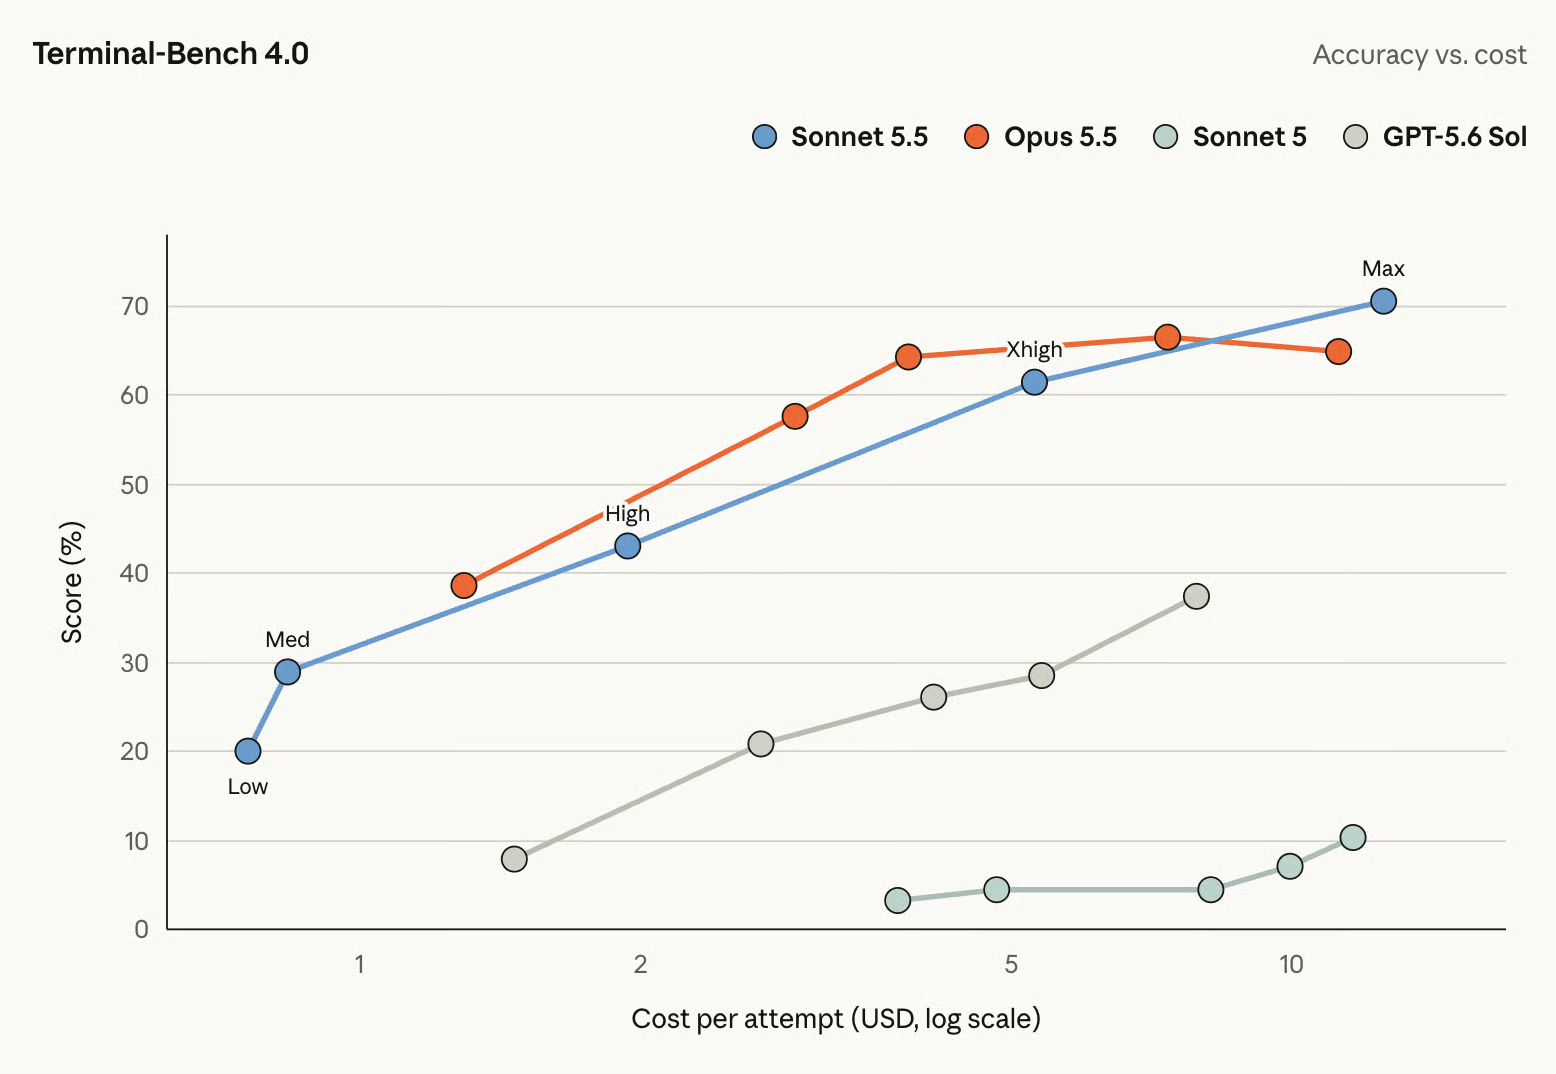
Un salto di 60 punti in una release è abbastanza insolito. Il resto del quadro sul coding è meno drammatico.
Lavoro di conoscenza
Su GDPval-AA v2.1, che valuta l'output del modello su compiti economicamente preziosi tratti da professioni reali usando un punteggio in stile Elo, Sonnet 5.5 ottiene 1844. Sono 2 punti dietro Opus 5.5 e quasi 400 davanti a Sonnet 5.
Per i team che usano Claude per report, analisi e documenti di business, questo è il risultato più utile in tabella. Su questo tipo di lavoro, l'extra costo di Opus 5.5 compra solo un po'.
Ragionamento e comprensione visiva
Chartography, un test di lettura e ragionamento su grafici senza strumenti, mostra il guadagno relativo più grande: Sonnet 5.5 segna 61,6% contro il 15,6% di Sonnet 5. Questo è in linea con le affermazioni di Anthropic su una migliore comprensione delle immagini.
Uso del computer
Su OSWorld 2.1, che misura se un modello può completare attività usando un vero sistema operativo desktop, Sonnet 5.5 arriva all'80,1%, in salita dal 57,0% di Sonnet 5 e a meno di 2 punti da Opus 5.5.
Quale fascia dovresti usare?
Per la maggior parte degli sviluppatori, Sonnet 5.5 dovrebbe ora essere il modello Claude predefinito. Opus 5.5 giustifica il suo prezzo più alto solo quando il compito è abbastanza aperto che il collo di bottiglia è il giudizio, non la velocità.
L'attuale lineup, secondo la tabella di confronto dei modelli di Anthropic, è questa. Tutti e quattro i modelli tranne Haiku 4.5 condividono una finestra di contesto da 1M token e un output massimo di 128K.
| Modello | Prezzo (input / output per 1M token) | Latenza | Ideale per |
|---|---|---|---|
| Claude Fable 5.1 | $10 / $50 | Più lenta | Lavori di fascia alta dove la capacità conta più del costo |
| Claude Opus 5.5 | $4 / $20 | Moderata | Lavoro complesso e aperto che richiede giudizio sostenuto |
| Claude Sonnet 5.5 | $2 / $10 | Veloce | Coding ben definito, agent e lavoro su documenti |
| Claude Haiku 4.5 | $1 / $5 | La più veloce | Attività ad alto volume e sensibili ai costi |
All'interno di Sonnet 5.5, l'impostazione dello sforzo è l'altra leva. Anthropic ha ricalibrato cinque livelli: low, medium, high, xhigh e max. I livelli più bassi privilegiano velocità e costo, mentre quelli più alti lasciano al modello più tempo per ragionare e verificare il proprio lavoro. Il predefinito è medium nelle app Claude e in Claude Code, e high sull'API.
Un dettaglio dal post di lancio cambia come lo userei: a sforzo basso o medio, Sonnet 5.5 supera il miglior punteggio di Sonnet 5 su diversi benchmark a circa un decimo del costo per attività. In sintesi:
-
Bugfix, refactor e sessioni con Claude Code: Sonnet 5.5 allo sforzo predefinito.
-
Loop agentici e pipeline ad alto throughput: Sonnet 5.5 su
lowomedium, poi alza lo sforzo solo sui fallimenti. -
Problemi di coding difficili con specifica chiara: Sonnet 5.5 su
xhighomaxprima di pagare per Opus. -
Progetti ambigui e multi-giorno: Opus 5.5.
Test di Claude Sonnet 5.5: esempi pratici
I benchmark sopra sono di Anthropic, quindi ho eseguito un compito di build con Claude Sonnet 5.5 e Claude Sonnet 5 con prompt e tool identici.
Il compito: trasformare il dataset dei laureati recenti di FiveThirtyEight (173 corsi di laurea USA, CC BY 4.0) in una dashboard HTML a file unico che aiuti un futuro studente a confrontare le categorie su guadagni e occupazione e a trovare i corsi più e meno remunerativi.
Il vero test è nei dati, che hanno alcune caratteristiche che il prompt non menziona mai:
- Il top earner, Ingegneria del petrolio, ha solo 36 rispondenti al sondaggio, e 76 dei 173 corsi hanno meno di 100
- I guadagni sono asimmetrici, quindi una singola barra di mediana nasconde molta variabilità
- Un corso, Scienze alimentari, ha campi di conteggio vuoti
- Le colonne per tipo di lavoro non sommano al numero di persone occupate
Notare questi problemi è il punto del test. Il test sonda le affermazioni di Anthropic su un "occhio attento al design".
I principali riscontri:
- Solo Sonnet 5.5 ha consegnato una dashboard funzionante. Sonnet 5 ha collegato un file di Chart.js che non esiste su cdnjs (l'URL restituisce un 404), quindi la libreria non è mai stata caricata e ogni pannello, incluse le sue tabelle semplici, è rimasto vuoto. Sonnet 5.5 controlla anche se la sua libreria di grafici è stata caricata e mantiene funzionanti le tabelle se non lo è.
- Sonnet 5.5 ha colto la trappola dei piccoli campioni, per lo più. Contrassegna i corsi con meno di 30 rispondenti come "trattare con cautela" e aggiunge un filtro per i rispondenti minimi. La sua vista predefinita mette Ingegneria del petrolio al n. 1 senza avviso.
- Sonnet 5 l'avrebbe mancata comunque. Il suo codice legge le colonne sulla dimensione del campione e sull'intervallo salariale, poi non le usa mai, e classifica i corsi solo per mediana.
- Le trappole minori non hanno ingannato nessuno. Entrambi hanno gestito esplicitamente la riga vuota di Scienze alimentari, e Sonnet 5.5 ha calcolato la quota di lavori “da laurea” senza implicare che le colonne sommino all'occupazione totale.
Ecco la dashboard di Sonnet 5.5 con il filtro impostato sui corsi con almeno 100 rispondenti.
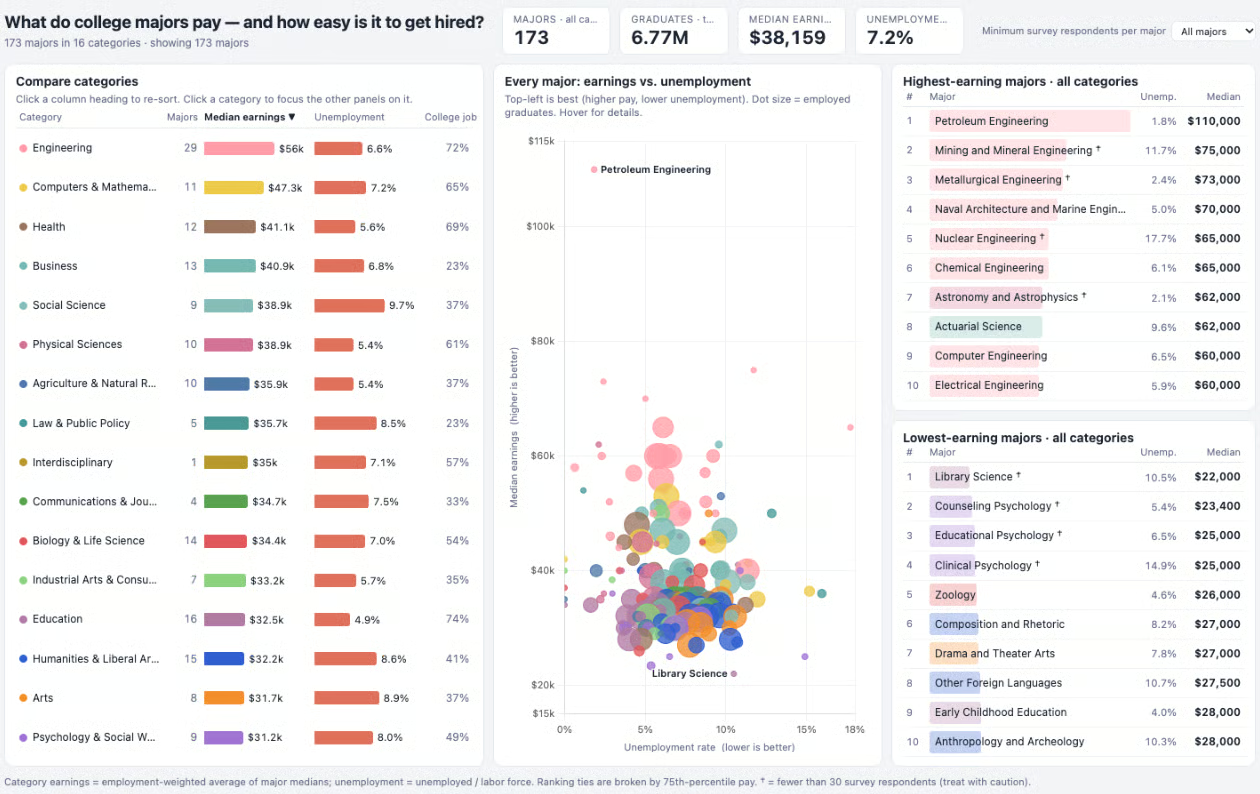
Ho valutato la dashboard di Sonnet 5.5 con 4 su 5 per la gestione onesta dei dati, 5 per l'utilità analitica e 4 per qualità di grafici e layout. La pagina vuota di Sonnet 5 la includo qui sotto.
Perché quindi Sonnet 5 ha fallito? Il problema era che la dashboard aveva bisogno di una libreria di grafici. Sonnet 5 ha chiesto a cdnjs una versione che non ospita. Ha quindi ricevuto un errore "404". Senza la libreria, il codice di Sonnet 5 è andato in crash: "Chart is not defined." A quanto pare, Sonnet 5 aveva scritto la pagina in modo che tutto, anche le sue tabelle di testo semplici, girasse dopo quel passaggio, e non è riuscito a intercettare l'errore.
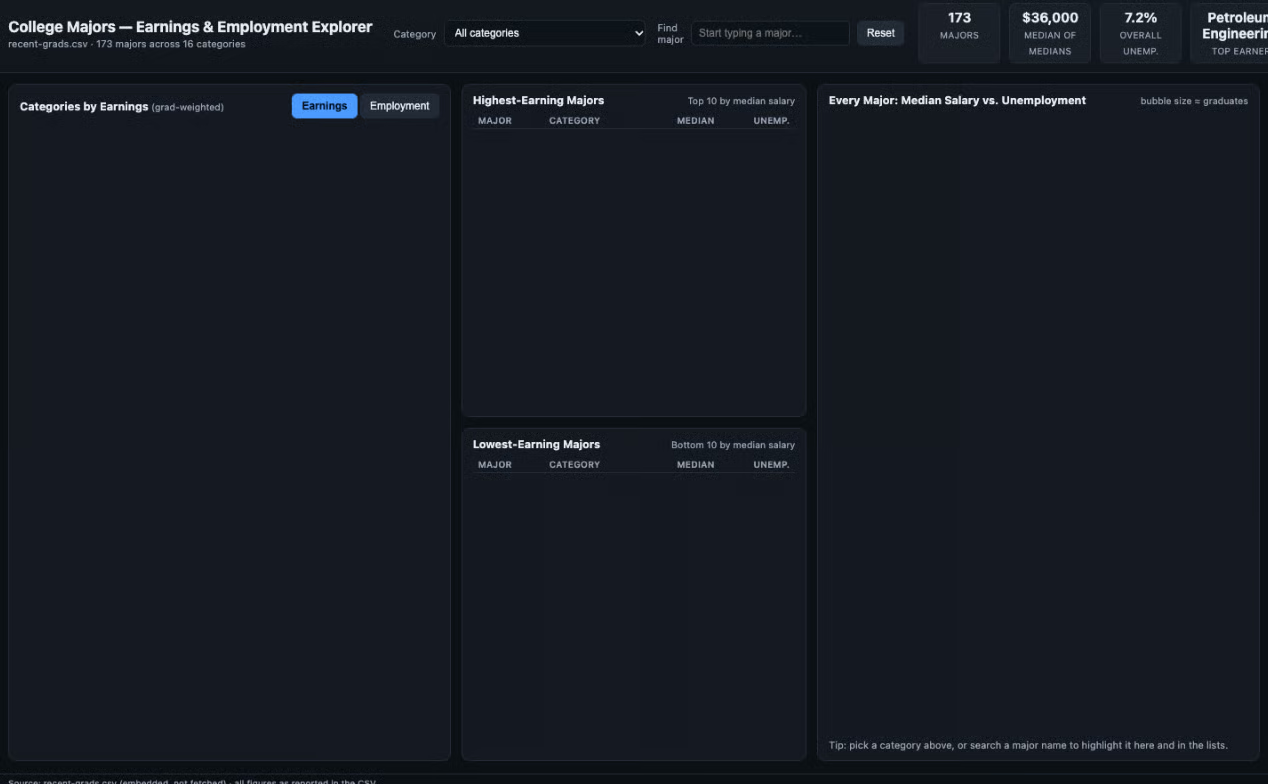
Il costo per esecuzione è stato essenzialmente identico: $0,56 per Sonnet 5.5 e $0,57 per Sonnet 5. Inoltre, Sonnet 5.5 ha finito il lavoro più velocemente.
Quindi, Sonnet 5.5 è un vero passo avanti? Su questo compito, sì. Sonnet 5.5 ha consegnato una dashboard funzionante che avvisa sui dati esigui, mentre Sonnet 5 ha consegnato una pagina vuota.
Prezzi e disponibilità di Claude Sonnet 5.5
Claude Sonnet 5.5 costa $2 per milione di token in input e $10 per milione di token in output sull'API, invariato rispetto a Sonnet 5 e metà del prezzo di Opus 5.5. Anthropic riporta meno token per attività, il che ridurrebbe il costo effettivo di un lavoro anche se la tariffa è fissa. Nel nostro test pratico, però, entrambi i modelli sono costati all'incirca lo stesso per completare il compito.
| Tipo di token | Prezzo per 1M token |
|---|---|
| Input | $2 |
| Output | $10 |
| Cache write (5 minuti) | $2,50 |
| Cache write (1 ora) | $4 |
| Cache read | $0,20 |
La Batch API applica uno sconto del 50% sia su input che su output. Il prompt minimo cacheabile è di 512 token, e sulla Batch API il modello può restituire fino a 300K token di output con l'header beta output-300k-2026-03-24.
Sonnet 5.5 è generalmente disponibile, non in anteprima, con opzione di zero data retention. Anthropic si impegna a non ritirarlo prima del 28 settembre 2027.
Come ottenere accesso a Claude Sonnet 5.5?
Puoi usare Claude Sonnet 5.5 oggi nelle app Claude, in Claude Code e tramite l'API con l'ID modello claude-sonnet-5-5. È disponibile anche su Amazon Bedrock come anthropic.claude-sonnet-5-5, e su Google Cloud, Microsoft Foundry e Claude Platform su AWS con claude-sonnet-5-5.
Ecco una chiamata Python minimale. Il thinking adattivo è attivo per impostazione predefinita, quindi la risposta può includere blocchi di thinking prima del testo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "Find the off-by-one bug in this loop: ..."}],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Per una guida reale a chiavi, costi e primo progetto, vedi la nostra guida completa all'API di Claude. Se stai costruendo agent, il nostro tutorial su come costruire i Claude Managed Agents è un buon prossimo passo. Pubblicheremo a breve un tutorial sull'API di Claude Sonnet 5.5.
Considerazioni finali
Anthropic scommette che la maggior parte del lavoro a pagamento, incluso gran parte del lavoro degli agent di coding, giri su questo nuovo modello di fascia media. Questo mette anche pressione diretta sul GPT-6 Sol di OpenAI, che lo segue sui numeri di Anthropic sul lavoro di conoscenza.
Io passerei subito se sei su Sonnet 5, ma aggiornati sulle modifiche all'API. Tieni Opus 5.5 per i progetti in cui il modello deve decidere cosa costruire.
Se ti interessa approfondire la costruzione con i modelli di Anthropic, ti consiglio di dare un'occhiata al nostro corso Introduzione ai modelli Claude.