Corso
Introduzione a SQL
2 ore
1.6M
Pratica and corso your progress.
Continua Con GoogleLa scelta del database è cruciale nella data science e nello sviluppo di applicazioni, perché incide direttamente su prestazioni, scalabilità e capacità di gestire i dati usati dall’applicazione. Optare per database NoSQL o SQL influisce sull’efficienza di recupero, archiviazione ed elaborazione dei dati, elementi fondamentali per il successo e la reattività delle applicazioni data-driven nel soddisfare esigenze specifiche.
SQL e NoSQL sono due tecnologie di database differenti: i database SQL puntano su modelli strutturati e relazionali, mentre i database NoSQL adottano un approccio flessibile e senza schema per gestire dati eterogenei e dinamici, con maggiore enfasi su scalabilità e velocità.
In questo articolo parleremo delle differenze tra i due sistemi di database. Tuttavia, non tratteremo le basi di nessuno dei due. Dai un’occhiata al nostro percorso di apprendimento SQL Fundamentals per imparare ad accedere ai dati dai database SQL.
Nel 1970, il modello relazionale per i database, un modello per organizzare e archiviare efficacemente i dati in tabelle con una struttura a colonne e righe, fu delineato dal Dr. Edgar Codd nel suo articolo fondamentale, "A Relational Model of Data for Large Shared Data Banks". Nel 1974, IBM sviluppò System R, il primo progetto a implementare il modello relazionale per l’archiviazione dei dati, e sviluppò SQL come linguaggio per interagire con questi database relazionali.
Negli anni sono stati sviluppati nuovi standard per SQL e Oracle, IBM e Microsoft hanno ciascuna realizzato sistemi di gestione di database relazionali (RDBMS) per usare SQL in modo efficiente, sicuro e comodo nell’interazione con i database SQL.
Successivamente, linguaggi open-source come MySQL hanno reso SQL e i database relazionali più accessibili al grande pubblico. Oggi SQL è ampiamente disponibile sia su sistemi fisici sia su cloud come AWS, Azure e Google Cloud.
Nei database SQL, il modello relazionale funge da fondazione concettuale, organizzando i dati in tabelle strutturate e interconnesse. I database SQL sono composti da schemi e tabelle:
Il modello relazionale garantisce la coerenza attraverso due tipi di chiavi: (1) chiavi primarie che identificano in modo univoco ogni record e (2) chiavi esterne che stabiliscono relazioni tra tabelle. Puoi approfondire i database relazionali nel nostro corso Introduction to SQL.
SQL, ovvero Structured Query Language, è l’interfaccia per la gestione di questi database, consentendo la creazione, il recupero, l’aggiornamento e l’eliminazione dei dati tramite comandi standardizzati. Un elenco di questi comandi e delle funzionalità di SQL è disponibile nella nostra SQL Basics Cheat Sheet. Questo modello e i suoi componenti offrono un framework potente e flessibile per organizzare e interrogare i dati in modo da garantire integrità e coerenza in tutto il database.
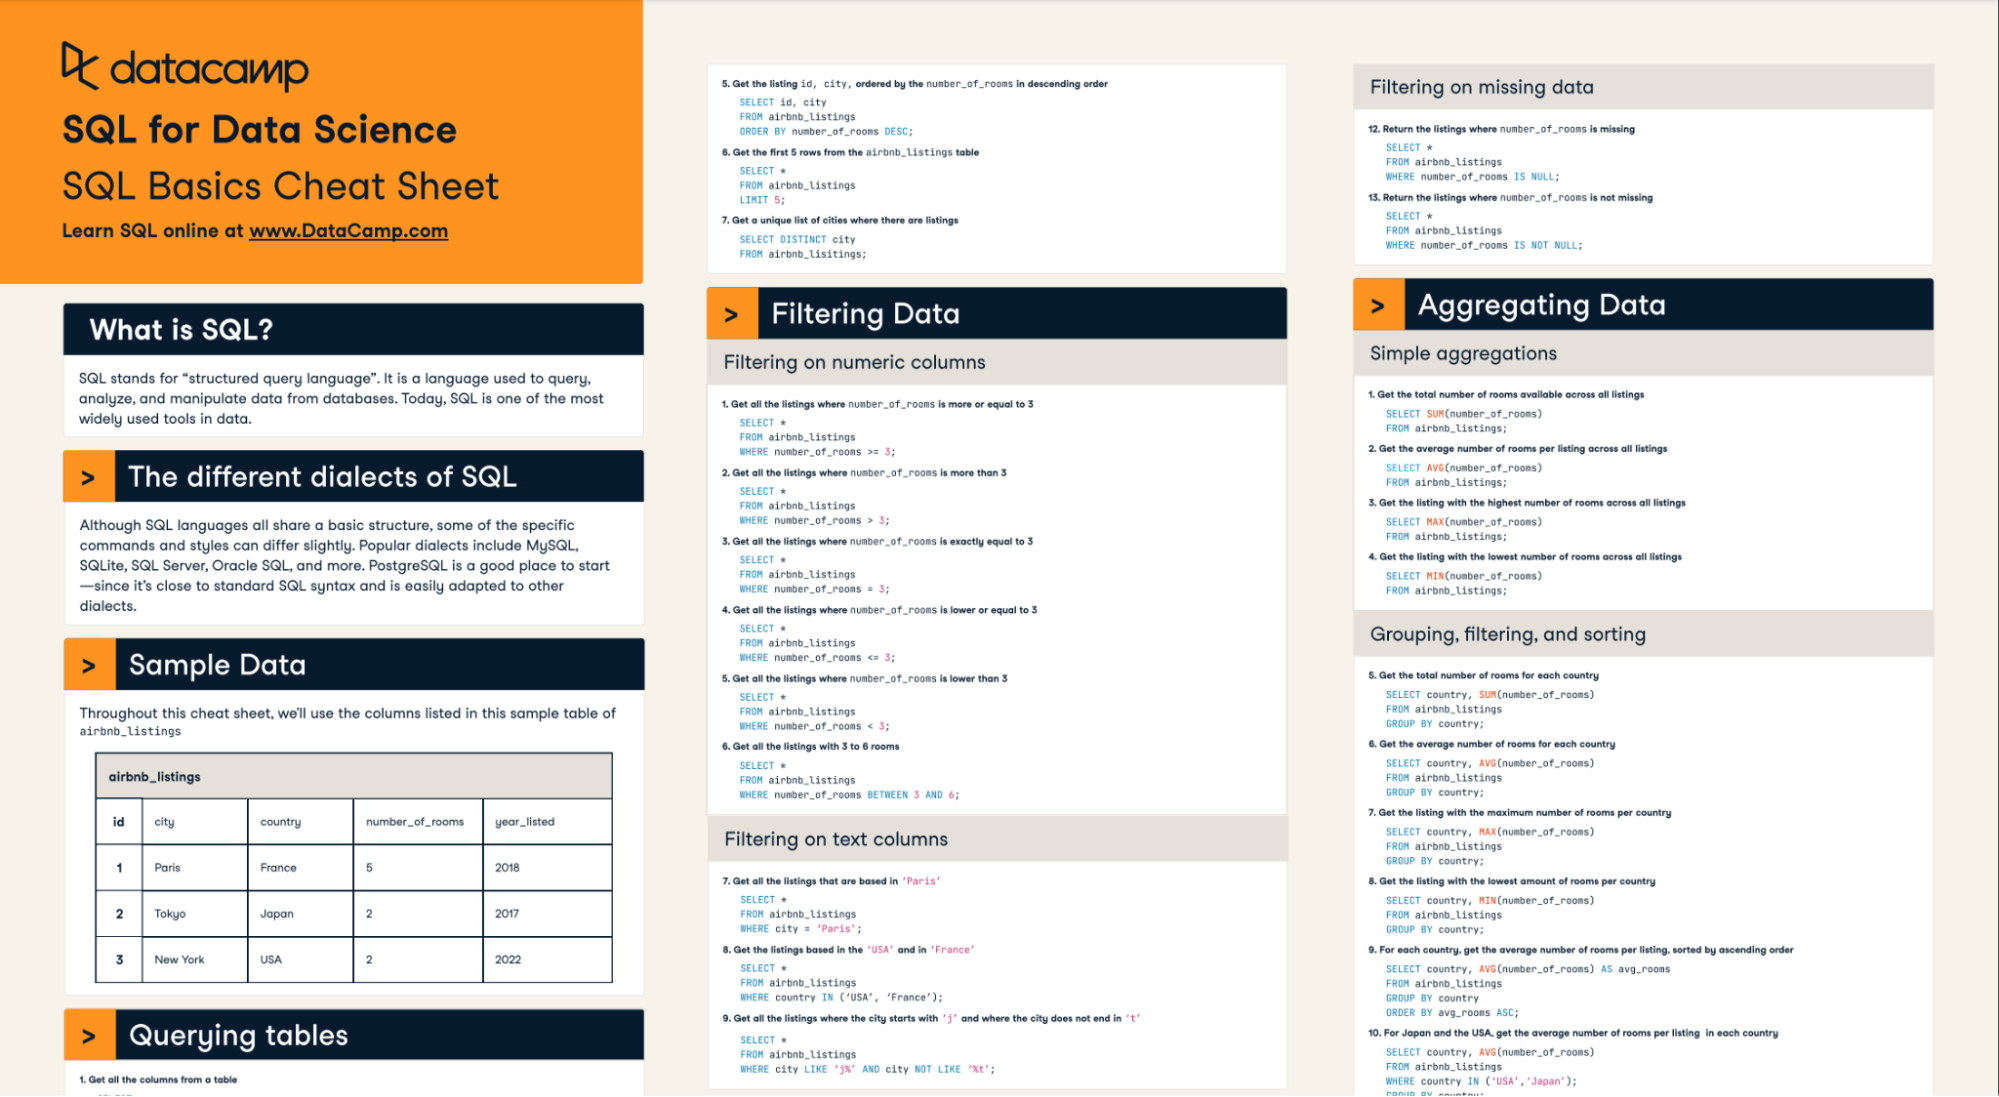
Uno sguardo alla nostra SQL Basics Cheat Sheet
SQL fornisce un set standard di comandi per definire, interrogare, aggiornare e amministrare i dati in un sistema di gestione di database relazionali (RDBMS). Le principali operazioni SQL includono SELECT (interrogazione dei dati), INSERT (aggiunta di nuovi record), UPDATE (modifica dei record esistenti) e DELETE (rimozione dei record).
Quando si utilizzano questi comandi, SQL garantisce il mantenimento delle proprietà ACID (Atomicità, Coerenza, Isolamento e Durabilità). Questo assicura l’affidabilità e la consistenza delle modifiche al database.
Queste proprietà fondamentali dei database SQL assicurano che i sistemi di database siano affidabili e coerenti, anche in caso di eventi imprevisti o guasti del sistema.
Esistono tre RDBMS comunemente utilizzati:
Scopri il nostro tutorial MySQL in Python per iniziare con questo RDBMS, e la nostra Guida per principianti a PostgreSQL.
Puoi leggere la nostra guida completa su Che cos’è NoSQL per una comprensione approfondita dei database Not Only SQL. Di seguito, riassumiamo i nostri risultati.
I database NoSQL (Not Only SQL) sono nati in risposta alle sfide poste dall’espansione dei big data e dal crescente bisogno di scalabilità nei sistemi di database. I database relazionali tradizionali faticano a gestire in modo efficiente grandi quantità di dati non strutturati e semi-strutturati, tipici dei moderni big data. I database NoSQL rappresentano un’alternativa più flessibile e scalabile ai database relazionali.
Gestiscono efficacemente tipi di dato eterogenei, accolgono una rapida crescita dei dati e distribuiscono i dati tra più server in modo efficiente.
Soluzioni NoSQL come MongoDB, Cassandra e Couchbase non usano le stesse strutture rigide supportate dal modello relazionale. Questi sistemi privilegiano la flessibilità dello schema e lo scaling orizzontale, consentendo alle organizzazioni di adattarsi alla natura dinamica dei big data mantenendo prestazioni e affidabilità. La correlazione tra NoSQL, big data e scalabilità evidenzia un’evoluzione fondamentale nella gestione dei database, che consente alle aziende di affrontare le sfide poste dalla recente crescita esponenziale dei dati.
A differenza dei database SQL, i database NoSQL utilizzano schemi dinamici e supportano vari modelli di dati per rispondere a esigenze applicative diverse.
Una caratteristica distintiva dei database non relazionali è l’uso di schemi dinamici. A differenza degli schemi predefiniti e rigidi dei database relazionali, i database non relazionali consentono flessibilità. Record diversi nello stesso database possono avere campi differenti. Per esempio, in un database clienti, un cliente può avere i campi nome ed età, mentre un altro può avere i campi nome ed email.
Esistono vari tipi di database NoSQL:
Puoi saperne di più su MongoDB nel nostro corso Introduction to MongoDB in Python.
La scelta di quale utilizzare dipende dall’applicazione per cui stai usando un database NoSQL.
I database NoSQL offrono diversi vantaggi, con punti di forza notevoli in termini di scalabilità, flessibilità e prestazioni nella gestione di dati non strutturati.
I database NoSQL offrono scalabilità sotto forma di scalabilità orizzontale ed elasticità. Sono progettati per scalare orizzontalmente, consentendo alle organizzazioni di gestire quantità crescenti di dati aggiungendo più server a un sistema distribuito. Questo li rende adatti ad applicazioni con carichi di lavoro in crescita o imprevedibili.
Molti database NoSQL forniscono anche sharding automatico e bilanciamento del carico, distribuendo i dati su più nodi per garantire un uso efficiente delle risorse e prestazioni migliori. Questa capacità consente ai sistemi di scalare verso l’alto o verso il basso in modo dinamico in base alla domanda ed è nota come elasticità.
Offrono inoltre flessibilità dello schema. I database NoSQL usano schemi dinamici, consentendo flessibilità nella rappresentazione dei dati. Ciò significa che i campi in un record possono variare tra documenti diversi, accogliendo le strutture di dati eterogenee e in evoluzione tipiche delle applicazioni moderne.
Inoltre, offrono buone prestazioni con dati non strutturati e semi-strutturati come JSON e XML. I dati odierni sono spesso imprevedibili, soprattutto quando generati dagli utenti, e NoSQL gestisce bene l’archiviazione di questi dati.
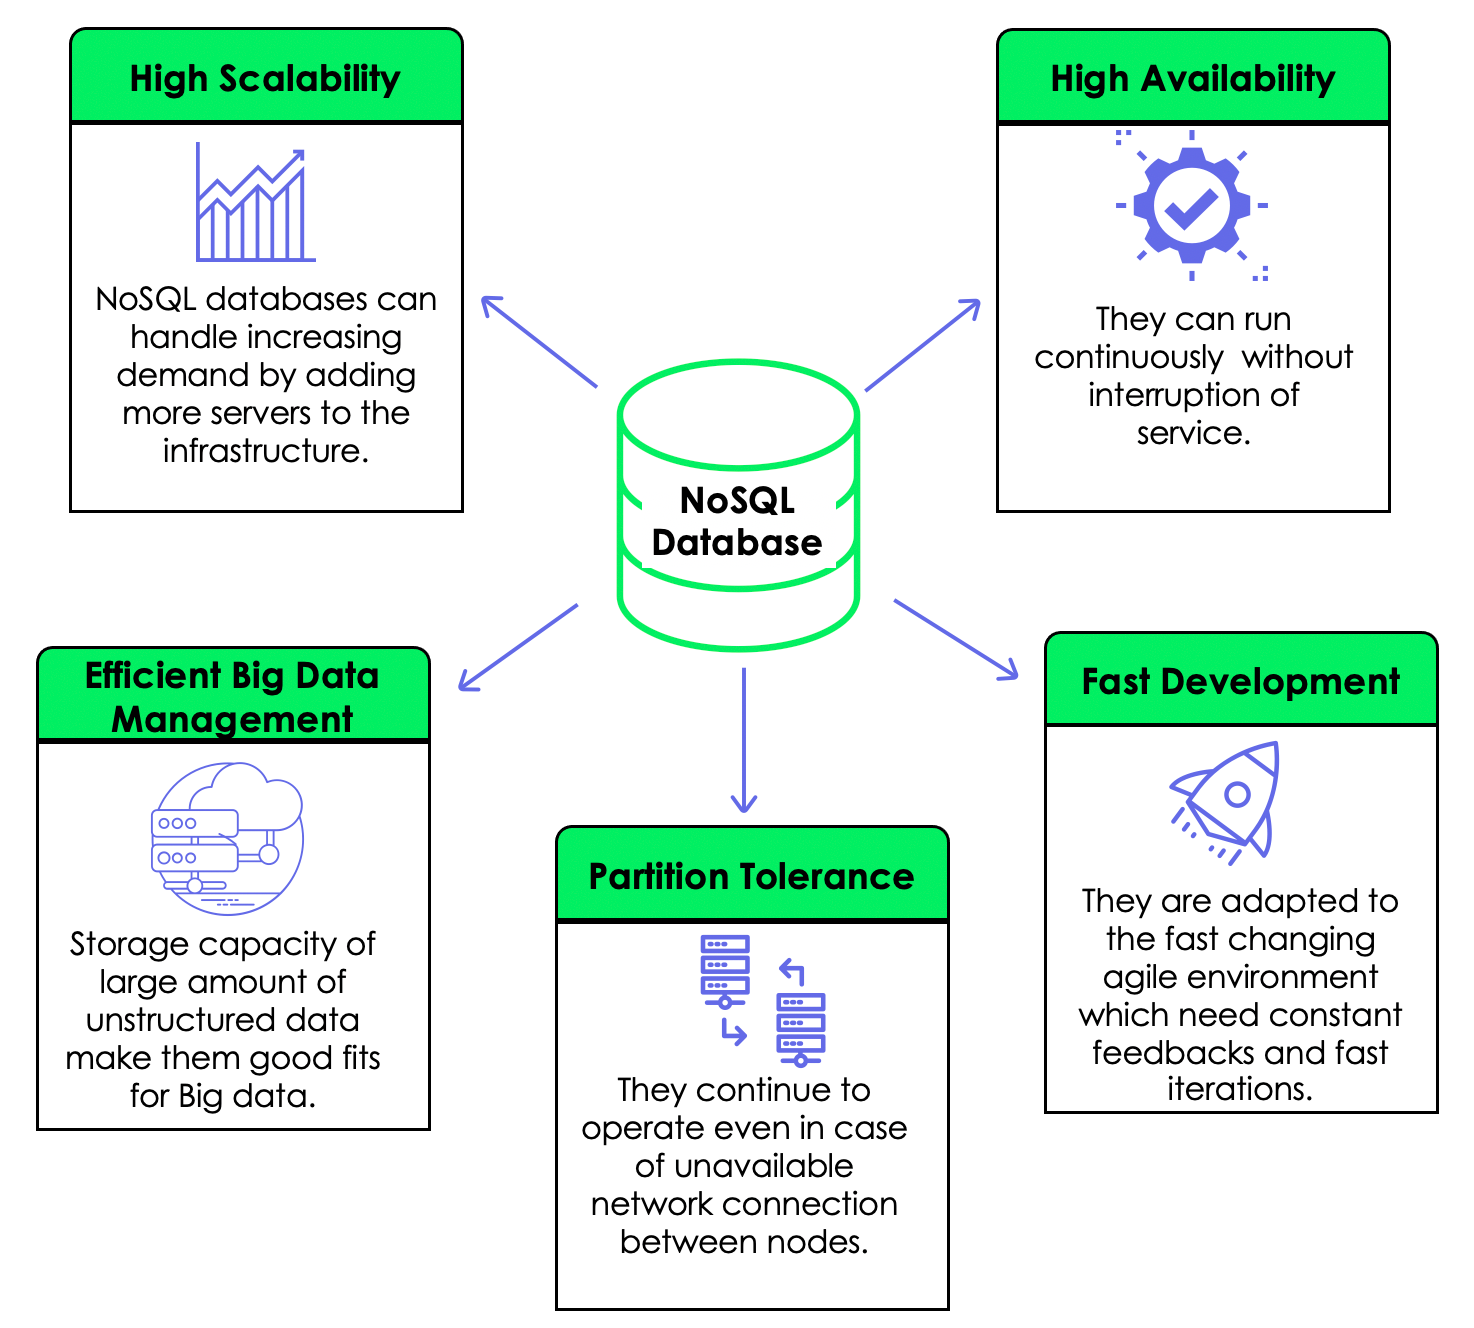
I vantaggi di NoSQL dal nostro articolo
Tra i sistemi di database NoSQL più utilizzati troviamo:
Confrontiamo SQL e NoSQL per capire meglio dove si sovrappongono e dove si differenziano:
I database SQL, caratterizzati da modelli di dati strutturati, impongono uno schema predefinito in cui i dati devono rientrare in tabelle con colonne e tipi di dato specifici. Questa struttura rigida garantisce coerenza e funziona bene per applicazioni con requisiti di dati stabili e prevedibili.
Al contrario, i database NoSQL adottano modelli di dati flessibili, consentendo un’archiviazione dinamica e senza schema. Questa flessibilità permette agli sviluppatori di inserire dati senza uno schema predefinito. I database NoSQL sono più utili quando le strutture dei dati possono essere indefinite o cambiare frequentemente.
I server SQL e NoSQL privilegiano punti di forza diversi nello scaling a causa dei rispettivi design. I sistemi SQL si affidano tipicamente alla scalabilità verticale, che implica il potenziamento e l’aggiunta di risorse allo stesso server per gestire carichi maggiori. La scalabilità orizzontale, tipica dei sistemi NoSQL, si ottiene aggiungendo più server o nodi a un sistema distribuito, aumentando così la capacità.
Nei sistemi NoSQL, i nodi comunicano tra loro e distribuiscono il carico, quindi aggiungere nodi aumenta la capacità complessiva del sistema. Questa è una soluzione più scalabile ed economicamente conveniente per gestire un database in crescita e un traffico maggiore.
I database SQL utilizzano schemi predefiniti, imponendo una struttura rigida per l’organizzazione dei dati e richiedendo che le tabelle rispettino una struttura predefinita di righe e colonne. Al contrario, i database NoSQL adottano schemi dinamici, offrendo flessibilità nella rappresentazione dei dati. Questi database consentono l’inserimento di dati senza una struttura predefinita, permettendo agli sviluppatori di adattare gli schemi al volo.
Questa flessibilità è particolarmente utile per gestire dati eterogenei, in evoluzione e imprevedibili. Di conseguenza, i database NoSQL funzionano bene quando le strutture dei dati potrebbero non essere note in anticipo o cambiare spesso, mentre i database SQL sono adatti quando i dati sono ben strutturati e prevedibili.
I sistemi di gestione di database SQL e NoSQL adottano approcci diversi per garantire l’affidabilità. SQL si basa sulle proprietà ACID (Atomicità, Coerenza, Isolamento, Durabilità) che, come detto sopra, assicurano coerenza immediata nel database. Le query SQL garantiscono che tutte o nessuna delle modifiche effettuate durante una transazione vengano confermate nel database, e stabiliscono regole su come gestire transazioni concorrenti ed eventi imprevisti.
I database NoSQL, invece, enfatizzando scalabilità e architetture distribuite, adottano il concetto di consistenza eventuale. La consistenza eventuale riconosce che, in un sistema distribuito, può essere necessario del tempo affinché tutti i nodi convergano verso uno stato coerente dopo un aggiornamento. Pur sacrificando la coerenza immediata a favore di scalabilità e tolleranza ai guasti, i database NoSQL garantiscono che, dato tempo sufficiente, tutte le repliche dei dati convergeranno allo stesso stato.
Questo compromesso consente ai sistemi NoSQL di gestire ambienti distribuiti su larga scala, in cui la coerenza in tempo reale potrebbe essere difficile da ottenere in modo efficiente.
Se non sei sicuro di quale database usare, ecco alcuni modi per scegliere tra NoSQL e SQL:
I database SQL funzionano al meglio quando i dati sono strutturati e prevedibili, le relazioni complesse devono essere rappresentate con precisione e l’integrità immediata dei dati è importante.
Le strutture rigide e le proprietà ACID di SQL lo rendono adatto a questo tipo di applicazioni.
Alcuni casi d’uso comuni in cui i database SQL funzionano bene sono:
I database NoSQL danno il meglio quando è utile avere strutture di dati flessibili che possano adattarsi dinamicamente a nuove informazioni e schemi, quando scalabilità e prestazioni sono importanti e per dati non strutturati. Gli schemi dinamici e lo scaling orizzontale di NoSQL lo rendono ideale per questi casi d’uso, presenti in scenari come:
Alcuni esempi di settori che si affidano ai database SQL sono:
Alcuni esempi di settori che si affidano ai database NoSQL sono:
La scelta tra database SQL e NoSQL svolge un ruolo fondamentale nell’efficacia e nel successo della data science e dello sviluppo di applicazioni. L’impatto su prestazioni, scalabilità e adattabilità ai tipi di dato influenza direttamente la reattività delle applicazioni data-driven.
SQL, con il suo modello strutturato e relazionale, eccelle negli scenari in cui i dati sono ben definiti e le relazioni sono cruciali, garantendo coerenza immediata grazie alle proprietà ACID.
I database NoSQL, invece, offrono flessibilità e scalabilità, rispondendo ai dati dinamici e non strutturati tipici delle applicazioni moderne.
Con l’evolversi dei settori, comprendere le sfumature tra queste tecnologie di database fondamentali diventa essenziale per architetti e sviluppatori che navigano nel variegato panorama della gestione dei dati.
Se vuoi saperne di più sul linguaggio di base per accedere ai dati nei database relazionali, dai un’occhiata al nostro corso di SQL intermedio.
Inizia oggi il tuo percorso SQL!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



