Cursus
Introductie tot SQL
2 uur
1.6M
Oefen en volg je voortgang.
Ga Verder Met GoogleDe keuze van een database is cruciaal in data science en applicatieontwikkeling, omdat deze rechtstreeks van invloed is op prestaties, schaalbaarheid en het vermogen om de gegevens te verwerken die binnen de applicatie worden gebruikt. De keuze tussen NoSQL- en SQL-databases beïnvloedt de efficiëntie van gegevensopvraging, opslag en verwerking, wat essentieel is voor het succes en de responsiviteit van datagedreven applicaties bij het voldoen aan specifieke behoeften.
SQL en NoSQL zijn twee verschillende databasetechnologieën: SQL-databases leggen de nadruk op gestructureerde, relationele modellen, terwijl NoSQL-databases een flexibele, schemaloze aanpak hanteren om diverse en dynamische gegevens te verwerken, met meer nadruk op schaalbaarheid en snelheid.
In dit artikel bespreken we de verschillen tussen beide databasesystemen. We behandelen echter niet de basisprincipes van elk. Bekijk daarvoor ons SQL Fundamentals-leerpad om te leren hoe je gegevens uit SQL-databases ophaalt.
In 1970 beschreef dr. Edgar Codd in zijn baanbrekende paper "A Relational Model of Data for Large Shared Data Banks" het relationele databasemodel: een model om gegevens effectief in tabellen met kolom- en rijstructuur te organiseren en op te slaan. In 1974 ontwikkelde IBM System R, het eerste project dat het relationele model implementeerde voor gegevensopslag, en ontwikkelde het SQL als de taal om met deze relationele databases te communiceren.
In de loop der jaren zijn er nieuwe SQL-standaarden ontwikkeld, en Oracle, IBM en Microsoft hebben elk relationele databasebeheersystemen (RDBMS) ontwikkeld om SQL efficiënt, veilig en gebruiksvriendelijk te gebruiken voor interactie met SQL-databases.
Vervolgens maakten open-sourcetalige systemen zoals MySQL SQL en relationele databases toegankelijker voor het grote publiek. SQL is nu breed beschikbaar, zowel op fysieke systemen als in de cloud, zoals AWS, Azure en Google Cloud.
In SQL-databases vormt het relationele model de conceptuele basis, waarbij gegevens in gestructureerde en onderling verbonden tabellen worden georganiseerd. SQL-databases bestaan uit schema's en tabellen:
Het relationele model waarborgt consistentie via twee soorten sleutels: (1) primaire sleutels die elk record uniek identificeren en (2) vreemde sleutels die relaties tussen tabellen vastleggen. Je kunt meer leren over relationele databases in onze cursus Introduction to SQL.
SQL, ofwel Structured Query Language, fungeert als de interface voor het beheren van deze databases en maakt het mogelijk om gegevens te creëren, op te halen, bij te werken en te verwijderen met gestandaardiseerde commando's. Een overzicht van deze commando's en de mogelijkheden van SQL vind je in onze SQL Basics Cheat Sheet. Dit model en zijn componenten bieden een krachtig en flexibel raamwerk voor het organiseren en bevragen van gegevens op een manier die de integriteit en samenhang in de hele database waarborgt.
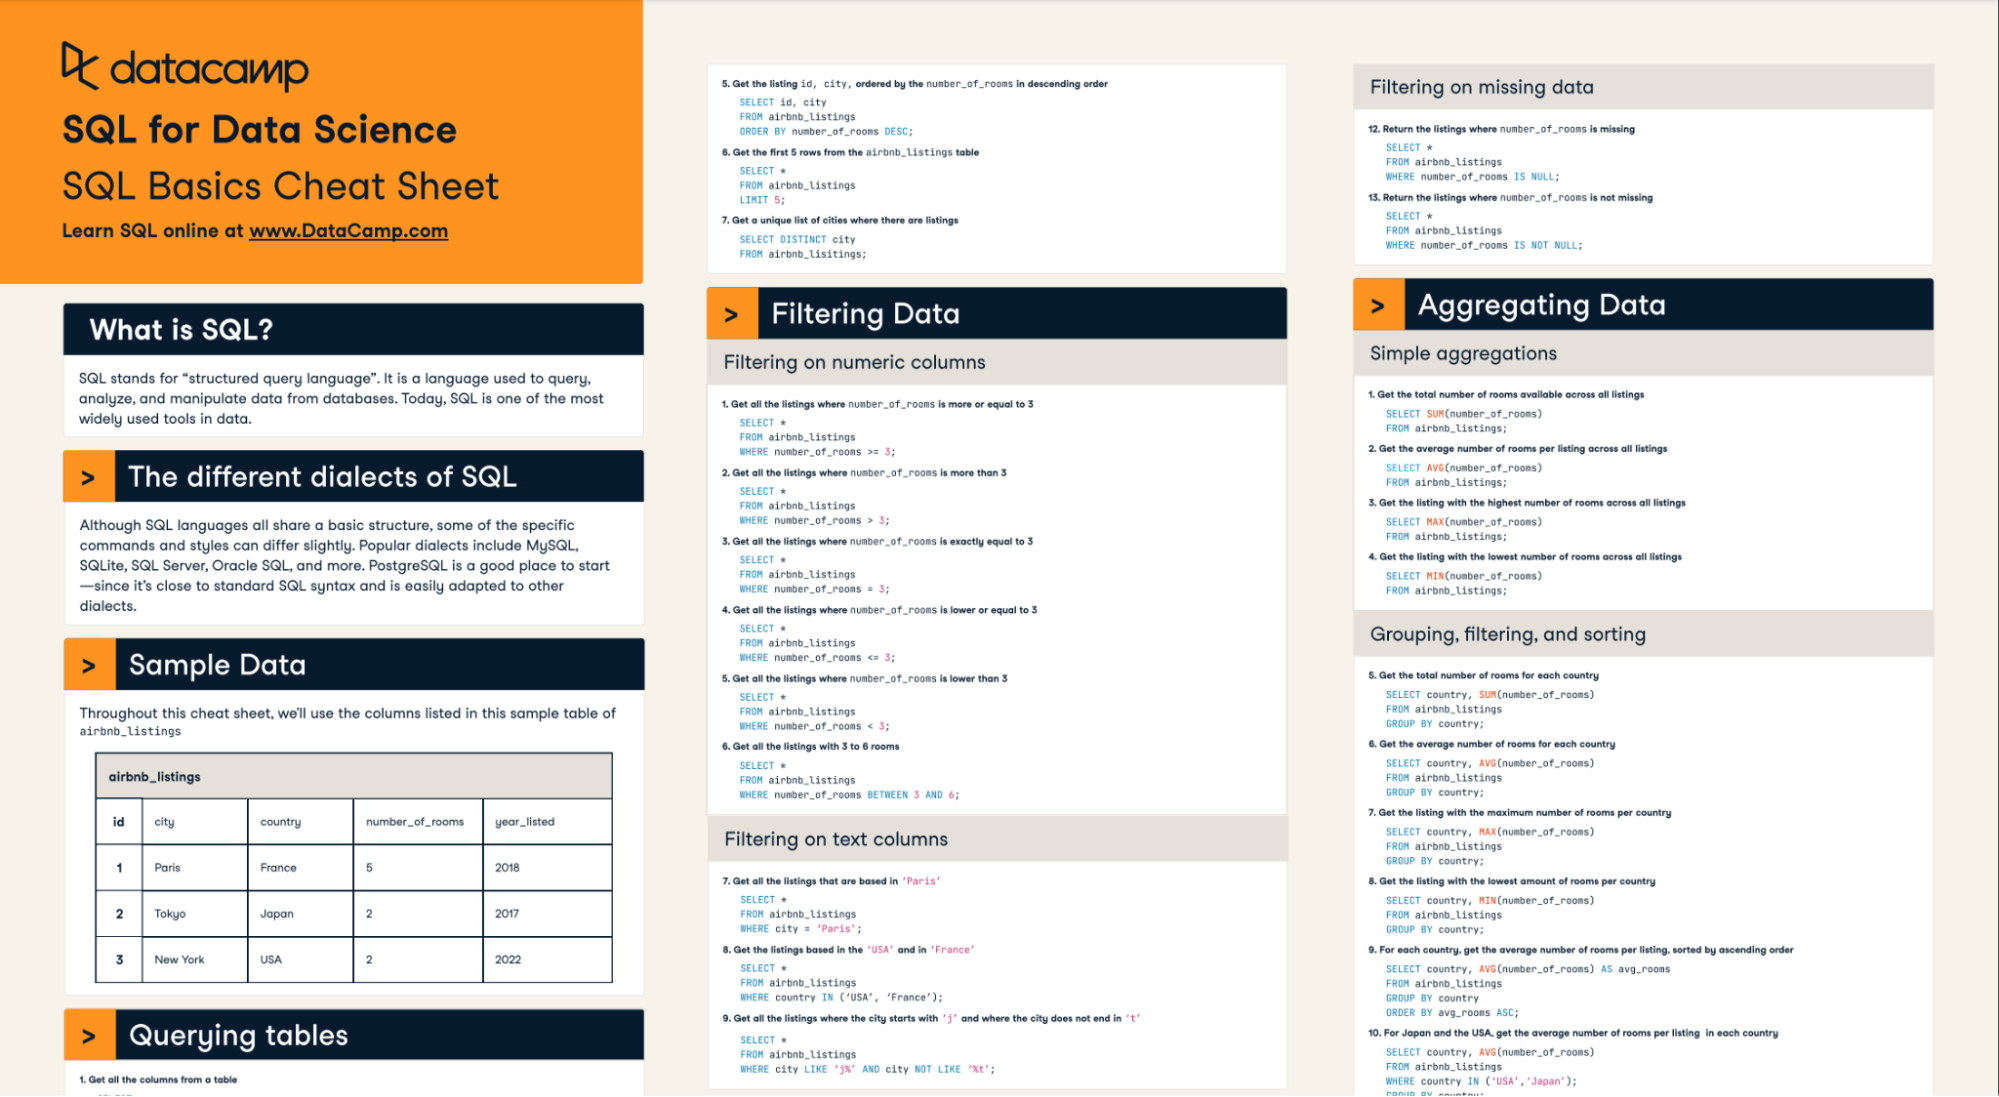
Een kijkje in onze SQL Basics Cheat Sheet
SQL biedt een standaardset commando's voor het definiëren, bevragen, bijwerken en beheren van gegevens in een relationeel databasebeheersysteem (RDBMS). Belangrijke SQL-operaties zijn SELECT (gegevens opvragen), INSERT (nieuwe records toevoegen), UPDATE (bestaande records wijzigen) en DELETE (records verwijderen).
Bij het gebruik van deze commando's zorgt SQL ervoor dat de ACID-eigenschappen (Atomicity, Consistency, Isolation en Durability) worden gehandhaafd. Dit garandeert de betrouwbaarheid en consistentie van databasewijzigingen.
Deze fundamentele eigenschappen van SQL-databases zorgen ervoor dat systemen betrouwbaar en consistent blijven, zelfs bij onverwachte gebeurtenissen of systeemstoringen.
Er zijn drie veelgebruikte RDBMS'en:
Bekijk onze MySQL in Python-tutorial om meer te leren over het starten met dit RDBMS, en onze Beginnersgids voor PostgreSQL.
Je kunt onze volledige gids Wat is NoSQL lezen voor een diepgaand begrip van Not Only SQL-databases. Hieronder hebben we onze bevindingen samengevat.
NoSQL-databases (Not Only SQL) zijn ontstaan als reactie op de uitdagingen door de groei van big data en de toenemende behoefte aan schaalbaarheid in databasesystemen. Traditionele relationele databases hebben moeite om grote hoeveelheden ongestructureerde en semi-gestructureerde data, die in moderne bigdata-omgevingen gebruikelijk zijn, efficiënt te beheren. NoSQL-databases vormen een flexibeler en beter schaalbaar alternatief voor relationele databases.
Ze verwerken uiteenlopende gegevenstypen effectief, kunnen snelle datagroei aan en verdelen gegevens efficiënt over meerdere servers.
NoSQL-oplossingen zoals MongoDB, Cassandra en Couchbase gebruiken niet dezelfde starre structuren die het relationele model vereist. Deze systemen geven de voorkeur aan schemaflexibiliteit en horizontale schaalvergroting, waardoor organisaties zich kunnen aanpassen aan de dynamiek van big data, terwijl prestaties en betrouwbaarheid behouden blijven. Het verband tussen NoSQL, big data en schaalbaarheid onderstreept een cruciale evolutie in databasemanagement, waarmee bedrijven de uitdagingen van de recente exponentiële datagroei aankunnen.
In tegenstelling tot SQL-databases gebruiken NoSQL-databases dynamische schema's en ondersteunen ze verschillende datamodellen om uiteenlopende toepassingsbehoeften te adresseren.
Een bepalend kenmerk van niet-relationele databases is het gebruik van dynamische schema's. Anders dan de vooraf gedefinieerde, vaste schema's van relationele databases, bieden niet-relationele databases flexibiliteit. Verschillende records in dezelfde database kunnen verschillende velden hebben. In een klantendatabase kan bijvoorbeeld de ene klant velden voor naam en leeftijd hebben, terwijl een andere klant velden voor naam en e-mail heeft.
Er zijn verschillende typen NoSQL-databases:
Je kunt meer leren over MongoDB in onze cursus Introduction to MongoDB in Python.
Welke je kiest, hangt af van de toepassing waarvoor je een NoSQL-database gebruikt.
NoSQL-databases bieden verschillende voordelen, met opvallende sterke punten op het gebied van schaalbaarheid, flexibiliteit en prestaties bij ongestructureerde gegevens.
NoSQL-databases bieden schaalbaarheid in de vorm van horizontale schaalbaarheid en elasticiteit. Ze zijn ontworpen om horizontaal te schalen, zodat organisaties toenemende hoeveelheden data kunnen verwerken door meer servers toe te voegen aan een gedistribueerd systeem. Dit maakt ze geschikt voor applicaties met groeiende of onvoorspelbare workloads.
Veel NoSQL-databases bieden ook automatische sharding en load balancing, waarbij gegevens over meerdere nodes worden verdeeld om resources efficiënt te benutten en de prestaties te verbeteren. Deze mogelijkheid maakt het mogelijk om systemen dynamisch op of af te schalen op basis van de vraag en staat bekend als elasticiteit.
Ze bieden ook schemaflexibiliteit. NoSQL-databases gebruiken dynamische schema's, waardoor er flexibiliteit is in gegevensrepresentatie. Dit betekent dat velden in een record kunnen variëren tussen verschillende documenten, wat aansluit bij de diverse en evoluerende datastructuren die in moderne applicaties veel voorkomen.
Daarnaast presteren ze goed bij ongestructureerde en semi-gestructureerde datatypen zoals JSON en XML. Data is tegenwoordig vaak onvoorspelbaar, zeker wanneer deze door gebruikers wordt gegenereerd, en NoSQL kan deze data goed opslaan.
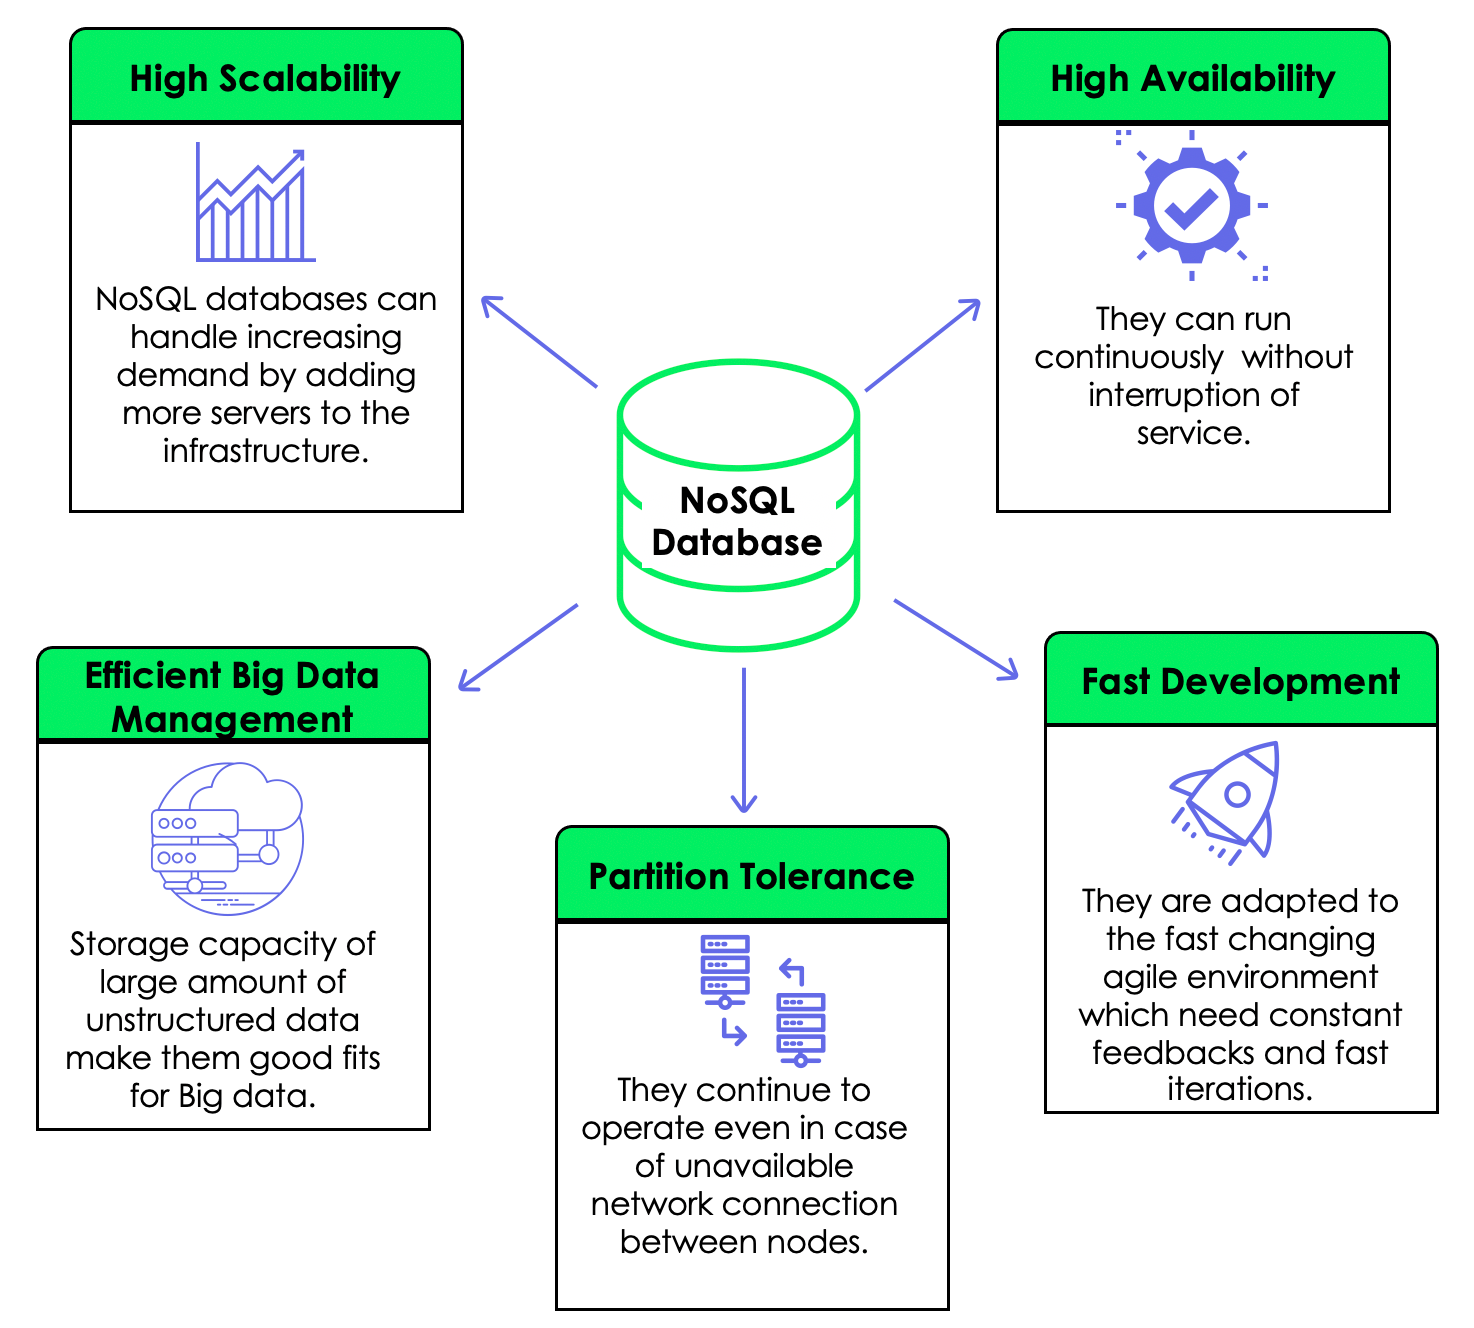
De voordelen van NoSQL uit ons artikel
Een paar van de meest gebruikte NoSQL-databasesystemen zijn:
Laten we SQL en NoSQL vergelijken om beter te begrijpen waar ze overlappen en waar ze verschillen:
SQL-databases, gekenmerkt door gestructureerde datamodellen, hanteren een vooraf gedefinieerd schema waarbij gegevens moeten passen in tabellen met specifieke kolommen en datatypen. Deze starre structuur waarborgt consistentie en werkt goed voor applicaties met stabiele en voorspelbare gegevensvereisten.
Daarentegen hanteren NoSQL-databases flexibele datamodellen, waardoor dynamische en schemaloze gegevensopslag mogelijk is. Deze flexibiliteit stelt ontwikkelaars in staat om gegevens in te voegen zonder vooraf gedefinieerd schema. NoSQL-databases zijn vooral nuttig in situaties waarin datastructuren ongedefinieerd zijn of vaak veranderen.
SQL- en NoSQL-servers leggen door hun ontwerp de nadruk op verschillende vormen van schalen. SQL-systemen vertrouwen doorgaans op verticale schaalvergroting, wat inhoudt dat je dezelfde server verbetert en meer resources toevoegt om hogere belasting aan te kunnen. Horizontale schaalvergroting, typisch voor NoSQL-systemen, wordt bereikt door meer servers of nodes toe te voegen aan een gedistribueerd systeem, wat de capaciteit vergroot.
In NoSQL-systemen communiceren de nodes met elkaar en verdelen ze de belasting, dus het toevoegen van meer nodes vergroot de totale capaciteit van het systeem. Dit is een beter schaalbare en kosteneffectieve oplossing voor het beheren van een groeiende database en toenemend dataverkeer.
SQL-databases gebruiken vooraf gedefinieerde schema's, die een rigide structuur voor gegevensorganisatie afdwingen en vereisen dat tabellen een vooraf gedefinieerde structuur van rijen en kolommen volgen. Daarentegen omarmen NoSQL-databases dynamische schema's en bieden ze flexibiliteit in gegevensrepresentatie. Deze databases maken het mogelijk gegevens in te voegen zonder vooraf gedefinieerde structuur, zodat ontwikkelaars schema's ter plekke kunnen aanpassen.
Deze flexibiliteit is vooral voordelig voor het verwerken van diverse, evoluerende en onvoorspelbare datatypen. NoSQL-databases werken dus goed in scenario's waarin datastructuren niet volledig vooraf bekend zijn of vaak veranderen, terwijl SQL-databases goed werken wanneer de gegevens goed gestructureerd en voorspelbaar zijn.
SQL- en NoSQL-databasebeheersystemen hanteren verschillende benaderingen om betrouwbaarheid te waarborgen. SQL vertrouwt op de ACID-eigenschappen (Atomicity, Consistency, Isolation, Durability), die, zoals hierboven besproken, onmiddellijke en strikte consistentie in de database garanderen. SQL-queries waarborgen dat alle of geen van de wijzigingen tijdens een transactie worden doorgevoerd in de database en hebben regels voor het omgaan met gelijktijdige transacties en onverwachte gebeurtenissen.
NoSQL-databases daarentegen, met de nadruk op schaalbaarheid en gedistribueerde architecturen, hanteren het concept van eventual consistency. Eventual consistency erkent dat het in een gedistribueerd systeem enige tijd kan duren voordat alle nodes naar een consistente toestand convergeren na een update. Hoewel NoSQL-databases onmiddellijke consistentie inruilen voor schaalbaarheid en fouttolerantie, zorgen ze ervoor dat, mits voldoende tijd, alle replica's van de gegevens uiteindelijk naar dezelfde toestand convergeren.
Deze afweging stelt NoSQL-systemen in staat om grootschalige, gedistribueerde omgevingen te verwerken, waar realtime consistentie mogelijk lastig efficiënt te bereiken is.
Als je niet zeker weet welke database je moet gebruiken, hebben we hieronder manieren uiteengezet om tussen NoSQL en SQL te kiezen:
SQL-databases werken het best wanneer gegevens gestructureerd en voorspelbaar zijn, complexe relaties nauwkeurig moeten worden vastgelegd en directe gegevensintegriteit belangrijk is.
De rigide structuren en ACID-eigenschappen van SQL maken het goed geschikt voor dit soort toepassingen.
Veelvoorkomende use-cases waar SQL-databases goed werken, zijn:
NoSQL-databases werken het best wanneer flexibele datastructuren nuttig zijn die zich dynamisch kunnen aanpassen aan nieuwe informatie en schema's, wanneer schaalbaarheid en prestaties belangrijk zijn, en voor ongestructureerde data. De dynamische schema's en horizontale schaalbaarheid van NoSQL maken het geschikt voor dit soort use-cases, die zich voordoen in scenario's zoals:
Enkele voorbeelden van sectoren die afhankelijk zijn van SQL-databases zijn:
Enkele voorbeelden van sectoren die afhankelijk zijn van NoSQL-databases zijn:
De keuze tussen SQL- en NoSQL-databases speelt een cruciale rol in de effectiviteit en het succes van data science en applicatieontwikkeling. De impact op prestaties, schaalbaarheid en aanpasbaarheid aan gegevenstypen beïnvloedt rechtstreeks de responsiviteit van datagedreven applicaties.
SQL blinkt, met zijn gestructureerde, relationele model, uit in scenario's waarin gegevens goed gedefinieerd zijn en relaties cruciaal, en het waarborgt onmiddellijke consistentie via de ACID-eigenschappen.
Daarentegen bieden NoSQL-databases flexibiliteit en schaalbaarheid, gericht op dynamische, ongestructureerde gegevenstypen die in moderne applicaties veel voorkomen.
Naarmate sectoren evolueren, wordt het begrijpen van de nuances tussen deze fundamentele databasetechnologieën essentieel voor architecten en ontwikkelaars die navigeren in het diverse landschap van databeheer.
Wil je meer leren over de onderliggende taal voor het benaderen van data in relationele databases, bekijk dan onze intermediate SQL-cursus.
Begin vandaag nog met je SQL-reis!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

