Programma
Un paio d’anni fa, durante la mia prima settimana in un nuovo ruolo da software engineer, mi è stato chiesto di esplorare i time series databases (TSDB) per sostituire la nostra soluzione Postgres.
Non sapevo assolutamente nulla dell’argomento e avevo un sacco di domande. Cos’è esattamente un database di serie temporali? Come funziona? In cosa è diverso da un database tradizionale? Perché dovremmo usarne uno? Servono competenze specifiche?
Da allora ho imparato molto sui TSDB e ho applicato queste conoscenze in varie aziende per risolvere un’ampia gamma di problemi.
In questo articolo riassumo ciò che ho imparato negli ultimi anni per darti una buona idea di cosa sono i TSDB, come funzionano e per quali casi d’uso rendono al meglio. Ti guiderò anche tra alcuni dei TSDB attualmente sul mercato e ti darò consigli per scegliere quello più adatto alle tue esigenze.
Cosa sono i time series databases?
Immagina un termostato smart venduto dall’azienda X che registra le letture della temperatura ogni 30 secondi. In un solo giorno, questo dispositivo genera migliaia di punti dati. Ora moltiplica per centinaia o migliaia di dispositivi in una città, e il volume di dati con timestamp raccolti dall’azienda X diventa enorme.
Per archiviare questi dati in modo efficiente e analizzare le tendenze (come i cambiamenti di temperatura nel tempo o i picchi improvvisi), l’azienda X ha bisogno di un database in grado di gestire velocità di scrittura elevate e di effettuare query basate sul tempo in modo efficiente.
I database tradizionali tendono a faticare con questo tipo di carico perché non sono progettati per gestire scritture di dati ad alta frequenza o interrogare i dati in modo efficiente su intervalli temporali specifici. È qui che entrano in gioco i database di serie temporali.
I time series databases sono database specializzati progettati per gestire dati organizzati e indicizzati in base al tempo. A differenza dei database tradizionali, ottimizzati per l’archiviazione generica, i TSDB si concentrano sul memorizzare, interrogare e analizzare in modo efficiente sequenze di punti dati con timestamp.
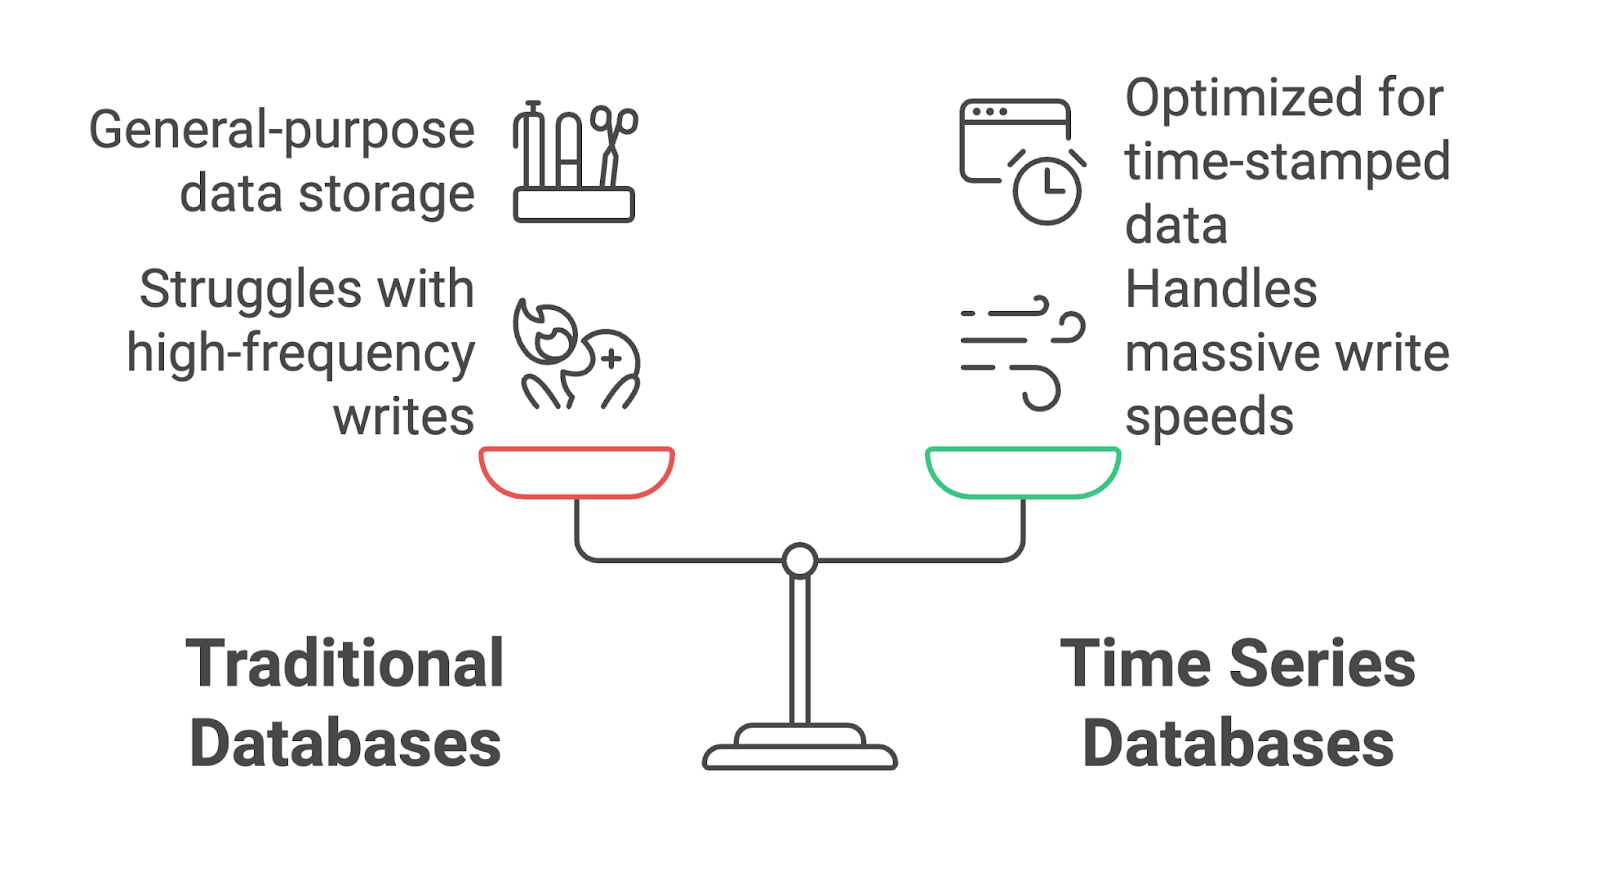
I TSDB sono particolarmente adatti ad applicazioni che trattano flussi di dati continui, come IoT, monitoraggio DevOps e analisi finanziaria.
Caratteristiche dei time series databases
Ci sono alcune cose che i TSDB fanno in modo diverso rispetto ai database tradizionali.
Ottimizzati per dati con timestamp
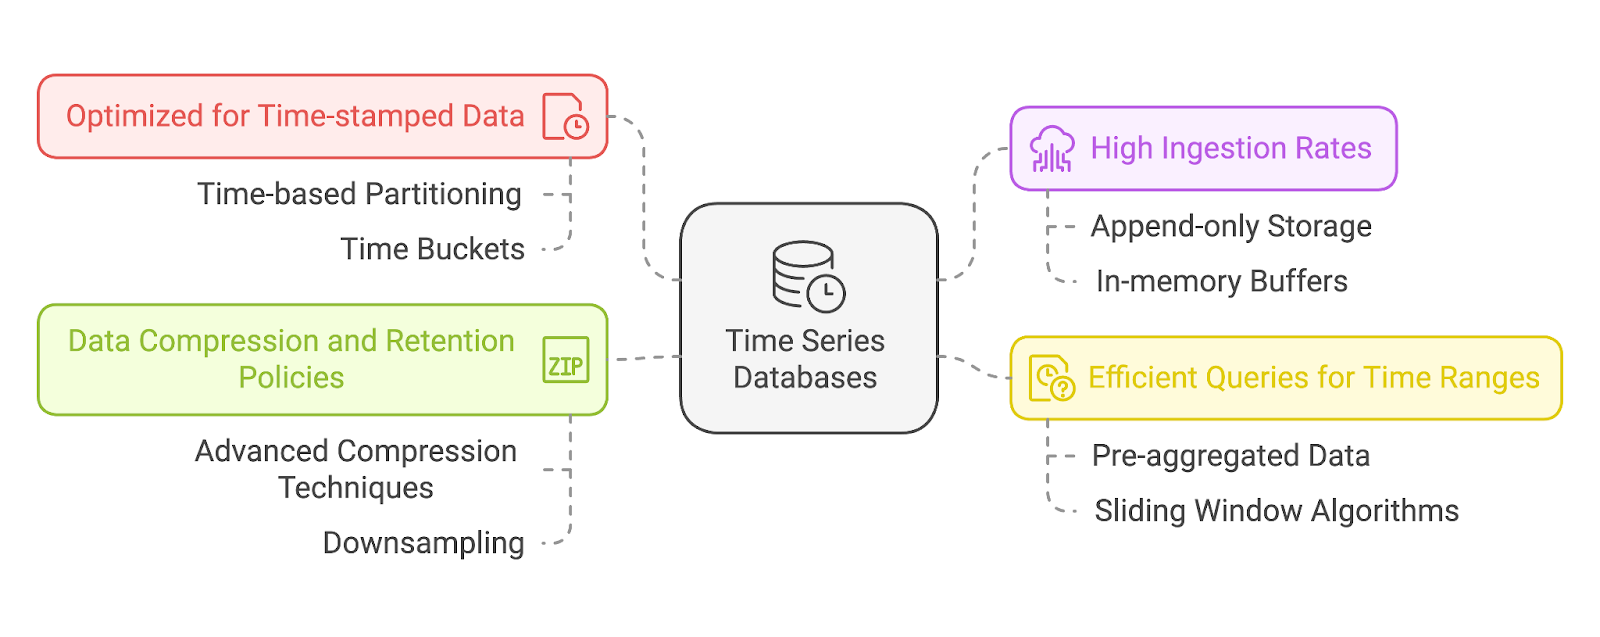
Alla base, i TSDB sono costruiti per gestire dati con il timestamp come attributo fondamentale. Ogni punto dati in un TSDB include un timestamp, che funge da indice principale. Ciò consente a questi database di archiviare e recuperare in modo efficiente sequenze ordinate nel tempo e di fornire accesso rapido a tendenze storiche o eventi recenti.
La maggior parte dei TSDB usa la partizionamento basato sul tempo, ossia i dati vengono archiviati in partizioni basate su intervalli temporali (ad esempio, orari, giornalieri). Questo abilita il pruning efficiente, in cui le query ignorano del tutto le partizioni irrilevanti.
Possono anche implementare i bucket temporali, raggruppando i dati in finestre temporali predefinite (ad esempio, 1 minuto, 1 ora) per aggregazioni più rapide.
Alti tassi di ingestione
I dati di serie temporali sono spesso generati a ritmo sostenuto: pensa a dispositivi IoT che inviano migliaia di punti dati al secondo o a uno strumento di monitoraggio che cattura metriche di sistema in tempo reale. I TSDB sono ottimizzati per questi alti tassi di scrittura e possono ingerire enormi quantità di dati senza rallentare o perdere informazioni.
Questo di solito si ottiene usando modelli di storage append-only e buffer in memoria per evitare lock o colli di bottiglia transazionali.
Query efficienti per intervalli temporali
Analizzare dati di serie temporali comporta spesso l’interrogazione di intervalli o finestre temporali specifiche, come “ultime 24 ore” o “quest’anno rispetto all’anno scorso”. I TSDB sono costruiti tenendo conto di ciò, offrendo funzionalità di query specializzate che consentono di recuperare rapidamente i dati su intervalli di tempo definiti. Supportano anche aggregazioni come medie, somme o trend per offrire analisi utili senza logiche di query complesse.
Le tecniche di ottimizzazione delle query includono:
- Dati pre-aggregati: i TSDB spesso pre-calcolano riepiloghi per intervalli comuni (ad esempio, medie orarie o giornaliere).
- Algoritmi a finestra mobile: aiutano a calcolare in modo efficiente metriche su finestre temporali mobili, come le medie mobili.
Compressione dei dati e policy di retention
Per gestire l’enorme quantità di dati di serie temporali generati nel tempo, i TSDB ricorrono a tecniche avanzate di compressione. Questi metodi riducono i requisiti di storage preservando al contempo le prestazioni delle query.
I TSDB includono di solito policy di retention per permettere agli utenti di definire per quanto tempo mantenere i dati. Per esempio, un sistema potrebbe conservare dati dettagliati per l’ultimo mese effettuando downsampling per i dati più vecchi. Il downsampling è il processo di riduzione della granularità dei dati nel tempo. Per esempio:
- Le letture grezze della temperatura potrebbero essere registrate ogni 10 secondi per gli ultimi 7 giorni.
- Per i dati più vecchi, il sistema potrebbe eseguire il downsampling a medie orarie per risparmiare spazio mantenendo comunque le tendenze storiche.
Esempi di tecniche avanzate di compressione includono:
- Codifica delta: memorizzare la differenza tra valori consecutivi invece del valore completo.
- Compressione Gorilla: un metodo usato per comprimere in modo efficiente dati di serie temporali in virgola mobile memorizzando le variazioni in formato binario.

Casi d’uso dei time series databases
I time series databases sono usati in molte applicazioni moderne data-driven e in settori diversi. Vediamo i principali casi d’uso.
1. Internet of Things (IoT)
Dispositivi IoT come termostati smart, sensori industriali e monitor ambientali generano flussi continui di dati con timestamp. I TSDB vengono usati per archiviare e analizzare questi dati e alimentare applicazioni come:
- Smart home: monitoraggio e controllo degli elettrodomestici in base a dati sensibili al tempo.
- Automazione industriale: tracciamento delle prestazioni delle macchine e rilevamento di anomalie in tempo reale per minimizzare i downtime.
- Monitoraggio ambientale: raccolta di dati dai sensori per monitorare qualità dell’aria, condizioni meteo o livelli dell’acqua nel tempo.
2. DevOps e monitoraggio dei sistemi
Nel mondo DevOps, i TSDB sono ampiamente usati per monitorare infrastrutture IT e applicazioni raccogliendo metriche come uso della CPU, consumo di memoria e throughput di rete. Consentono di:
- Monitorare le prestazioni: visualizzare in tempo reale lo stato del sistema e le metriche di performance.
- Rilevare anomalie: identificare pattern insoliti, come picchi di carico del server o latenze di rete.
- Capacity planning: usare le tendenze storiche per prevedere e allocare i bisogni di risorse future.
Strumenti come Prometheus e Grafana si integrano spesso con i TSDB per fornire funzionalità di visualizzazione e alerting ai team DevOps.
3. Mercati finanziari
I TSDB sono fondamentali per elaborare e analizzare le enormi quantità di dati ad alta frequenza generate dai mercati finanziari. Sono usati per:
- Trading algoritmico: memorizzare e analizzare i dati di mercato in millisecondi per eseguire operazioni basate su trend in tempo reale.
- Gestione del rischio: monitorare metriche finanziarie nel tempo per valutare e mitigare i rischi.
- Analisi di mercato: analizzare dati storici per individuare pattern, trend e anomalie nel comportamento del mercato.
4. Altre applicazioni
Sebbene i tre casi d’uso sopra siano molto comuni, i time series databases trovano applicazione anche in molti altri ambiti:
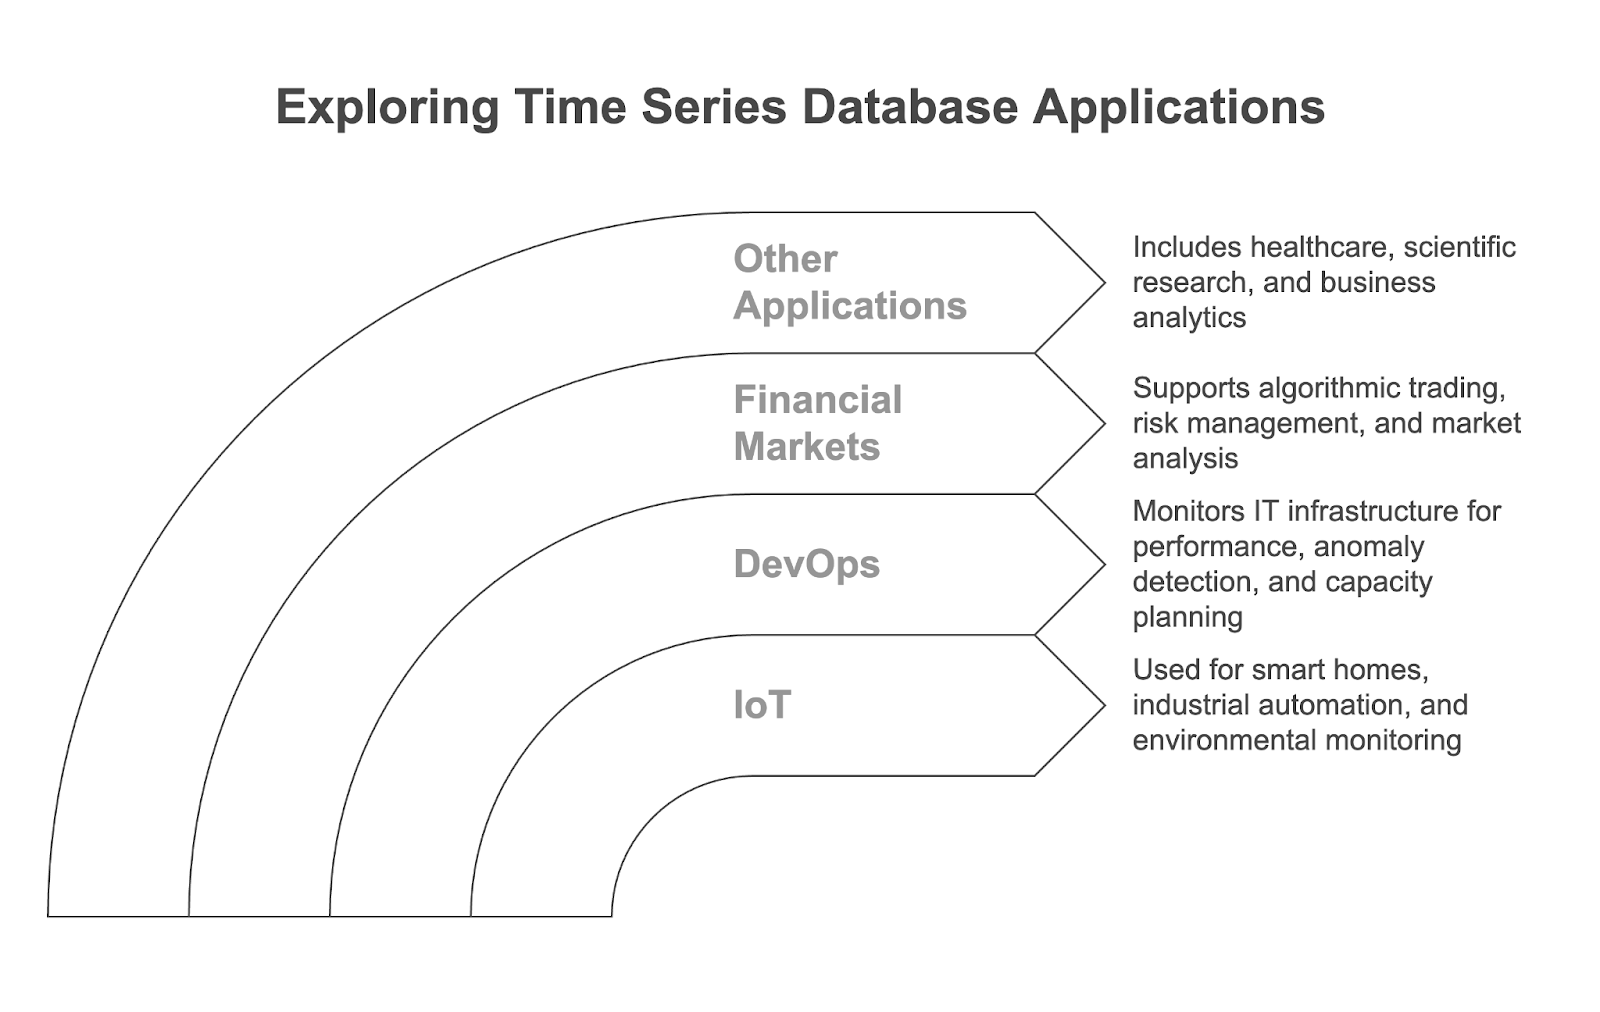
- Sanità: monitoraggio in tempo reale dei parametri vitali dei pazienti e analisi dei dati dei dispositivi medici.
- Ricerca scientifica: raccolta e analisi di dati per la modellazione climatica, osservazioni astronomiche e altri fenomeni dipendenti dal tempo.
- Business analytics: tracciamento del comportamento dei clienti, analisi delle tendenze di vendita e monitoraggio delle KPI nel tempo.

I migliori time series databases: panoramica comparativa
I time series databases esistono in varie forme, ciascuna pensata per casi d’uso specifici.
InfluxDB
InfluxDB è un popolare database di serie temporali open source sviluppato da InfluxData. È stato progettato specificamente per alti tassi di ingestione e query efficienti su dati con timestamp, rendendolo una soluzione comune per monitoraggio IoT, metriche DevOps e analytics in tempo reale.
|
Pro |
Contro |
|
Alti tassi di ingestione per volumi massivi di dati. |
Richiede la gestione manuale delle policy di retention per uno storage ottimale. |
|
InfluxQL, simile a SQL, semplifica le query per gli analyst abituati ai database relazionali. |
Sfide di scalabilità per dataset molto grandi senza funzionalità enterprise. |
|
Si integra facilmente con strumenti come Grafana per la visualizzazione. |
Capacità di query avanzate limitate rispetto ai database basati su SQL. |
TimescaleDB
TimescaleDB è un’estensione open source per PostgreSQL, progettata per combinare la potenza dei database relazionali con la funzionalità delle serie temporali. Ti permette di sfruttare SQL gestendo al contempo in modo efficiente i dati con timestamp. È particolarmente adatto a casi d’uso che richiedono l’integrazione di dati di serie temporali con dati relazionali, come business analytics o telemetria IoT.
|
Pro |
Contro |
|
Pieno supporto SQL per un’integrazione facile con strumenti e workflow PostgreSQL esistenti. |
Richiede conoscenze di PostgreSQL per setup e manutenzione. |
|
Hypertable: partiziona automaticamente i dati di serie temporali per storage e query efficienti. |
Potrebbe non raggiungere la velocità di ingestione dei TSDB dedicati come InfluxDB. |
|
Combina dati relazionali e di serie temporali in un unico database. |
Prometheus
Prometheus è un sistema di monitoraggio e alerting con un TSDB integrato, ampiamente adottato in DevOps per metriche di sistema in tempo reale, tracciamento delle prestazioni e gestione degli alert.
|
Pro |
Contro |
|
Leggero e facile da distribuire, soprattutto con Kubernetes. |
Storage a lungo termine limitato senza soluzioni esterne. |
|
Lo scraping pull-based delle metriche garantisce la raccolta dei soli dati rilevanti. |
La scalabilità si affida a strumenti aggiuntivi come Thanos o Cortex. |
|
PromQL offre potenti capacità di query. |
Si concentra sulle metriche e potrebbe non adattarsi a tutte le esigenze TSDB generiche. |
Clickhouse
ClickHouse è un database colonnare open source progettato per query analitiche ad alte prestazioni. Pur non essendo un TSDB tradizionale, la sua architettura lo rende eccezionalmente adatto ai dati di serie temporali, soprattutto quando le prestazioni delle query devono essere elevate.
|
Pro |
Contro |
|
Prestazioni elevate per workload analitici. |
Complesso da configurare e mantenere per i principianti. |
|
Lo storage colonnare riduce la latenza delle query. |
Non progettato specificamente come TSDB (potrebbero servire workaround). |
Apache Cassandra
Apache Cassandra è un database NoSQL distribuito costruito per la scalabilità orizzontale e l’alta disponibilità. Pur non essendo esclusivamente un TSDB, può essere usato in modo efficace per workload di serie temporali, in particolare quando sono fondamentali durabilità e tolleranza ai guasti.
|
Pro |
Contro |
|
Eccellente scalabilità orizzontale. |
L’esecuzione di query su serie temporali può essere macchinosa senza ottimizzazioni aggiuntive, poiché il database non dispone di funzioni native per query e aggregazioni time series. |
|
Fault-tolerant e altamente disponibile. |
Amazon Timestream
Amazon Timestream è un servizio di database di serie temporali completamente gestito offerto da AWS. Costruito per scalabilità e semplicità, è ideale per le organizzazioni che già sfruttano l’infrastruttura AWS per IoT e monitoraggio applicativo.
|
Pro |
Contro |
|
Architettura serverless che semplifica la gestione. |
Funzionalità limitate al di fuori dell’ecosistema AWS. |
|
Scala automaticamente per gestire grandi volumi di dati. |
I costi possono crescere con tassi di ingestione elevati. |
Facciamo un rapido riepilogo con questa tabella:
|
Database |
Casi d’uso principali |
Modello di storage |
Compatibilità con l’ecosistema |
|
InfluxDB |
Monitoraggio IoT, metriche DevOps, analytics in tempo reale |
Ottimizzato per time series, basato su disco |
Si integra con Grafana, Telegraf e Kapacitor |
|
TimescaleDB |
Business analytics, telemetria IoT, applicazioni basate su SQL |
Relazionale (estensione PostgreSQL) |
Funziona con strumenti PostgreSQL come pgAdmin, Grafana |
|
Prometheus |
Monitoraggio DevOps, tracciamento delle prestazioni, alerting |
Storage di serie temporali integrato |
Progettato per Kubernetes, si integra con Thanos, Grafana |
|
ClickHouse |
Workload analitici ad alte prestazioni, analytics su serie temporali |
Storage colonnare |
Supporta analytics basati su SQL, si integra con strumenti BI |
|
Apache Cassandra |
Storage distribuito di serie temporali, logging su larga scala |
NoSQL a colonne larghe |
Compatibile con Spark, Kafka e sistemi distribuiti scalabili |
|
Amazon Timestream |
Monitoraggio IoT su AWS, telemetria applicativa |
Serverless, TSDB gestito |
Fortemente integrato con i servizi AWS (Lambda, IoT Core, QuickSight) |
Scegliere il time series database giusto: fattori chiave
I time series databases offrono funzionalità diverse per esigenze diverse. Quindi, come scegliere quello che risolverà al meglio il tuo problema?
Valuta volume dei dati e tasso di ingestione
I workload di serie temporali possono variare significativamente per volume di dati (quanti dati vengono generati) e tasso di ingestione (quanto velocemente i dati vengono scritti). Alcuni sistemi generano dati sporadicamente, altri producono enormi quantità di dati ogni secondo.
Per esempio:
- Un’implementazione IoT con migliaia di dispositivi può richiedere l’ingestione di milioni di punti dati ogni minuto.
- Uno strumento di monitoraggio DevOps potrebbe raccogliere metriche dei server in tempo reale ogni pochi secondi su migliaia di server.
Non tutti i TSDB sono ottimizzati per velocità di scrittura estremamente elevate. I sistemi che non riescono a stare al passo con l’ingestione perderanno dati, causando lacune nell’analisi e risultati incompleti.
Se i tuoi sistemi generano una grande quantità di dati, devi cercare:
- TSDB che supportano alti tassi di ingestione senza degradazione delle prestazioni.
- Soluzioni con modelli di storage append-only e buffering in memoria per ottimizzare le scritture (ad esempio, InfluxDB, TimescaleDB, Prometheus).
Ti consiglio vivamente di valutare il throughput di scrittura di un TSDB testandolo con workload realistici. Suite di benchmark come Time Series Benchmark Suite possono aiutare a simulare scenari di ingestione.
In alternativa, puoi collegare il tuo sistema al TSDB di tua scelta con una prova gratuita e valutare i risultati. Per esperienza, scoprire che le tue pipeline generano 30 GB di dati ogni 30 minuti non è una bella sorpresa.
Osserva pattern e complessità delle query
Il tipo di query che eseguirai spesso è un altro fattore critico nella scelta di un TSDB. Database diversi sono ottimizzati per workload di query differenti.
Esempi di pattern di query:
- Query su intervalli semplici: recuperare punti dati in un intervallo temporale specifico (ad esempio, “ultimi 7 giorni”).
- Query di aggregazione: calcolare medie, somme o percentili (ad esempio, “media oraria dell’uso CPU”).
- Downsampling: riassumere i dati grezzi a granularità inferiore (ad esempio, medie orarie da letture al secondo).
- Analitiche complesse: correlare più flussi di dati, rilevare anomalie o eseguire analisi predittive.
Alcuni TSDB eccellono nelle query temporali semplici, altri sono più adatti ad aggregazioni complesse o workload analitici. Scegliere il database sbagliato può tradursi in query lente e pipeline analitiche inefficienti.
Potresti voler cercare:
- TSDB con supporto integrato per i tipi di query più comuni per te.
- Sistemi con linguaggi di query simili a SQL (ad esempio, TimescaleDB con compatibilità PostgreSQL) per query più complesse.
- Funzionalità di query continue che permettono di precomputare aggregazioni per i dati consultati di frequente e ridurre il carico in fase di esecuzione.
Verifica scalabilità e disponibilità
Con la crescita del volume dei dati, il tuo TSDB deve scalare senza problemi mantenendo le prestazioni. Inoltre, per applicazioni mission-critical, il database deve essere altamente disponibile per garantire zero downtime.
Se il tuo TSDB non può scalare orizzontalmente (aggiungendo server) o verticalmente (aumentando le risorse del server), rischi colli di bottiglia man mano che i dati crescono.
Cerca di ottenere:
- Scalabilità orizzontale: database che possono distribuire i dati su più nodi (ad esempio con strategie di sharding)
- Alta disponibilità: clustering, replica e meccanismi di failover integrati per garantire l’uptime.
Integrazione ed ecosistema contano davvero
La capacità di un TSDB di integrarsi con i tuoi strumenti e workflow esistenti è fondamentale per garantire che il team lo adotti e lo usi in modo efficiente.
Cerca:
- Integrazione con i tuoi strumenti (piattaforme di monitoraggio, framework di elaborazione dati, strumenti BI, ecc.).
- Supporto per pipeline di ingestione: TSDB che si integrano con le tue fonti dati, come dispositivi IoT, API o aggregatori di log.
- API e linguaggi di query: TSDB che offrono REST API, supporto SQL o SDK linguistici per facilitare l’integrazione degli sviluppatori.
Costo
I TSDB possono diventare costosi, soprattutto con l’aumentare dei volumi. I costi variano in base a licenze, requisiti infrastrutturali e sforzi di manutenzione.
Alcuni TSDB sono open source e gratuiti, ma possono richiedere costi infrastrutturali e operativi significativi. Altri sono commerciali, con costi di licenza ma funzionalità avanzate e supporto.
Assicurati di valutare:
- Costi di licenza: open source (ad es., Prometheus, VictoriaMetrics) vs. commerciali (ad es., InfluxDB Enterprise).
- Costi infrastrutturali: TSDB gestiti in cloud vs. soluzioni self-hosted.
- Overhead di manutenzione: costi operativi per scalabilità, backup e disaster recovery.
Per workload più piccoli, puoi considerare servizi gestiti in cloud che riducono l’overhead operativo, ma assicurati di considerare i costi a lungo termine man mano che i dati crescono. Consiglio inoltre di implementare fin dall’inizio policy di retention e downsampling per gestire efficacemente i costi di storage.
Conclusione
Spero che questa guida ti sia piaciuta tanto quanto è piaciuto a me scriverla!
Ora che conosci le basi dei database di serie temporali, puoi scegliere il database che preferisci, avviare una prova gratuita e iniziare a mettere in pratica le tue competenze!
FAQs
Come gestire dati di serie temporali con intervalli irregolari o fusi orari diversi?
Per intervalli irregolari, il campionamento a intervalli di tempo regolari può aiutare; le differenze di fuso orario possono essere gestite convertendo tutti i dati in un unico fuso o usando l’UTC per mantenere la coerenza.
Posso archiviare dati di serie temporali in un database non relazionale?
Sì, i dati di serie temporali possono essere archiviati in database non relazionali come MongoDB o Cassandra, ma database specializzati per serie temporali o database relazionali con opportune ottimizzazioni (come il partitioning) possono offrire prestazioni migliori per workload di serie temporali su larga scala.
Come scegliere tra un database relazionale e uno specializzato in serie temporali per il mio progetto?
Se i tuoi dati sono principalmente con timestamp e ti servono query e storage efficienti per grandi volumi, un database specializzato come InfluxDB o TimescaleDB può essere più adatto. Tuttavia, se i dati sono più generici e le serie temporali sono solo una parte dell’applicazione, un database relazionale con indicizzazione e partitioning adeguati potrebbe bastare!

Sono una tech lead orientata al prodotto, specializzata nel far crescere startup nelle fasi iniziali, dal primo prototipo al product-market fit e oltre. Sono instancabilmente curiosa di come le persone usano la tecnologia e adoro lavorare a stretto contatto con founder e team cross‑funzionali per dare vita a idee ambiziose. Quando non costruisco prodotti, inseguo l’ispirazione in angoli nuovi del mondo o scarico le tensioni in una sala yoga.


