Leerpad
Een paar jaar geleden, tijdens mijn eerste week in een nieuwe rol als software engineer, werd me gevraagd om time series-databases (TSDB's) te onderzoeken als vervanging voor onze Postgres-oplossing.
Ik wist er helemaal niets van en had enorm veel vragen. Wat is een time series-database eigenlijk? Hoe werkt het? Hoe verschilt het van een traditionele database? Waarom zouden we er een gebruiken? Heb ik daar specifieke skills voor nodig?
Sindsdien heb ik veel geleerd over TSDB's en die kennis in verschillende bedrijven toegepast om een breed scala aan problemen op te lossen.
In dit artikel vat ik samen wat ik de afgelopen jaren heb geleerd, zodat je een goed beeld krijgt van wat TSDB's zijn, hoe ze werken en voor welke use cases ze het best geschikt zijn. Ik loop ook langs een aantal TSDB's die momenteel op de markt zijn en geef je tips om de database te kiezen die het beste bij jouw behoeften past.
Wat zijn time series-databases?
Stel je een slimme thermostaat voor van bedrijf X die elke 30 seconden temperatuurmetingen vastlegt. Op één dag genereert dit ene apparaat duizenden datapunten. Vermenigvuldig dat nu met honderden of duizenden apparaten in een stad, en de hoeveelheid data met tijdstempel die bedrijf X verzamelt is enorm.
Om deze data efficiënt op te slaan en trends te analyseren (zoals temperatuurveranderingen in de tijd of plotselinge pieken), heeft bedrijf X een database nodig die enorme schrijfsnelheden aankan en tijdgebaseerde queries efficiënt kan uitvoeren.
Traditionele databases hebben vaak moeite met dit soort workload, omdat ze niet zijn ontworpen voor high-frequency writes of voor het efficiënt bevragen van data over specifieke tijdsperioden. Daar komen time series-databases in beeld.
Time series-databases zijn gespecialiseerde databases die zijn ontworpen om data te beheren die is geordend en geïndexeerd op tijd. In tegenstelling tot traditionele databases, die zijn geoptimaliseerd voor algemene dataopslag, focussen TSDB's op het efficiënt opslaan, bevragen en analyseren van reeksen datapunten met een tijdstempel.
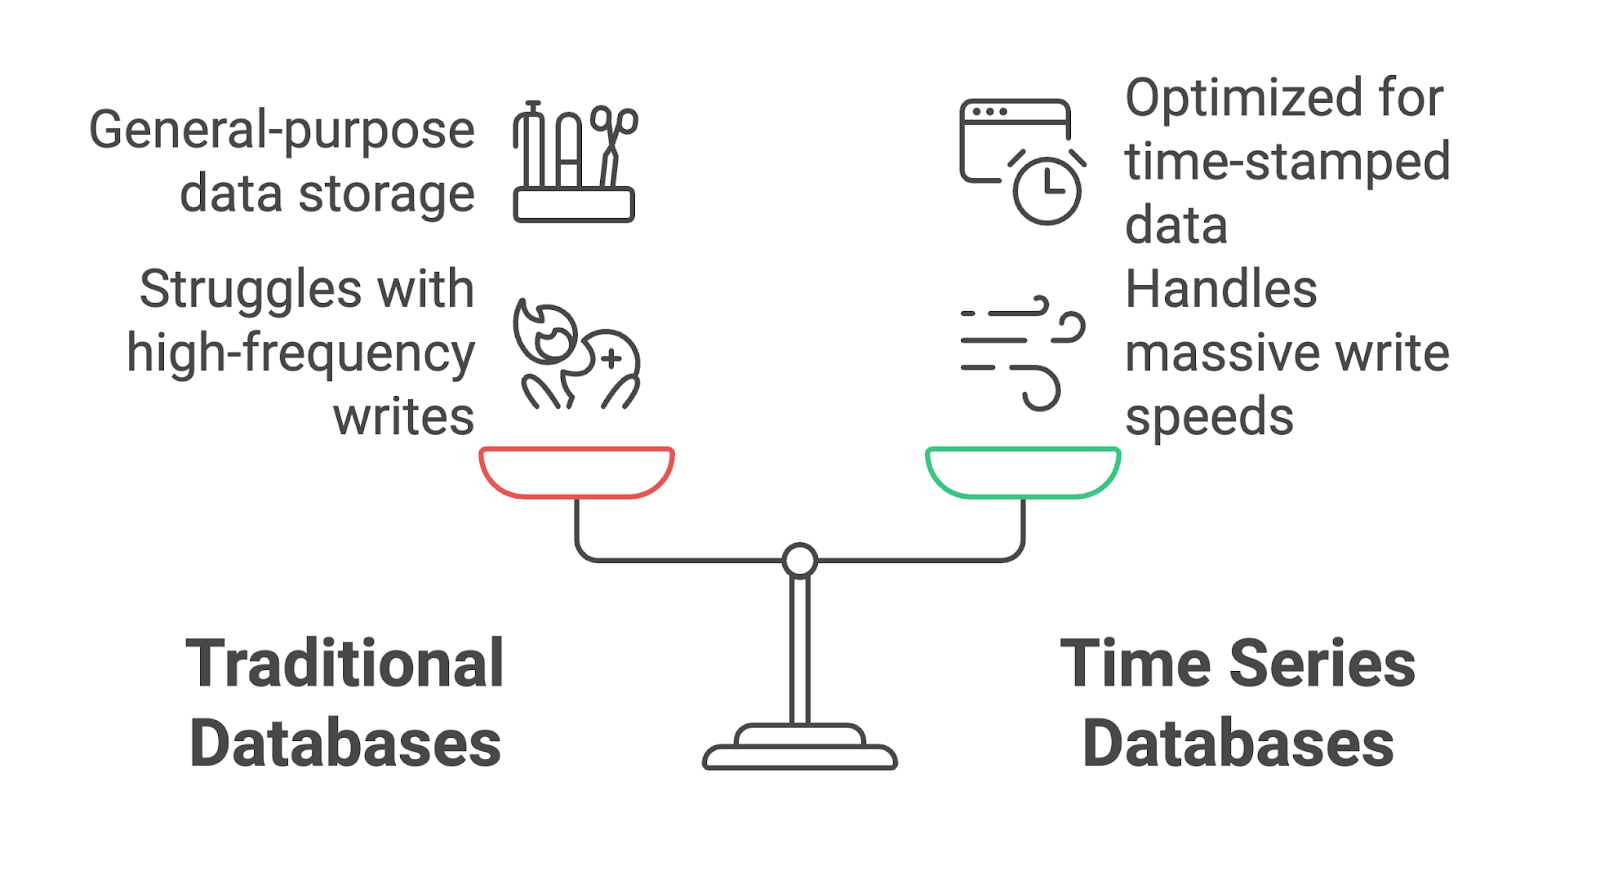
TSDB's zijn vooral geschikt voor toepassingen die met continue datastromen werken, zoals IoT, DevOps-monitoring en financiële analytics.
Kenmerken van time series-databases
Er zijn een paar dingen die TSDB's anders doen dan traditionele databases.
Geoptimaliseerd voor data met tijdstempel
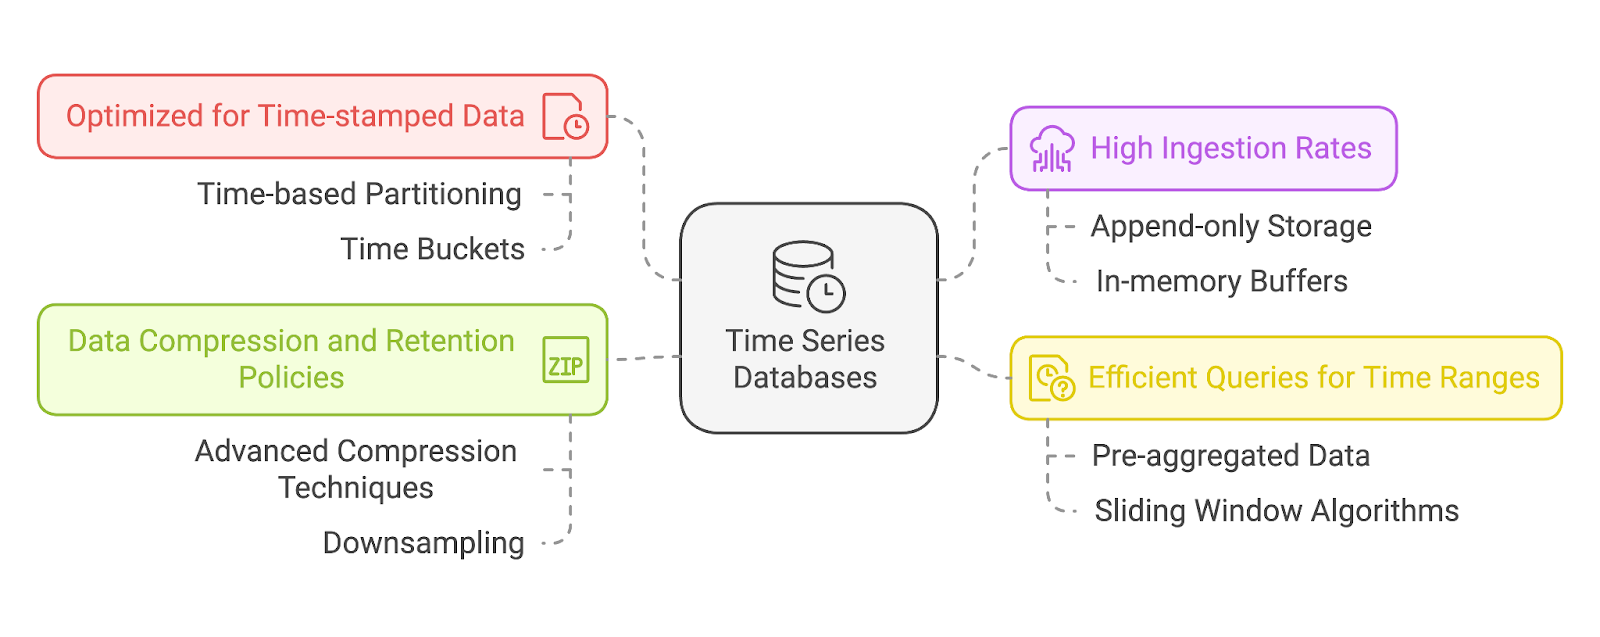
In de kern zijn TSDB's gebouwd om data met tijdstempels als fundamenteel kenmerk te verwerken. Elk datapunt in een TSDB bevat een tijdstempel, die dient als primaire index. Dit stelt deze databases in staat om tijdgeordende reeksen efficiënt op te slaan en op te halen, en snel toegang te bieden tot historische trends of recente gebeurtenissen.
De meeste TSDB's gebruiken tijdgebaseerde partitionering, wat betekent dat data wordt opgeslagen in partities op basis van tijdsintervallen (bijv. elk uur, dagelijks). Dit maakt efficiënt prunen mogelijk, waarbij queries irrelevante partities volledig negeren.
Ze kunnen ook time buckets implementeren, waarbij data wordt gegroepeerd in vooraf gedefinieerde tijdvensters (bijv. 1 minuut, 1 uur) voor snellere aggregaties.
Hoge ingestiesnelheden
Time series-data wordt vaak in hoog tempo gegenereerd—denk aan IoT-apparaten die duizenden datapunten per seconde sturen of een servermonitoringtool die systeemstatistieken in real time vastlegt. TSDB's zijn geoptimaliseerd voor deze hoge schrijfsnelheden en kunnen enorme hoeveelheden data opnemen zonder te vertragen of informatie te verliezen.
Dit wordt meestal bereikt met append-only opslagmodellen en in-memory buffers om locks of transactionele bottlenecks te voorkomen.
Efficiënte queries voor tijdsbereiken
Het analyseren van time series-data houdt vaak in dat je specifieke tijdsintervallen of -vensters bevraagt, zoals “afgelopen 24 uur” of “dit jaar vergeleken met vorig jaar”. TSDB's zijn hiermee in gedachten gebouwd en bieden gespecialiseerde querymogelijkheden waarmee je snel data kunt ophalen over gedefinieerde tijdsbereiken. Ze ondersteunen ook aggregaties zoals gemiddelden, totalen of trends om waardevolle analyses te bieden zonder complexe querylogica.
De queryoptimalisatietechnieken omvatten:
- Pre-geaggregeerde data: TSDB's berekenen vaak samenvattingen vooraf voor veelvoorkomende tijdsintervallen (bijv. uurlijkse of dagelijkse gemiddelden).
- Sliding window-algoritmen: Deze helpen om statistieken efficiënt te berekenen over schuivende tijdsvensters, zoals voortschrijdende gemiddelden.
Datacompressie en retentiebeleid
Om de enorme hoeveelheid time series-data in de loop van de tijd te beheren, gebruiken TSDB's geavanceerde compressietechnieken. Deze methoden verlagen de opslagvereisten terwijl de queryprestaties behouden blijven.
TSDB's bevatten doorgaans retentiebeleid zodat gebruikers kunnen bepalen hoe lang data bewaard moet blijven. Zo kan een systeem bijvoorbeeld gedetailleerde data van de afgelopen maand bewaren, terwijl het voor oudere data downsampling toepast. Downsampling is het proces waarbij de granulariteit van data in de loop van de tijd wordt verlaagd. Bijvoorbeeld:
- Ruwe temperatuurmetingen kunnen elke 10 seconden worden vastgelegd voor de meest recente 7 dagen.
- Voor oudere data kan het systeem downsamplen naar uurlijkse gemiddelden om ruimte te besparen en toch historische trends te behouden.
Voorbeelden van geavanceerde compressietechnieken zijn:
- Delta-encoding: Het opslaan van het verschil tussen opeenvolgende waarden in plaats van de volledige waarde.
- Gorilla-compressie: Een methode om drijvende-komma time series-data efficiënt te comprimeren door veranderingen in binair formaat op te slaan.

Use cases voor time series-databases
Time series-databases worden gebruikt in veel moderne datagedreven toepassingen en in uiteenlopende sectoren. Laten we de belangrijkste use cases verkennen.
1. Internet of Things (IoT)
IoT-apparaten, zoals slimme thermostaten, industriële sensoren en milieumonitors, genereren continue stromen data met tijdstempel. TSDB's worden gebruikt om deze data op te slaan en te analyseren, en drijven toepassingen aan zoals:
- Slimme huizen: Apparaten monitoren en aansturen op basis van tijdbepaalde data.
- Industriële automatisering: Machineprestaties volgen en realtime anomalieën detecteren om downtime te minimaliseren.
- Milieumonitoring: Data verzamelen van sensoren om luchtkwaliteit, weerpatronen of waterstanden in de tijd te volgen.
2. DevOps en systeemmonitoring
In DevOps worden TSDB's veel gebruikt om IT-infrastructuur en applicaties te monitoren door statistieken te verzamelen zoals CPU-gebruik, geheugengebruik en netwerkdoorvoer. Ze maken mogelijk:
- Prestatiemonitoring: Systeemsituatie en prestatiestatistieken realtime visualiseren.
- Anomaliedetectie: Ongebruikelijke patronen identificeren, zoals pieken in serverbelasting of netwerkvertraging.
- Capaciteitsplanning: Historische trends gebruiken om toekomstige resourcebehoeften te voorspellen en toe te wijzen.
Tools zoals Prometheus en Grafana integreren vaak met TSDB's om visualisatie- en alarmeringsmogelijkheden te bieden voor DevOps-teams.
3. Financiële markten
TSDB's zijn cruciaal voor het verwerken en analyseren van de enorme hoeveelheden high-frequency data die in financiële markten worden gegenereerd. Ze worden gebruikt voor:
- Algorithmische handel: Marktdata in milliseconden opslaan en analyseren om trades uit te voeren op basis van realtime trends.
- Risicobeheer: Financiële statistieken in de tijd monitoren om risico's te beoordelen en te beperken.
- Marktanalyse: Historische data analyseren om patronen, trends en anomalieën in markgedrag te identificeren.
4. Andere toepassingen
Hoewel de drie bovenstaande use cases heel gangbaar zijn, kunnen time series-databases ook in allerlei andere domeinen worden ingezet:
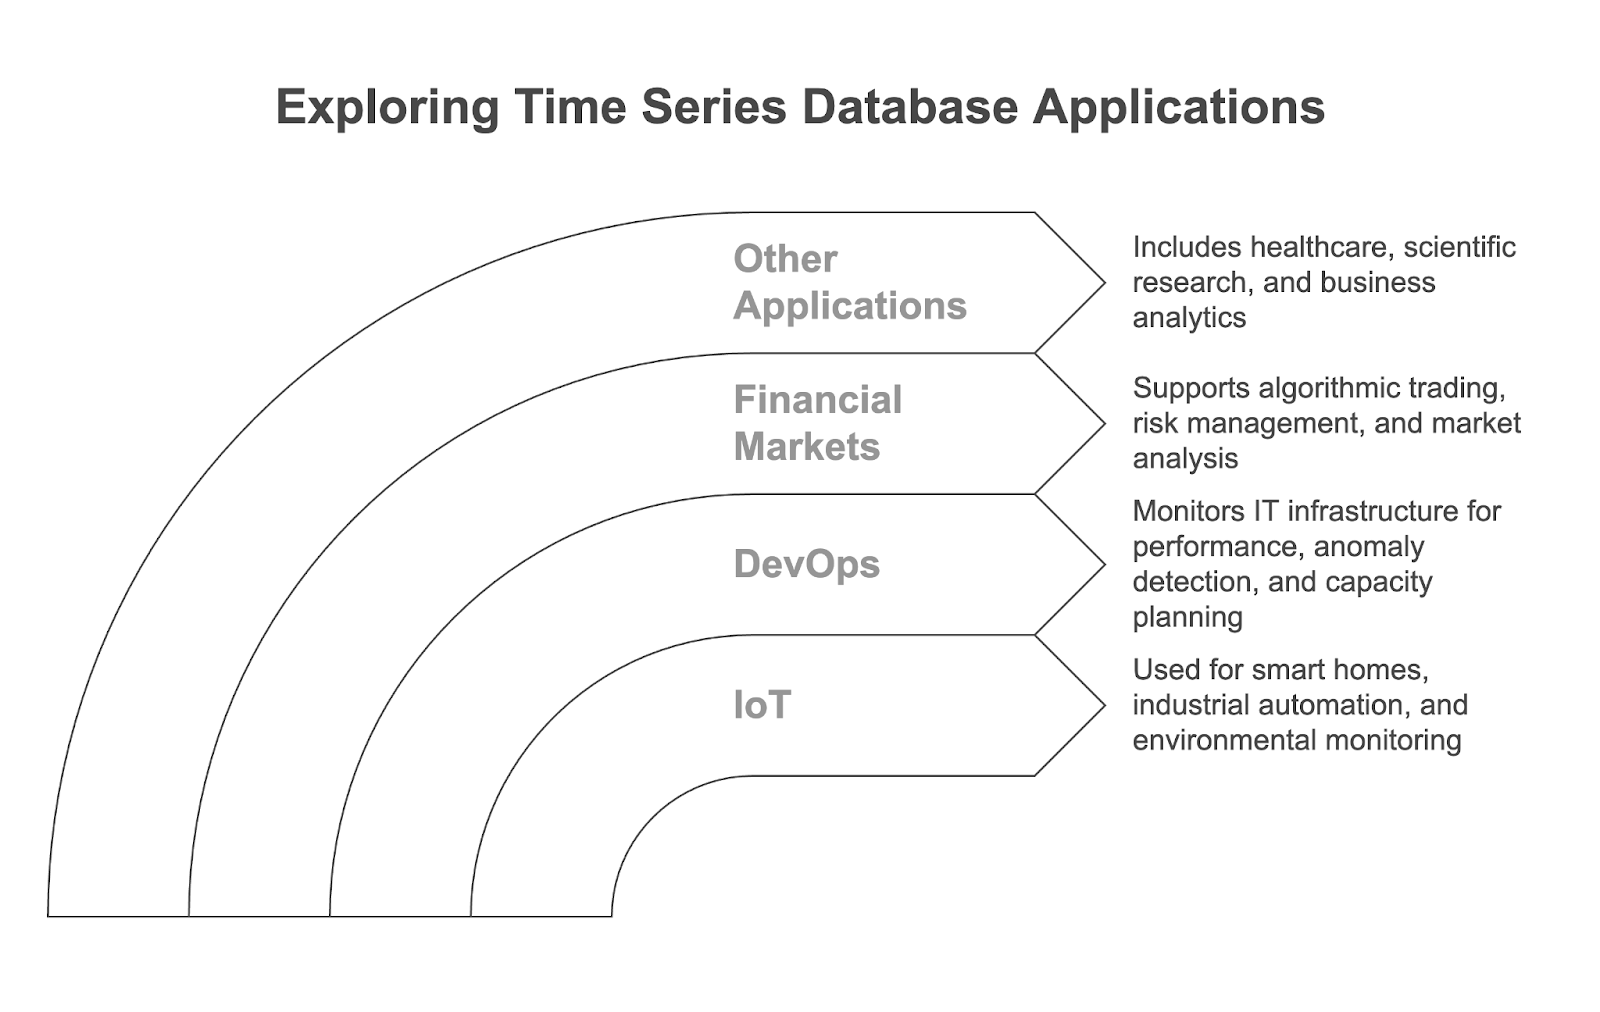
- Zorg: Patiëntvitale waarden realtime monitoren en data van medische apparaten analyseren.
- Wetenschappelijk onderzoek: Data verzamelen en analyseren voor klimaatmodellering, astronomische observaties en andere tijdsafhankelijke fenomenen.
- Business analytics: Klantgedrag volgen, verkooptrends analyseren en key performance indicators in de tijd monitoren.

Beste time series-databases: een vergelijkend overzicht
Time series-databases komen in verschillende vormen, elk toegesneden op specifieke use cases.
InfluxDB
InfluxDB is een populaire open-source time series-database, ontwikkeld door InfluxData. Het is specifiek ontworpen voor hoge ingestiesnelheden en efficiënt bevragen van data met tijdstempel, waardoor het een veelgebruikte oplossing is voor IoT-monitoring, DevOps-statistieken en realtime analytics.
|
Voordelen |
Nadelen |
|
Hoge ingestiesnelheden voor enorme volumes data. |
Vereist handmatig beheer van retentiebeleid voor optimale opslag. |
|
SQL-achtige InfluxQL vereenvoudigt query's voor analisten die bekend zijn met relationele databases. |
Schaalbaarheidsuitdagingen voor zeer grote datasets zonder enterprise-functies. |
|
Integreert eenvoudig met tools zoals Grafana voor visualisatie. |
Beperkte geavanceerde querymogelijkheden vergeleken met SQL-gebaseerde databases. |
TimescaleDB
TimescaleDB is een open-source extensie voor PostgreSQL, ontworpen om de kracht van relationele databases te combineren met time series-functionaliteit. Je kunt SQL benutten terwijl je data met tijdstempel efficiënt verwerkt. Dit maakt het bijzonder geschikt voor use cases waarbij time series-data moet worden geïntegreerd met relationele data, zoals business analytics of IoT-telemetrie.
|
Voordelen |
Nadelen |
|
Volledige SQL-ondersteuning maakt eenvoudige integratie met bestaande PostgreSQL-tools en -workflows mogelijk. |
Vereist PostgreSQL-kennis voor setup en onderhoud. |
|
Hypertables: Partitioneert time series-data automatisch voor efficiënte opslag en query's. |
Haalt mogelijk nog niet de ingestiesnelheid van dedicated TSDB's zoals InfluxDB. |
|
Combineert relationele en time series-data in één database. |
Prometheus
Prometheus is een monitoring- en alarmeringssysteem met een ingebouwde TSDB, breed omarmd in DevOps voor realtime systeemstatistieken, prestatietracking en alarmbeheer.
|
Voordelen |
Nadelen |
|
Lichtgewicht en eenvoudig te deployen, vooral met Kubernetes. |
Beperkte langetermijnopslag zonder externe oplossingen. |
|
Pull-based metric scraping zorgt dat alleen relevante data wordt verzameld. |
Schaalbaarheid leunt op extra tools zoals Thanos of Cortex. |
|
PromQL biedt krachtige querymogelijkheden. |
Richt zich op metrics en is mogelijk niet geschikt voor alle algemene TSDB-behoeften. |
Clickhouse
ClickHouse is een open-source column store-database die is ontworpen voor analytische query's met hoge prestaties. Hoewel het geen traditionele TSDB is, maakt de architectuur het uitzonderlijk geschikt voor time series-data, vooral wanneer snelle queryprestaties cruciaal zijn.
|
Voordelen |
Nadelen |
|
Hoge queryprestaties voor analytische workloads. |
Complex om op te zetten en te onderhouden voor beginners. |
|
Column store-opslag vermindert querylatentie. |
Niet specifiek ontworpen als TSDB (kan workarounds vereisen). |
Apache Cassandra
Apache Cassandra is een gedistribueerde NoSQL-database, gebouwd voor horizontale schaalbaarheid en hoge beschikbaarheid. Hoewel het niet exclusief een TSDB is, kan het effectief worden gebruikt voor time series-workloads, met name wanneer duurzaamheid en fouttolerantie cruciaal zijn.
|
Voordelen |
Nadelen |
|
Uitstekende horizontale schaalbaarheid. |
Time series-data bevragen kan omslachtig zijn zonder extra optimalisaties, omdat de database geen native time series-query- en aggregatiefuncties heeft. |
|
Fouttolerant en zeer beschikbaar. |
Amazon Timestream
Amazon Timestream is een volledig beheerde time series-databaseservice die door AWS wordt aangeboden. Gebouwd voor schaalbaarheid en eenvoud, is het ideaal voor organisaties die al gebruikmaken van AWS-infrastructuur voor IoT en applicatiemonitoring.
|
Voordelen |
Nadelen |
|
Serverless-architectuur vereenvoudigt het beheer. |
Beperkte functionaliteit buiten het AWS-ecosysteem. |
|
Schaalt automatisch om grote datavolumes aan te kunnen. |
Kosten kunnen oplopen bij hoge ingestiesnelheden. |
Laten we dit snel samenvatten met deze tabel:
|
Database |
Primaire use cases |
Opslagmodel |
Ecosysteem-compatibiliteit |
|
InfluxDB |
IoT-monitoring, DevOps-metrics, realtime analytics |
Geoptimaliseerd voor time series, disk-based |
Integreert met Grafana, Telegraf en Kapacitor |
|
TimescaleDB |
Business analytics, IoT-telemetrie, SQL-gebaseerde applicaties |
Relationeel (PostgreSQL-extensie) |
Werkt met PostgreSQL-tools zoals pgAdmin, Grafana |
|
Prometheus |
DevOps-monitoring, prestatietracking, alarmering |
Ingebedde time series-opslag |
Ontworpen voor Kubernetes, integreert met Thanos, Grafana |
|
ClickHouse |
Analytische workloads met hoge prestaties, time series-analytics |
Column store-opslag |
Ondersteunt SQL-gebaseerde analytics, integreert met BI-tools |
|
Apache Cassandra |
Gedistribueerde time series-opslag, grootschalige logging |
Wide-column NoSQL |
Compatibel met Spark, Kafka en schaalbare gedistribueerde systemen |
|
Amazon Timestream |
AWS-gebaseerde IoT-monitoring, applicatietelemetrie |
Serverless, beheerde TSDB |
Nauw geïntegreerd met AWS-services (Lambda, IoT Core, QuickSight) |
De juiste time series-database kiezen: belangrijke overwegingen
Time series-databases bieden verschillende functies voor verschillende behoeften. Hoe kies je dus degene die jouw probleem het beste oplost?
Evalueer het datavolume en de ingestiesnelheid
Time series-workloads kunnen sterk variëren in termen van datavolume (hoeveel data er wordt gegenereerd) en ingestiesnelheid (hoe snel data wordt weggeschreven). Sommige systemen genereren data sporadisch, terwijl andere elke seconde enorme hoeveelheden data produceren.
Bijvoorbeeld:
- Een IoT-implementatie met duizenden apparaten kan miljoenen datapunten per minuut moeten opnemen.
- Een DevOps-monitoringtool kan realtime serverstatistieken elke paar seconden verzamelen over duizenden servers.
Niet alle TSDB's zijn geoptimaliseerd voor extreem hoge schrijfsnelheden. Systemen die de ingestie niet kunnen bijbenen, laten data vallen, wat leidt tot gaten in analyses en onvolledige resultaten.
Als jouw systemen enorme hoeveelheden data genereren, moet je letten op:
- TSDB's die hoge ingestiesnelheden ondersteunen zonder prestatieverlies.
- Oplossingen met append-only opslagmodellen en in-memory buffering voor write-optimalisatie (bijv. InfluxDB, TimescaleDB, Prometheus).
Ik raad je echt aan om de write-throughput van een TSDB te evalueren door te testen met realistische workloads. Benchmarking-suites zoals Time Series Benchmark Suite kunnen ingestiescenario's helpen simuleren.
Je kunt ook je systeem verbinden met de TSDB van je keuze in een gratis proefperiode en de resultaten evalueren. Uit ervaring: ontdekken dat je pipelines elke 30 minuten 30GB aan data genereren is geen leuke verrassing.
Kijk naar querypatronen en complexiteit
Het type query's dat je vaak draait, is een andere cruciale factor bij het kiezen van een TSDB. Verschillende databases zijn geoptimaliseerd voor verschillende queryworkloads.
Voorbeelden van querypatronen:
- Eenvoudige bereikquery's: Datapunten ophalen binnen een specifiek tijdsbereik (bijv. “afgelopen 7 dagen”).
- Aggregatiequery's: Gemiddelden, totalen of percentielen berekenen (bijv. “gemiddeld CPU-gebruik per uur”).
- Downsampling: Ruwe data samenvatten naar lagere granulariteit (bijv. uurlijkse gemiddelden uit per-seconde metingen).
- Complexe analytics: Meerdere datastromen correleren, anomalieën detecteren of voorspellende analyses uitvoeren.
Sommige TSDB's blinken uit in eenvoudige tijdgebaseerde query's, terwijl andere beter geschikt zijn voor complexe aggregaties of analytische workloads. De verkeerde database kiezen kan resulteren in trage query's en inefficiënte analytische pipelines.
Je wilt mogelijk letten op:
- TSDB's met ingebouwde ondersteuning voor jouw meest voorkomende querytypen.
- Systemen met SQL-achtige querytalen (bijv. TimescaleDB met PostgreSQL-compatibiliteit) voor complexere query's.
- Mogelijkheden voor continue query's waarmee je aggregaties vooraf kunt berekenen voor vaak geraadpleegde data en de queryload tijdens runtime kunt verlagen.
Controleer schaalbaarheid en beschikbaarheid
Naarmate je datavolume groeit, moet je TSDB naadloos schalen met behoud van performance. Bovendien moet de database voor mission-critical applicaties hoog beschikbaar zijn om downtime te voorkomen.
Als je TSDB niet horizontaal (door meer servers toe te voegen) of verticaal (door serverresources te vergroten) kan schalen, loop je risico op systeemknelpunten naarmate de data groeit.
Je wilt letten op:
- Horizontale schaalbaarheid: Databases die data over meerdere nodes kunnen verdelen (bijvoorbeeld met sharding-strategieën)
- Hoge beschikbaarheid: Ingebouwde clustering, replicatie en failover-mechanismen om uptime te garanderen.
Integratie en ecosysteem zijn echt belangrijk
Hoe goed een TSDB integreert met je bestaande tools en workflows is superbelangrijk om te zorgen dat je team het adopteert en efficiënt gebruikt.
Let op:
- Integratie met je tools (monitoringplatformen, dataverwerkingsframework, BI-tools, enz.)
- Ondersteuning voor ingestiepijplijnen: Kijk naar TSDB's die integreren met jouw databronnen, zoals IoT-apparaten, API's of log-aggregators.
- API's en querytalen: TSDB's die REST API's, SQL-ondersteuning of taal-SDK's bieden, maken integratie voor developers eenvoudiger.
Kosten
TSDB kan duur worden, vooral naarmate je datavolumes groeien. Kosten kunnen variëren afhankelijk van licenties, infrastructuurvereisten en onderhoudsinspanningen.
Sommige TSDB's zijn open source en gratis te gebruiken, maar vragen mogelijk aanzienlijke infrastructuur- en operationele kosten. Andere zijn commercieel met licentiekosten, maar komen met geavanceerde functies en support.
Zorg dat je kijkt naar:
- Licentiekosten: Open source (bijv. Prometheus, VictoriaMetrics) vs. commercieel (bijv. InfluxDB Enterprise).
- Infrastructuurkosten: Cloud-gehoste TSDB's vs. zelfgehoste oplossingen.
- Onderhoudsoverhead: Operationele kosten voor schalen, back-ups en disaster recovery.
Voor kleinere workloads kun je beheerde cloudservices overwegen die de operationele overhead verminderen, maar houd rekening met de langetermijnkosten naarmate de data schaalt. Ik raad ook echt aan om vanaf het begin retentiebeleid en downsampling te implementeren om opslagkosten effectief te beheren.
Conclusie
Ik hoop dat je deze gids met net zoveel plezier hebt gelezen als ik hem heb geschreven!
Nu je de basis van time series-databases kent, kun je een database naar keuze kiezen, een gratis proef starten en je skills in de praktijk brengen!
FAQs
Hoe ga je om met time series-data met onregelmatige intervallen of verschillende tijdzones?
Voor onregelmatige intervallen kan het helpen om de data te resamplen op regelmatige tijdsintervallen, terwijl tijdzoneverschillen beheerd kunnen worden door alle data om te zetten naar één tijdzone of door UTC te gebruiken om consistentie te behouden.
Kan ik time series-data opslaan in een niet-relationele database?
Ja, time series-data kan worden opgeslagen in niet-relationele databases zoals MongoDB of Cassandra, maar gespecialiseerde time series-databases of relationele databases met de juiste optimalisaties (zoals partitionering) kunnen betere prestaties bieden voor grootschalige time series-workloads.
Hoe kies ik tussen een relationele database of een gespecialiseerde time series-database voor mijn project?
Als je data voornamelijk tijdgestempeld is en je efficiënte query's en opslag voor grote volumes data nodig hebt, is een gespecialiseerde time series-database zoals InfluxDB of TimescaleDB mogelijk geschikter. Maar als de data algemener van aard is en time series slechts een deel van je applicatie is, kan een relationele database met de juiste indexering en partitionering voldoende zijn!

Ik ben een productgerichte tech lead die gespecialiseerd is in het laten groeien van startups in een vroeg stadium, van het eerste prototype tot product‑market fit en verder. Ik ben eindeloos nieuwsgierig naar hoe mensen technologie gebruiken, en ik werk graag nauw samen met oprichters en multidisciplinaire teams om gedurfde ideeën tot leven te brengen. Als ik geen producten bouw, zoek ik inspiratie in nieuwe uithoeken van de wereld of ontspan ik me in de yogastudio.

