Grup Göreli Politika Optimizasyonu (GRPO), en yeni büyük dil modellerinin (LLM) etkileyici performansını besleyen son teknoloji bir pekiştirmeli öğrenme (RL) tekniğidir. DeepSeek-R1 yayınlandıktan sonra geniş çapta dikkat çekse de, GRPO ilk olarak gelişmiş matematiksel akıl yürütme için ince ayarlanmış bir LLM olan DeepSeekMath içinde tanıtıldı. GRPO başlangıçta ince ayarlamada verimliliği artırmak için tasarlandı ve topluluk tarafından benimsenen, maliyet etkin ve çok yönlü bir yöntem olduğunu kanıtladı.
Bu yazıda GRPO’ya derinlemesine bakacağız. Ne olduğunu, nasıl çalıştığını, uygulanması için gerekli temel bileşenleri ve ne zaman kullanmanın en uygun olduğunu inceleyeceğiz. Bu rehberin amacı, GRPO’nun artan popülaritesini haklı çıkaran temel içgörüleri adım adım aktarmaktır.
DeepSeek hakkında daha fazla bilgi edinmek isterseniz, Python ile DeepSeek Kullanımı kursumuza mutlaka göz atın.
Pekiştirmeli Öğrenmeye Giriş
LLM ince ayar rehberimizde incelediğimiz üzere, gözetimli ince ayar (SFT), etiketli veriler kullanarak bir modelin eğitilmesinden oluşan geleneksel bir eğitim tekniğidir. Yani, verilen girdiler için beklenen tamamlama veya çıktıları gösteren örneklerin kullanılmasıdır.
SFT’nin sınırlamalarından biri, üretimi maliyetli ve zaman alıcı olabilen büyük, etiketli veri kümelerine büyük ölçüde dayanmasıdır. Ayrıca SFT ile eğitilen modellerin, eğitim örneklerine aşırı uyum sağlama riski vardır; bu da görülen verilerde iyi performans gösterip yeni veya beklenmedik durumlara genellemekte zorlanmaları anlamına gelir.
SFT’ye bir alternatif de pekiştirmeli öğrenmedir; burada, sabit örneklerden öğrenmek yerine, bir ajan, bir görevi tamamlamak için çeşitli eylemleri deneyerek çevresiyle etkileşime girerek öğrenir. Her eylemden sonra ajan, ödüller veya cezalar şeklinde geri bildirim alır. Amaç, en iyi çalışan stratejileri keşfederek zaman içinde toplam ödülü en üst düzeye çıkarmaktır.
Basit bir RL iş akışını şu şekilde betimleyebiliriz:
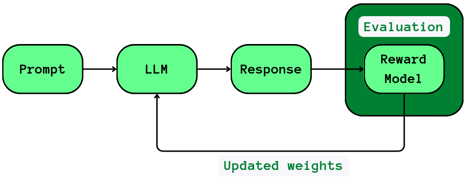
Basit bir RL iş akışı diyagramı.
Python ile RL’ye uygulamalı başlamak isterseniz, Pekiştirmeli Öğrenme: Python Örnekleriyle Bir Giriş eğitimi size göre!
Pekiştirmeli öğrenmeyi kolaylaştırmak
Pekiştirmeli öğrenme kavramını somutlaştırmak için, kuzeninize bisiklete binmeyi öğrettiğinizi hayal edin. Başlangıçta pedallama ve denge kurma konusunda zorlanır, sık sık yalpalayıp düşer.
Her biraz daha ileri gittiğinde onu tezahüratla desteklersiniz. Bu olumlu geri bildirim devam etmesini teşvik eder. Ancak merdivenlerden inmeye çalıştığında onu hemen durdurur ve riskleri açıklarsınız. Bu da istenmeyen eylemleri caydıran olumsuz bir sinyal işlevi görür.
Benzer şekilde, pekiştirmeli öğrenme, modellere farklı eylemleri keşfetme imkânı tanır. Olumlu ödüller arzu edilen sonuçları pekiştirirken, olumsuz ödüller istenmeyen davranışları caydırır. Zamanla model bu geri bildirim sayesinde daha iyi kararlar almayı öğrenir.
Pekiştirmeli öğrenmeye yaklaşımlar
Bir modele pekiştirmeli öğrenme uygulamak için farklı teknikler vardır. Spesifik olarak, GRPO, yakınsal politika optimizasyonu (PPO) ve doğrudan politika optimizasyonunun (DPO) bir evrimi olarak kabul edilir.
Daha önce PPO ve DPO’yu duymuş muydunuz?
Yakınsal politika optimizasyonu
PPO, ayrı bir ödül modeli kullanarak bir modelin ödüllerini en üst düzeye çıkaracak şekilde davranışını optimize etmeyi amaçlayan, yaygın kullanılan bir RL algoritmasıdır. PPO’nun uygulamadaki harika bir örneği OpenAI’nin insan geri bildiriminden pekiştirmeli öğrenme (RLHF) yaklaşımıdır. RLHF’de insan geri bildirimi önce model çıktıları üzerinde toplanır ve bu veriler daha sonra geri bildirimi tahmin etmek üzere bir ödül modelini eğitmekte kullanılır. Bir ödül modeline sahip olmak, insanlara ihtiyaç duymadan insan geri bildirimini ölçeklemenin bir yoludur.
Son olarak PPO, eğitim sırasında ödül modelini kullanarak modelin parametrelerini ayarlar ve insan tercihleriyle daha iyi hizalanan yanıtlar üretmesini teşvik eder. Aşağıdaki diyagram PPO iş akışını göstermektedir:
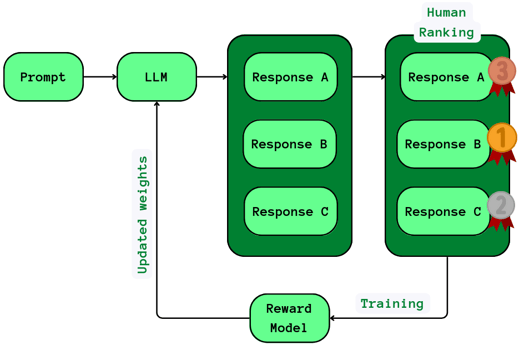
PPO iş akışı diyagramı.
PPO iş akışını Python’da uygulamak isterseniz, PyTorch ve Gymnasium ile Proximal Policy Optimization eğitimini değerlendirin.
Doğrudan politika optimizasyonu
Ayrı bir ödül modeli eğitmek karmaşık ve kaynak yoğun olabilir. Bu süreci basitleştirmek için, insan geri bildiriminin toplanma şeklini değiştiren DPO tanıtıldı.
İnsanlardan yanıtları sayısal puanlarla derecelendirmeleri istenmek yerine, DPO tercih karşılaştırmalarına dayanır. İnsan değerlendiricilere iki yanıt gösterilir ve hangisini tercih ettikleri sorulur. Bu nedenle tercih edilen ve daha az tercih edilen örneklerden oluşan bir veri kümesi oluşur.
Model daha sonra ödül modeline dayanmak yerine bu tercih çiftleri üzerinde doğrudan ince ayar yapılır. Bu yaklaşımla model, tercih edilen yanıtı üretme olasılığını artırmayı, daha az tercih edileni ise azaltmayı öğrenir.
Bu yaklaşım, ayrı bir ödül modeline ihtiyaç duymadan modelin insan tercihleriyle hizalanmasını sağlar. Bu yeni iş akışına göz atalım:
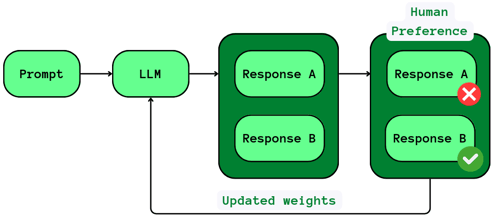
DPO iş akışı diyagramı.
DPO’yu pratikte uygulamanıza yardımcı olacak OpenAI'nin Tercih İnce Ayarı: Örneklerle Rehber eğitimine göz atın.
PPO ve DPO’nun zorlukları
DPO, PPO’ya kıyasla pek çok avantaj sunar. Veriden başlayacak olursak, PPO’nun önce ödül modelini eğitmek için veriyi toplaması, ardından bu yardımcı modelin gerçek eğitimini yapması gerekir (yeni bir modeli eğitmenin tüm teknik zorluklarıyla birlikte); üstelik hedef modelinizi eğitmeye başlamadan önce. DPO, ayrı bir ödül modeline gerek olmamasını sağlayarak süreci basitleştirir. Bununla birlikte, bu yaklaşım yine de kayda değer miktarda tercih verisi gerektirir.
Bu sınırlamaları ortadan kaldırmanın bir yolunu öngörebiliyor musunuz?
Dış geri bildirime güvenmek yerine model yanıtlarını doğrulayıp puanlayacak otomatik bir yol bulabilsek?
İşte GRPO tam olarak bunu sunuyor!
GRPO nedir?
Grup Göreli Politika Optimizasyonu, etiketli veri gerektirmeyen; yalnızca doğruluğu “doğrulayacak” ve yanıtları buna göre sıralayacak bir yönteme ihtiyaç duyan bir RL tekniğidir. Doğrulama genellikle programlanabilir ödül işlevleriyle sağlanır; örneğin, modelin yanıtını girdi olarak alıp işlevin belirli bir yönüne ilişkin bir puan üreten işlevler.
GRPO’nun bazı yaklaşımları yanıtları doğrulamak ve puanlamak için bir yargıç olarak LLM kullanır, ancak GRPO’nun temel fikri, üretilen kodun farklı yönlerinin harici araçlarla doğrulanabildiği yazılım geliştirme gibi alanlarda, harici bir modele gerek olmadan da uygulanabilir. Örneğin,
- Kod derleniyor mu? Burada yalnızca derleyiciye ihtiyaç var.
- Çalışma zamanı hatası var mı? Burada yalnızca kodu çalıştırmamız gerekir.
- Birim testlerini geçiyor mu? Burada yalnızca birim testlerine ihtiyacımız var.
- Kod denetleyicisinin çıktısı temiz mi? Burada yalnızca bir linter gerekir.
Gördüğünüz gibi, insanlara veya tercih verisine ihtiyaç yok!
Ödül işlevleri
DeepSeek-Math’in orijinal makalesinde, ödül işlevleri matematiksel çözümlerin doğruluğunu ve biçimlendirmesini değerlendirecek şekilde tasarlandı. Bir LLM’den yapılandırılmış bir çıktı istediyseniz, modelin tamamlamanın çoğunda istenen çıktı biçimine uymuş olabileceğini fark etmişsinizdir; ama her zaman hattınızı bozan bir köşe vaka olmuştur, değil mi?
DeepSeek-Math durumunda ödül işlevleri doğruluk ve biçimlendirmeye odaklandı:
- Doğruluk ödülleri, modelin nihai yanıtının doğru olup olmadığını değerlendirir. Deterministik matematik problemleri için, modelin nihai yanıtı belirli bir biçimde sunması istenir (ör. bir kutu içinde), böylece altın standartla otomatik doğrulama yapılabilir.
- Biçim ödülleri, modelin yanıtlarının önceden tanımlı bir yapıya uymasını sağlar. Özellikle modelin akıl yürütme sürecini belirlenen etiketler (ör.
<think> ve </think>) içine alması teşvik edilir. Bu biçimlendirme, modelin düşünce sürecinin çıkarılmasını ve analizini kolaylaştırır, çıktılarında açıklık ve tutarlılığı destekler.
GRPO iş akışı
Bu noktada kendinize şu soruyu soruyor olabilirsiniz: GRPO bir modelin eğitim iş akışına nerede oturur?
Süreci adım adım gözden geçirelim!
- LLM’ye bir istem gönderin ve birden çok aday yanıt örnekleyin.
- İstemi ve yanıt çiftlerini alan ve her birine bir puan atayan bir veya daha fazla programlanabilir işlev yazın.
- Bu puanları, ortalamanın üzerindeki puanlara sahip yanıtları üretme olasılığını artıracak ve ortalamanın altındakileri azaltacak şekilde LLM ağırlıklarını güncellemek için kullanın.
Bu döngüyü izleyerek, GRPO tercih verisi toplamaya gerek kalmadan modeli doğrudan ödül işlevlerinin çıktısına göre ince ayarlar.
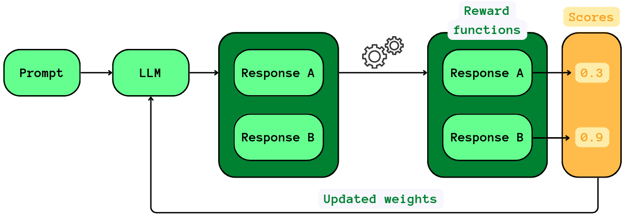
Puan ödüllerinin harici bir aktör tarafından hesaplandığı GRPO iş akışı diyagramı.
Son olarak, GRPO’nun yalnızca PPO veya DPO’da olduğu gibi öğrenmeyi bir tercihe yönlendirmek yerine, modele yeni görevler öğretme avantajını da sağladığını belirtmek ilginçtir.
GRPO’nun faydaları
Yukarıdaki diyagramdan da görülebileceği gibi, GRPO’nun en büyük faydası, etiketli veri gerektirmemesi; doğruluğu “doğrulamanın” bir yolunun yeterli olmasıdır; bu da programlanabilir ödül işlevleri kullanılarak elde edilir.
Bir diğer fayda, geleneksel ince ayara kıyasla çok daha az örnek gerektirmesidir; bu da tekniği maliyet açısından cazip kılar.
Ayrıca model, sabit etiketli örnekler yerine geri bildirimden aktif olarak öğrenir; bu da aşırı uyum riskini azaltır. Modelleri GRPO ile eğitmek, onların daha iyi stratejileri organik olarak keşfetmelerine ve düşünce zincirlerini geliştirmelerine olanak tanır.
GRPO Kullanım Alanları
Daha önce tartıştığımız gibi, GRPO’nun birincil kullanım alanı, etiketli veriniz olmadığı ancak çıktının doğruluğunu doğrulayabildiğiniz durumlardır. Ayrıca, geleneksel gözetimli ince ayar için yeterli olmasa da sınırlı etiketli veriye sahip olduğunuzda da oldukça etkilidir. Bu, etiketlemenin maliyetli veya uygulanamaz olduğu senaryolarda GRPO’yu özellikle değerli kılar.
GRPO’nun önemli avantajlar gösterdiği bazı alanlar şunlardır:
- Matematiksel beceriler: Örneğin, DeepSeek-Math modelinde, GRPO geniş etiketli veri kümelerine ihtiyaç duymadan modelin karmaşık matematik problemlerini çözme yeteneğini etkili biçimde geliştirdi.
- Kod üretimi: GRPO, sistemin çıktıları kendi kendine doğrulamasına ve yinelemeli olarak iyileştirmesine imkân tanıyarak üretilen kodun doğruluğunu ve güvenilirliğini artırmaya yardımcı olur.
- Çok adımlı akıl yürütme: GRPO, sıralı akıl yürütme ve birden çok mantıksal adımın bütünleştirilmesini gerektiren görevlerde modellerin performansını artırdığı gösterilmiştir.
İleri Düzey GRPO
GRPO’yu pratikte uygularken farkında olmanız gereken bazı ileri düzey ipuçları ve püf noktaları vardır.
Gelişmiş ödül işlevleri
Ödül işlevleri, modelin hedefini ne kadar iyi gerçekleştirdiğine dair geri bildirim sağlar. Bu süreçte kritik bileşenler vardır:
- Yanıtlarda çeşitlilik: Geniş bir aday çıktı yelpazesi üretmek, daha yüksek kaliteli çözümler veya stratejiler keşfetme olasılığını artırır.
- Ödüllerde çeşitlilik: Yalnızca ikili geçti/kaldı sinyali yerine, farklı başarı düzeyleri veya kısmi başarım arasında ayrım yapabilen ödül işlevleri tasarlamak. Bu, kısmi kredi ödülleri olarak bilinir; yanıta ilişkin farklı yönlere kısmi kredi vererek daha nüanslı geri bildirim sunar. Örnekler arasında en azından çıktı biçiminin doğru olduğunu doğrulamak, üretilen kodun başarıyla derlenmesi veya kodun birim testlerinin bir alt kümesini geçmesi bulunur. Bu tür derecelendirilmiş ödüller, yanıt tamamen doğru olmasa bile modelin kademeli olarak iyileşmesini teşvik eder.
Buna ek olarak, tüm grup için bir taban çizgisi belirlemek eğitim sürecini istikrara kavuşturma ve iyileştirmede önemli bir rol oynayabilir. Bu taban çizgisini bireysel ödüllerden çıkararak, model gruba göreli geri bildirim alır; bu da ödül tahminlerindeki varyansı azaltır ve ortalama üzerindeki kademeli iyileştirmeleri teşvik eder.
Sıcaklık
LLM’lerde sıcaklık parametresi, çıktı üretimi sırasında örnekleme sürecinin rastgeleliğini kontrol eder. Sıcaklığın 0 olarak ayarlanması deterministik örnekleme sağlar; yani model her zaman en olası bir sonraki belirteci seçer.
Bu tutarlılık sağlasa da genellikle aynı çıktının tekrar tekrar üretilmesine yol açar ve yanıtlarda çeşitliliği sınırlar.
Öte yandan sıcaklığın artırılması daha fazla rastgelelik katar; modelin daha geniş olasılıkları keşfetmesine izin verir. Bu çeşitlilik, farklı veya beklenmedik çözümleri keşfetmek açısından faydalı olabilir.
Ancak daha yüksek sıcaklıklar bir ödün içerir: Model daha az olası belirteçleri daha sık örneklediğinden, her bir tahminin kalitesi düşme eğilimindedir. Bu nedenle, genel öğrenme süreci yavaşlayabilir.
Doğru sıcaklığı seçmek bazen bir sanattır!
Ödül suistimali
Modeller kurnaz olabilir ve bazen ödül işlevlerini amaca gerçekten ulaşmadan, istenmeyen yollarla en yüksek ödülü almak için istismar edebilir.
Örneğin, model belirli bir kod parçası için testler ürettiğinde ödüllendiriliyor olsun. Model, kod doğruluğunu gerçekten doğrulama hedefini atlayıp yine de ödül almak için fiilen hiçbir şeyi test etmeyen bir test işlevi sağlayabilir.
Ödül işlevlerini yazarken bu tür suistimallerin farkında olunmalıdır. Örneğin test üretimi durumunda, genellikle modelin testin içinde en az bir ‘assert’ ifadesi üretmesi istenir; aksi halde cezalandırılır.
Sonuç
Son olarak, tüm kavramların iyi anlaşıldığından emin olmak için GRPO’yu gerçek dünya senaryosuna uygulamak istiyorum.
Siz ve arkadaşlarınızın koşu, şınav ve kürek performansına dayalı ödüllerin verildiği bir fitness yarışmasına katıldığınızı hayal edin. Başlangıçta spor salonu yalnızca mutlak olarak en iyi sonuçları elde eden kişiyi ödüllendirir.
Bu durumda Alice, Ben’den daha uzağa koşuyor ve daha çok şınav çekiyorsa, Ben önemli ilerleme göstermiş olsa bile Alice her zaman kazanır.
Bu Ben için haksız hissettirmiyor mu?
Bunu çözmek için, spor salonu geçmiş performansa dayalı kişisel hedefler yaklaşımını dener.
Artık yalnızca kendi önceki rekorlarınızı kırarsanız ödül kazanırsınız. Bu daha adil görünse de yeni sorunlar doğurur. Charlie gibi yeni üyelerin karşılaştırma yapacak geçmiş verisi yoktur; bu da onların katılımını zorlaştırır. Ayrıca antrenörlerin herkesin ilerlemesini tek tek izlemesi gerekir ki bu da verimsizdir.
Sonunda spor salonu daha iyi bir çözüm sunar: GRPO.
Antrenman başlamadan önce, spor salonu eğitmeni katılımcıların özelliklerini analiz eden ve benzer koşullara göre gruplandıran bir sistemi etkinleştirir. Antrenman sırasında sistem her katılımcının performansını takip eder ve grup içindeki ortalama bir puanı taban çizgisi olarak hesaplar. Sonrasında, ödüller herkesin aynı gün kendi grubunun ortalama performansını ne kadar aştığına göre verilir.
Dolayısıyla Ben, grubundaki diğerlerine kıyasla belirgin şekilde daha iyi performans gösterirse, Alice toplamda en yüksek puana sahip olsa bile ödül kazanır. Bu yöntem Charlie gibi yeni gelenlere de adildir; çünkü değerlendirme önceki geçmişe değil, aynı oturumdaki akranlara göre yapılır.
Bu süreçte önemli bir etken sıcaklıktır; iyileştirmelerin ne kadar katı şekilde ödüllendirileceğini kontrol eder. Sıcaklık çok düşükse yalnızca taban çizgisine göre büyük iyileştirmeler sayılır. Sıcaklık çok yüksekse küçük iyileştirmeler bile ödüllendirilir; bu da denemeyi teşvik eder ama dalgalı bir ilerlemeye yol açabilir.
GRPO, keşfe izin verirken istikrarlı ilerleme sağlayacak doğru dengeyi bulmayı hedefler.
Son olarak ödül suistimali riski vardır. Bu, katılımcıların gerçekten gelişmeden sistemi kandırmanın yollarını bulması anlamına gelir. Örneğin Ben, gerçek bir çaba göstermeden puanını şişirmek için yalnızca en kolay egzersizlere odaklanabilir.
Bunu önlemek için, spor salonu dengeli bir egzersiz karması gerektirmek veya tekrarlayan, düşük çabalı egzersizleri cezalandırmak gibi güvenlik önlemleri ekler. Bu kısıtlar, ödüllerin gerçek ilerlemeyi yansıtmasını sağlar.
LLM’lerin nasıl çalıştığını ve kendi modelinizi nasıl geliştireceğinizi öğrenmek istiyorsanız, Gelişmiş Büyük Dil Modelleri kursumuza göz atın.






Grup Göreli Politika Optimizasyonu (GRPO), en yeni büyük dil modellerinin (LLM) etkileyici performansını besleyen son teknoloji bir pekiştirmeli öğrenme (RL) tekniğidir. DeepSeek-R1 yayınlandıktan sonra geniş çapta dikkat çekse de, GRPO ilk olarak gelişmiş matematiksel akıl yürütme için ince ayarlanmış bir LLM olan DeepSeekMath içinde tanıtıldı. GRPO başlangıçta ince ayarlamada verimliliği artırmak için tasarlandı ve topluluk tarafından benimsenen, maliyet etkin ve çok yönlü bir yöntem olduğunu kanıtladı.
Bu yazıda GRPO’ya derinlemesine bakacağız. Ne olduğunu, nasıl çalıştığını, uygulanması için gerekli temel bileşenleri ve ne zaman kullanmanın en uygun olduğunu inceleyeceğiz. Bu rehberin amacı, GRPO’nun artan popülaritesini haklı çıkaran temel içgörüleri adım adım aktarmaktır.
DeepSeek hakkında daha fazla bilgi edinmek isterseniz, Python ile DeepSeek Kullanımı kursumuza mutlaka göz atın.
Pekiştirmeli Öğrenmeye Giriş
LLM ince ayar rehberimizde incelediğimiz üzere, gözetimli ince ayar (SFT), etiketli veriler kullanarak bir modelin eğitilmesinden oluşan geleneksel bir eğitim tekniğidir. Yani, verilen girdiler için beklenen tamamlama veya çıktıları gösteren örneklerin kullanılmasıdır.
SFT’nin sınırlamalarından biri, üretimi maliyetli ve zaman alıcı olabilen büyük, etiketli veri kümelerine büyük ölçüde dayanmasıdır. Ayrıca SFT ile eğitilen modellerin, eğitim örneklerine aşırı uyum sağlama riski vardır; bu da görülen verilerde iyi performans gösterip yeni veya beklenmedik durumlara genellemekte zorlanmaları anlamına gelir.
SFT’ye bir alternatif de pekiştirmeli öğrenmedir; burada, sabit örneklerden öğrenmek yerine, bir ajan, bir görevi tamamlamak için çeşitli eylemleri deneyerek çevresiyle etkileşime girerek öğrenir. Her eylemden sonra ajan, ödüller veya cezalar şeklinde geri bildirim alır. Amaç, en iyi çalışan stratejileri keşfederek zaman içinde toplam ödülü en üst düzeye çıkarmaktır.
Basit bir RL iş akışını şu şekilde betimleyebiliriz:
Basit bir RL iş akışı diyagramı.
Python ile RL’ye uygulamalı başlamak isterseniz, Pekiştirmeli Öğrenme: Python Örnekleriyle Bir Giriş eğitimi size göre!
Pekiştirmeli öğrenmeyi kolaylaştırmak
Pekiştirmeli öğrenme kavramını somutlaştırmak için, kuzeninize bisiklete binmeyi öğrettiğinizi hayal edin. Başlangıçta pedallama ve denge kurma konusunda zorlanır, sık sık yalpalayıp düşer.
Her biraz daha ileri gittiğinde onu tezahüratla desteklersiniz. Bu olumlu geri bildirim devam etmesini teşvik eder. Ancak merdivenlerden inmeye çalıştığında onu hemen durdurur ve riskleri açıklarsınız. Bu da istenmeyen eylemleri caydıran olumsuz bir sinyal işlevi görür.
Benzer şekilde, pekiştirmeli öğrenme, modellere farklı eylemleri keşfetme imkânı tanır. Olumlu ödüller arzu edilen sonuçları pekiştirirken, olumsuz ödüller istenmeyen davranışları caydırır. Zamanla model bu geri bildirim sayesinde daha iyi kararlar almayı öğrenir.
Pekiştirmeli öğrenmeye yaklaşımlar
Bir modele pekiştirmeli öğrenme uygulamak için farklı teknikler vardır. Spesifik olarak, GRPO, yakınsal politika optimizasyonu (PPO) ve doğrudan politika optimizasyonunun (DPO) bir evrimi olarak kabul edilir.
Daha önce PPO ve DPO’yu duymuş muydunuz?
Yakınsal politika optimizasyonu
PPO, ayrı bir ödül modeli kullanarak bir modelin ödüllerini en üst düzeye çıkaracak şekilde davranışını optimize etmeyi amaçlayan, yaygın kullanılan bir RL algoritmasıdır. PPO’nun uygulamadaki harika bir örneği OpenAI’nin insan geri bildiriminden pekiştirmeli öğrenme (RLHF) yaklaşımıdır. RLHF’de insan geri bildirimi önce model çıktıları üzerinde toplanır ve bu veriler daha sonra geri bildirimi tahmin etmek üzere bir ödül modelini eğitmekte kullanılır. Bir ödül modeline sahip olmak, insanlara ihtiyaç duymadan insan geri bildirimini ölçeklemenin bir yoludur.
Son olarak PPO, eğitim sırasında ödül modelini kullanarak modelin parametrelerini ayarlar ve insan tercihleriyle daha iyi hizalanan yanıtlar üretmesini teşvik eder. Aşağıdaki diyagram PPO iş akışını göstermektedir:
PPO iş akışı diyagramı.
PPO iş akışını Python’da uygulamak isterseniz, PyTorch ve Gymnasium ile Proximal Policy Optimization eğitimini değerlendirin.
Doğrudan politika optimizasyonu
Ayrı bir ödül modeli eğitmek karmaşık ve kaynak yoğun olabilir. Bu süreci basitleştirmek için, insan geri bildiriminin toplanma şeklini değiştiren DPO tanıtıldı.
İnsanlardan yanıtları sayısal puanlarla derecelendirmeleri istenmek yerine, DPO tercih karşılaştırmalarına dayanır. İnsan değerlendiricilere iki yanıt gösterilir ve hangisini tercih ettikleri sorulur. Bu nedenle tercih edilen ve daha az tercih edilen örneklerden oluşan bir veri kümesi oluşur.
Model daha sonra ödül modeline dayanmak yerine bu tercih çiftleri üzerinde doğrudan ince ayar yapılır. Bu yaklaşımla model, tercih edilen yanıtı üretme olasılığını artırmayı, daha az tercih edileni ise azaltmayı öğrenir.
Bu yaklaşım, ayrı bir ödül modeline ihtiyaç duymadan modelin insan tercihleriyle hizalanmasını sağlar. Bu yeni iş akışına göz atalım:
DPO iş akışı diyagramı.
DPO’yu pratikte uygulamanıza yardımcı olacak OpenAI'nin Tercih İnce Ayarı: Örneklerle Rehber eğitimine göz atın.
PPO ve DPO’nun zorlukları
DPO, PPO’ya kıyasla pek çok avantaj sunar. Veriden başlayacak olursak, PPO’nun önce ödül modelini eğitmek için veriyi toplaması, ardından bu yardımcı modelin gerçek eğitimini yapması gerekir (yeni bir modeli eğitmenin tüm teknik zorluklarıyla birlikte); üstelik hedef modelinizi eğitmeye başlamadan önce. DPO, ayrı bir ödül modeline gerek olmamasını sağlayarak süreci basitleştirir. Bununla birlikte, bu yaklaşım yine de kayda değer miktarda tercih verisi gerektirir.
Bu sınırlamaları ortadan kaldırmanın bir yolunu öngörebiliyor musunuz?
Dış geri bildirime güvenmek yerine model yanıtlarını doğrulayıp puanlayacak otomatik bir yol bulabilsek?
İşte GRPO tam olarak bunu sunuyor!
GRPO nedir?
Grup Göreli Politika Optimizasyonu, etiketli veri gerektirmeyen; yalnızca doğruluğu “doğrulayacak” ve yanıtları buna göre sıralayacak bir yönteme ihtiyaç duyan bir RL tekniğidir. Doğrulama genellikle programlanabilir ödül işlevleriyle sağlanır; örneğin, modelin yanıtını girdi olarak alıp işlevin belirli bir yönüne ilişkin bir puan üreten işlevler.
GRPO’nun bazı yaklaşımları yanıtları doğrulamak ve puanlamak için bir yargıç olarak LLM kullanır, ancak GRPO’nun temel fikri, üretilen kodun farklı yönlerinin harici araçlarla doğrulanabildiği yazılım geliştirme gibi alanlarda, harici bir modele gerek olmadan da uygulanabilir. Örneğin,
Gördüğünüz gibi, insanlara veya tercih verisine ihtiyaç yok!
Ödül işlevleri
DeepSeek-Math’in orijinal makalesinde, ödül işlevleri matematiksel çözümlerin doğruluğunu ve biçimlendirmesini değerlendirecek şekilde tasarlandı. Bir LLM’den yapılandırılmış bir çıktı istediyseniz, modelin tamamlamanın çoğunda istenen çıktı biçimine uymuş olabileceğini fark etmişsinizdir; ama her zaman hattınızı bozan bir köşe vaka olmuştur, değil mi?
DeepSeek-Math durumunda ödül işlevleri doğruluk ve biçimlendirmeye odaklandı:
<think>ve</think>) içine alması teşvik edilir. Bu biçimlendirme, modelin düşünce sürecinin çıkarılmasını ve analizini kolaylaştırır, çıktılarında açıklık ve tutarlılığı destekler.GRPO iş akışı
Bu noktada kendinize şu soruyu soruyor olabilirsiniz: GRPO bir modelin eğitim iş akışına nerede oturur?
Süreci adım adım gözden geçirelim!
Bu döngüyü izleyerek, GRPO tercih verisi toplamaya gerek kalmadan modeli doğrudan ödül işlevlerinin çıktısına göre ince ayarlar.
Puan ödüllerinin harici bir aktör tarafından hesaplandığı GRPO iş akışı diyagramı.
Son olarak, GRPO’nun yalnızca PPO veya DPO’da olduğu gibi öğrenmeyi bir tercihe yönlendirmek yerine, modele yeni görevler öğretme avantajını da sağladığını belirtmek ilginçtir.
GRPO’nun faydaları
Yukarıdaki diyagramdan da görülebileceği gibi, GRPO’nun en büyük faydası, etiketli veri gerektirmemesi; doğruluğu “doğrulamanın” bir yolunun yeterli olmasıdır; bu da programlanabilir ödül işlevleri kullanılarak elde edilir.
Bir diğer fayda, geleneksel ince ayara kıyasla çok daha az örnek gerektirmesidir; bu da tekniği maliyet açısından cazip kılar.
Ayrıca model, sabit etiketli örnekler yerine geri bildirimden aktif olarak öğrenir; bu da aşırı uyum riskini azaltır. Modelleri GRPO ile eğitmek, onların daha iyi stratejileri organik olarak keşfetmelerine ve düşünce zincirlerini geliştirmelerine olanak tanır.
GRPO Kullanım Alanları
Daha önce tartıştığımız gibi, GRPO’nun birincil kullanım alanı, etiketli veriniz olmadığı ancak çıktının doğruluğunu doğrulayabildiğiniz durumlardır. Ayrıca, geleneksel gözetimli ince ayar için yeterli olmasa da sınırlı etiketli veriye sahip olduğunuzda da oldukça etkilidir. Bu, etiketlemenin maliyetli veya uygulanamaz olduğu senaryolarda GRPO’yu özellikle değerli kılar.
GRPO’nun önemli avantajlar gösterdiği bazı alanlar şunlardır:
İleri Düzey GRPO
GRPO’yu pratikte uygularken farkında olmanız gereken bazı ileri düzey ipuçları ve püf noktaları vardır.
Gelişmiş ödül işlevleri
Ödül işlevleri, modelin hedefini ne kadar iyi gerçekleştirdiğine dair geri bildirim sağlar. Bu süreçte kritik bileşenler vardır:
Buna ek olarak, tüm grup için bir taban çizgisi belirlemek eğitim sürecini istikrara kavuşturma ve iyileştirmede önemli bir rol oynayabilir. Bu taban çizgisini bireysel ödüllerden çıkararak, model gruba göreli geri bildirim alır; bu da ödül tahminlerindeki varyansı azaltır ve ortalama üzerindeki kademeli iyileştirmeleri teşvik eder.
Sıcaklık
LLM’lerde sıcaklık parametresi, çıktı üretimi sırasında örnekleme sürecinin rastgeleliğini kontrol eder. Sıcaklığın 0 olarak ayarlanması deterministik örnekleme sağlar; yani model her zaman en olası bir sonraki belirteci seçer.
Bu tutarlılık sağlasa da genellikle aynı çıktının tekrar tekrar üretilmesine yol açar ve yanıtlarda çeşitliliği sınırlar.
Öte yandan sıcaklığın artırılması daha fazla rastgelelik katar; modelin daha geniş olasılıkları keşfetmesine izin verir. Bu çeşitlilik, farklı veya beklenmedik çözümleri keşfetmek açısından faydalı olabilir.
Ancak daha yüksek sıcaklıklar bir ödün içerir: Model daha az olası belirteçleri daha sık örneklediğinden, her bir tahminin kalitesi düşme eğilimindedir. Bu nedenle, genel öğrenme süreci yavaşlayabilir.
Doğru sıcaklığı seçmek bazen bir sanattır!
Ödül suistimali
Modeller kurnaz olabilir ve bazen ödül işlevlerini amaca gerçekten ulaşmadan, istenmeyen yollarla en yüksek ödülü almak için istismar edebilir.
Örneğin, model belirli bir kod parçası için testler ürettiğinde ödüllendiriliyor olsun. Model, kod doğruluğunu gerçekten doğrulama hedefini atlayıp yine de ödül almak için fiilen hiçbir şeyi test etmeyen bir test işlevi sağlayabilir.
Ödül işlevlerini yazarken bu tür suistimallerin farkında olunmalıdır. Örneğin test üretimi durumunda, genellikle modelin testin içinde en az bir ‘assert’ ifadesi üretmesi istenir; aksi halde cezalandırılır.
Sonuç
Son olarak, tüm kavramların iyi anlaşıldığından emin olmak için GRPO’yu gerçek dünya senaryosuna uygulamak istiyorum.
Siz ve arkadaşlarınızın koşu, şınav ve kürek performansına dayalı ödüllerin verildiği bir fitness yarışmasına katıldığınızı hayal edin. Başlangıçta spor salonu yalnızca mutlak olarak en iyi sonuçları elde eden kişiyi ödüllendirir.
Bu durumda Alice, Ben’den daha uzağa koşuyor ve daha çok şınav çekiyorsa, Ben önemli ilerleme göstermiş olsa bile Alice her zaman kazanır.
Bu Ben için haksız hissettirmiyor mu?
Bunu çözmek için, spor salonu geçmiş performansa dayalı kişisel hedefler yaklaşımını dener.
Artık yalnızca kendi önceki rekorlarınızı kırarsanız ödül kazanırsınız. Bu daha adil görünse de yeni sorunlar doğurur. Charlie gibi yeni üyelerin karşılaştırma yapacak geçmiş verisi yoktur; bu da onların katılımını zorlaştırır. Ayrıca antrenörlerin herkesin ilerlemesini tek tek izlemesi gerekir ki bu da verimsizdir.
Sonunda spor salonu daha iyi bir çözüm sunar: GRPO.
Antrenman başlamadan önce, spor salonu eğitmeni katılımcıların özelliklerini analiz eden ve benzer koşullara göre gruplandıran bir sistemi etkinleştirir. Antrenman sırasında sistem her katılımcının performansını takip eder ve grup içindeki ortalama bir puanı taban çizgisi olarak hesaplar. Sonrasında, ödüller herkesin aynı gün kendi grubunun ortalama performansını ne kadar aştığına göre verilir.
Dolayısıyla Ben, grubundaki diğerlerine kıyasla belirgin şekilde daha iyi performans gösterirse, Alice toplamda en yüksek puana sahip olsa bile ödül kazanır. Bu yöntem Charlie gibi yeni gelenlere de adildir; çünkü değerlendirme önceki geçmişe değil, aynı oturumdaki akranlara göre yapılır.
Bu süreçte önemli bir etken sıcaklıktır; iyileştirmelerin ne kadar katı şekilde ödüllendirileceğini kontrol eder. Sıcaklık çok düşükse yalnızca taban çizgisine göre büyük iyileştirmeler sayılır. Sıcaklık çok yüksekse küçük iyileştirmeler bile ödüllendirilir; bu da denemeyi teşvik eder ama dalgalı bir ilerlemeye yol açabilir.
GRPO, keşfe izin verirken istikrarlı ilerleme sağlayacak doğru dengeyi bulmayı hedefler.
Son olarak ödül suistimali riski vardır. Bu, katılımcıların gerçekten gelişmeden sistemi kandırmanın yollarını bulması anlamına gelir. Örneğin Ben, gerçek bir çaba göstermeden puanını şişirmek için yalnızca en kolay egzersizlere odaklanabilir.
Bunu önlemek için, spor salonu dengeli bir egzersiz karması gerektirmek veya tekrarlayan, düşük çabalı egzersizleri cezalandırmak gibi güvenlik önlemleri ekler. Bu kısıtlar, ödüllerin gerçek ilerlemeyi yansıtmasını sağlar.
LLM’lerin nasıl çalıştığını ve kendi modelinizi nasıl geliştireceğinizi öğrenmek istiyorsanız, Gelişmiş Büyük Dil Modelleri kursumuza göz atın.