Kurs
Python ile Ağaç Tabanlı Modellerle Machine Learning
5 sa
119.8K
PPO’yu uygulamadan önce, gerekli yazılım kütüphanelerini yüklememiz ve politikayı uygulayacağımız uygun bir ortam seçmemiz gerekir.
Aşağıdaki yazılımları kurmamız gerekir:
numpy (matematiksel ve istatistiksel fonksiyonlar için) ile matplotlib (grafik çizimi için) gibi diğer yazılım kütüphaneleri.gym’in işlevselliği bazen değiştiğinden, bu örnekte sürümünü 0.25.2’ye sabitliyoruz. Bir sunucuya veya yerel makineye kurmak için şunu çalıştırın:
$ pip install torch numpy matplotlib gym==0.25.2Google Colab gibi bir Notebook ya da DataLab kullanarak kurmak için:
!pip install torch numpy matplotlib gym==0.25.2OpenAI Gym kullanarak CartPole ortamının iki örneğini (biri eğitim, diğeri test için) oluşturun:
env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')Şimdi, PPO’yu PyTorch kullanarak uygulayalım.
Daha önce açıklandığı gibi, PPO bir aktör-eleştirmen modeli olarak uygulanır. Aktör politikayı uygular ve eleştirmen onun tahmini değerini öngörür. Hem aktör hem eleştirmen sinir ağları aynı girdiyi—her zaman adımındaki durumu—alır. Bu nedenle aktör ve eleştirmen modelleri, omurga (backbone) mimarisi olarak adlandırılan ortak bir sinir ağını paylaşabilir. Aktör ve eleştirmen, omurga mimarisini ek katmanlarla genişletebilir.
Aşağıdaki adımlar omurga ağını açıklar:
Aşağıdaki kod omurgayı uygular:
class BackboneNetwork(nn.Module):
    def __init__(self, in_features, hidden_dimensions, out_features, dropout):
        super().__init__()
        self.layer1 = nn.Linear(in_features, hidden_dimensions)
        self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
        self.layer3 = nn.Linear(hidden_dimensions, out_features)
        self.dropout = nn.Dropout(dropout)
    def forward(self, x):
        x = self.layer1(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer2(x)
        x = f.relu(x)
        x = self.dropout(x)
        x = self.layer3(x)
return xŞimdi bu ağı kullanarak ActorCritic adlı aktör-eleştirmen sınıfını tanımlayabiliriz. Aktör politikayı modeller ve eylemi tahmin eder. Eleştirmen değer fonksiyonunu modeller ve değeri tahmin eder. İkisi de girdide durumu alır.
class ActorCritic(nn.Module):
    def __init__(self, actor, critic):
        super().__init__()
        self.actor = actor
        self.critic = critic
    def forward(self, state):
        action_pred = self.actor(state)
        value_pred = self.critic(state)
return action_pred, value_predYukarıda tanımlanan ağları kullanarak bir aktör ve bir eleştirmen oluşturacağız. Ardından aktör ve eleştirmeni içeren bir ajan yaratacağız.
Ajanı oluşturmadan önce ağın parametrelerini başlatın:
Aşağıdaki kod, omurga ağına dayalı olarak aktör ve eleştirmen ağlarının nasıl tanımlanacağını gösterir:
def create_agent(hidden_dimensions, dropout):
    INPUT_FEATURES = env_train.observation_space.shape[0]
    HIDDEN_DIMENSIONS = hidden_dimensions
    ACTOR_OUTPUT_FEATURES = env_train.action_space.n
    CRITIC_OUTPUT_FEATURES = 1
    DROPOUT = dropout
    actor = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
    critic = BackboneNetwork(
            INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
    agent = ActorCritic(actor, critic)
return agentAjanın eylemine bağlı olarak ortam, her adımdan bir sonrakine giderken bir ödül verir. Ödül, R, şu şekilde ifade edilir:

Getiri, beklenen gelecekteki ödüllerin birikimli değeri olarak tanımlanır. Gelecekte daha uzakta olan zaman adımlarının ödülleri, anlık ödüllerden daha az değerlidir. Bu nedenle getiri, yaygın olarak indirgenmiş getiri, G, olarak hesaplanır ve şu şekilde tanımlanır:

Bu eğitimde (ve birçok diğer kaynakta) getiri, indirgenmiş getiri anlamına gelir.
Getiriyi hesaplamak için:
calculate_returns() işlevi bu hesaplamaları aşağıda gösterildiği gibi yapar:
def calculate_returns(rewards, discount_factor):
    returns = []
    cumulative_reward = 0
    for r in reversed(rewards):
        cumulative_reward = r + cumulative_reward * discount_factor
        returns.insert(0, cumulative_reward)
    returns = torch.tensor(returns)
    # normalize the return
    returns = (returns - returns.mean()) / returns.std()
return returnsAvantaj, eleştirmenin tahmin ettiği değer ile aktörün politikaya göre seçtiği eylemlerden beklenen getiri arasındaki fark olarak hesaplanır. Belirli bir eylem için avantaj, bu spesifik eylemi, rastgele (ortalama) bir eyleme kıyasla seçmenin faydasını ifade eder.
Orijinal PPO makalesinde (denklem 10), T zaman adımına kadar ileri bakıldığında avantaj şu şekilde ifade edilir:

Algoritmayı kodlarken, belirli sayıda zaman adımına kadar ileri bakma kısıtı, yığın boyutu aracılığıyla uygulanır. Dolayısıyla yukarıdaki denklem, değer ile beklenen getiriler arasındaki fark olarak basitleştirilebilir. Beklenen getiriler, durum-eylem değer fonksiyonu Q ile nicelenir.
Dolayısıyla, aşağıdaki basitleştirilmiş formül, seçmenin avantajını ifade eder:
Şu şekilde ifade edilir:

OpenAI de RL uygulamak için bu formülü kullanır. Aşağıda gösterilen calculate_advantages() işlevi avantajı hesaplar:
def calculate_advantages(returns, values):
    advantages = returns - values
    # Normalize the advantage
    advantages = (advantages - advantages.mean()) / advantages.std()
return advantagesPolitika kaybı, PPO gibi özel teknikler olmadan standart politika gradyanı kaybı olurdu. Standart politika gradyanı kaybı şu çarpım olarak hesaplanır:
Standart politika gradyanı kaybı, ani politika değişiklikleri için düzeltme yapamaz. Vekil kaybı, politikanın her yinelemede ne kadar değişebileceğini kısıtlamak için standart kaybı değiştirir. İki büyüklüğün minimumudur:
Optimizasyon süreci için vekil kayıp, gerçek kaybın bir temsili (proxy’si) olarak kullanılır.
Politika oranı, R, yeni ve eski politikalar arasındaki farktır ve yeni ve eski parametreler altındaki politikanın log olasılıklarının oranı olarak verilir:
Kırpılmış politika oranı, R', şu şekilde kısıtlanır:
Önceki bölümde gösterilen avantaj At ve yukarıda gösterilen politika oranı verildiğinde, vekil kayıp şu şekilde hesaplanır:
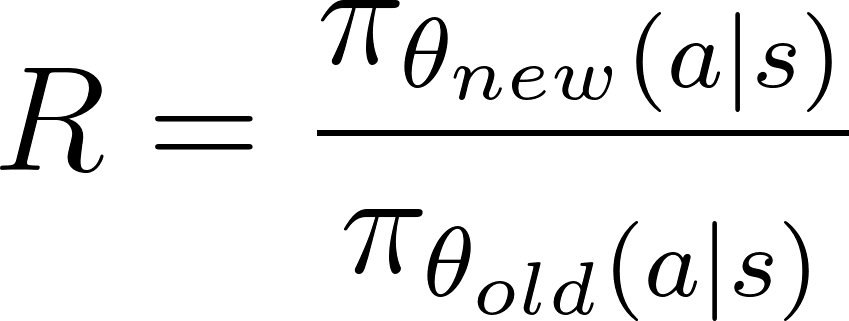
Aşağıdaki kod, kırpma mekanizması ve vekil kaybın nasıl uygulanacağını gösterir.
def calculate_surrogate_loss(
        actions_log_probability_old,
        actions_log_probability_new,
        epsilon,
        advantages):
    advantages = advantages.detach()
    policy_ratio = (
            actions_log_probability_new - actions_log_probability_old
            ).exp()
    surrogate_loss_1 = policy_ratio * advantages
    surrogate_loss_2 = torch.clamp(
            policy_ratio, min=1.0-epsilon, max=1.0+epsilon
            ) * advantages
    surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
return surrogate_lossŞimdi ajanı eğitelim.
Artık politika ve değer kayıplarını hesaplamaya hazırız:
Yukarıda hesaplanan her iki kayıp da tensördür. Gradyan inişi skaler değerlere dayanır. Kaybı temsil eden tek bir skaler değer elde etmek için .sum() işlevini kullanarak tensör elemanlarını toplayın. Aşağıdaki işlev bunun nasıl yapılacağını gösterir:
def calculate_losses(
        surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
    entropy_bonus = entropy_coefficient * entropy
    policy_loss = -(surrogate_loss + entropy_bonus).sum()
    value_loss = f.smooth_l1_loss(returns, value_pred).sum()
    return policy_loss, value_loss
Eğitim sürecine başlamadan önce, tamponları boş diziler olarak oluşturun. Eğitim algoritması, her zaman adımında ajanın eylemleri, ortamın durumları ve ödüllerine ilişkin bilgileri depolamak için bu tamponları kullanacaktır. Aşağıdaki işlev bu tamponları başlatır:
def init_training():
    states = []
    actions = []
    actions_log_probability = []
    values = []
    rewards = []
    done = False
    episode_reward = 0
    return states, actions, actions_log_probability, values, rewards, done, episode_reward
Her eğitim yinelemesi, o yinelemenin politika parametreleriyle ajanı çalıştırır. Ajan, bir sonlandırma koşuluna ulaşana kadar bir döngü içinde zaman adımlarında ortamla etkileşime girer.
Her zaman adımından sonra, ajanın eylemi, ödül ve değeri ilgili tamponlara eklenir. Bölüm sona erdiğinde, bölüme ait sonuçları özetleyen güncellenmiş tampon kümesi döndürülür.
Eğitim döngüsünü çalıştırmadan önce:
agent.train() ile ayarlayın. env.reset() kullanarak rastgele bir duruma sıfırlayın. Bu, bu eğitim yinelemesinin başlangıç durumudur. Aşağıdaki adımlar, eğitim döngüsündeki her zaman adımında neler olduğunu açıklar:
dist.sample() işlevi bunu yapar. env.step() işlevini kullanarak bu eylemi ortama iletin ve bu zaman adımı için ortamın tepkisini simüle edin. Ajanın eylemine bağlı olarak ortam şunları üretir:done (ortamın son durumuna ulaşıp ulaşmadığını gösterir)Eğitim bölümü, env.step() işlevi done’ın boole dönüş değeri için true döndürdüğünde sona erer.
Bölüm sona erdikten sonra, bu bölümden kümülatif getirileri, her zaman adımındaki ödülleri toplayarak hesaplamak için her zaman adımından biriken değerleri kullanın. Bunu yapmak için daha önce açıklanan calculate_returns() işlevini kullanıyoruz. Bu işlevin girdileri, iskonto faktörü ve her zaman adımındaki ödülleri içeren tampondur. Bu getirileri ve her zaman adımından biriken değerleri kullanarak calculate_advantages() işleviyle avantajları hesaplıyoruz.
Aşağıdaki Python işlevi bu adımların nasıl uygulanacağını gösterir:
def forward_pass(env, agent, optimizer, discount_factor):
    states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
    state = env.reset()
    agent.train()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        states.append(state)
        action_pred, value_pred = agent(state)
        action_prob = f.softmax(action_pred, dim=-1)
        dist = distributions.Categorical(action_prob)
        action = dist.sample()
        log_prob_action = dist.log_prob(action)
        state, reward, done, _ = env.step(action.item())
        actions.append(action)
        actions_log_probability.append(log_prob_action)
        values.append(value_pred)
        rewards.append(reward)
        episode_reward += reward
    states = torch.cat(states)
    actions = torch.cat(actions)
    actions_log_probability = torch.cat(actions_log_probability)
    values = torch.cat(values).squeeze(-1)
    returns = calculate_returns(rewards, discount_factor)
    advantages = calculate_advantages(returns, values)
return episode_reward, states, actions, actions_log_probability, advantages, returnsHer eğitim yinelemesi, bir sonlandırma koşuluna ulaşana kadar birçok zaman adımından oluşan tam bir bölüm boyunca modeli çalıştırır. Her zaman adımında, politika parametrelerini, ajanın eylemini, getirileri ve avantajları depolarız. Her yinelemeden sonra, model, o yinelemedeki tüm zaman adımlarındaki politikanın performansına göre güncellenir.
CartPole ortamındaki en fazla zaman adımı sayısı 500’dür. Daha karmaşık ortamlarda zaman adımı daha fazladır, hatta milyonlarca olabilir. Bu gibi durumlarda, eğitim sonuçları veri kümesi yığınlara bölünmelidir. Her yığındaki zaman adımı sayısına optimizasyon yığın boyutu denir.
Dolayısıyla model parametrelerini güncelleme adımları şunlardır:
.backward()’ı politika ve değer kayıpları üzerinde ayrı ayrı çalıştırın. Bu, kayıp fonksiyonlarındaki gradyanları günceller. .step() çalıştırın. Bu durumda hız ve sağlamlık dengesini kurmak için Adam optimize edicisini kullanıyoruz. PPO_STEPS parametresinin değerine bağlı olarak her yığının üzerinde birkaç kez tekrarlayın. Her yığın üzerinde geriye doğru geçişi tekrarlamak, ek ileri geçişler çalıştırmadan eğitim veri kümesinin boyutunu etkin biçimde artırdığı için hesaplama açısından verimlidir. Örnekleme ve optimizasyon arasındaki her değişimdeki ortam adımı sayısına yineleme yığın boyutu denir. Aşağıdaki kod bu adımları uygular:
def update_policy(
        agent,
        states,
        actions,
        actions_log_probability_old,
        advantages,
        returns,
        optimizer,
        ppo_steps,
        epsilon,
        entropy_coefficient):
    BATCH_SIZE = 128
    total_policy_loss = 0
    total_value_loss = 0
    actions_log_probability_old = actions_log_probability_old.detach()
    actions = actions.detach()
    training_results_dataset = TensorDataset(
            states,
            actions,
            actions_log_probability_old,
            advantages,
            returns)
    batch_dataset = DataLoader(
            training_results_dataset,
            batch_size=BATCH_SIZE,
            shuffle=False)
    for _ in range(ppo_steps):
        for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
            # get new log prob of actions for all input states
            action_pred, value_pred = agent(states)
            value_pred = value_pred.squeeze(-1)
            action_prob = f.softmax(action_pred, dim=-1)
            probability_distribution_new = distributions.Categorical(
                    action_prob)
            entropy = probability_distribution_new.entropy()
            # estimate new log probabilities using old actions
            actions_log_probability_new = probability_distribution_new.log_prob(actions)
            surrogate_loss = calculate_surrogate_loss(
                    actions_log_probability_old,
                    actions_log_probability_new,
                    epsilon,
                    advantages)
            policy_loss, value_loss = calculate_losses(
                    surrogate_loss,
                    entropy,
                    entropy_coefficient,
                    returns,
                    value_pred)
            optimizer.zero_grad()
            policy_loss.backward()
            value_loss.backward()
            optimizer.step()
            total_policy_loss += policy_loss.item()
            total_value_loss += value_loss.item()
return total_policy_loss / ppo_steps, total_value_loss / ppo_stepsArtık PPO ajanını çalıştıralım.
Ajanın performansını değerlendirmek için yeni bir ortam oluşturun ve ajanın bu yeni ortamda çalıştırılmasından elde edilen kümülatif ödülleri hesaplayın. Ajanı .eval() işlevini kullanarak değerlendirme moduna almanız gerekir. Adımlar, eğitim döngüsüyle aynıdır. Aşağıdaki kod parçacığı değerlendirme işlevini uygular:
def evaluate(env, agent):
    agent.eval()
    rewards = []
    done = False
    episode_reward = 0
    state = env.reset()
    while not done:
        state = torch.FloatTensor(state).unsqueeze(0)
        with torch.no_grad():
            action_pred, _ = agent(state)
            action_prob = f.softmax(action_pred, dim=-1)
        action = torch.argmax(action_prob, dim=-1)
        state, reward, done, _ = env.step(action.item())
        episode_reward += reward
return episode_rewardMatplotlib kütüphanesini eğitim sürecinin ilerlemesini görselleştirmek için kullanacağız. Aşağıdaki işlev, hem eğitim hem test döngülerinden elde edilen ödüllerin nasıl çizileceğini gösterir:
def plot_train_rewards(train_rewards, reward_threshold):
    plt.figure(figsize=(12, 8))
    plt.plot(train_rewards, label='Training Reward')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Training Reward', fontsize=20)
    plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
def plot_test_rewards(test_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(test_rewards, label='Testing Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Testing Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()Aşağıdaki örnek grafiklerde, sırasıyla eğitim ve test ortamlarında politikayı uygulayarak elde edilen eğitim ve test ödüllerini gösteriyoruz. Kod her çalıştırıldığında bu grafiklerin şeklinin farklı görüneceğini unutmayın. Bunun nedeni eğitim sürecinin doğasında bulunan rastgeleliktir.
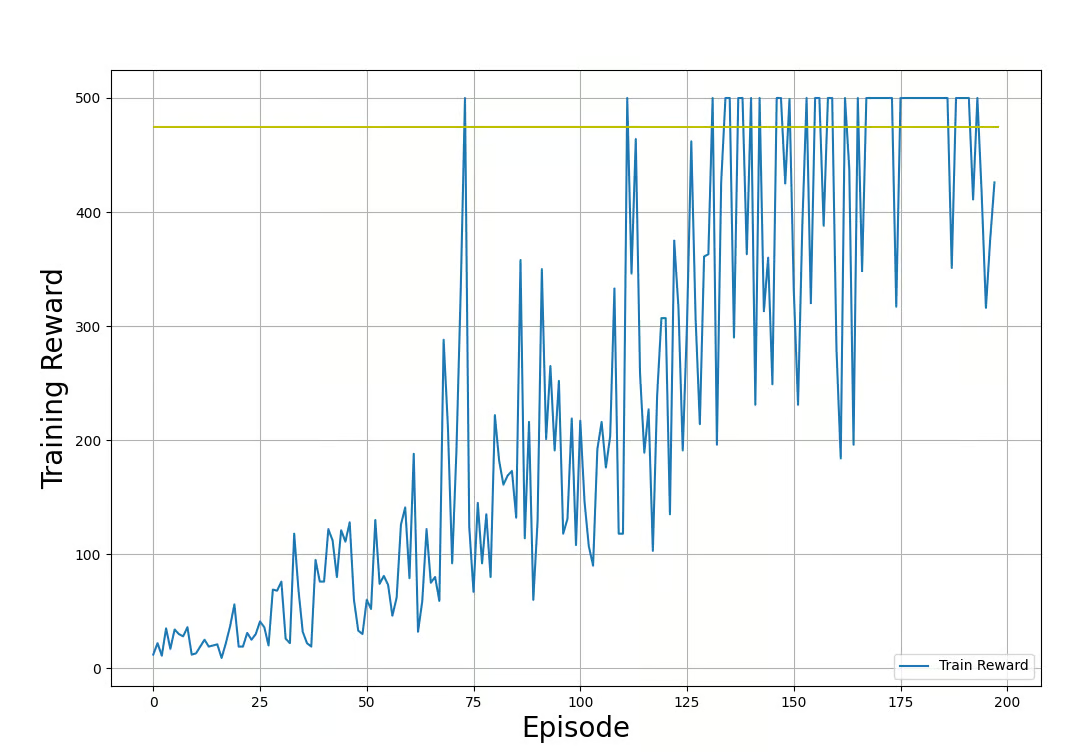
Eğitim ödülleri (eğitim ortamında politika uygulanarak elde edilmiştir). Görsel: Yazar.
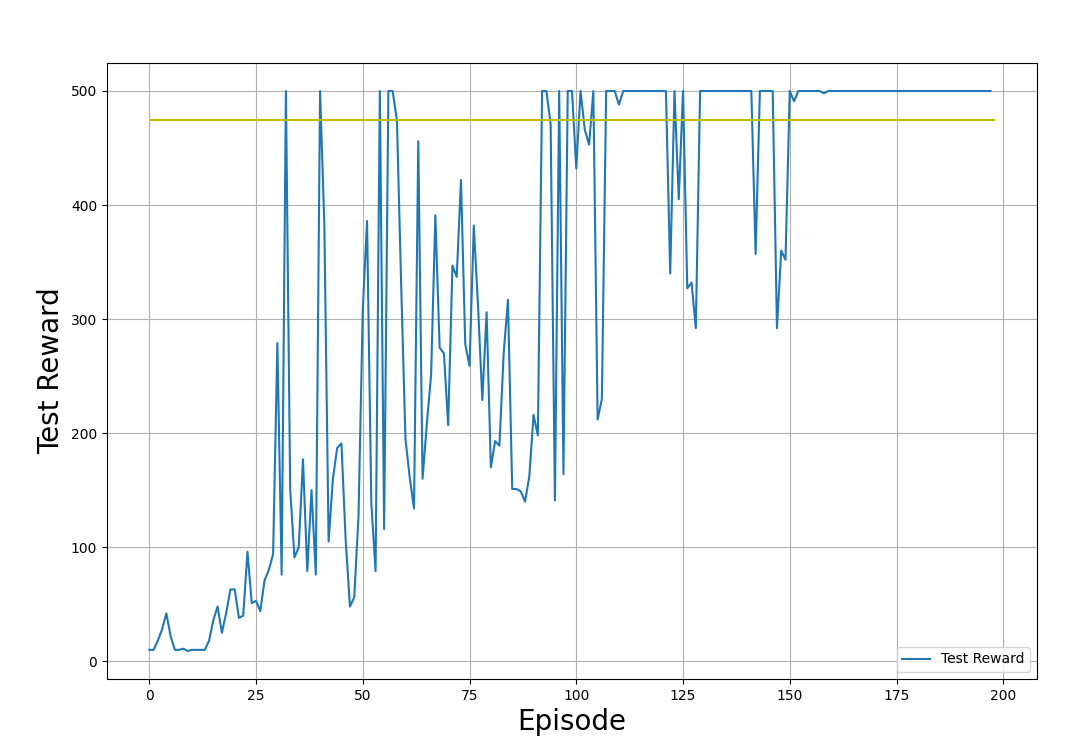
Test ödülleri (test ortamında politika uygulanarak elde edilmiştir). Görsel: Yazar.
Yukarıdaki çıktı grafiklerinde eğitim sürecinin ilerlemesini gözlemleyin:
Benzer şekilde, yinelemeler boyunca değer ve politika kayıplarını da çizebilirsiniz:
def plot_losses(policy_losses, value_losses):
    plt.figure(figsize=(12, 8))
    plt.plot(value_losses, label='Value Losses')
    plt.plot(policy_losses, label='Policy Losses')
    plt.xlabel('Episode', fontsize=20)
    plt.ylabel('Loss', fontsize=20)
    plt.legend(loc='lower right')
    plt.grid()
    plt.show()
Aşağıdaki örnek grafik, eğitim bölümleri boyunca izlenen kayıpları gösterir:
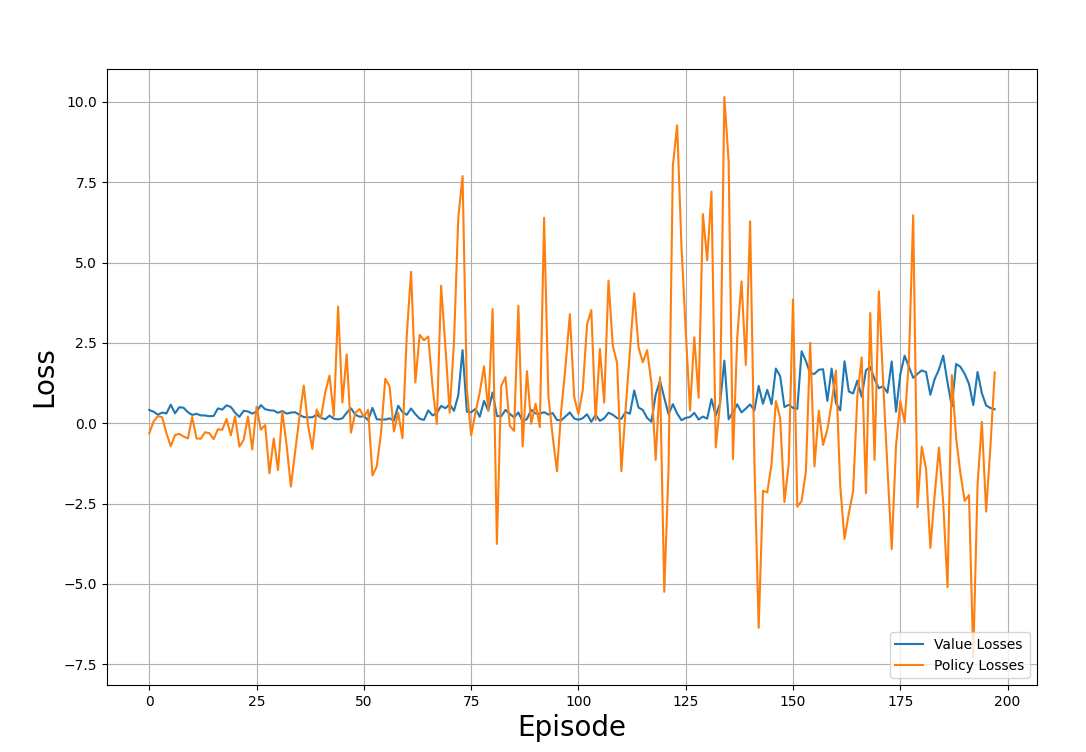
Eğitim süreci boyunca değer ve politika kayıpları. Görsel: Yazar
Grafiği gözlemleyin ve şunları fark edin:
Artık ajanı PPO kullanarak eğitmek için tüm bileşenlere sahipsiniz. Tümünü bir araya getirmek için şunları yapmanız gerekir:
create_agent() işlevini kullanarak bir ajan örneği oluşturun.forward_pass() ve update_policy() işlevlerini kullanarak ileri ve geri geçişleri yinelemeli olarak çalıştırın. evaluate() işlevini kullanarak politikanın performansını test edin. Aşağıdaki kod, bunu Python’da yapan bir işlevin nasıl ilan edileceğini gösterir:
def run_ppo():
    MAX_EPISODES = 500
    DISCOUNT_FACTOR = 0.99
    REWARD_THRESHOLD = 475
    PRINT_INTERVAL = 10
    PPO_STEPS = 8
    N_TRIALS = 100
    EPSILON = 0.2
    ENTROPY_COEFFICIENT = 0.01
    HIDDEN_DIMENSIONS = 64
    DROPOUT = 0.2
    LEARNING_RATE = 0.001
    train_rewards = []
    test_rewards = []
    policy_losses = []
    value_losses = []
    agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
    optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
    for episode in range(1, MAX_EPISODES+1):
        train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
                env_train,
                agent,
                optimizer,
                DISCOUNT_FACTOR)
        policy_loss, value_loss = update_policy(
                agent,
                states,
                actions,
                actions_log_probability,
                advantages,
                returns,
                optimizer,
                PPO_STEPS,
                EPSILON,
                ENTROPY_COEFFICIENT)
        test_reward = evaluate(env_test, agent)
        policy_losses.append(policy_loss)
        value_losses.append(value_loss)
        train_rewards.append(train_reward)
        test_rewards.append(test_reward)
        mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
        mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
        mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
        mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
        if episode % PRINT_INTERVAL == 0:
            print(f'Episode: {episode:3} | \
                  Mean Train Rewards: {mean_train_rewards:3.1f} \
                  | Mean Test Rewards: {mean_test_rewards:3.1f} \
                  | Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
                  | Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
        if mean_test_rewards >= REWARD_THRESHOLD:
            print(f'Reached reward threshold in {episode} episodes')
            break
    plot_train_rewards(train_rewards, REWARD_THRESHOLD)
    plot_test_rewards(test_rewards, REWARD_THRESHOLD)
    plot_losses(policy_losses, value_losses)
Programı çalıştırın:
run_ppo()Çıktı aşağıdaki örneğe benzer olmalıdır:
Episode:  10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39
Episode:  20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22
Reached reward threshold in 116 episodes
Çalışan programı şu DataLab not defterinde görüntüleyip çalıştırabilirsiniz!
Makine öğreniminde hiperparametreler eğitim sürecini kontrol eder. Aşağıda, PPO’da kullanılan önemli hiperparametrelerden bazılarını açıklıyorum:
PPO_STEPS olarak anılır. Karmaşık ortamlarda ileri geçişi birçok kez çalıştırmak hesaplama açısından maliyetlidir. Daha verimli bir alternatif, her yığını birkaç kez yeniden çalıştırmaktır. Genellikle 5 ile 10 arasında bir değer önerilir. N_TRIALS değişkeni ile ifade edilmiştir. Bu daha yüksek bir değere ayarlandığında eğitim daha uzun sürer, çünkü politikanın eşik ödülünü daha fazla bölümde elde etmesi gerekir. Ayrıca daha sağlam bir politika ile sonuçlanır, fakat hesaplama açısından daha maliyetlidir. PPO’nun stokastik bir politika olduğunu ve ajanın eşiği aşamadığı bölümler olacağını unutmayın. Bu nedenle N_TRIALS değeri çok yüksekse eğitiminiz sonlanmayabilir.PPO algoritmalarının eğitim performansını optimize etmek deneme-yanılmayı ve farklı hiperparametre değerleriyle denemeler yapmayı içerir. Ancak bazı genel yönergeler vardır:
PPO’nun kavramlarını ve uygulama ayrıntılarını açıkladıktan sonra, zorluklar ve en iyi uygulamaları tartışalım.
PPO yaygın olarak kullanılıyor olsa da, bu tekniği gerçek dünya problemlerini başarıyla çözmek için uygularken potansiyel zorlukların farkında olmanız gerekir. Bu zorluklardan bazıları şunlardır:
PPO ile iyi sonuçlar elde etmek için bazı en iyi uygulamaları öneriyorum:
PPO_STEPS olarak adlandırır. Bu makalede RL problemlerini çözmenin bir yolu olarak PPO’yu tartıştık. Ardından PyTorch kullanarak PPO’nun nasıl uygulanacağına ilişkin adımları ayrıntılandırdık. Son olarak, PPO için bazı performans ipuçları ve en iyi uygulamaları sunduk.
Öğrenmenin en iyi yolu, kodu kendiniz uygulamaktır. Kodu Gym’deki diğer klasik kontrol ortamlarıyla çalışacak şekilde de değiştirebilirsiniz. Python ve OpenAI’nin Gymnasium’u kullanarak RL ajanlarının nasıl uygulanacağını öğrenmek için Reinforcement Learning with Gymnasium in Python kursunu takip edin!
Bu kurslarla makine öğrenimi hakkında daha fazla bilgi edinin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




