
Kurs
Python ile Gymnasium'da Reinforcement Learning
4 sa
13.8K
Temel ve derin pekiştirmeli öğrenme (RL) modelleri, çoğu zaman bugünkü büyük dil modellerinden ziyade bilim kurgu yapay zekâsını andırabilir. RL’in bir ajanı Süper Mario’daki çok zor bir bölümü nasıl tamamlatabildiğine bakalım:
Başlangıçta, ajanın bu oyunu nasıl oynayacağına dair hiçbir fikri yoktur. Kontrolleri, nasıl ilerleyeceğini, engelleri veya oyunun nasıl biteceğini bilmez. Ajan tüm bunları herhangi bir insan müdahalesi olmadan—pekistirmeli öğrenme algoritmalarının gücüyle—öğrenmek zorundadır.
RL ajanları, önceden tanımlanmış çözümler veya açıkça programlanmış eylemler olmadan ve en önemlisi, büyük miktarda veriye ihtiyaç duymadan problemleri çözebilirler. Bu nedenle RL pek çok alanda önemli bir etki yaratıyor. Örneğin şu alanlarda kullanılıyor:
Pekiştirmeli öğrenme hızla gelişen ve büyük potansiyele sahip bir alan. Araştırmalar ilerledikçe, kaynak yönetimi, sağlık ve kişiselleştirilmiş öğrenme gibi alanlarda daha da çığır açan uygulamalar bekleyebiliriz.
İşte bu yüzden, makine öğrenmesinin bu büyüleyici alanını öğrenmek için harika bir zamandayız. Bu eğitimde, pekiştirmeli öğrenmenin temellerini anlamanıza yardımcı olacak ve ajan, ortam, eylem, durum, ödül ve daha fazlası gibi kavramları adım adım açıklayacağız.
Diyelim ki kediniz Bob’a, pahalı mobilyalarınız yerine bir odadaki birden fazla tırmalama direğini kullanmasını öğretmek istiyorsunuz. Pekiştirmeli öğrenme terimleriyle Bob bir ajan, yani öğrenen ve karar verendir. Hangi şeyleri tırmalamanın uygun (halılar ve direkler) hangilerinin uygun olmadığını (koltuklar ve perdeler) öğrenmesi gerekir.
Oda, ajanın etkileşime girdiği ortam olarak adlandırılır. Zorluklar (cezbedici mobilyalar) ve istenen hedefi (tatmin edici bir tırmalama direği) sunar.
RL’de iki ana ortam türü vardır:
Odamız aynı zamanda durağan bir ortamdır. Mobilyalar hareket etmez ve tırmalama direkleri yerinde durur.
Ancak birkaç saatte bir mobilyaları ve tırmalama direklerini rastgele yer değiştirirseniz (Süper Mario’nun farklı seviyeleri gibi), oda dinamik bir ortama dönüşür; bu da ajan için daha zorludur çünkü her şey sürekli değişir.
Tüm pekiştirmeli öğrenme problemlerinin iki önemli yönü durum uzayı ve eylem uzayıdır.
Durum uzayı, herhangi bir anda ajan ve ortamın bulunabileceği tüm olası durumları (senaryoları) temsil eder. Durum uzayının boyutu ortam türüne bağlıdır:
Eylem uzayı ise Bob’un ortamda yapabileceği her şeydir. Tırmalama direği örneğimizde Bob’un eylemleri direği tırmalamak, kanepede şekerleme yapmak ya da kuyruğunu kovalamak olabilir.
Durum uzayına benzer şekilde, Bob’un gerçekleştirebileceği eylem sayısı ortama bağlıdır:
Bob tırmalama direği macerasına başladığında ortam varsayılan bir durumdadır, buna durum sıfır diyelim. Bizim örneğimizde bu, tırmalama direğinin kurulu olduğu odadır. Yaptığı her eylem ortamı yeni ardıl durumlara taşır.
Bob’un genel hedefine ulaşması için teşviklere ya da ödüllere ihtiyacı vardır.
Çoğu RL probleminin önceden tanımlanmış ödülleri vardır. Örneğin satrançta bir taş almak pozitif ödülken, şah çekilmesi negatif bir ödüldür.
Bizim durumda, olumlu bir eylem gözlemlersek, örneğin bir süre mobilyaları tırmalamaması ya da gerçekten tırmalama direklerinden birini bulması halinde Bob’a ödül mamaları verebiliriz. Perdeleri parçalamaya kalkarsa yüzüne biraz su sıkarak onu cezalandırabiliriz.
Bob’un öğrenme yolculuğundaki ilerlemeyi ölçmek için eylemlerini zaman adımları üzerinden düşünebiliriz. Örneğin t1 zaman adımında Bob a1 eylemini yapar ve bunun sonucu yeni bir durum s1 olur (s0 varsayılan durumdu). Ayrıca r1 ödülü de alabilir.
Zaman adımlarının bir koleksiyonuna bölüm denir. Bir bölüm her zaman varsayılan durumda başlar (mobilyalar ve direkler kuruludur) ve hedefe ulaşıldığında (bir direk bulunur) veya ajan başarısız olduğunda (mobilyaları tırmalar) sona erer. Bazen bir bölüm, geçen süreye bağlı olarak da sona erebilir (satrançta olduğu gibi).
Usta bir satranç oyuncusu gibi, Bob sadece herhangi bir tırmalama direğini aramamalıdır. En çok ödül maması getiren direği istemelidir. Bu, pekiştirmeli öğrenmedeki klasik bir ikilemi vurgular: keşif vs. sömürü.
Cezbedici bir direk anlık tatmin sunabilirken daha stratejik bir keşif daha sonra büyük bir ödül kazandırabilir. Nasıl ki bir satranç oyuncusu üstün bir konum elde etmek için taş almayı erteleyebilir, Bob da nihai tırmalama cennetini (sömürü) keşfetmek için başlangıçta daha az iyi bir direği tırmalayabilir (keşif). Bu uzun vadeli strateji, ajanların karmaşık ortamlarda ödülleri maksimize etmesi için kritiktir.
Başka bir deyişle, Bob’un, işe yarayana bağlı kalma (sömürü) ile zaman zaman yeni tırmalama direkleri aramak için dışarı açılma (keşif) arasında bir denge kurması gerekir. Aşırı keşif özellikle sürekli ortamlarda zaman kaybı olabilirken, aşırı sömürü Bob’un daha iyi bir seçeneği kaçırmasına neden olabilir.
Neyse ki Bob’un uygulayabileceği bazı akıllı stratejiler var:
Bu stratejileri (veya bu eğitimin kapsamı dışında kalan diğerlerini) kullanarak Bob, bilinmeyeni keşfetmek ile iyi olana bağlı kalmak arasında denge kurabilir.
Bob ödül mamalarının sayısını kendi başına en üst düzeye nasıl çıkaracağını bulamaz. Ortamın her durumunda kararlarını yönlendirecek yöntem ve araçlara ihtiyacı vardır. İşte pekiştirmeli öğrenme algoritmaları Bob’un yardımına burada yetişir.
Daha geniş açıdan bakıldığında, pekiştirmeli öğrenme algoritmaları, ajanların ortamla nasıl etkileşime geçtiğine ve deneyimden nasıl öğrendiğine göre sınıflandırılabilir. İki ana kategori model tabanlı ve modelsiz yaklaşımlardır.
Model tabanlı algoritmalarda ajan (Bob gibi) ortamın içsel bir modelini oluşturur. Bu model, durum geçişleri ve ödül olasılıkları dahil olmak üzere ortamın dinamiklerini temsil eder. Ajan daha sonra gerçek ortamda eyleme geçmeden önce farklı eylemleri planlamak ve değerlendirmek için bu modeli kullanabilir.
Bu yaklaşım, özellikle karmaşık ortamlarda örnek verimliliği açısından avantajlıdır. Bu, Bob’un salt deneme-yanılma yaklaşımlarına kıyasla en iyi direği belirlemek için daha az tırmalama girişimine ihtiyaç duyabileceği anlamına gelir. Çünkü Bob, eyleme geçmeden önce planlayıp değerlendirebilir.
Dezavantajı ise doğru bir model inşa etmenin, özellikle karmaşık ortamlar için zor olabilmesidir. Model, gerçek ortamı doğru yansıtmayabilir ve bu da altoptimal davranışa yol açabilir.
Yaygın bir model tabanlı RL algoritması, aslında model tabanlı ve modelsiz öğrenmeyi birleştiren Dyna-Q’dur. Ortamın bir modelini oluşturur ve bunu eylem planlaması için kullanırken eşzamanlı olarak modelsiz Q-öğrenme (bunu birazdan açıklayacağız) yoluyla doğrudan deneyimden öğrenir.
Bu yaklaşım, içsel bir model oluşturmadan doğrudan ortamla etkileşimden öğrenmeye odaklanır. Ajan (Bob), durumların ve eylemlerin değerini veya en iyi stratejiyi deneme-yanılma yoluyla öğrenir.
Modelsiz RL, doğru bir model kurmanın zor olduğu ortamlarda daha basit bir yaklaşım sunar. Bob için bu, odanın karmaşık bir zihinsel haritasını çıkarmasına gerek olmadığı; tırmalayarak ve sonuçlarını deneyimleyerek öğrenebileceği anlamına gelir.
Modelsiz RL, kuralların değişebileceği dinamik ortamlarda başarılıdır. Odanın mobilya düzeni değişirse Bob keşfini uyarlayabilir ve yeni en iyi tırmalama noktalarını öğrenebilir.
Ancak yalnızca deneme-yanılma yoluyla öğrenmek örnek verimliliği açısından düşük olabilir. Bob, en ödüllendirici direği tutarlı biçimde bulmadan önce pek çok mobilyayı tırmalamak zorunda kalabilir.
Yaygın modelsiz RL algoritmalarından bazıları şunlardır:
Hangi algoritmayı seçeceğimiz; ortamın karmaşıklığı, kaynakların kullanılabilirliği veya istenen yorumlanabilirlik düzeyi gibi çeşitli faktörlere bağlıdır.
Doğru bir modelin kurulmasının mümkün olduğu daha basit ortamlar için model tabanlı yaklaşımlar tercih edilebilir. Öte yandan modelsiz yaklaşımlar, genellikle karmaşık gerçek dünya senaryoları için daha pratiktir.
Ayrıca, derin öğrenmenin yükselişiyle birlikte, Derin Q-Ağları (DQN) ve diğer derin RL algoritmaları, yüksek boyutlu durum uzaylarına sahip karmaşık görevlerin üstesinden gelmek için giderek daha popüler hâle geliyor.
Şimdi tek bir algoritmaya odaklanalım ve Q-öğrenmeyi daha yakından inceleyelim.
Q-öğrenme, ajanlara ortamla akıllı etkileşimler yoluyla en iyi kazanma stratejisini öğreten modelsiz bir algoritmadır.
Kedi örneğimize dönelim ve ayrık bir ortam ile sonlu bir eylem kümesinin olduğu bir atari sürümünü çözdüğümüzü hayal edelim.
Bob’a bir tablo verdiğimizi düşünün. Sütunlar kullanılabilir eylemleri temsil ederken, her satır eylemi durum uzayındaki belirli bir duruma eşler.
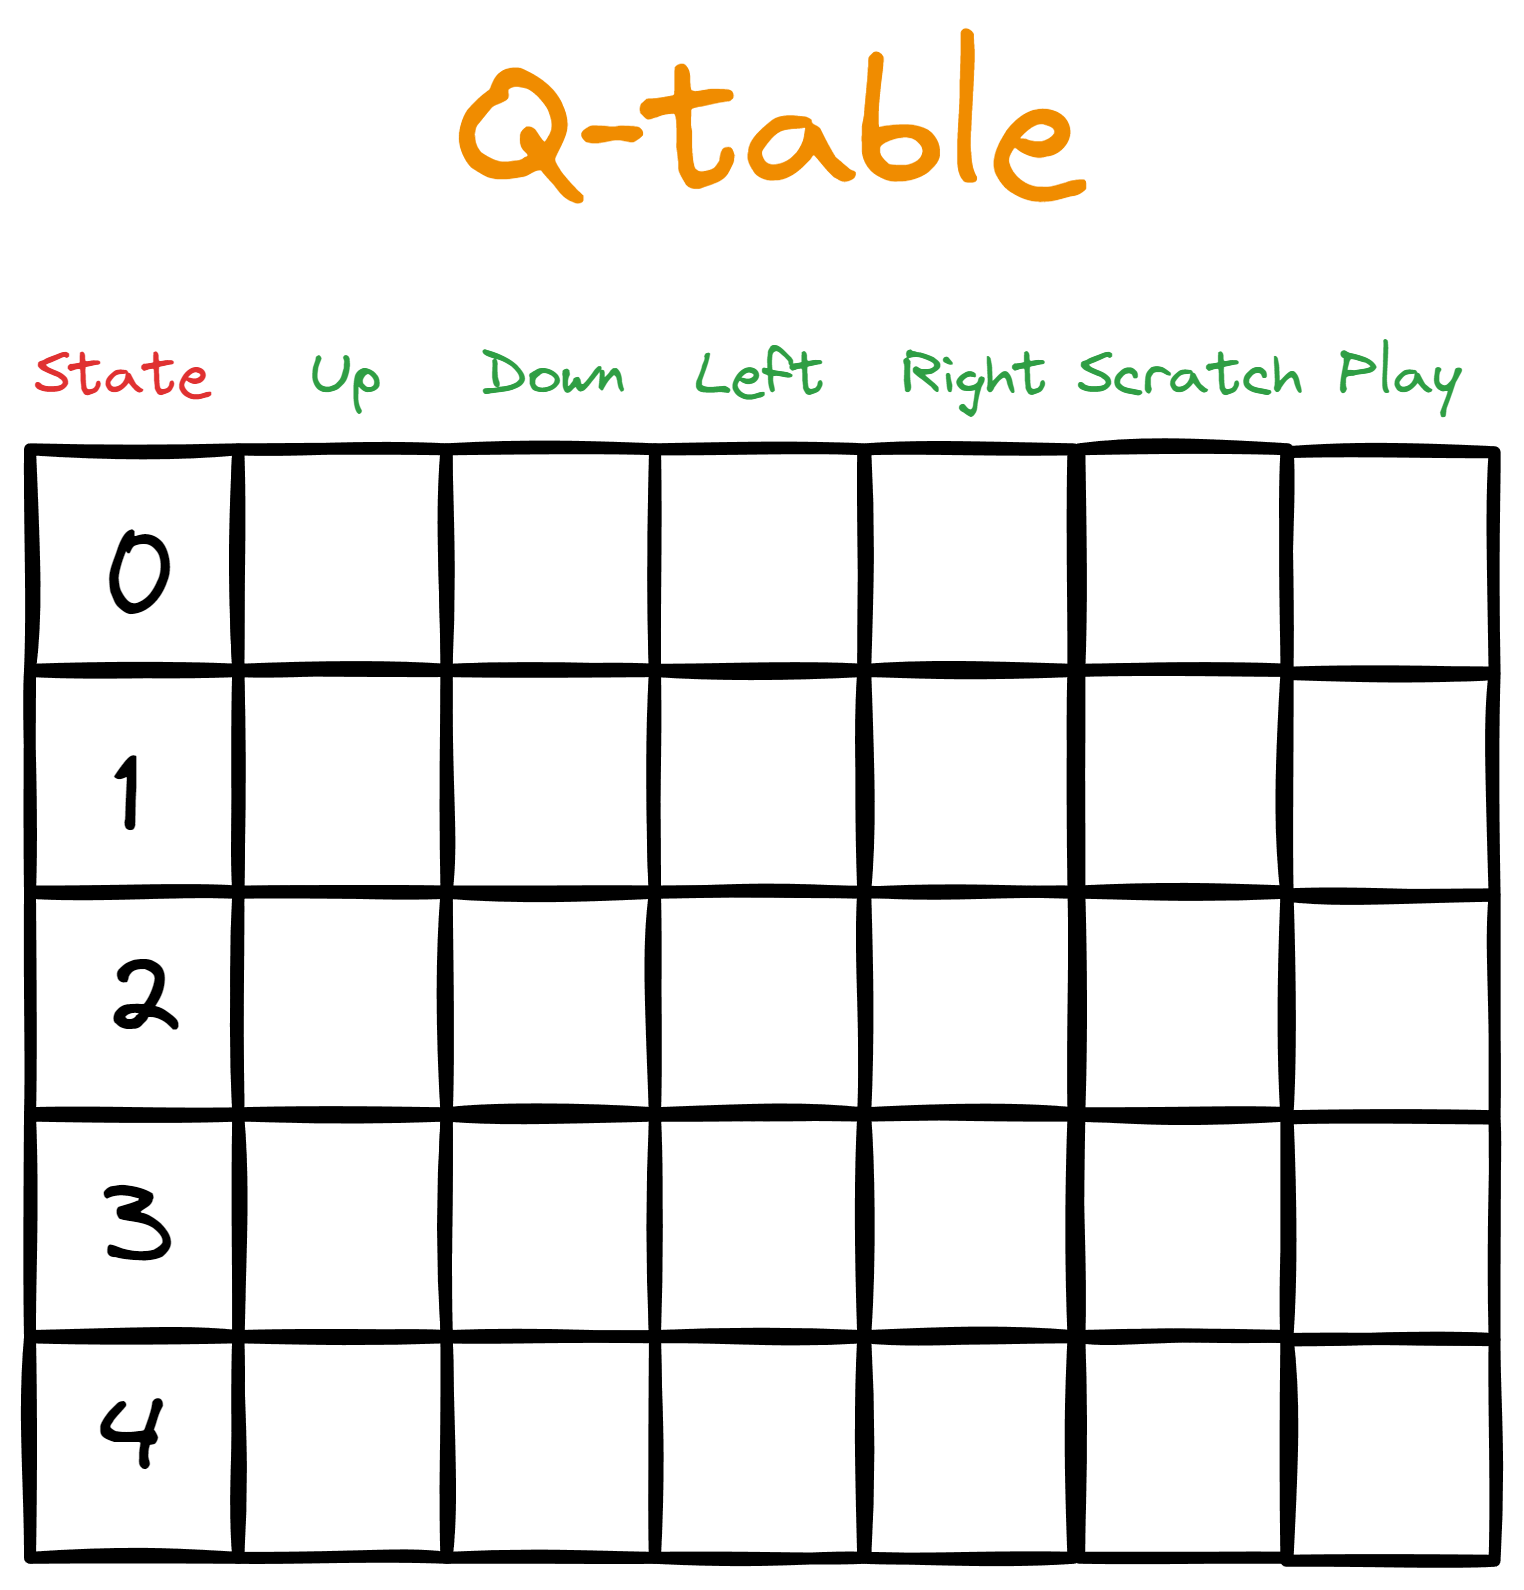
İlk başta tabloyu sıfırlarla doldururuz; bunlar başlangıç Q-değerlerini temsil eder—bu yüzden buna bir Q-tablosu deriz.
Ardından, varsayılan durumdan (bir bölümün başlangıcı) bir etkileşim döngüsü başlatırız. Döngüde Bob, verilen durum için en yüksek Q-değerine sahip eylemi alır. Ancak döngüden ilk geçişte, tüm Q-değerleri başlangıçta sıfır olduğu için Bob’un eylemine rehberlik edecek bir en yüksek Q-değeri olmayacaktır.
İşte keşif stratejilerinin (rastgele keşif veya epsilon-açgözlü gibi) devreye girdiği yer burasıdır. Bu stratejiler, Q-tablosu boşken Bob’un bilgi toplamasına yardımcı olur.
Q-tablosu güncellendikten sonra Bob tekrar bir etkileşim döngüsü başlatır. Yaptığı eylem bir ödül ve bir yeni durumla sonuçlanır. Daha sonra Bob’un yeni durumda yapabileceği her eylem için yeni Q-değerlerini hesaplarız (Q-değerlerinin nasıl hesaplanacağını birazdan göstereceğiz).
Bölüm, sona erene kadar (Bob her bölümde herhangi bir sayıda adım atabilir) devam eder ve sonra yeniden başlarız. Her bir sonraki bölüm, daha zengin bir Q-tablosuna sahip olacak ve Bob’u daha akıllı hâle getirecektir.
İşte adımların yüksek düzeyde özeti:
Bir ve iki gibi adımlar basit olabilir, ancak geri kalanlar daha fazla açıklama gerektirir.
Birinci zaman adımında Bob ilk eylemini yaptığında, tüm Q-değerleri sıfır olduğundan seçim rastgele olacaktır. İzleyen zaman adımlarında Bob’un keşif ve sömürü dengesini gözetmesi gerekir.
Buna yardımcı olmak için Bob’a tipik olarak 0,1 olan küçük değerli bir epsilon hiperparametresi veririz. Sonra Bob’a 0 ile 1 arasında rastgele bir sayı üretmesini ve sayı epsilon’dan küçükse Q-değerinden bağımsız olarak rastgele bir eylem seçmesini söyleriz.
Sayı epsilon’dan büyükse Bob, en yüksek Q-değerine sahip eylemi seçecektir. Böylece Bob, zamanın epsilon’u (0,1 veya %10) kadar keşif, (1 - epsilon veya 0,9 ya da %90) kadar sömürü yapacaktır.
Az önce açıkladığımız şeye epsilon-açgözlü politika denir. Politikalar, ajanın nasıl eylem aldığını ve Q-değerlerinin nasıl hesaplandığını tanımlar.
Ödülü hesaplama kuralları genellikle ortamı oluşturan kişi tarafından belirlenir. Örneğin Bob’a, tırmalama halısını kullandığı için bir ödül maması, duvardakini tırmalamak için yeterince yükseğe zıpladığı için beş ödül maması vermeye karar verebilirsiniz. Değerli nesneleri tırmalaması hâlinde Bob’u cezalandırma ihtimaliniz de vardır.
Ancak çoğu zaman hiçbir ödül olmayacaktır; çünkü Bob ya uyur, ya yürür, ya da oynar.
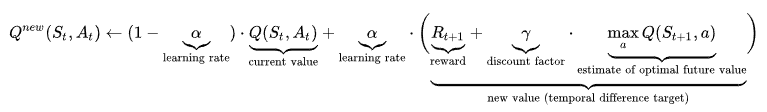
Q-değerini hesaplama formülü ilk bakışta göz korkutucu olabilir; önce tam hâliyle görelim, sonra adım adım açıklayalım:
Formülün başına bakalım:
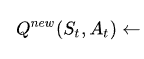
Bu kısım, “Önceki durum ve eylem verilmişken yeni Q-değeri şu şekilde hesaplanır (...).” der.
Aşağıdaki kısım, ajanın eylemi yapmak için kullandığı mevcut (yakında eski olacak) Q-değeridir.

Şimdi son kısma bakalım:

St+1, At eylemini gerçekleştirmekten kaynaklanan yeni durumdur. Dolayısıyla bu kısım, o yeni durumdaki tüm eylemler (a) arasından en büyük Q-değerini bulur. Bu değeri gamma (iskonto faktörü) olarak adlandırılan γ parametresiyle çarpar ve sonucu alınan ödüle ekleriz.
Gammayı 1’e yakın ayarlarsak gelecekteki ödüllere daha fazla ağırlık veririz. Sıfıra yaklaştırırsak mevcut ödül Rt+1’i daha çok vurgularız. Bu, gammanın keşif ve sömürü dengesini kurmak için kullanabileceğimiz bir diğer parametre olduğu anlamına gelir.
Son olarak, 0 ile 1 arasında değişen ve eğitim hızını kontrol eden alfa (α) vardır. 1’e yakın değerler Q-değeri güncellemelerini daha büyük yapar; böylece ajan daha hızlı öğrenir ve artı işaretinin sağ tarafı ağır basar. Buna karşılık 0’a yakın değerler, mevcut Q-değerini içeren sol tarafı ağır basar.
Öğrenme hızını kontrol etmek için öğrenme oranını kullanmak, ajanın çok hızlı ilerleyip eski bilgileri unutmamasını sağlar. Ayrıca çok yavaş öğrenmesini de engelleyerek önemli bilgileri kaçırmamasını temin eder.
Bu, Q-öğrenmeyi anlamanın en zorlu kısmıdır; umarım nasıl çalıştığına dair kabaca bir fikir edinmişsinizdir.
Her şeyde olduğu gibi, pekiştirmeli öğrenme problemlerini çözmek için de Python çerçeveleri vardır. En popüleri, kapsamlı belgeleriyle birlikte 2000’den fazla ortamla önceden gelen Gymnasium’dur.
$ pip install "gymnasium[atari]"
$ pip install autorom[accept-rom-license]
$ AutoROM --accept-license

import gymnasium as gym
env = gym.make("ALE/Breakout-v5")
Az önce yüklediğimiz ortamın adı Breakout. Şöyle görünüyor:
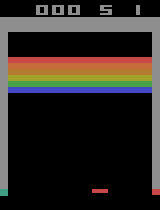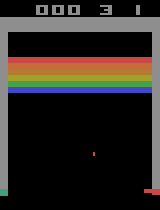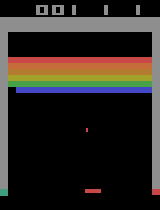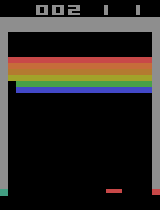
Buradaki amaç, tahtanın (ajanın) deneme-yanılma yoluyla tüm tuğlaları nasıl yok edeceğini öğrenmesidir. Oyunun kuralları cezaları ve ödülleri belirler.
Yazıyı, kendi etkileşim bölümlerinizi nasıl çalıştırabileceğinizi ve ajanın ilerlemesini yukarıdaki gibi bir GIF ile nasıl görselleştirebileceğinizi göstererek bitireceğiz.
Etkileşim döngüsünün kodu şöyle:
epochs = 0

frames = []  # for animation
done = False

env = gym.make("ALE/Breakout-v5", render_mode="rgb_array")
observation, info = env.reset()

while not done:
    action = env.action_space.sample()
    observation, reward, terminated, truncated, info = env.step(action)

    # Put each rendered frame into dict for animation
    frames.append(
        {
            "frame": env.render(),
            "state": observation,
            "action": action,
            "reward": reward,
        }
    )

    epochs += 1
    if epochs == 1000:
        break
Az önce bin zaman adımı çalıştırdık; başka bir deyişle ajan 1000 eylem gerçekleştirdi. Ancak bu eylemlerin tümü tamamen rastgele—geçmiş hatalardan öğrenmiyor. Bunu doğrulamak için frames değişkenini kullanarak bir GIF oluşturabiliriz:
from moviepy.editor import ImageSequenceClip
# !pip install moviepy - if you don’t have moviepy

def create_gif(frames: dict, filename, fps=100):
    """
    Creates a GIF animation from a list of RGBA NumPy arrays.

    Args:
        frames: A list of RGBA NumPy arrays representing the animation frames.
        filename: The output filename for the GIF animation.
        fps: The frames per second of the animation (default: 10).
    """
    rgba_frames = [frame["frame"] for frame in frames]

    clip = ImageSequenceClip(rgba_frames, fps=fps)
    clip.write_gif(filename, fps=fps)

# Example usage
create_gif(frames, "animation.gif") #saves the GIF locally
Not: “RuntimeError: No ffmpeg exe could be found” hatasıyla karşılaşırsanız, moviepy’i içe aktarmadan önce aşağıdaki iki satırı eklemeyi deneyin:
from moviepy.config import change_settings
change_settings({"FFMPEG_BINARY": "/usr/bin/ffmpeg"})
İlk kod parçamız, her bir zaman adımı için ortamın durumunu RGBA dizileri olarak döndürmüştü ve bunlar frames içinde saklanıyor. moviepy kütüphanesini kullanarak tüm kareleri bir araya getirerek az önce gördüğünüz GIF’i oluşturabiliriz:

Bir not olarak, çok sayıda zaman adımı çalıştırırsanız GIF’i hızlandırmak için fps parametresini ayarlayabilirsiniz.
Artık ajanın yalnızca rastgele eylemler yaptığını gördüğümüze göre, bazı algoritmaları denemenin zamanı geldi. Bunu adım adım, Python ile Gymnasium Kullanarak Pekiştirmeli Öğrenme kursunda yapabilir, Q-öğrenme, SARSA ve daha birçok algoritmayı keşfedebilirsiniz.
Oluşturduğumuz bu fonksiyonu, ajanlarınızın ilerlemesini canlandırmak için mutlaka kullanın ve iyi eğlenceler!
Pekiştirmeli öğrenme, bilgisayar bilimi ve makine öğrenmesinin en ilgi çekici konularından biridir. Bu eğitimde, ajan ve ortamlardan Q-öğrenme gibi modelsiz algoritmalara kadar RL’in temel kavramlarını öğrendik.
Ancak satranç veya video oyunları gibi karmaşık problemleri çözebilen dünya çapında ajanlar yaratmak zaman ve pratik gerektirir. Yolda işinize yarayabilecek bazı kaynaklar şunlardır:
Okuduğunuz için teşekkürler!
Yapay zekâ ve pekiştirmeli öğrenme hakkında daha fazlasını keşfedin!
Kurs
Kurs
Program
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




