
Ana içeriğe atla

İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) Nedir?

ChatGPT gibi yeni nesil yapay zekâ araçlarının başarısının ardındaki hayati tekniğin temellerini keşfedin
Güncel 3 Eki 2026  · 8 dk. oku

Yapay Zeka ile Keşfedin

ChatGPTClaudePerplexity

ChatGPT ve diğer üretken yapay zekâ araçlarının yaygın biçimde benimsenmesi, yapay zekânın faydaları ve zorlukları ile toplumumuzu nasıl yeniden şekillendireceği üzerine büyük bir tartışmayı beraberinde getirdi. Bu soruları daha iyi değerlendirebilmek için, yeni nesil yapay zekâ araçlarının arkasındaki sözde Büyük Dil Modellerinin (LLM) nasıl çalıştığını bilmek önemlidir.

Bu makale, ChatGPT gibi LLM’lerin etkileyici sonuçlar vermesine yardımcı olmak için pekiştirmeli öğrenme teknikleri ile insan rehberliğini birleştiren yenilikçi bir yaklaşım olan İnsan Geri Bildiriminden Pekiştirmeli Öğrenme (RLHF) hakkında bir giriş sunar. RLHF’nin ne olduğunu, faydalarını, sınırlamalarını ve hızla gelişen üretken yapay zekâ alanının gelecekteki gelişimindeki rolünü ele alacağız. Okumaya devam edin!

RLHF’yi Anlamak

RLHF’nin rolünü anlamak için önce LLM’lerin eğitim sürecinden bahsetmemiz gerekiyor.

En popüler LLM’lerin temel teknolojisi bir dönüştürücüdür (transformer). Google araştırmacıları tarafından geliştirilmesinden bu yana, dönüştürücüler yapay zekâ ve derin öğrenme alanında yeni bir ölçüt haline gelmiş, bir cümledeki sözcükler gibi sıralı verileri ele almak için daha etkili bir yöntem sunmuştur.

LLM’ler ve dönüştürücülere daha ayrıntılı bir giriş için Büyük Dil Modelleri (LLM) Kavramları Kursumuza göz atın.

Dönüştürücüler, insan müdahalesi olmadan verileri etiketlemeyi sağlayan yenilikçi bir eğitim türü olan öz denetimli öğrenme ile internetten toplanan devasa bir metin külliyatı üzerinde önceden eğitilir. Önceden eğitilmiş dönüştürücüler, çok çeşitli doğal dil işleme (NLP) sorunlarını çözebilir.

Ancak, ChatGPT gibi bir yapay zekâ aracının ilgi çekici, doğru ve insan benzeri yanıtlar vermesi için yalnızca önceden eğitilmiş bir LLM kullanmak yeterli olmayacaktır. Sonuçta, insan iletişimi yaratıcı ve öznel bir süreçtir. Bir metni “iyi” yapan şeyler, insan değerleri ve tercihleri tarafından derinden etkilenir; bu da açık, algoritmik bir çözüme dökmeyi veya ölçmeyi çok zorlaştırır.

RLHF’nin ardındaki fikir, modelin performansını ölçmek ve iyileştirmek için insan geri bildirimi kullanmaktır. RLHF’yi diğer pekiştirmeli öğrenme tekniklerinden ayıran şey, ajan ödülünü en üst düzeye çıkarmak için istatistiksel olarak önceden tanımlanmış bir işlev yerine modeli optimize etmek üzere insan katılımının kullanılmasıdır.

Bu strateji, daha uyarlanabilir ve kişiselleştirilmiş bir öğrenme deneyimi sağlar ve LLM’leri kod yardımı, hukuki araştırma, kompozisyon yazımı ve şiir üretimi gibi her türlü sektöre özgü uygulama için uygun hale getirir.

RLHF Nasıl Çalışır?

RLHF; çoklu model eğitimi ve farklı devreye alma aşamalarını içeren zorlu bir süreçtir. Özünde üç adıma ayrılabilir.

1. Önceden eğitilmiş bir model seçin

İlk aşama, daha sonra RLHF kullanılarak ince ayar yapılacak önceden eğitilmiş bir LLM seçmeyi içerir.

LLM’inizi sıfırdan da önceden eğitebilirsiniz, ancak bu maliyetli ve zaman alıcı bir süreçtir. Bu nedenle, kamuya açık birçok önceden eğitilmiş LLM’den birini seçmenizi şiddetle öneririz.

LLM nasıl eğitilir hakkında daha fazla bilgi edinmek isterseniz, PyTorch ile Bir LLM Nasıl Eğitilir başlıklı öğreticimiz örnek bir uygulama sunar.

Modelinizin özel ihtiyaçlarını karşılamak için, insan geri bildirimiyle ince ayar aşamasına başlamadan önce modelinizi ek metinler veya koşullar üzerinde de ince ayar yapabilirsiniz.

Örneğin, bir yapay zekâ hukuk asistanı geliştirmek istiyorsanız, LLM’inizi hukuki terminoloji ve kavramlara özellikle aşina kılmak için bir hukuk metinleri külliyatıyla ince ayar yapabilirsiniz.

2. İnsan geri bildirimi

İstatistiksel olarak önceden tanımlanmış bir ödül modeli kullanmak (insan tercihlerine göre ayarlama açısından oldukça kısıtlayıcı olurdu) yerine, RLHF modelin daha incelikli bir ödül modeli geliştirmesine yardımcı olmak için insan geri bildirimi kullanır. Süreç şu şekilde işler:

  • Önce, önceden eğitilmiş model bir dizi istem örnekleyerek girdi-istek/üretilmiş-metin çiftlerinden oluşan bir eğitim seti oluşturur.
  • Ardından, insan test ediciler, modeli insan değerleri ve tercihlerine hizalamak ve güvenli tutmak için belirli yönergeleri kullanarak üretilen metinleri sıralar. Bu sıralamalar daha sonra Elo derecelendirme sistemleri gibi çeşitli tekniklerle puan çıktılara dönüştürülebilir.
  • Son olarak, biriken insan geri bildirimi sistem tarafından performansını değerlendirmek ve bir ödül modeli geliştirmek için kullanılır.

Aşağıdaki görsel tüm süreci göstermektedir:
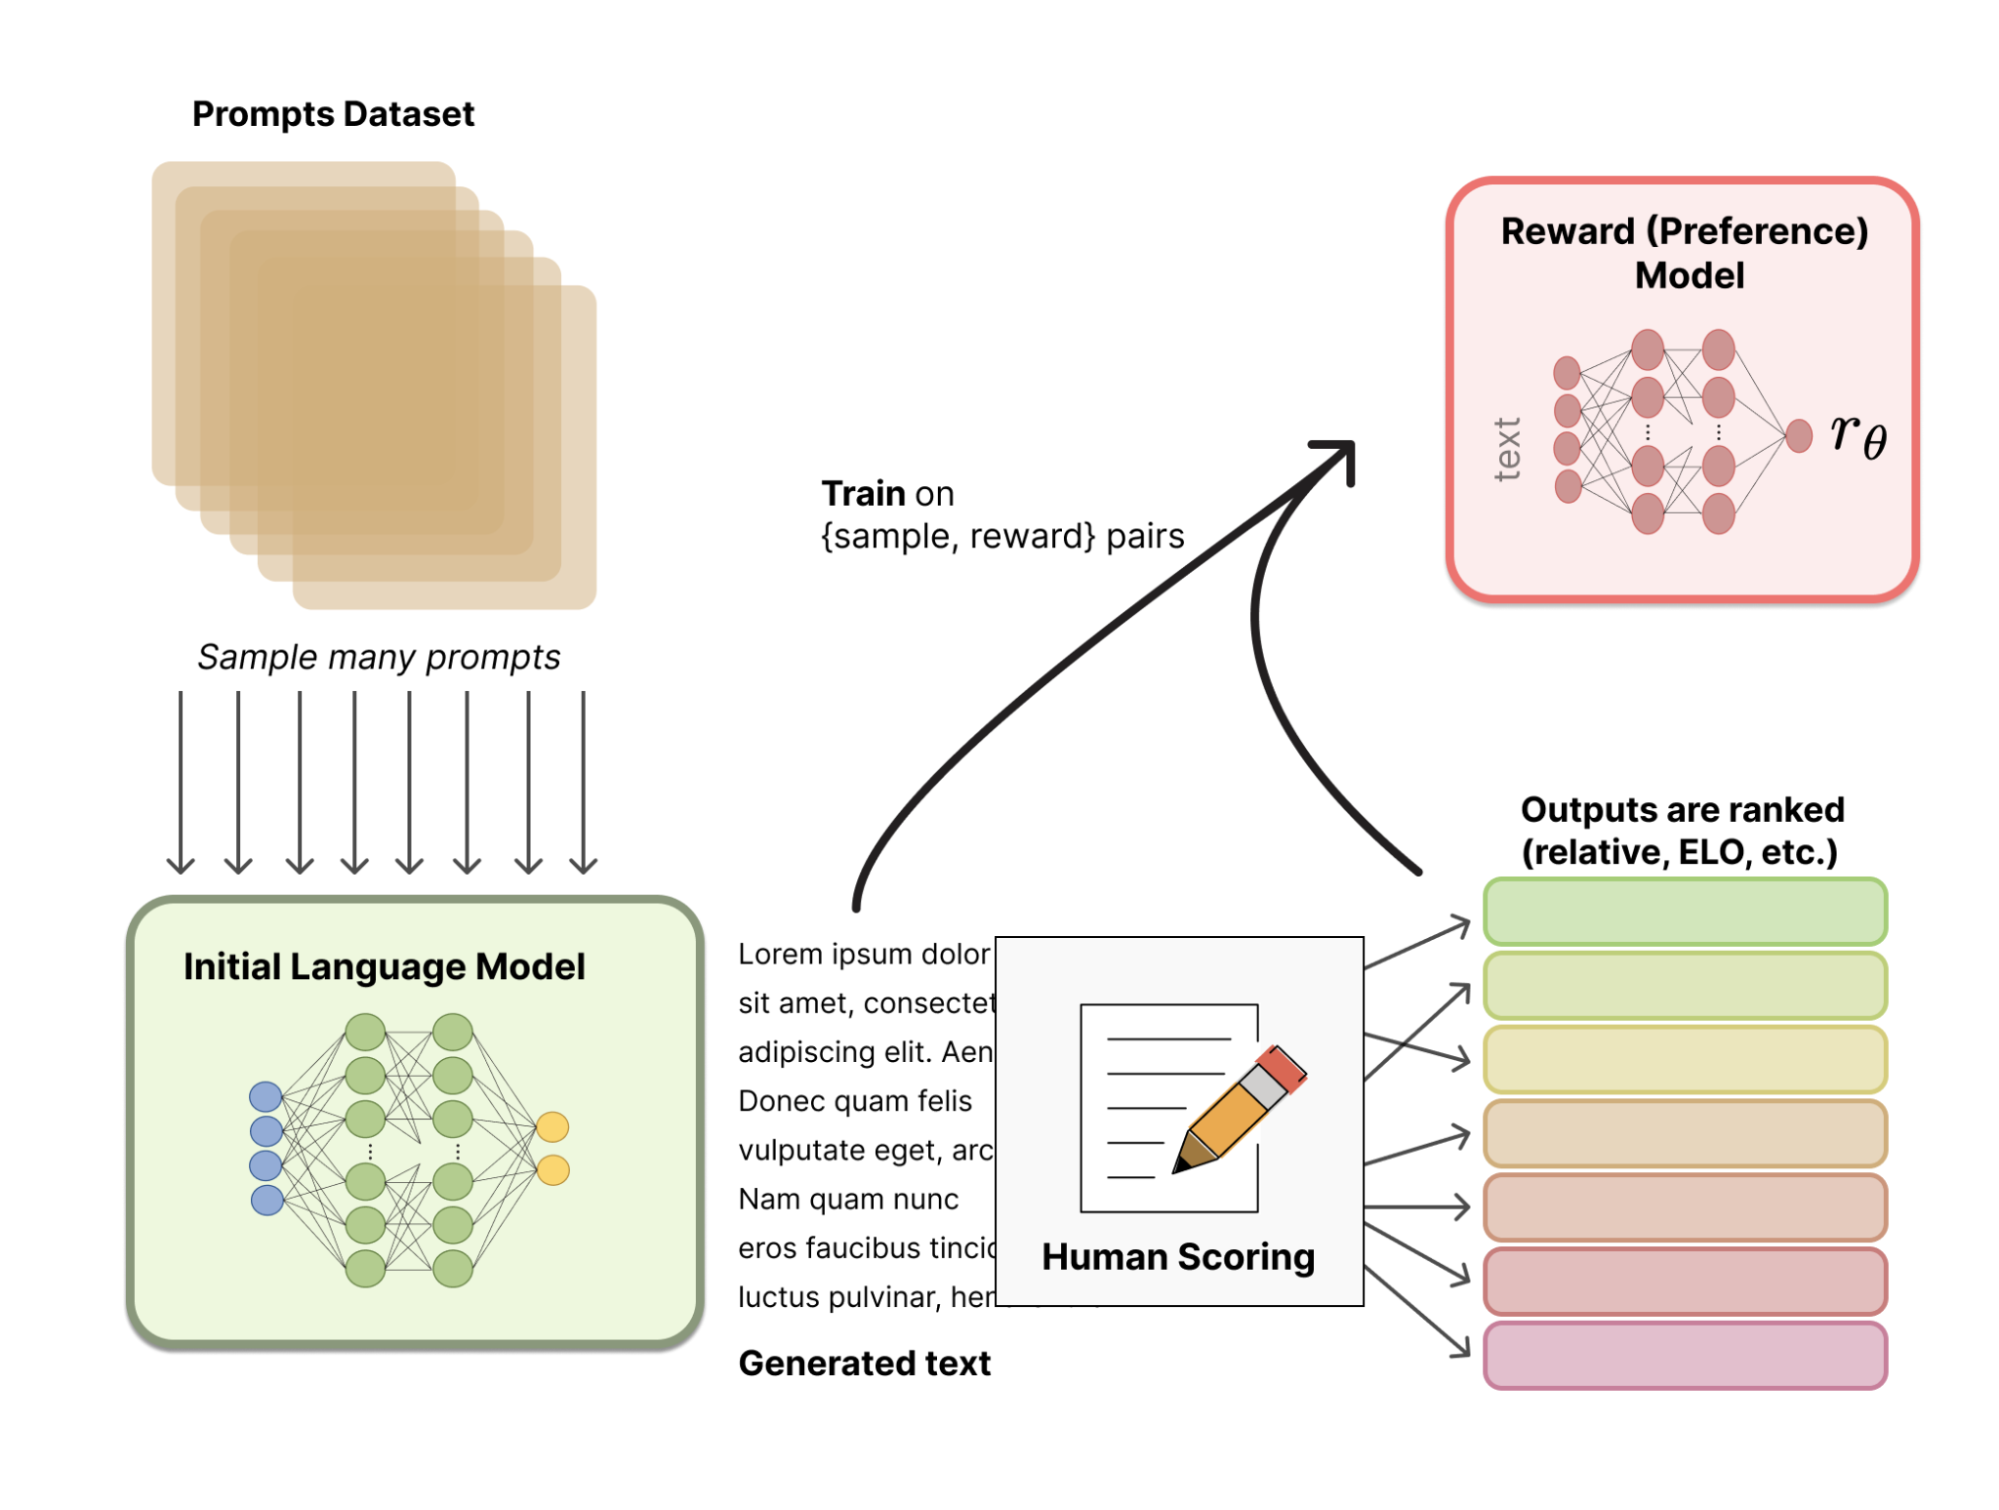
Source. Hugging Face

Kaynak: Hugging Face

3. Pekiştirmeli öğrenme ile ince ayar

Son aşamada, LLM yeni metinler üretir ve insan geri bildirimi temelli ödül modelini kullanarak bir kalite puanı hesaplar. Model daha sonra bu puanı, sonraki istemlerdeki performansını iyileştirmek için kullanır.

Böylece, insan geri bildirimi ve pekiştirmeli öğrenme teknikleri, belirli bir doğruluk düzeyine ulaşılana kadar süren yinelemeli bir süreçte birleştirilir.

İnsan Geri Bildiriminden Pekiştirmeli Öğrenmenin Uygulamaları

RLHF, ChatGPT gibi LLM’lerin ince ayarı için ileri düzey bir tekniktir. Bununla birlikte, RLHF popüler bir konudur ve NLP sorunlarının ötesindeki olasılıkları inceleyen literatür giderek artmaktadır. Aşağıda RLHF’nin başarıyla uygulandığı diğer alanların bir listesini bulabilirsiniz:

  • Sohbet robotları. ChatGPT, RLHF’nin sunduğu olanakların en belirgin örneğidir. ChatGPT’nin RLHF’yi nasıl kullandığı hakkında daha fazla bilgi için, ChatGPT’ye doğrudan nasıl çalıştığını sorduğumuz “ChatGPT nedir?” başlıklı bu makaleye göz atın.
  • Robotik. Robotik, RLHF’nin umut verici sonuçlar verdiği başlıca alanlardan biridir. İnsan geri bildiriminin kullanımı, bir ödül işlevinde belirtmesi zor olabilecek görev ve hareketleri bir robotun yerine getirmesine yardımcı olabilir. OpenAI araştırmacıları, RLHF kullanarak bir robota geri takla atmayı –modellenmesi oldukça güç bir görev– öğretmeyi başardı.
  • Oyun. Pekiştirmeli öğrenme teknikleri, video oyunu botları geliştirmek için kullanılmıştır. Ancak RLHF, botları insan tercihlerine göre eğitmek için kullanılabilir; böylece onları basitçe ödül ençoklayan makineler yerine daha insan benzeri oyuncular haline getirir. Örneğin, OpenAI ve DeepMind, RLHF ile Atari oyunları oynayacak botlar eğitti.

RLHF’nin Faydaları

RLHF, onsuz yeni nesil yapay zekâ araçlarının mümkün olmayacağı güçlü ve umut verici bir tekniktir. İşte RLHF’nin bazı faydaları:

  • Artırılmış performans. İnsan geri bildirimi, ChatGPT gibi LLM’lerin insan gibi “düşünmesinin” ve ses çıkarmasının anahtarıdır. RLHF, insan değerleri veya tercihlerinin söz konusu olduğu NLP gibi karmaşık görevlerin makineler tarafından ele alınmasını sağlar.
  • Uyarlanabilirlik. LLM’ler her türden istemde insan geri bildirimiyle ince ayarlandığından, RLHF makinelerin çoklu görevleri yerine getirmesine ve beklenen durumlara uyum sağlamasına imkân tanır. Bu da LLM’leri genel amaçlı yapay zekâ eşiğine daha da yaklaştırır.
  • Sürekli iyileştirme. RLHF yinelemeli bir süreçtir; bu da sistemin, öğrenme işlevi yeni insan geri bildirimlerini takiben güncellendikçe sürekli geliştirildiği anlamına gelir.
  • Gelişmiş güvenlik. İnsan geri bildirimi alarak sistem yalnızca nasıl yapılacağını değil, nelerin yapılmaması gerektiğini de öğrenir; bu da daha etkili, daha güvenli ve güvenilir sistemler sağlar.

RLHF’nin Sınırlamaları

Bununla birlikte, RLHF kusursuz değildir. Bu teknik bazı riskler ve sınırlamalar da barındırır. Aşağıda en önemlilerinden bazılarını görebilirsiniz:

  • Sınırlı ve maliyetli insan geri bildirimi. RLHF, insan geri bildirimlerinin kalitesine ve bulunabilirliğine dayanır. Ancak işi tamamlamak yavaş, emek yoğun ve maliyetli olabilir; özellikle de eldeki iş çok fazla geri bildirim gerektiriyorsa.
  • İnsan geri bildiriminde önyargı. Geri bildirim sağlamak için standartlaştırılmış yönergeler kullanılsa da puanlama veya sıralama nihayetinde insan tercihleri ve değerlerinden etkilenir. Sıralama görevleri iyi çerçevelenmezse veya insan geri bildiriminin kalitesi düşükse, model önyargılı hale gelebilir veya istenmeyen çıktıları pekiştirebilir.
  • Yeni bağlamlara genelleme. LLM’ler hatırı sayılır insan geri bildirimiyle ince ayarlansa bile, her zaman beklenmedik bağlamlar ortaya çıkabilir. Bu durumda zorluk, sınırlı geri bildirim bulunan durumlara karşı ajanı dayanıklı kılmaktır.
  • Halüsinasyonlar. İnsan geri bildirimi sınırlı veya zayıf olduğunda, ajanlar istenmeyen, yanlış veya saçma davranışlar anlamına gelen sözde halüsinasyonlar yaşayabilir.

RLHF’de Gelecek Eğilimler ve Gelişmeler

RLHF, ChatGPT ve GPT-4 gibi modern üretken yapay zekâ araçlarının belkemiğinden biridir. Etkileyici sonuçlarına rağmen, RLHF nispeten yeni bir tekniktir ve hâlâ geniş bir iyileştirme alanı mevcuttur. RLHF tekniklerine yönelik gelecekteki araştırmalar, LLM’leri daha verimli hale getirmek, çevresel ayak izlerini azaltmak ve LLM’lerin bazı risk ve sınırlamalarını ele almak için kritik önemdedir.

Üretken yapay zekâ, makine öğrenmesi ve LLM’lerdeki en son gelişmelerden haberdar olmak için, özenle seçtiğimiz öğrenim materyallerimize göz atmanızı önemle tavsiye ederiz:


Javier Canales Luna's photo
Author
Javier Canales Luna
LinkedIn

Serbest çalışan bir veri analistiyim; dünya genelinde şirketler ve kuruluşlarla veri bilimi projelerinde iş birliği yapıyorum. Ayrıca 2+ yıllık deneyime sahip bir veri bilimi eğitmeniyim. Düzenli olarak İngilizce ve İspanyolca veri bilimiyle ilgili makaleler yazıyorum; bunların bir kısmı DataCamp, Towards Data Science ve Analytics Vidhya gibi köklü internet sitelerinde yayımlandı. Siyaset bilimi ve hukuk geçmişine sahip bir veri bilimci olarak amacım, kamu politikası, hukuk ve teknolojinin kesişiminde çalışmak; fikirlerin gücünden yararlanarak özellikle iklim krizi olmak üzere acil sorunların üstesinden gelmemize yardımcı olabilecek yenilikçi çözümler ve anlatılar geliştirmek. Kendimi otodidakt bir kişi, sürekli öğrenen ve disiplinlerarasılığın güçlü bir savunucusu olarak görüyorum. Yeni şeyler öğrenmek için asla geç değildir.

Konular
Yapay Zeka

Bu Yazıda Bahsedilen Konuları Öğrenin!

{count, plural, one {Kurs} other {Kurs}}

Python ile Deep Learning'e Giriş

{hours} sa
264.7K
Python'da Keras 2.0 kullanarak sinir ağlarının temellerini ve derin öğrenme modellerinin nasıl oluşturulacağını öğrenin.
Ayrıntıları GörüntüleRight Arrow
Kursa Başla
Devamını GörRight Arrow
İlgili

{count, plural, one {blog} other {blog}}

Hızlı Sevkiyat İçin Pratik Vibe Kodlama Teknoloji Yığını

Ön uç, arka uç, veritabanları, kimlik doğrulama, depolama, e-posta, test, dağıtım ve izleme için en iyi araçları keşfedin.
Abid Ali Awan's photo

Abid Ali Awan

14 dk.

{count, plural, one {blog} other {blog}}

2026’da En Popüler 40 Yazılım Mühendisi Mülakat Sorusu

Algoritmalar, sistem tasarımı ve davranışsal senaryoları kapsayan bu temel sorularla teknik mülakat sürecine hakim olun. Uzman cevapları, kod örnekleri ve kanıtlanmış hazırlık stratejileri edinin.
Dario Radečić's photo

Dario Radečić

15 dk.

{count, plural, one {Eğitim} other {Eğitim}}

.gitignore Nasıl Kullanılır: Örneklerle Pratik Bir Giriş

Git deponuzu temiz tutmak için .gitignore’u nasıl kullanacağınızı öğrenin. Bu eğitim; temelleri, yaygın kullanım durumlarını ve başlamanıza yardımcı olacak pratik örnekleri kapsar!
Kurtis Pykes 's photo

Kurtis Pykes

8 dk.

{count, plural, one {Eğitim} other {Eğitim}}

Python'da Listeyi String'e Nasıl Dönüştürürsünüz

Bu hızlı eğitimde, Python'da bir listeyi string'e nasıl dönüştüreceğinizi öğrenin.
Adel Nehme's photo

Adel Nehme

Devamını GörDevamını Gör

