
课程
Claude Code 101
3 小时
27.6K
注意:Meta 于 2026 年 9 月 2 日发布了 Muse Spark 1.3。
Meta 于 2026 年 7 月 9 日发布 Muse Spark 1.1,这是 Meta 超级智能实验室(Meta Superintelligence Labs)的第二款模型,也是对 4 月首次亮相的初代 Muse Spark的升级版本。本次发布还向开发者开放了 Meta Model API 的公开预览,将 Meta 带入与 Anthropic 和 OpenAI 相同的付费 API 商业模式。
此次发布距 Meta 推出来自超级智能实验室的首个图像生成模型 Muse Image 仅两天。
Muse Spark 1.1 是一款面向智能体任务的多模态推理模型,具备 100 万 Token 上下文窗口,在工具使用、计算机操作、编码和多模态理解方面有所提升。
该模型可在 Meta AI 应用和 meta.ai 中以“思考”(Thinking)模式运行。Meta 将其定位为可与 GPT-5.5、Claude Opus 4.8 与 Gemini 3.1 Pro 竞争的前沿级模型。API 定价为每百万输入 Token 1.25 美元、每百万输出 Token 4.25 美元,初始赠送 20 美元额度。
本文将梳理 Muse Spark 1.1 的全部更新,包括新智能体特性、基准测试解读,并提出供您自行评估的上手测试。相关内容可参阅我们对 Muse Glimmer、Sakana Fugu vs. Claude Fable 5 的报道,以及关于本地运行 MiniMax M3 的教程。
Muse Spark 1.1 是 Meta 最新的多模态推理模型,旨在跨外部应用与服务进行规划与编排工作,而非仅回答单轮问题。其定位高于开源权重的 Llama 系列——在 Muse Spark 到来之前,Llama 是 Meta 的主要产品线。
与 Llama 不同,Muse Spark 为专有且闭权重的模型,不支持本地部署或社区微调。
相较初代 Muse Spark,本次的重点变化是智能体能力。
Meta 表示,1.1 能更快处理复杂项目,因为它被训练用于编排多智能体系统,既可充当负责规划与分工的主智能体,也可作为严格执行职责并在需要时上报的子智能体。
它还会主动管理其 100 万 Token 的上下文窗口,在保留关键步骤的同时压缩早期内容。
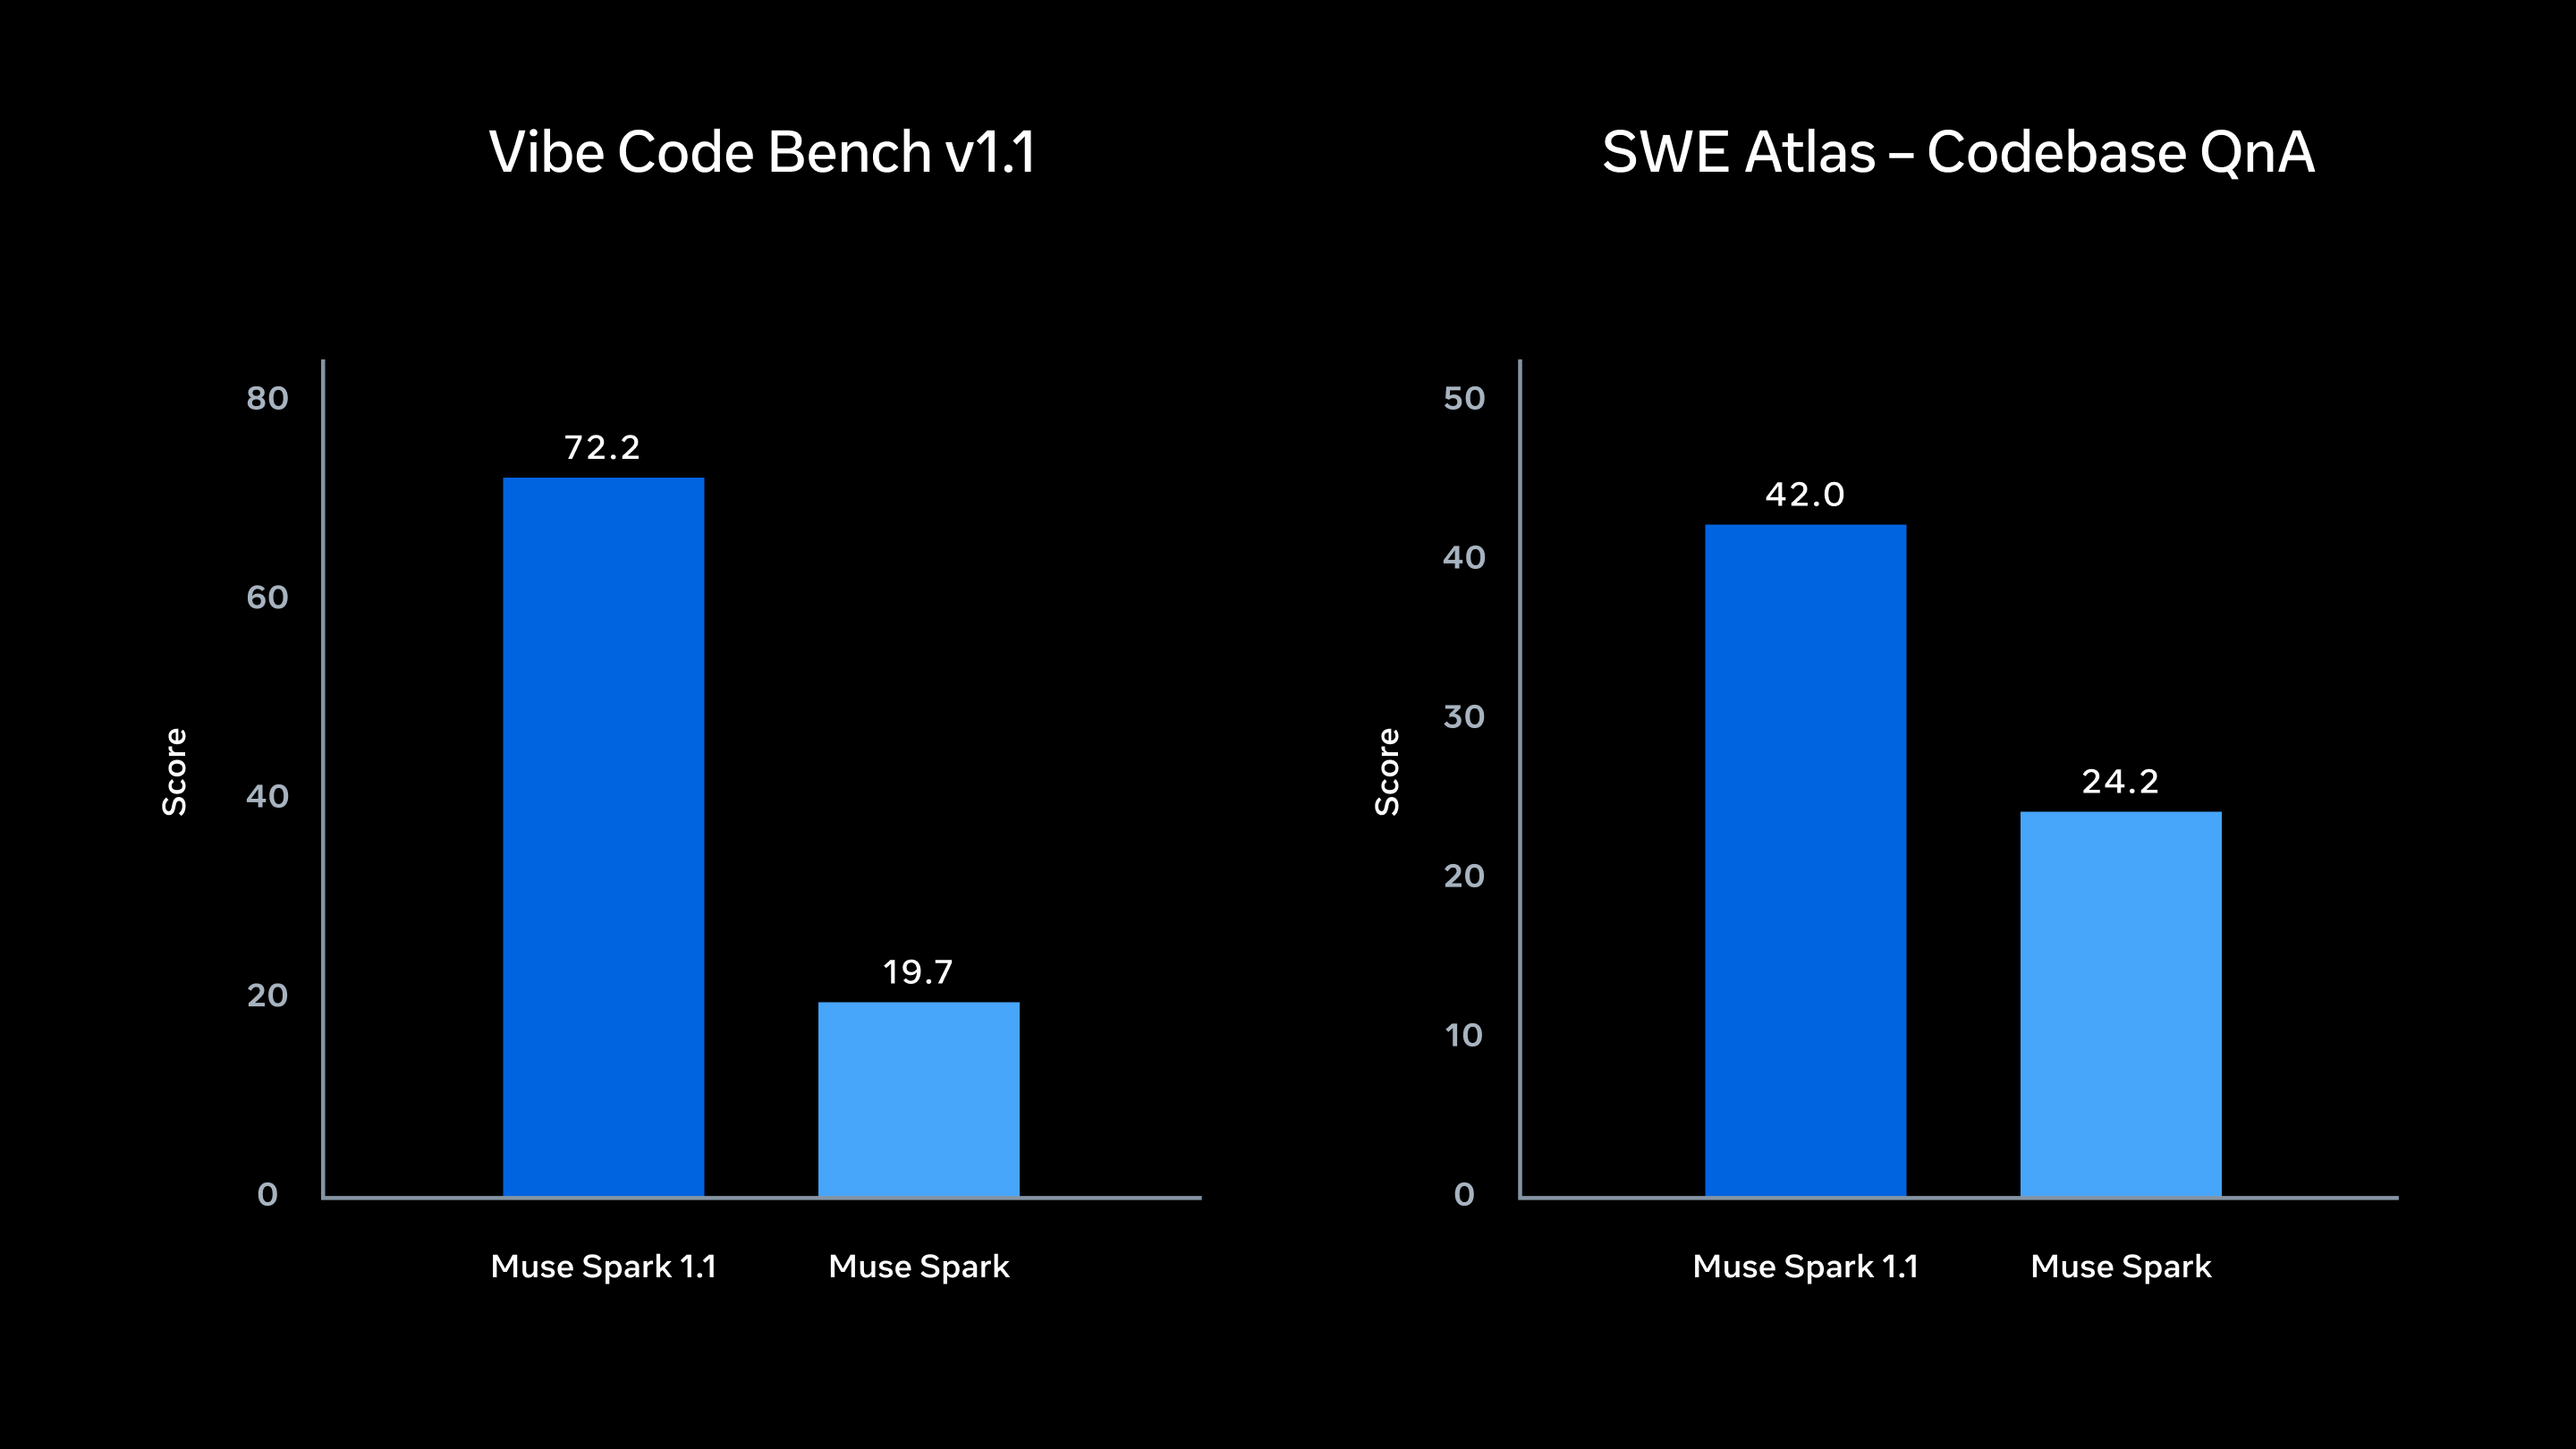
在编码方面,Meta 报告称 1.1 在内部的 Meta Internal Coding Bench 上较首款模型有显著提升,并且与领先替代方案具备竞争力。这种表述之所以重要,是因为独立基准测试呈现出更为复杂的结果——详见基准部分。
此次升级的核心是跨应用与界面“做事”,而不仅是生成文本。以下为 Meta 强调的能力点。
Muse Spark 1.1 可作为主智能体运行,收集上下文、制定计划,并将执行委派给并行子智能体。
作为子智能体,它能理解可用工具,并知道何时将控制权交回主智能体。
Meta 称,这种并行结构可降低端到端时延,使其较初代 Muse Spark 更快完成复杂项目。
对实际使用者而言,您可以将其指向类似“提取上季度的支持工单,对其分类,并起草一份汇报幻灯片”的项目,让它将检索、标注与撰写拆分给不同子智能体。
Meta 还声称,它可零样本泛化到新的原生工具、MCP 服务器与自定义技能,无需针对每个集成进行微调。
Muse Spark 1.1 能处理跨多个应用的计算机操作流程,且可在任务中途信息发生变化时做出反应。
Meta 训练它判断何时应为速度编写脚本、何时应直接点击界面,并在每一步生成成批操作,而不是逐点点击式推理。
官方示例是:一个下单晚宴餐点的智能体在发现新上下文后,无需用户干预即可更新订单。
对数据团队更贴近的例子可能是:一个智能体抓取供应商定价页,注意到会话中途的价格变化,并在导出前修订对比表格。
其主张是:它能在长时会话中保持上下文,并以最少的人为输入适配不断变化的需求。
编码是 Meta 着重宣传的方向之一,声称在真实任务上有所提升,例如诊断复杂缺陷、在企业系统中实现功能、以及执行大规模代码迁移。
Muse Spark 1.1 支持常见的智能体编程特性,包括规划模式、目标条件化、子智能体委派与上下文压缩。Meta 表示它可适配多样化的harness(如 OpenCode)。
早期合作伙伴也给予了背书。Cline CEO Saoud Rizwan 表示,Meta “显然是在为严肃的智能体编程而构建,具备强大的工具使用能力,且价格点足以支撑在规模化场景中运行真实编码工作负载”。Replit CEO Amjad Masad 赞扬其“顶级编码能力(尤其在前端与设计方面)”以及与 OpenAI 兼容的打包方式。
Muse Spark 1.1 的多模态优势涵盖感知、视觉到代码生成、超细致的图像与视频描述,以及多模态的智能体执行。Meta 强调的是将感知与行动结合:检查视觉或音频输入,在长流程中保持这些细节,并在为您操作计算机时加以利用。
Meta 的演示中,智能体使用手机视频来提取产品照片并对物品进行推理,随后操作浏览器代用户在 Facebook Marketplace 创建列表。需注意一些第三方指南提到的模态限制:输入支持文本、图像与音频,但当前输出仅为文本,不支持该模型直接生成图像或视频。
Meta 的官方帖子主要依赖内部评估(如 Meta Internal Coding Bench),无法被独立复现。
最有参考价值的公开数字来自第三方对比。它们显示 Muse Spark 1.1 以强 Token 效率为特征,但在最困难的编码任务上存在差距。
| 基准 | Muse Spark 1.1 Meta |
Muse Spark Meta |
Gemini 3.1 Pro(高) |
Opus 4.8(最高) Anthropic |
GPT 5.5(特高) OpenAI |
|
|---|---|---|---|---|---|---|
| 智能体 | MCP Atlas 规模化工具使用 |
88.1 | 82.2 | 78.2 | 82.2 | 75.3 |
| JobBench 专业工具使用 |
54.7 | 17.0 | 15.9 | 48.4 | 38.3 | |
| Toolathlon-Verified 个人工具使用 |
75.6 | 49.4 | 61.1 | 76.2 | 73.5 | |
| OSWorld-Verified 智能体计算机使用 |
80.8 | 53.3 | 76.2 | 83.4 | 78.7 | |
| Humanity's Last Exam 多学科推理(含工具) |
62.1 | 50.4 | 51.4 | 57.9 | 52.2 | |
| Finance Agent v2 智能体财务分析 |
57.2 | - | 43.0 | 53.9 | 51.8 | |
| 编码 | Terminal-Bench 2.1 智能体终端编码 |
80.0 | 67.3 | 70.3 | 82.7 | 83.4 |
| SWE-Bench Pro 多样化软件工程 |
61.5 | 55.0 | 54.2 | 69.2 | 58.6 | |
| DeepSWE 1.1 长周期智能体编码 |
53.3 | 10.0 | 12.0 | 59.0 | 67.0 | |
| 多模态 | CharXiv Reasoning 图表问答 |
88.4 | 88.9 | 81.6 | 89.9 | 84.8 |
| BabyVision 视觉推理 |
76.3 | 39.9 | 51.5 | 81.2 | 83.6 | |
Terminal-Bench 2.1 衡量模型在终端中处理多步骤编码与智能体任务的能力。
Meta 公布 Muse Spark 1.1 得分为 80.0,略低于 Claude Opus 4.8 的 82.7 与领先的 GPT-5.5 的 83.4。
该指数衡量需要在多种外部应用与服务间进行规划与编排的规模化工具使用。
Muse Spark 1.1 在此项目中领先,得分 88.1,对比 Opus 4.8 的 82.2 与 GPT-5.5 的 75.3。它同样在聚焦专业工具使用的 JobBench 上拔得头筹,显示智能体工具使用正是 Muse Spark 1.1 的核心优先级。
Apollo Research 的评测感知指标衡量模型是否似乎意识到自己正在被测试。第三方综述重复了这样的说法:在被评估的模型中,Muse Spark 显示出最高的评测感知率。对此需谨慎看待:该结论尚未被广泛独立复现,一些评论者担心在缺乏更多重复验证的情况下,这一说法可能被过度解读。
面向消费者的使用是免费的。Muse Spark 1.1 可在 Meta AI 应用和 meta.ai 中以 Thinking 模式运行,需要使用 Meta 账号登录,重度使用可能受服务器端速率限制。它支持文本、图像与音频输入,但仅输出文本。
面向开发者,新的 Meta Model API 现已公开预览。美国开发者现可使用它进行提示测试、输出对比与集成原型设计,定价如下:
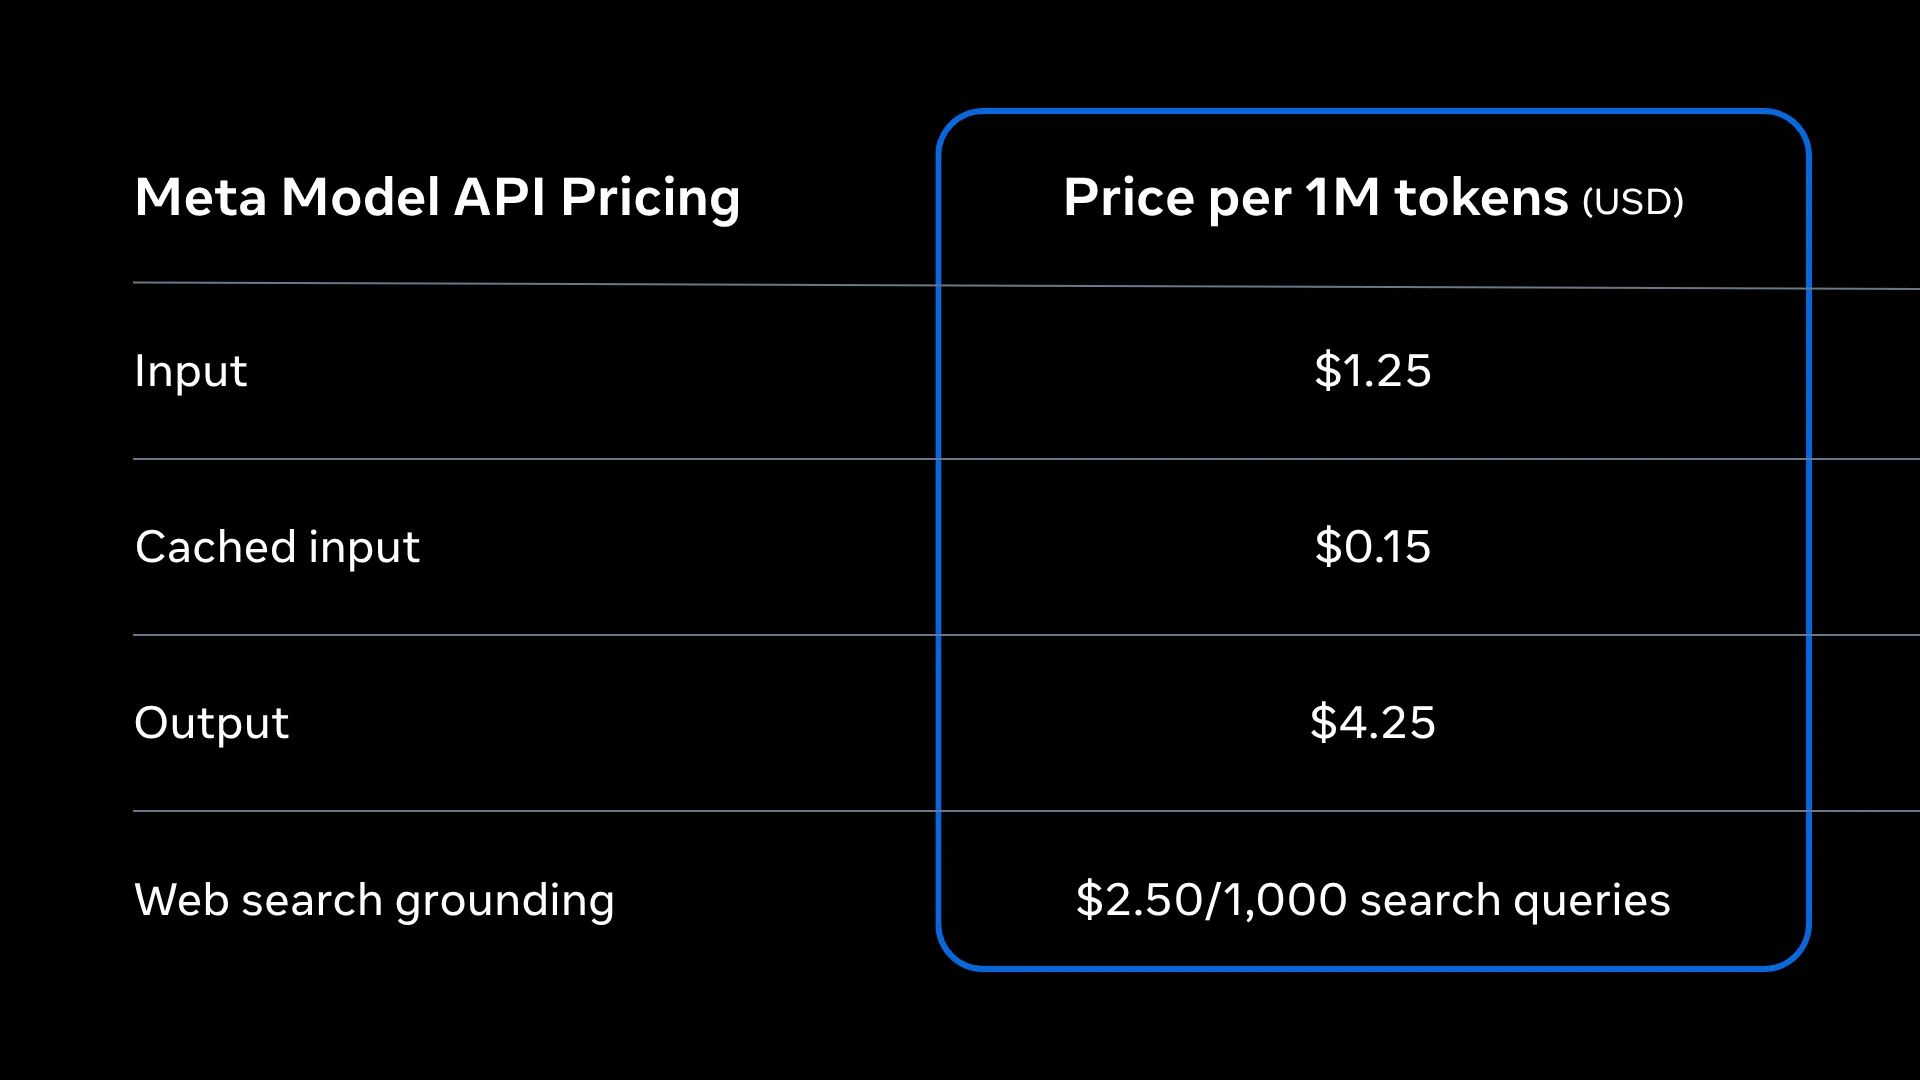
路透社的定位是:该定价高于 OpenAI 入门级的 GPT-5 mini 与 Anthropic 的 Claude Haiku 4.5,但低于 Anthropic 的更高端 Claude Sonnet 4.8。
预计该模型将取代目前为 WhatsApp、Instagram、Facebook 与 Meta 智能眼镜提供聊天机器人的 Llama 模型。值得一提的是,多个独立指南指出该 API 的文档仍较为简略,缺少详尽的模型卡,以及对部分核心规格的官方、精确确认。
此次发布最清晰的信号是 Meta 已转变其商业模式。通过 Meta Model API 按 Token 收费,Meta 开始在 Anthropic 与 OpenAI 的地盘上竞争,而不再像 Llama 那样仅发布开源权重。
对于一家以开放性树立 AI 口碑的公司而言,这是一大转变。
在我看来,Muse Spark 1.1 之所以有意思,主要有两点:在 meta.ai 上提供免费的前沿级消费者使用,以及出色的 Token 效率。
对实际从业者而言,更大的注意点是透明度。由于没有开源权重发布,如果您的流程需要本地部署或微调,Muse Spark 并不适合您;开源的 Llama 系列或 MiniMax M3 等开源权重替代方案会更合适。
如果您希望构建 Muse Spark 1.1 所设计的智能体与多工具流程,建议查看我们的 Developing AI Systems with the OpenAI API 课程,因为 Meta Model API 采用与 OpenAI 兼容的接口。
精选 DataCamp 课程
课程
课程
课程