MiniMax M3 是 MiniMax 最新的开源权重模型,面向编码、工具使用以及长时程代理工作流。与早期的 MiniMax 模型相比,它的亮点在于:提供 100 万 token 的上下文窗口;原生多模态支持文本、图像和视频;以及 MiniMax 稀疏注意力(Sparse Attention),旨在让超长上下文推理更实用。
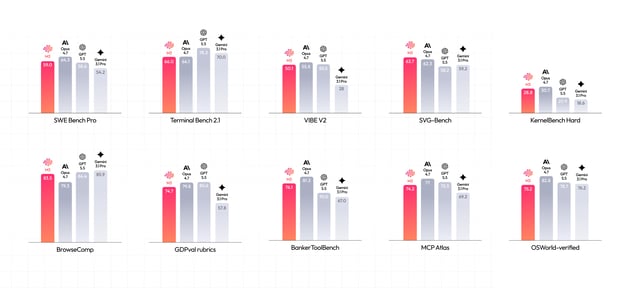
来源: MiniMax
本指南将演示如何在两张 NVIDIA RTX PRO 6000 GPU 上本地运行 MiniMax M3,使用其内置网页界面测试模型,并将本地兼容 OpenAI 的端点连接到 Pi 编码代理。
整个流程在 RunPod 的 PyTorch Pod 上通过 JupyterLab 终端完成,而非使用 SSH;llama.cpp 将以启用 CUDA 的方式编译,并在端口 8910 提供服务。
本地运行 MiniMax M3 的系统要求
在本地运行 MiniMax M3 之前,请确保系统拥有足够的 GPU 显存和存储空间以加载模型。
- GPU: 2× NVIDIA RTX PRO 6000,每张 96 GB 显存,总计 192 GB 显存。
- 存储: 至少 350 GB 可用磁盘空间,用于模型文件、Hugging Face 缓存、llama.cpp 构建文件以及运行时临时数据。
- 模型量化: 使用
unsloth/MiniMax-M3-GGUF 提供的 UD-IQ3_XXS GGUF 量化版本。该文件约 159 GB,是此硬件上最实用的选择。
- 运行时: 使用启用 CUDA 且支持多 GPU 的
llama.cpp 构建。
MiniMax M3 是一个大型专家混合(MoE)模型,因此在推理时需要将权重分布到两张 GPU 上。尽管系统总计提供 192 GB 显存,但并非全部都可用于模型本身。
一部分显存需要用于运行时开销、提示处理以及 KV 缓存。
因此,建议从 UD-IQ3_XXS 量化版本开始。其约 159 GB,能为模型加载与运行留出足够的空间。
在该配置下请避免使用 4-bit 的 MiniMax M3 量化版本,因为最小的 4-bit 文件约为 208 GB,在考虑运行时开销之前就已超出可用显存。
1. 配置 RunPod 多 GPU 环境
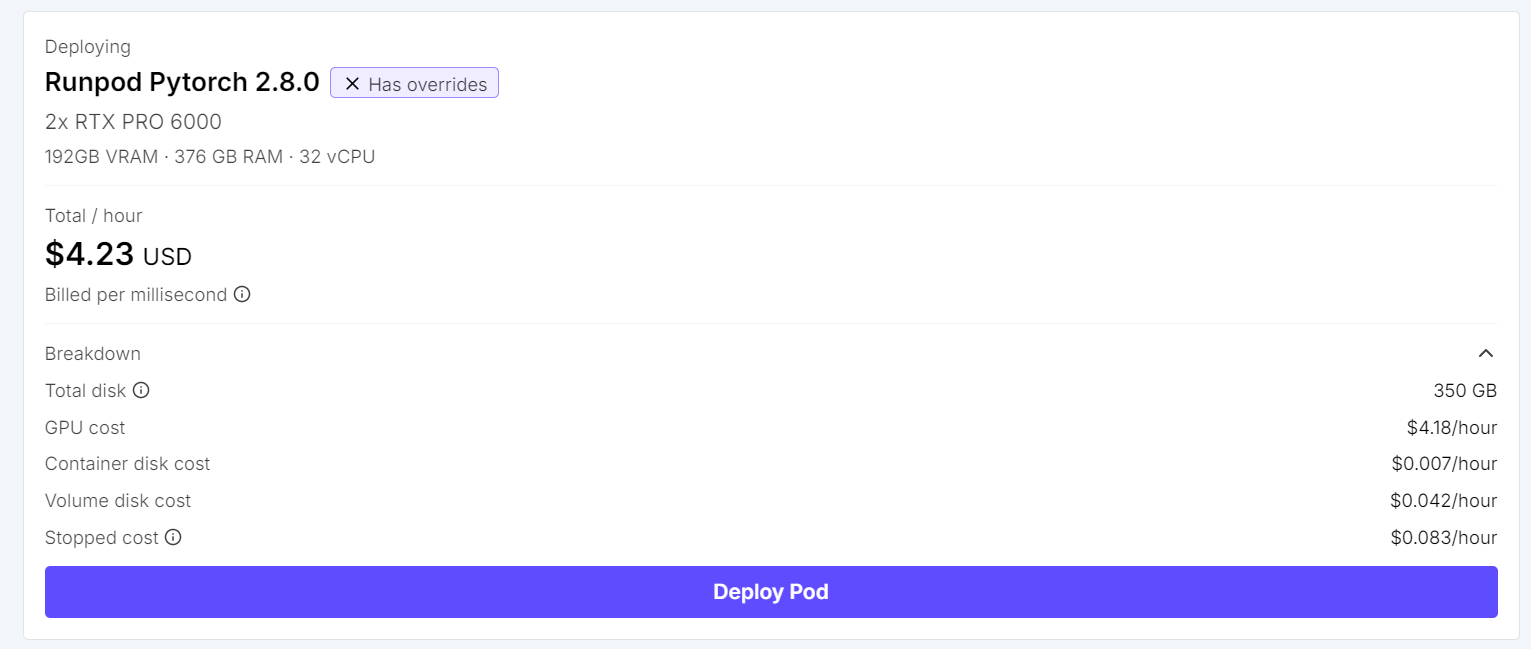
创建一个新的 RunPod Pod,选择 2× NVIDIA RTX PRO 6000 GPU,并使用最新的 RunPod PyTorch 模板。该模板内置 JupyterLab,本文将全程以此替代 SSH。
按以下设置配置 Pod:
- Container Disk:
50 GB
- Volume Disk:
300 GB
- Expose HTTP Ports:
8910
- 环境变量:
HF_TOKEN:您的 Hugging Face 访问令牌
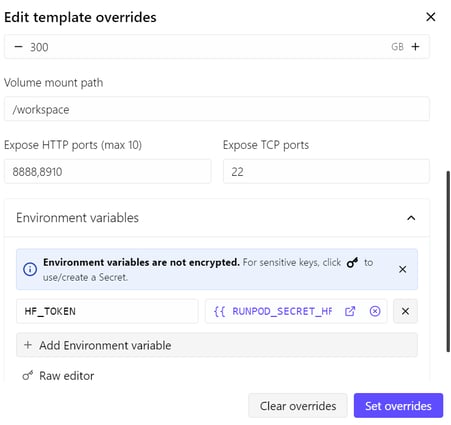
50 GB 的容器磁盘仅用于操作系统、软件包和临时文件。300 GB 的卷磁盘用于存放 MiniMax M3 模型和 Hugging Face 缓存。
暴露 HTTP 端口 8910,稍后 llama.cpp 将在该端口运行网页界面和兼容 OpenAI 的 API。服务器启动后,您可以通过如下格式的 URL 访问:
https://<POD_ID>-8910.proxy.runpod.net
本指南所用 Pod 配置的费用约为每小时 $4.23,实际价格可能因供给和地域而变化。
建议至少保留$10 的 RunPod 余额,首次构建、下载模型并测试时以 $15–$20 更为稳妥。
Pod 启动后,在 RunPod 控制台中打开它:
- 打开您的 Pod。
- 点击 Connect 选项卡
- 打开 JupyterLab。
- 在 JupyterLab 中选择 File → New → Terminal。
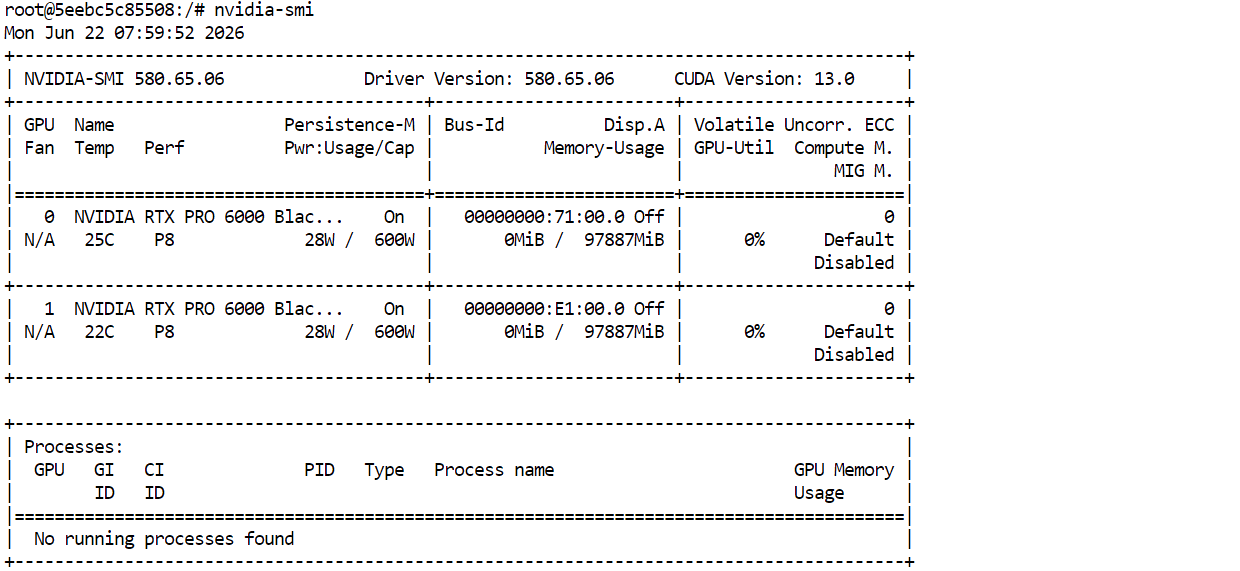
首先确认两张 GPU 都可用:
nvidia-smi技术支持
您应能看到两张 NVIDIA RTX PRO 6000,每张约 96 GB 显存。
接着安装必要的构建工具:
apt-get update && apt-get install -y \
  git \
  cmake \
  build-essential \
  curl技术支持
最后,验证 CUDA 是否可用:
nvcc --version技术支持
您应能看到 CUDA 12.8 或兼容版本。现在可以开始以 CUDA 支持构建 llama.cpp。
2. 以 CUDA 构建 MiniMax M3 的 llama.cpp 分支
llama.cpp 是一个用于本地运行 GGUF 模型的开源推理引擎。如果您还不熟悉,建议阅读我们的完整 llama.cpp 指南。
它支持 CUDA 加速、多 GPU 卸载、内置网页界面以及兼容 OpenAI 的 API 服务器。
MiniMax M3 的支持仍属试验性,因此需要从专用的 minimax-m3 分支构建 llama.cpp,而不是使用标准发行版。
在 JupyterLab 终端中运行以下命令:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp

git fetch origin pull/24523/head:minimax-m3
git checkout minimax-m3技术支持
随后启用 CUDA 支持并编译服务器与命令行可执行文件:
cmake -B build \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release

cmake --build build \
  -j"$(nproc)" \
  --target llama-server llama-cli技术支持
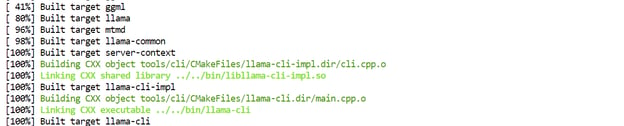
这会在 build/bin/ 目录下生成两个二进制文件:
llama-server:提供基于浏览器的聊天界面和兼容 OpenAI 的 API 端点。llama-cli:允许您直接在终端中测试模型。
注意: 这是一个实验性的 MiniMax M3 实现。当前支持文本推理,但该分支未包含 MiniMax 稀疏注意力,因此 llama.cpp 采用稠密注意力。视觉支持与 MTP/投机解码也不在本次构建中。
3. 下载 MiniMax M3 的 GGUF 模型权重
MiniMax M3 以多个 GGUF 文件分发。启动服务器前,请将完整的 UD-IQ3_XXS 文件夹下载到持久化的工作区卷中。
首先安装最新的 Hugging Face Hub CLI:
pip install -U huggingface_hub技术支持
创建模型目录,并启用更快的 Hugging Face 下载:
mkdir -p /workspace/unsloth

export HF_XET_HIGH_PERFORMANCE=1技术支持
然后下载 UD-IQ3_XXS 量化版本:
hf download unsloth/MiniMax-M3-GGUF \
  --include "UD-IQ3_XXS/*" \
  --local-dir /workspace/unsloth技术支持
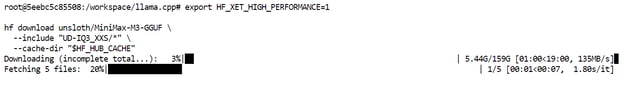
该下载约 159 GB,包含五个 GGUF 分片。由于模型保存在 /workspace,当您停止并重新启动 Pod 时仍可用。
4. 在多 GPU 上本地提供 MiniMax M3 服务
切换到 llama.cpp 目录,并让服务器可见两张 GPU:
cd /workspace/llama.cpp

export CUDA_VISIBLE_DEVICES=0,1技术支持
然后启动 MiniMax M3:
MODEL_FILE="/workspace/unsloth/UD-IQ3_XXS/MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf"

./build/bin/llama-server \
  -m "$MODEL_FILE" \
  --host 0.0.0.0 \
  --port 8910 \
  --ctx-size 8192 \
  --parallel 1 \
  --split-mode layer \
  --tensor-split 1,1 \
  --n-gpu-layers 99 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 40技术支持
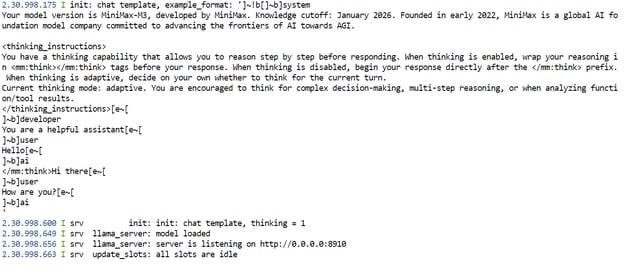
该命令会将 MiniMax M3 加载到两张 RTX PRO 6000 上。--tensor-split 1,1 将模型在两张 GPU 上平均分配,--n-gpu-layers 99 则尽可能将模型保留在显存中。
服务器运行在端口 8910,同时提供 llama.cpp 的网页界面和兼容 OpenAI 的 API。模型运行期间请保持该终端处于打开状态。
从 8K 上下文窗口起步。该实验性 llama.cpp 分支使用稠密注意力而非 MiniMax 稀疏注意力,过大的上下文窗口可能引发内存问题。服务器稳定后,您可尝试 --ctx-size 16384。
再打开一个 JupyterLab 终端,运行以下命令确认两张 GPU 均被使用:
nvidia-smi技术支持
模型加载完成后,您应能看到两张 GPU 的显存占用显著上升。
5. 测试 MiniMax M3 的兼容 OpenAI API 端点
打开新的 JupyterLab 终端,首先确认服务器正在运行且已加载 MiniMax M3:
curl -s http://127.0.0.1:8910/v1/models \
  | python3 -c "import sys, json; print(json.load(sys.stdin)['data'][0]['id'])"技术支持
您应能看到类似如下的模型 ID:
MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf技术支持
接着,向兼容 OpenAI 的聊天补全端点发送测试请求:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function that checks whether a number is prime."
      }
    ],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 512
  }'技术支持
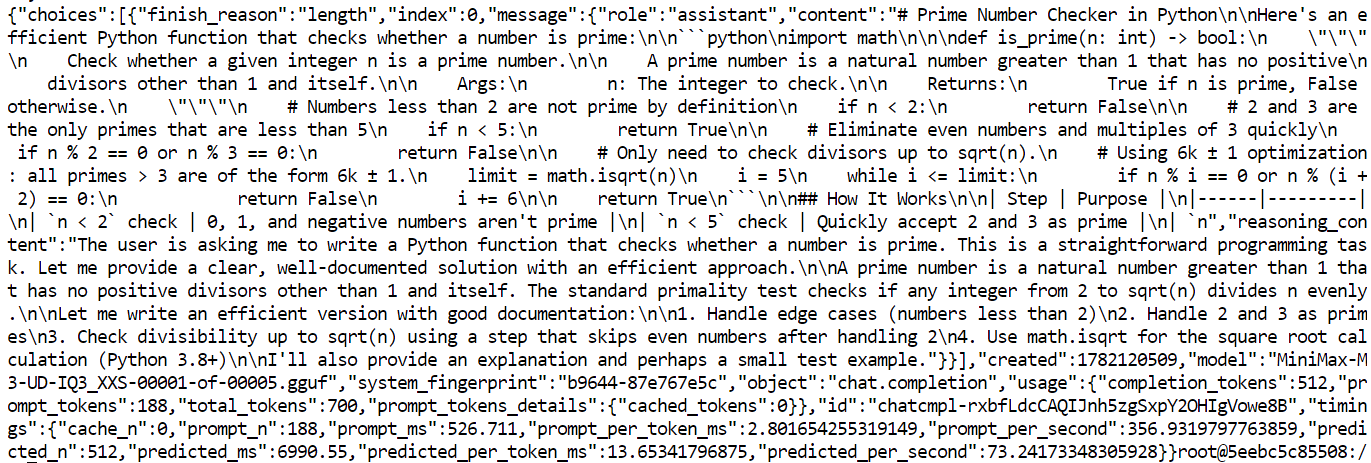
您的本地 MiniMax M3 服务器运行正常。
它生成了一段高效的 Python is_prime() 函数,使用了 math.isqrt() 和 6k ± 1 的优化。
响应被截断是因为触达了 max_tokens 的 512 限制,对应 "finish_reason": "length"
本次测试中,服务器的提示处理速度约为每秒 357 token,文本生成约为每秒 73 token。
具体速度会因上下文长度、GPU 负载与提示大小而异。
6. 通过 llama.cpp 网页界面使用 MiniMax M3
由于端口 8910 已通过 RunPod 暴露,您也可以在内置的 llama.cpp 网页界面中测试 MiniMax M3。
在 RunPod 控制台中打开您的 Pod 并点击 Connect 按钮。在已暴露的 HTTP 端口下,选择 8910 端口的链接。
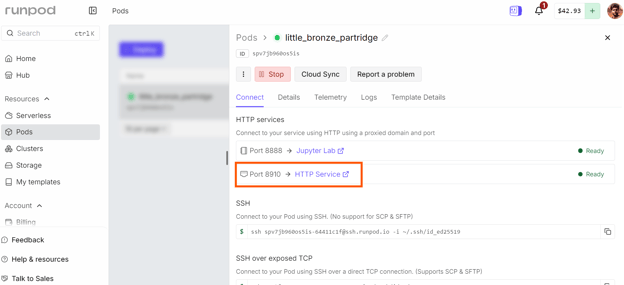
浏览器将打开 llama.cpp 网页界面。它的交互方式类似轻量级的 ChatGPT 聊天应用,并已选择本地运行的 MiniMax M3 模型。现在您无需使用终端或 API,即可直接发送提示并测试模型。
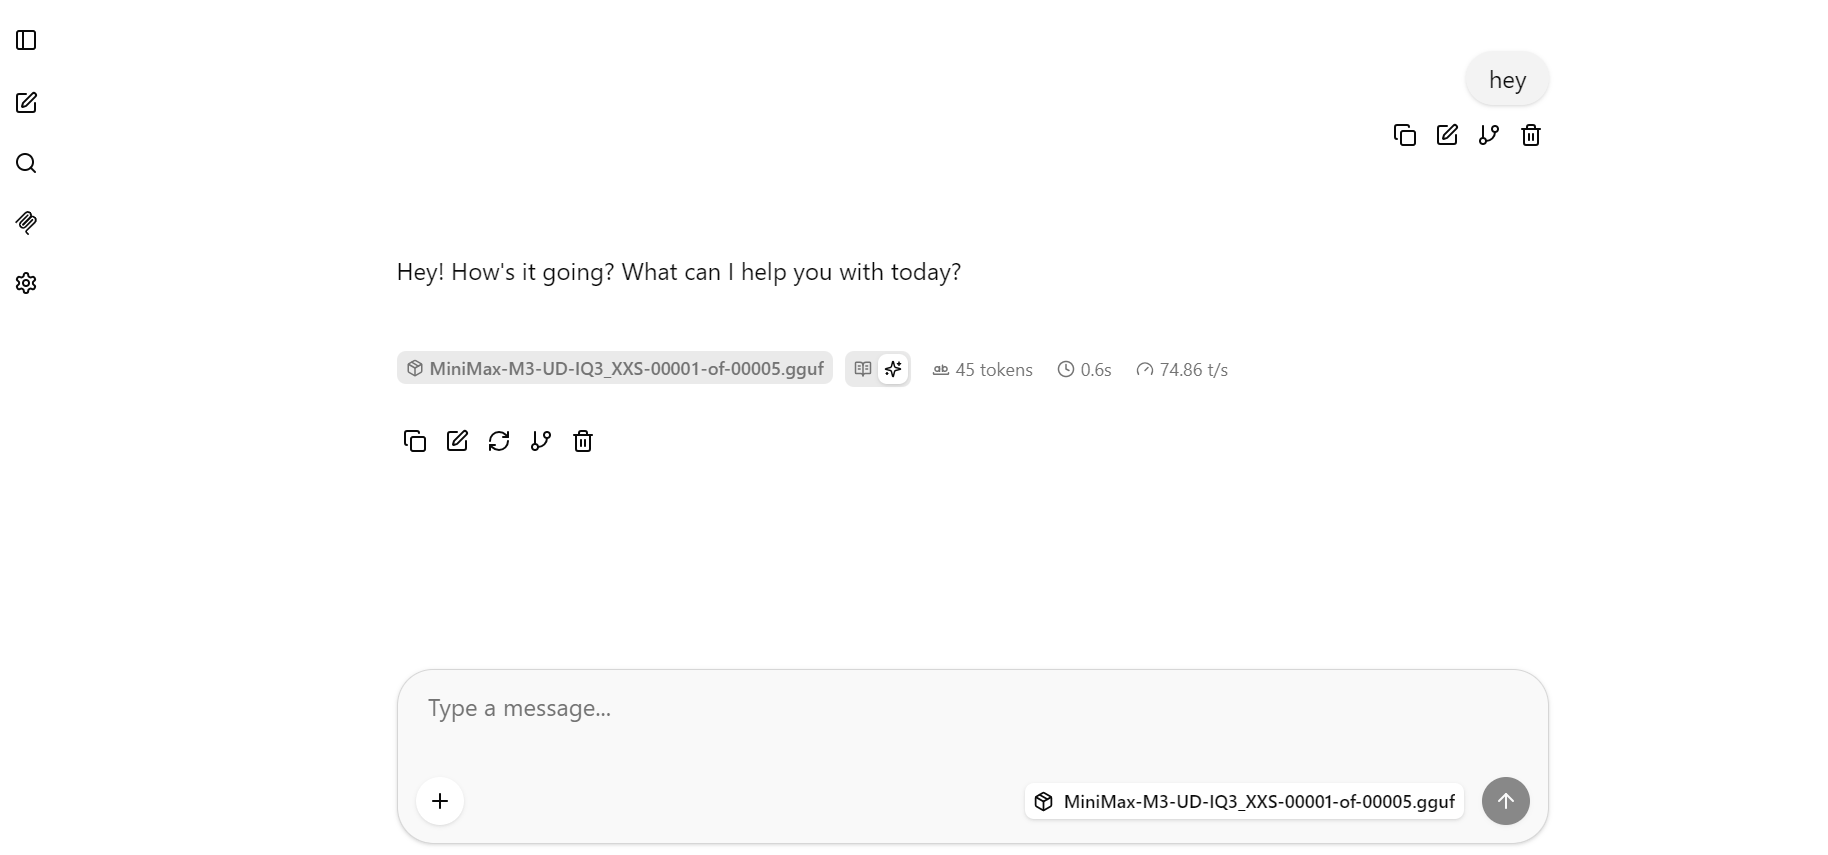
作为一次实用测试,我要求 MiniMax M3 生成一个用于服务机器学习模型的 Python 网页界面。它给出了详尽的基于 FastAPI 的看板设计,包含模型切换、JSON 预测请求、CSV 批量上传、WebSocket 实时流、模型注册表、健康检查端点、结构化日志、测试以及 Docker 配置。
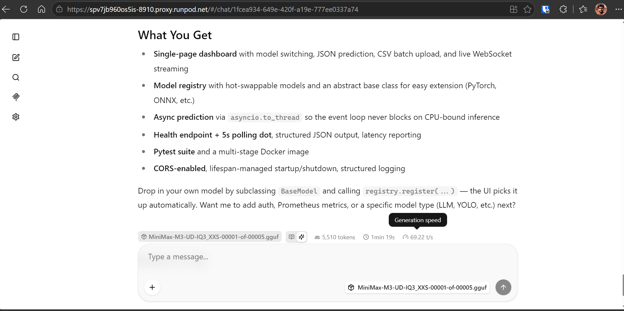
该响应在 1 分 19 秒内生成了 5,510 个 token,速度约为每秒 69 个 token。
对于一个在两张 RTX PRO 6000 上运行的 3-bit 本地量化模型而言,这是一个相当不错的结果,说明 MiniMax M3 能以交互式速度处理较长的编码请求。
7. 将 Pi 编码代理连接到您的本地 LLM
Pi 是一个基于终端的编码代理,可直接与您的本地项目文件协同工作、运行命令、检查代码,并使用您本地部署的 MiniMax M3 模型。
打开第三个 JupyterLab 终端。保持第一个运行 llama-server 的终端不关闭,然后在此终端安装并配置 Pi。
通过官方安装脚本安装 Pi:
curl -fsSL https://pi.dev/install.sh | sh技术支持
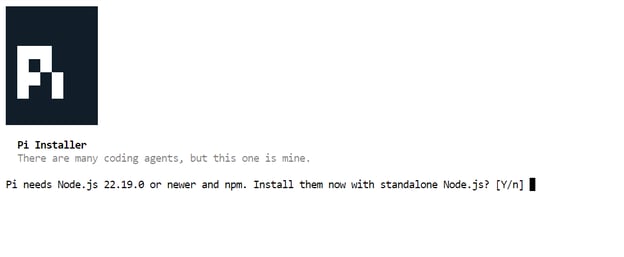 如果安装程序询问是否应安装 Node.js,请输入 Y 并回车。随后 Pi 会安装所需的 Node.js 运行时与 pi 命令行工具。
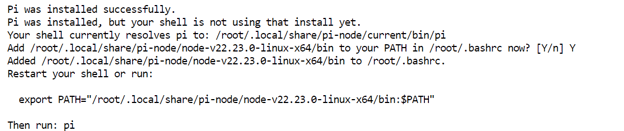
安装完成后,安装器可能会显示一条用于更新 Shell 环境的命令。运行该命令,然后重启 Shell:
exec bash -l技术支持
确认 Pi 可用:
pi --version技术支持
您应能看到已安装的 Pi 版本号。
0.79.10技术支持
Pi 通过 models.json 文件支持自定义兼容 OpenAI 的提供方。先创建 Pi 的配置目录:
mkdir -p ~/.pi/agent技术支持
然后创建提供方配置:
cat > ~/.pi/agent/models.json <<'EOF'
{
  "providers": {
    "local-minimax": {
      "baseUrl": "http://127.0.0.1:8910/v1",
      "api": "openai-completions",
      "apiKey": "none",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false,
        "supportsUsageInStreaming": false,
        "maxTokensField": "max_tokens"
      },
      "models": [
        {
          "id": "MiniMax-M3-UD-IQ3_XXS-00001-of-00005.gguf",
          "name": "MiniMax M3 Local 3-bit",
          "reasoning": false,
          "input": ["text"],
          "contextWindow": 8192,
          "maxTokens": 2048,
          "cost": {
            "input": 0,
            "output": 0,
            "cacheRead": 0,
            "cacheWrite": 0
          }
        }
      ]
    }
  }
}
EOF技术支持
该配置让 Pi 使用运行在 8910 端口上的本地 llama.cpp 服务器。openai-completions 设置与 llama.cpp 的兼容 OpenAI 聊天补全端点一致。
兼容性设置可避免 Pi 发送某些本地兼容 OpenAI 服务器不支持的字段或消息角色引发问题。尤其是,Pi 将使用标准的 system 角色而非较新的 developer 角色,并发送 max_tokens,这正是 llama.cpp 所期望的字段。
该模型被标注为仅文本、8K 上下文窗口,与您先前启动的服务器配置一致。成本被设为零,因为 MiniMax M3 在您的 RunPod 实例本地运行,而非通过付费 API。
8. 使用 MiniMax M3 运行 Pi
为更舒适的编码代理体验,请在新的 JupyterLab 终端中使用 Pi。可在 Settings → Theme → JupyterLab Dark 切换为深色模式。
接下来克隆您希望 MiniMax M3 处理的项目:
cd /workspace

git clone https://github.com/kingabzpro/semantic-web-cache
cd semantic-web-cache技术支持
启动 Pi:
pi技术支持
在 Pi 中输入:
/model技术支持
搜索 local,然后选择 MiniMax M3 Local 3-bit。Pi 应显示本地提供方,并确认已选择 MiniMax M3 GGUF 模型。
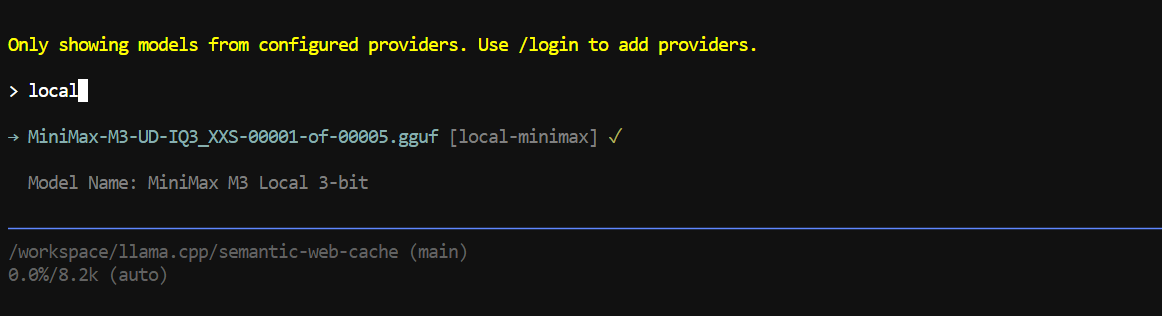
先以只读任务开始,让 Pi 在不改动任何文件的情况下检查代码库。例如:
"Read the README.md file and explain how this project is structured."技术支持
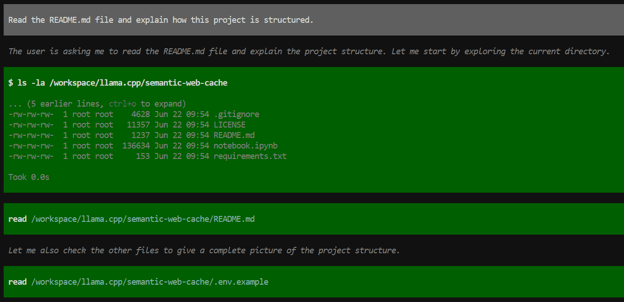
Pi 会使用诸如 ls 与 read 等终端工具探索仓库,查看 README,并审阅 .env.example、requirements.txt 与 Jupyter 笔记本等配套文件。
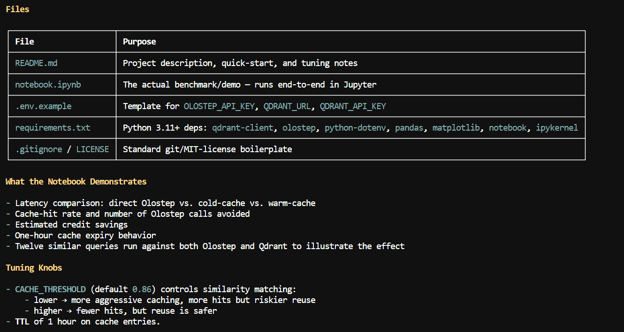
在该示例中,MiniMax M3 正确识别了主要项目文件,并说明该仓库是基于 Olostep 与 Qdrant 构建的语义缓存演示。
它指出了基于笔记本的工作流、API 所需的环境变量、缓存阈值与 TTL 设置,以及项目中包含的延迟、缓存命中率与节省代币消耗的评估。
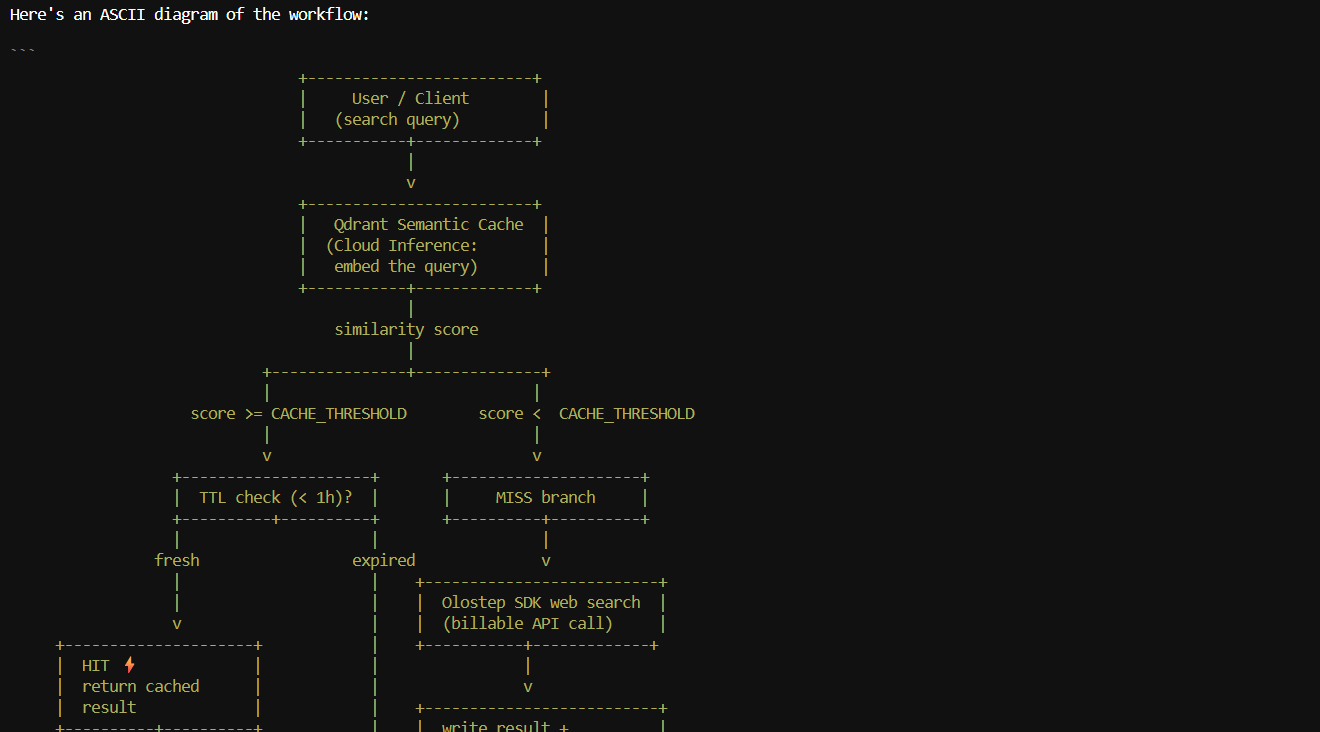
我还要求其绘制语义缓存管线的 ASCII 工作流图。它生成了清晰的流程:用户查询如何被嵌入、在 Qdrant 缓存中查找、基于相似度阈值判定,并决定是直接从缓存返回还是发送至 Olostep,然后再存储结果。
对于更大的代码库或更深入的多步任务,您可能需要更大的上下文窗口。请在 llama-server 命令中调整 --ctx-size,并重启服务器。先从 8192 提升到 16384,若显存仍有余量,再测试 32768`。
避免直接跳到 100K 上下文窗口。这个实验性的 MiniMax M3 llama.cpp 分支使用稠密注意力而非 MiniMax 稀疏注意力,超大上下文会显著增加内存占用并可能导致 OOM 错误。
结语
在本地运行 MiniMax M3 后,我认为相较于尝试运行诸如GLM 5.2 或 Kimi K2.7 Code 这类超大编码模型,MiniMax M3 实用性更强、平衡更好。
这些模型在某些场景下也许更强,但它们需要的 GPU 显存多得多,本地租用与服务成本也会高不少。
借助 MiniMax M3,我能在两张 RTX PRO 6000 上运行一款能编码、能代理的模型,通过浏览器界面使用它,通过兼容 OpenAI 的 API 对外暴露,并将其作为本地编码代理连接到 Pi。
在我的测试中,它的生成速度大约为每秒 70 个 token,能很好地处理代码库探索、README 分析、命令执行、项目说明和工作流图。
当然,这套方案还不算完美:llama.cpp 支持仍处于实验阶段,稀疏注意力尚不可用,而且除非您拥有更多显存,上下文窗口需要保持相对较小。尽管如此,作为一款 3-bit 量化且本地运行的模型,结果已相当令人印象深刻。


MiniMax M3 是 MiniMax 最新的开源权重模型,面向编码、工具使用以及长时程代理工作流。与早期的 MiniMax 模型相比,它的亮点在于:提供 100 万 token 的上下文窗口;原生多模态支持文本、图像和视频;以及 MiniMax 稀疏注意力(Sparse Attention),旨在让超长上下文推理更实用。
来源: MiniMax
本指南将演示如何在两张 NVIDIA RTX PRO 6000 GPU 上本地运行 MiniMax M3,使用其内置网页界面测试模型,并将本地兼容 OpenAI 的端点连接到 Pi 编码代理。
整个流程在 RunPod 的 PyTorch Pod 上通过 JupyterLab 终端完成,而非使用 SSH;llama.cpp 将以启用 CUDA 的方式编译,并在端口
8910提供服务。本地运行 MiniMax M3 的系统要求
在本地运行 MiniMax M3 之前,请确保系统拥有足够的 GPU 显存和存储空间以加载模型。
unsloth/MiniMax-M3-GGUF提供的UD-IQ3_XXSGGUF 量化版本。该文件约 159 GB,是此硬件上最实用的选择。llama.cpp构建。MiniMax M3 是一个大型专家混合(MoE)模型,因此在推理时需要将权重分布到两张 GPU 上。尽管系统总计提供 192 GB 显存,但并非全部都可用于模型本身。
一部分显存需要用于运行时开销、提示处理以及 KV 缓存。
因此,建议从
UD-IQ3_XXS量化版本开始。其约 159 GB,能为模型加载与运行留出足够的空间。在该配置下请避免使用 4-bit 的 MiniMax M3 量化版本,因为最小的 4-bit 文件约为 208 GB,在考虑运行时开销之前就已超出可用显存。
1. 配置 RunPod 多 GPU 环境
创建一个新的 RunPod Pod,选择 2× NVIDIA RTX PRO 6000 GPU,并使用最新的 RunPod PyTorch 模板。该模板内置 JupyterLab,本文将全程以此替代 SSH。
按以下设置配置 Pod:
50 GB300 GB8910HF_TOKEN:您的 Hugging Face 访问令牌50 GB 的容器磁盘仅用于操作系统、软件包和临时文件。300 GB 的卷磁盘用于存放 MiniMax M3 模型和 Hugging Face 缓存。
暴露 HTTP 端口
8910,稍后 llama.cpp 将在该端口运行网页界面和兼容 OpenAI 的 API。服务器启动后,您可以通过如下格式的 URL 访问:https://<POD_ID>-8910.proxy.runpod.net
本指南所用 Pod 配置的费用约为每小时 $4.23,实际价格可能因供给和地域而变化。
建议至少保留$10 的 RunPod 余额,首次构建、下载模型并测试时以 $15–$20 更为稳妥。
Pod 启动后,在 RunPod 控制台中打开它:
首先确认两张 GPU 都可用:
您应能看到两张 NVIDIA RTX PRO 6000,每张约 96 GB 显存。
接着安装必要的构建工具:
最后,验证 CUDA 是否可用:
您应能看到 CUDA 12.8 或兼容版本。现在可以开始以 CUDA 支持构建 llama.cpp。
2. 以 CUDA 构建 MiniMax M3 的 llama.cpp 分支
llama.cpp 是一个用于本地运行 GGUF 模型的开源推理引擎。如果您还不熟悉,建议阅读我们的完整 llama.cpp 指南。
它支持 CUDA 加速、多 GPU 卸载、内置网页界面以及兼容 OpenAI 的 API 服务器。
MiniMax M3 的支持仍属试验性,因此需要从专用的
minimax-m3分支构建 llama.cpp,而不是使用标准发行版。在 JupyterLab 终端中运行以下命令:
随后启用 CUDA 支持并编译服务器与命令行可执行文件:
这会在
build/bin/目录下生成两个二进制文件:llama-server:提供基于浏览器的聊天界面和兼容 OpenAI 的 API 端点。llama-cli:允许您直接在终端中测试模型。注意: 这是一个实验性的 MiniMax M3 实现。当前支持文本推理,但该分支未包含 MiniMax 稀疏注意力,因此 llama.cpp 采用稠密注意力。视觉支持与 MTP/投机解码也不在本次构建中。
3. 下载 MiniMax M3 的 GGUF 模型权重
MiniMax M3 以多个 GGUF 文件分发。启动服务器前,请将完整的
UD-IQ3_XXS文件夹下载到持久化的工作区卷中。首先安装最新的 Hugging Face Hub CLI:
创建模型目录,并启用更快的 Hugging Face 下载:
然后下载
UD-IQ3_XXS量化版本:该下载约 159 GB,包含五个 GGUF 分片。由于模型保存在
/workspace,当您停止并重新启动 Pod 时仍可用。4. 在多 GPU 上本地提供 MiniMax M3 服务
切换到 llama.cpp 目录,并让服务器可见两张 GPU:
然后启动 MiniMax M3:
该命令会将 MiniMax M3 加载到两张 RTX PRO 6000 上。
--tensor-split 1,1将模型在两张 GPU 上平均分配,--n-gpu-layers 99则尽可能将模型保留在显存中。服务器运行在端口 8910
,同时提供 llama.cpp 的网页界面和兼容 OpenAI 的 API。模型运行期间请保持该终端处于打开状态。从 8K 上下文窗口起步。该实验性 llama.cpp 分支使用稠密注意力而非 MiniMax 稀疏注意力,过大的上下文窗口可能引发内存问题。服务器稳定后,您可尝试 --ctx-size 16384
。再打开一个 JupyterLab 终端,运行以下命令确认两张 GPU 均被使用:
模型加载完成后,您应能看到两张 GPU 的显存占用显著上升。
5. 测试 MiniMax M3 的兼容 OpenAI API 端点
打开新的 JupyterLab 终端,首先确认服务器正在运行且已加载 MiniMax M3:
您应能看到类似如下的模型 ID:
接着,向兼容 OpenAI 的聊天补全端点发送测试请求:
您的本地 MiniMax M3 服务器运行正常。
它生成了一段高效的 Python is_prime()
函数,使用了math.isqrt()和6k ± 1的优化。响应被截断是因为触达了 max_tokens
的 512 限制,对应 "finish_reason": "length"本次测试中,服务器的提示处理速度约为每秒 357 token,文本生成约为每秒 73 token。
具体速度会因上下文长度、GPU 负载与提示大小而异。
6. 通过 llama.cpp 网页界面使用 MiniMax M3
由于端口
8910已通过 RunPod 暴露,您也可以在内置的 llama.cpp 网页界面中测试 MiniMax M3。在 RunPod 控制台中打开您的 Pod 并点击 Connect 按钮。在已暴露的 HTTP 端口下,选择
8910端口的链接。浏览器将打开 llama.cpp 网页界面。它的交互方式类似轻量级的 ChatGPT 聊天应用,并已选择本地运行的 MiniMax M3 模型。现在您无需使用终端或 API,即可直接发送提示并测试模型。
作为一次实用测试,我要求 MiniMax M3 生成一个用于服务机器学习模型的 Python 网页界面。它给出了详尽的基于 FastAPI 的看板设计,包含模型切换、JSON 预测请求、CSV 批量上传、WebSocket 实时流、模型注册表、健康检查端点、结构化日志、测试以及 Docker 配置。
该响应在 1 分 19 秒内生成了 5,510 个 token,速度约为每秒 69 个 token。
对于一个在两张 RTX PRO 6000 上运行的 3-bit 本地量化模型而言,这是一个相当不错的结果,说明 MiniMax M3 能以交互式速度处理较长的编码请求。
7. 将 Pi 编码代理连接到您的本地 LLM
Pi 是一个基于终端的编码代理,可直接与您的本地项目文件协同工作、运行命令、检查代码,并使用您本地部署的 MiniMax M3 模型。
打开第三个 JupyterLab 终端。保持第一个运行 llama-server
的终端不关闭,然后在此终端安装并配置 Pi。通过官方安装脚本安装 Pi:
安装完成后,安装器可能会显示一条用于更新 Shell 环境的命令。运行该命令,然后重启 Shell:
确认 Pi 可用:
您应能看到已安装的 Pi 版本号。
Pi 通过 models.json 文件支持自定义兼容 OpenAI 的提供方。先创建 Pi 的配置目录:
然后创建提供方配置:
该配置让 Pi 使用运行在
8910端口上的本地 llama.cpp 服务器。openai-completions设置与 llama.cpp 的兼容 OpenAI 聊天补全端点一致。兼容性设置可避免 Pi 发送某些本地兼容 OpenAI 服务器不支持的字段或消息角色引发问题。尤其是,Pi 将使用标准的 system 角色而非较新的 developer 角色,并发送
max_tokens,这正是 llama.cpp 所期望的字段。该模型被标注为仅文本、8K 上下文窗口,与您先前启动的服务器配置一致。成本被设为零,因为 MiniMax M3 在您的 RunPod 实例本地运行,而非通过付费 API。
8. 使用 MiniMax M3 运行 Pi
为更舒适的编码代理体验,请在新的 JupyterLab 终端中使用 Pi。可在 Settings → Theme → JupyterLab Dark 切换为深色模式。
接下来克隆您希望 MiniMax M3 处理的项目:
启动 Pi:
在 Pi 中输入:
搜索 local
,然后选择 MiniMax M3 Local 3-bit。Pi 应显示本地提供方,并确认已选择 MiniMax M3 GGUF 模型。先以只读任务开始,让 Pi 在不改动任何文件的情况下检查代码库。例如:
Pi 会使用诸如 ls
与read等终端工具探索仓库,查看 README,并审阅.env.example、requirements.txt与 Jupyter 笔记本等配套文件。在该示例中,MiniMax M3 正确识别了主要项目文件,并说明该仓库是基于 Olostep 与 Qdrant 构建的语义缓存演示。
它指出了基于笔记本的工作流、API 所需的环境变量、缓存阈值与 TTL 设置,以及项目中包含的延迟、缓存命中率与节省代币消耗的评估。
我还要求其绘制语义缓存管线的 ASCII 工作流图。它生成了清晰的流程:用户查询如何被嵌入、在 Qdrant 缓存中查找、基于相似度阈值判定,并决定是直接从缓存返回还是发送至 Olostep,然后再存储结果。
对于更大的代码库或更深入的多步任务,您可能需要更大的上下文窗口。请在 llama-server
命令中调整--ctx-size,并重启服务器。先从8192提升到16384,若显存仍有余量,再测试32768`。避免直接跳到 100K 上下文窗口。这个实验性的 MiniMax M3 llama.cpp 分支使用稠密注意力而非 MiniMax 稀疏注意力,超大上下文会显著增加内存占用并可能导致 OOM 错误。
结语
在本地运行 MiniMax M3 后,我认为相较于尝试运行诸如GLM 5.2 或 Kimi K2.7 Code 这类超大编码模型,MiniMax M3 实用性更强、平衡更好。
这些模型在某些场景下也许更强,但它们需要的 GPU 显存多得多,本地租用与服务成本也会高不少。
借助 MiniMax M3,我能在两张 RTX PRO 6000 上运行一款能编码、能代理的模型,通过浏览器界面使用它,通过兼容 OpenAI 的 API 对外暴露,并将其作为本地编码代理连接到 Pi。
在我的测试中,它的生成速度大约为每秒 70 个 token,能很好地处理代码库探索、README 分析、命令执行、项目说明和工作流图。
当然,这套方案还不算完美:llama.cpp 支持仍处于实验阶段,稀疏注意力尚不可用,而且除非您拥有更多显存,上下文窗口需要保持相对较小。尽管如此,作为一款 3-bit 量化且本地运行的模型,结果已相当令人印象深刻。