Meta Superintelligence Labs 于 2026 年 8 月 10 日发布了 Muse Glimmer,这次 2026 年新模型发布的独特之处在于:它能在笔记本电脑上运行。
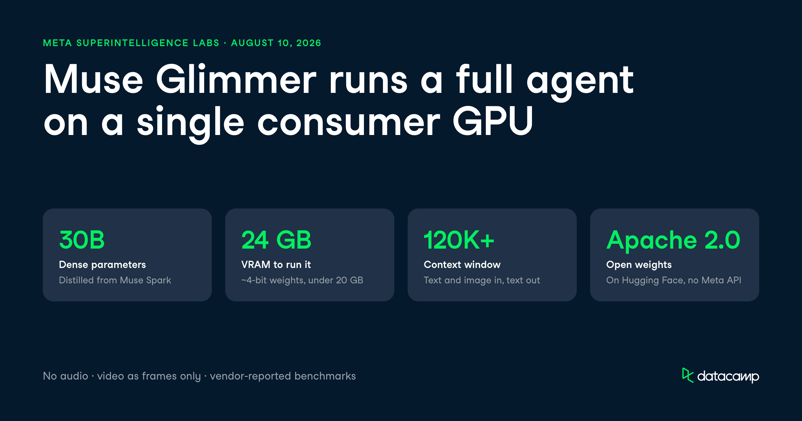
这是一个面向本地、常驻工作流打造的 300 亿参数智能体模型,以 Apache 2.0 许可证开源权重发布。
最引人注目的卖点是:Muse Glimmer 可在单块 24 GB 消费级 GPU 或 Mac 级统一内存系统上,作为完整智能体运行(规划、工具调用、自检与故障恢复)。它配备 12 万+上下文窗口,支持文本与图像多模态输入,并提供量化权重,将模型压缩至 20 GB 以内。Meta 已在 Hugging Face 开源权重,并提供开发者文档。
本文将全面介绍 Muse Glimmer 的新变化,包括功能亮点、与 Qwen3.6-27B 和 Gemma4-31B 的基准对比,以及本地部署技巧。您也可以阅读我们的独立本地运行 Muse Glimmer 进行 AI 编码指南。
若想进一步了解本地运行模型,请查看我们的Qwen3.6 微调教程,并通过AI 智能体基础技能路径快速上手。
要点速览
- Muse Glimmer 是 Meta Superintelligence Labs 于 2026 年 8 月 10 日发布的 30B 开源权重(Apache 2.0)智能体模型。
- 可在单块 24 GB 或 32 GB GPU 或 Mac 上本地运行,权重量化至约 4 比特(小于 20 GB)。
- 在 MCP-Atlas(75.5)与 DeepSearch QA(74.6)上领跑同量级,但在 OSWorld-Verified 和 Terminal-Bench 2.1 上落后于 Qwen3.6-27B。
- 支持文本与图像输入,仅输出文本。不支持音频,视频按逐帧处理。
- 无 Meta 自托管 API;需自托管或使用 Together AI、Fireworks AI 等第三方服务。
Muse Glimmer 是什么?
Muse Glimmer 是来自 Meta Superintelligence Labs 的 300 亿参数致密模型,重点优化于本地智能体工作流,而非云端聊天。
它定位为更大型内部教师模型 Muse Spark 的更小型蒸馏“兄弟”,Meta 明确表示 Muse Glimmer 不符合其“前沿 AI(Frontier AI)”定义。
此处的新意在于部署目标。
大多数具备此等能力的智能体模型都假设有数据中心支撑,而 Muse Glimmer 旨在离线运行于单块消费级 GPU 上。
Meta 将权重量化压缩至约 4 比特,使语言模型小于 20 GB,从而在 24 GB 或 32 GB 的内存预算中仍有余量。
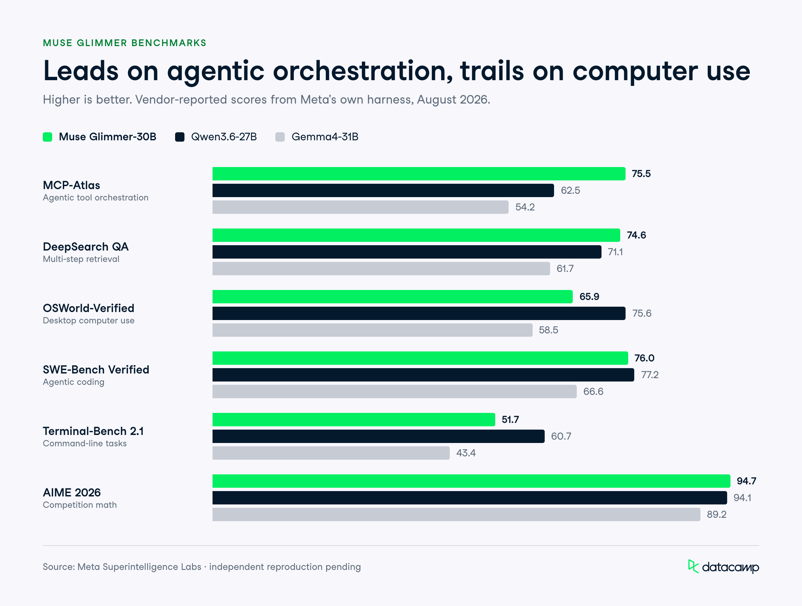
最醒目的基准是通用智能体基准 MCP-Atlas:Muse Glimmer 得分 75.5,对比 Qwen3.6-27B 的 62.5 与 Gemma4-31B 的 54.2。
对于一款可在无网络下运行的模型而言,在智能体编排上领跑同量级,正是这次发布的意义所在。
Muse Glimmer 的核心特性
Muse Glimmer 围绕本地运行个人智能体而构建,其特性聚焦于任务完成、工具使用,以及在有限硬件上的高响应性。
以下是对实践者最关键的能力。
离线运行完整智能体
您可以将 Muse Glimmer 指向一个多步骤任务,让其进行规划、调用工具、自检并在无网络的情况下从失败中恢复。
Meta 首席 AI 官 Alexandr Wang 表示,该模型可“作为功能完备的智能体”运行,并可在 24 GB 显存条件下保持智能体级的可靠性。
对实践者而言,这改变了智能体的部署场所。
一个帮您撰写邮件、整理文件或梳理日程的模型需要深度访问个人上下文,将这些上下文保留在设备上与发往云端 API 的隐私姿态截然不同。
具备失败恢复的可靠工具调用
Muse Glimmer 可在长链路工作流中按精确模式调用工具;当调用失败或返回异常结果时,模型会诊断错误并重试,而不是直接中止。这样的失败恢复能力,决定了一个智能体是把任务做完,还是中途停摆。
它可适配 OpenClaw 等多种智能体编排范式,避免被锁定在单一脚手架中。
Meta 在文档中提供了搭建自定义脚手架的指南,这很关键,因为智能体质量往往更多取决于外部的“束具”,而不仅仅是底层模型。
读取截图、图表与文档
借助专用感知编码器,Muse Glimmer 支持交错的文本与图像输入,因此智能体可以在对话中理解错误对话框的截图、销售图表或扫描发票。
这是“文本与图像输入、仅文本输出”。
这里有个需要强调的实际限制:没有音频输入输出,视频仅按独立帧处理,而非真正的视频理解。
如果您的工作流需要端到端观看屏幕录制,这不是合适的模型。
可控的推理强度
Muse Glimmer 支持不同的推理强度,您可以根据任务在质量与速度间取舍。
重命名文件的简单智能体无需与多步骤调试相同的深度思考,能够在设备上灵活调节有助于维持低延迟。
模型亦训练于 100 多种语言的数据之上,但 Meta 提醒并未对所有语言进行评估,超出强支持语种范围时质量可能下降。
Meta 使用自家测试框架,将 Muse Glimmer 与 Gemma4-31B、Qwen3.6-27B 在智能体、编码、多模态、安全与推理等维度进行了对比评估。
撰文时尚无独立复现结果落地,因此这些数据应视为厂商指标。
Muse Glimmer 在通用智能体基准上领跑同量级,但在多项电脑使用与终端任务上落后于 Qwen3.6-27B。
Muse Glimmer vs Qwen3.6-27B vs Gemma4-31B 一览
下表可快速对比 Muse Glimmer 与竞品的表现:
| Benchmark | Muse Glimmer-30B | Qwen3.6-27B | Gemma4-31B |
|---|
| MCP-Atlas | 75.5 | 62.5 | 54.2 |
| DeepSearch QA | 74.6 | 71.1 | 61.7 |
| OSWorld-Verified | 65.9 | 75.6 | 58.5 |
| SWE-Bench Verified | 76.0 | 77.2 | 66.6 |
| Terminal-Bench 2.1 | 51.7 | 60.7 | 43.4 |
| AIME 2026 | 94.7 | 94.1 | 89.2 |
| GPQA Diamond | 83.5 | 84.2 | 85.7 |
| MMMU Pro | 74 | 75 | 73 |
MCP-Atlas 与通用智能体
MCP-Atlas 评估模型通过 Model Context Protocol 编排工具调用的能力。Muse Glimmer 得分 75.5,对比 Qwen3.6-27B 的 62.5 和 Gemma4-31B 的 54.2。
在多步骤信息检索基准 DeepSearch QA 上,Muse Glimmer 得分 74.6,略高于 Qwen3.6-27B 的 71.1,且显著领先于 Gemma4-31B 的 61.7。
结果并不一边倒。在 OSWorld-Verified(在真实桌面环境测试电脑使用智能体)上,Muse Glimmer 得分 65.9,而 Qwen3.6-27B 以 75.6 领先,因此在“驱屏类”智能体上 Qwen 更具优势。
SWE-Bench 与智能体编码
SWE-Bench Verified 测试模型能否通过编写与调试代码解决真实的 GitHub 问题。
Muse Glimmer 得分 76.0,接近 Qwen3.6-27B 的 77.2,领先于 Gemma4-31B 的 66.6。
在命令行任务完成度测试 Terminal-Bench 2.1 上,Muse Glimmer 以 51.7 落后于 Qwen3.6-27B 的 60.7。作为参考,我们在自己的Qwen3.6 微调教程中发现,其在 SWE-Bench 与 Terminal-Bench 上的优势在实操中同样明显,这与此处 Qwen 在终端任务上的领先相吻合。
推理:AIME 2026 与 GPQA Diamond
AIME 2026 是竞赛数学基准,Muse Glimmer 得分 94.7,略高于 Qwen3.6-27B 的 94.1,并领先 Gemma4-31B 的 89.2。
对这样体量的模型而言,这是很强的结果。
在研究生难度的科学问答 GPQA Diamond 上,Muse Glimmer 得分 83.5,Gemma4-31B 以 85.7 领先,Qwen3.6-27B 为 84.2。
在 Humanity's Last Exam(纯文本、无工具)上,Muse Glimmer 得分 22.0,略落后于两位对手。
多模态:MMMU Pro 与 Charxiv
MMMU Pro 测试图文多模态推理(研究生难度),三者表现几乎一致:Muse Glimmer 74、Qwen3.6-27B 75、Gemma4-31B 73。
在图表理解的 Charxiv Reasoning 上,Muse Glimmer 得分 78.8,略高于两位对手。
Meta 对 ScreenSpot Pro 的自家强项说法并未完全兑现:Muse Glimmer 得分 75.4,而 Qwen3.6-27B 以 76.1 领先。
总体来看,多模态项目的差距不足以成为这几款模型间的决定性因素。
安全性:CI Memories 与 Siren AgentDojo
在衡量隐私违规率(越低越好)的 CI Memories 上,Muse Glimmer 的违规率为 26.4,对比 Gemma4-31B 更低的 12.1 与 Qwen3.6-27B 的 53.4。
因此在该指标上,Muse Glimmer 介于两者之间,比 Qwen 更安全,但明显落后于 Gemma。
在测量对提示注入攻击抵抗力的 Siren AgentDojo 上,Muse Glimmer 显示 28.4 的攻击成功率与 94.2 的可用性;Gemma4-31B 为 25.6,Qwen3.6-27B 为 40.3。若您的智能体需接触不受信内容,这方面的抗注入能力值得权衡。
Muse Glimmer 的价格与可用性
Muse Glimmer 以 Apache 2.0 许可证开源权重形式发布,Meta 不提供自家托管的第一方 API。
这意味着 Meta 不会有按 Token 计费:您的成本在于基础设施与自托管,而非按量计费的 API。
您可以通过以下途径开始使用:
- 直接从 Hugging Face 下载权重
- 通过 Ollama、LM Studio 或 Unsloth 本地运行
- 在 llama.cpp、ExecuTorch 与 MLX 等边缘框架上部署
- 使用 vLLM 与 SGLang 进行大规模服务
- 选择 Together AI、Fireworks AI、OpenRouter 等托管第三方
- 使用 PyTorch 的 TorchTitan 进一步微调
Meta 正与 AMD、Arm、Dell、Intel 与 NVIDIA 合作,在多种设备上调优性能。
实际硬件目标是 24 GB 或 32 GB 机器:Meta 报告称,K-Quant-17GB 构建加上量化的 DFlash drafter,可在 RTX 5090 上将解码加速至 3.1 倍,在 M5 Max 上为 1.8 倍,在 M4 Max 上为 1.5 倍。
结语
Muse Glimmer 体现了 Meta 对本地、私密、开源权重智能体的明确押注,而非再打造一个云端旗舰。
通过将规模限定在 30B,并发布可在单块消费级 GPU 上承载的量化权重,Meta 瞄准了多数实验室忽视的细分场景:希望在离线环境下运行、且个人上下文从不离开设备的开发者。
坦率地说,这是一套面向构建者的技术栈,而非“一键”替代云端。
基准表现喜忧参半(Qwen3.6-27B 仍在 OSWorld-Verified 与 Terminal-Bench 2.1 上领先,Gemma4-31B 在 CI Memories 上更“干净”),且有评测者指出 Muse Glimmer 在逼近内存上限时偏慢且脆弱。但其在 MCP-Atlas 与 DeepSearch QA 上领跑同量级,加之宽松的 Apache 2.0 许可证,使其成为搭建本地智能体的有力选项。
需要注意的限制包括:不支持音频、视频仅按帧处理、语言覆盖不均衡,以及在独立复现出现前仅有厂商基准。
如果您的工作流对隐私敏感,或确实需要在无网络环境下运行,Muse Glimmer 值得下载并在您的硬件上与 Qwen3.6 进行对比测试。
若您希望亲自掌握此类模型的运行与调优技能,推荐我们的首个自主 AI 智能体构建教程。


Meta Superintelligence Labs 于 2026 年 8 月 10 日发布了 Muse Glimmer,这次 2026 年新模型发布的独特之处在于:它能在笔记本电脑上运行。
这是一个面向本地、常驻工作流打造的 300 亿参数智能体模型,以 Apache 2.0 许可证开源权重发布。
最引人注目的卖点是:Muse Glimmer 可在单块 24 GB 消费级 GPU 或 Mac 级统一内存系统上,作为完整智能体运行(规划、工具调用、自检与故障恢复)。它配备 12 万+上下文窗口,支持文本与图像多模态输入,并提供量化权重,将模型压缩至 20 GB 以内。Meta 已在 Hugging Face 开源权重,并提供开发者文档。
本文将全面介绍 Muse Glimmer 的新变化,包括功能亮点、与 Qwen3.6-27B 和 Gemma4-31B 的基准对比,以及本地部署技巧。您也可以阅读我们的独立本地运行 Muse Glimmer 进行 AI 编码指南。
若想进一步了解本地运行模型,请查看我们的Qwen3.6 微调教程,并通过AI 智能体基础技能路径快速上手。
要点速览
Muse Glimmer 是什么?
Muse Glimmer 是来自 Meta Superintelligence Labs 的 300 亿参数致密模型,重点优化于本地智能体工作流,而非云端聊天。
它定位为更大型内部教师模型 Muse Spark 的更小型蒸馏“兄弟”,Meta 明确表示 Muse Glimmer 不符合其“前沿 AI(Frontier AI)”定义。
此处的新意在于部署目标。
大多数具备此等能力的智能体模型都假设有数据中心支撑,而 Muse Glimmer 旨在离线运行于单块消费级 GPU 上。
Meta 将权重量化压缩至约 4 比特,使语言模型小于 20 GB,从而在 24 GB 或 32 GB 的内存预算中仍有余量。
最醒目的基准是通用智能体基准 MCP-Atlas:Muse Glimmer 得分 75.5,对比 Qwen3.6-27B 的 62.5 与 Gemma4-31B 的 54.2。
对于一款可在无网络下运行的模型而言,在智能体编排上领跑同量级,正是这次发布的意义所在。
Muse Glimmer 的核心特性
Muse Glimmer 围绕本地运行个人智能体而构建,其特性聚焦于任务完成、工具使用,以及在有限硬件上的高响应性。
以下是对实践者最关键的能力。
离线运行完整智能体
您可以将 Muse Glimmer 指向一个多步骤任务,让其进行规划、调用工具、自检并在无网络的情况下从失败中恢复。
Meta 首席 AI 官 Alexandr Wang 表示,该模型可“作为功能完备的智能体”运行,并可在 24 GB 显存条件下保持智能体级的可靠性。
对实践者而言,这改变了智能体的部署场所。
一个帮您撰写邮件、整理文件或梳理日程的模型需要深度访问个人上下文,将这些上下文保留在设备上与发往云端 API 的隐私姿态截然不同。
具备失败恢复的可靠工具调用
Muse Glimmer 可在长链路工作流中按精确模式调用工具;当调用失败或返回异常结果时,模型会诊断错误并重试,而不是直接中止。这样的失败恢复能力,决定了一个智能体是把任务做完,还是中途停摆。
它可适配 OpenClaw 等多种智能体编排范式,避免被锁定在单一脚手架中。
Meta 在文档中提供了搭建自定义脚手架的指南,这很关键,因为智能体质量往往更多取决于外部的“束具”,而不仅仅是底层模型。
读取截图、图表与文档
借助专用感知编码器,Muse Glimmer 支持交错的文本与图像输入,因此智能体可以在对话中理解错误对话框的截图、销售图表或扫描发票。
这是“文本与图像输入、仅文本输出”。
这里有个需要强调的实际限制:没有音频输入输出,视频仅按独立帧处理,而非真正的视频理解。
如果您的工作流需要端到端观看屏幕录制,这不是合适的模型。
可控的推理强度
Muse Glimmer 支持不同的推理强度,您可以根据任务在质量与速度间取舍。
重命名文件的简单智能体无需与多步骤调试相同的深度思考,能够在设备上灵活调节有助于维持低延迟。
模型亦训练于 100 多种语言的数据之上,但 Meta 提醒并未对所有语言进行评估,超出强支持语种范围时质量可能下降。
Muse Glimmer 基准测试
Meta 使用自家测试框架,将 Muse Glimmer 与 Gemma4-31B、Qwen3.6-27B 在智能体、编码、多模态、安全与推理等维度进行了对比评估。
撰文时尚无独立复现结果落地,因此这些数据应视为厂商指标。
Muse Glimmer 在通用智能体基准上领跑同量级,但在多项电脑使用与终端任务上落后于 Qwen3.6-27B。
Muse Glimmer vs Qwen3.6-27B vs Gemma4-31B 一览
下表可快速对比 Muse Glimmer 与竞品的表现:
MCP-Atlas 与通用智能体
MCP-Atlas 评估模型通过 Model Context Protocol 编排工具调用的能力。Muse Glimmer 得分 75.5,对比 Qwen3.6-27B 的 62.5 和 Gemma4-31B 的 54.2。
在多步骤信息检索基准 DeepSearch QA 上,Muse Glimmer 得分 74.6,略高于 Qwen3.6-27B 的 71.1,且显著领先于 Gemma4-31B 的 61.7。
结果并不一边倒。在 OSWorld-Verified(在真实桌面环境测试电脑使用智能体)上,Muse Glimmer 得分 65.9,而 Qwen3.6-27B 以 75.6 领先,因此在“驱屏类”智能体上 Qwen 更具优势。
SWE-Bench 与智能体编码
SWE-Bench Verified 测试模型能否通过编写与调试代码解决真实的 GitHub 问题。
Muse Glimmer 得分 76.0,接近 Qwen3.6-27B 的 77.2,领先于 Gemma4-31B 的 66.6。
在命令行任务完成度测试 Terminal-Bench 2.1 上,Muse Glimmer 以 51.7 落后于 Qwen3.6-27B 的 60.7。作为参考,我们在自己的Qwen3.6 微调教程中发现,其在 SWE-Bench 与 Terminal-Bench 上的优势在实操中同样明显,这与此处 Qwen 在终端任务上的领先相吻合。
推理:AIME 2026 与 GPQA Diamond
AIME 2026 是竞赛数学基准,Muse Glimmer 得分 94.7,略高于 Qwen3.6-27B 的 94.1,并领先 Gemma4-31B 的 89.2。
对这样体量的模型而言,这是很强的结果。
在研究生难度的科学问答 GPQA Diamond 上,Muse Glimmer 得分 83.5,Gemma4-31B 以 85.7 领先,Qwen3.6-27B 为 84.2。
在 Humanity's Last Exam(纯文本、无工具)上,Muse Glimmer 得分 22.0,略落后于两位对手。
多模态:MMMU Pro 与 Charxiv
MMMU Pro 测试图文多模态推理(研究生难度),三者表现几乎一致:Muse Glimmer 74、Qwen3.6-27B 75、Gemma4-31B 73。
在图表理解的 Charxiv Reasoning 上,Muse Glimmer 得分 78.8,略高于两位对手。
Meta 对 ScreenSpot Pro 的自家强项说法并未完全兑现:Muse Glimmer 得分 75.4,而 Qwen3.6-27B 以 76.1 领先。
总体来看,多模态项目的差距不足以成为这几款模型间的决定性因素。
安全性:CI Memories 与 Siren AgentDojo
在衡量隐私违规率(越低越好)的 CI Memories 上,Muse Glimmer 的违规率为 26.4,对比 Gemma4-31B 更低的 12.1 与 Qwen3.6-27B 的 53.4。
因此在该指标上,Muse Glimmer 介于两者之间,比 Qwen 更安全,但明显落后于 Gemma。
在测量对提示注入攻击抵抗力的 Siren AgentDojo 上,Muse Glimmer 显示 28.4 的攻击成功率与 94.2 的可用性;Gemma4-31B 为 25.6,Qwen3.6-27B 为 40.3。若您的智能体需接触不受信内容,这方面的抗注入能力值得权衡。
Muse Glimmer 的价格与可用性
Muse Glimmer 以 Apache 2.0 许可证开源权重形式发布,Meta 不提供自家托管的第一方 API。
这意味着 Meta 不会有按 Token 计费:您的成本在于基础设施与自托管,而非按量计费的 API。
您可以通过以下途径开始使用:
Meta 正与 AMD、Arm、Dell、Intel 与 NVIDIA 合作,在多种设备上调优性能。
实际硬件目标是 24 GB 或 32 GB 机器:Meta 报告称,K-Quant-17GB 构建加上量化的 DFlash drafter,可在 RTX 5090 上将解码加速至 3.1 倍,在 M5 Max 上为 1.8 倍,在 M4 Max 上为 1.5 倍。
结语
Muse Glimmer 体现了 Meta 对本地、私密、开源权重智能体的明确押注,而非再打造一个云端旗舰。
通过将规模限定在 30B,并发布可在单块消费级 GPU 上承载的量化权重,Meta 瞄准了多数实验室忽视的细分场景:希望在离线环境下运行、且个人上下文从不离开设备的开发者。
坦率地说,这是一套面向构建者的技术栈,而非“一键”替代云端。
基准表现喜忧参半(Qwen3.6-27B 仍在 OSWorld-Verified 与 Terminal-Bench 2.1 上领先,Gemma4-31B 在 CI Memories 上更“干净”),且有评测者指出 Muse Glimmer 在逼近内存上限时偏慢且脆弱。但其在 MCP-Atlas 与 DeepSearch QA 上领跑同量级,加之宽松的 Apache 2.0 许可证,使其成为搭建本地智能体的有力选项。
需要注意的限制包括:不支持音频、视频仅按帧处理、语言覆盖不均衡,以及在独立复现出现前仅有厂商基准。
如果您的工作流对隐私敏感,或确实需要在无网络环境下运行,Muse Glimmer 值得下载并在您的硬件上与 Qwen3.6 进行对比测试。
若您希望亲自掌握此类模型的运行与调优技能,推荐我们的首个自主 AI 智能体构建教程。