
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
11.1K
就在 Google 发布 Gemini 3.8 Flash 几小时后,Meta 推出了 Muse Spark 1.3,这是其面向代理式工作流与编码的旗舰模型家族更新。
这一版本发布置身于竞争激烈的战场:OpenAI 的 GPT-5.6 Sol、Anthropic 的 Claude Opus 5,以及 xAI 的 Grok 4.6 都在争夺同一批开发者的注意力。
Muse Spark 1.3 正在 Muse Code 和 Meta Model API 中逐步上线,并保留 100 万令牌的上下文窗口。
在 Meta 工程师的对比中,该模型比 Muse Spark 1.2 大约少用 20% 的工具调用和 25% 的令牌;Artificial Analysis 为 xhigh 变体给出 Intelligence Index 61,输出速度 182 令牌/秒。
本文将全面介绍 Muse Spark 1.3 的新变化,涵盖其代理与编码特性、基准测试表现和定价。
若要横向对比,请查看我们的 GPT-5.6 Terra vs Claude Sonnet 5 和 Claude Opus 5 vs Claude Sonnet 5 指南。也推荐阅读我们的 Meta Muse Agent 指南。
Muse Spark 1.3 是 Meta 当前的旗舰模型,更像是在 1.2 基础上的增量更新,而非从零重构。
研究中出现了两个变体:
更新主要集中在两方面:支撑更长周期的代理式工作,以及改进编码行为。
Meta 让模型在一系列不同的 harness 上进行训练,从而泛化至多种代理环境,并为更多长周期编码任务加入训练。他们将此版本定位为迈向其所称的“个人超级智能”的一步。
我从这次发布中最大的体会是效率提升;Muse Spark 1.3 在工程对比中比 1.2 少用了约 20% 的工具调用和 25% 的令牌。
对于通过 Meta Model API 按令牌计费的人来说,这意味着在同等工作负载下直接降低成本。
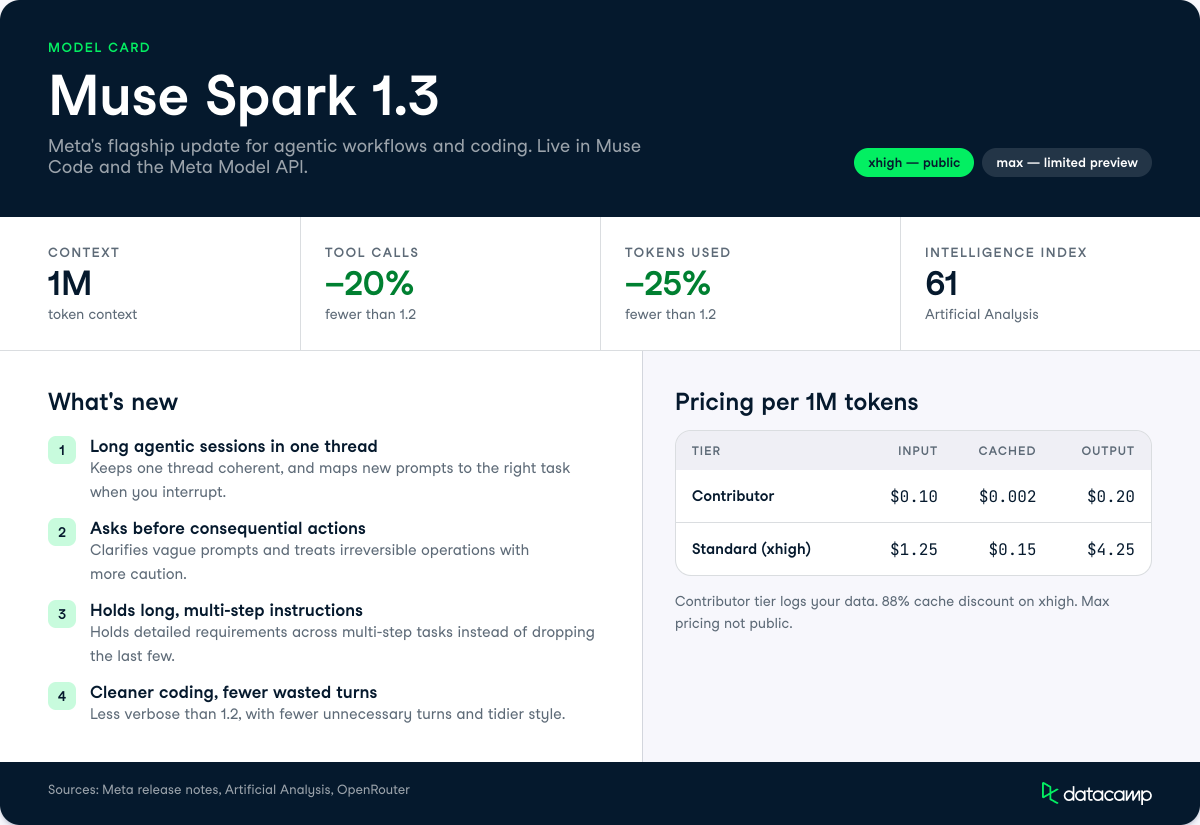
这次更新聚焦于模型在长时代理会话中的行为,以及其编写与编辑代码的方式。
以下是我认为最值得关注的能力。
Muse Spark 1.3 旨在在单个长对话中保持连贯,同时可并行处理多条工作流。
在给定开放式目标时,它会使用工具从混乱且相互矛盾的来源中构建自身上下文,边走边修正计划中的缺口,并跟踪自身学到的内容以产出最终成果。
Meta 还改进了单线程上下文中的多任务处理。
即使您在修正较早的请求或在中途打断,模型也能将新收到的提示映射至正确任务——而这通常是导致长时代理会话脱轨的失败模式。
对常用 Muse Spark 的用户而言,这点很重要,因为大多数真实代理工作并非“一条干净指令”。它更像是一段持续对话:您会改变主意、增加约束、暂停任务;如果模型无法分辨每条消息所属的任务,很快就难以使用。
Meta 表示,Muse Spark 1.3 训练得更倾向于与您协作,而非在指令含糊时一意孤行。这意味着当提示不清时它会先澄清问题、在陷入僵局时拉您介入,并在执行关键操作前进行确认。
在长任务中,它会根据您对进度更新的偏好进行适配。您可以让它频繁汇报,或在后台安静工作直至有结果——当您想先派发任务、稍后再回来查看时非常实用。
Meta 还改进了模型对不可逆操作的校准,因此它对破坏性操作会比可逆操作更为谨慎。
对于会接触文件、发送消息或运行 Shell 命令的代理而言,这可能是有意义的安全阀。
与早期版本相比,Muse Spark 1.3 更可靠地遵循复杂的长形式指令。
在多步骤任务中,Meta 报告称它在保留细致要求方面表现更佳,不易丢失约束或偏离既定工作流。
设想这样一个请求:起草合规报告、从附带的电子表格中提取数据、将数字格式化为两张表、导出为 PDF,并按六个命名标题组织。早期模型往往能做好前三项,却悄然忘记最后两项。
该模型对自身局限的认知也更好。
Meta 训练它在“碰壁”时能识别并据实说明,而非为了看起来完整而幻觉出结果,尽管研究并未量化这一点发生的频率。
Muse Spark 1.3 针对更多长周期编码任务进行训练,并在常见工程工作流中表现更佳。
与 Muse Spark 1.2 相比,Meta 称其在不需要时更少往返、更少冗长,且产出的代码风格更干净。
效率提升是最具体的部分:在 Meta 工程师的对比中,Muse Spark 1.3 相比 1.2 大约少用 20% 的工具调用和 25% 的令牌。
更少的工具调用意味着更少的往返和更低的代理式编码任务时延,更少的令牌意味着更低的单任务成本。
我在社区报告中看到的一个注意点是:一些 Reddit 用户认为该模型令人沮丧,因为它不公开其思考过程,这使得调试其编码决策比能展示推理轨迹的模型更困难。
在 Muse Spark 1.3 的发布中,Meta 公布了三类基准:代理任务、长上下文检索和编码。
下方结果比较的是 max 变体,对比对象包括 Muse Spark 1.2 xhigh、GPT-5.6 Sol(max)和 Claude Opus 5(max)。
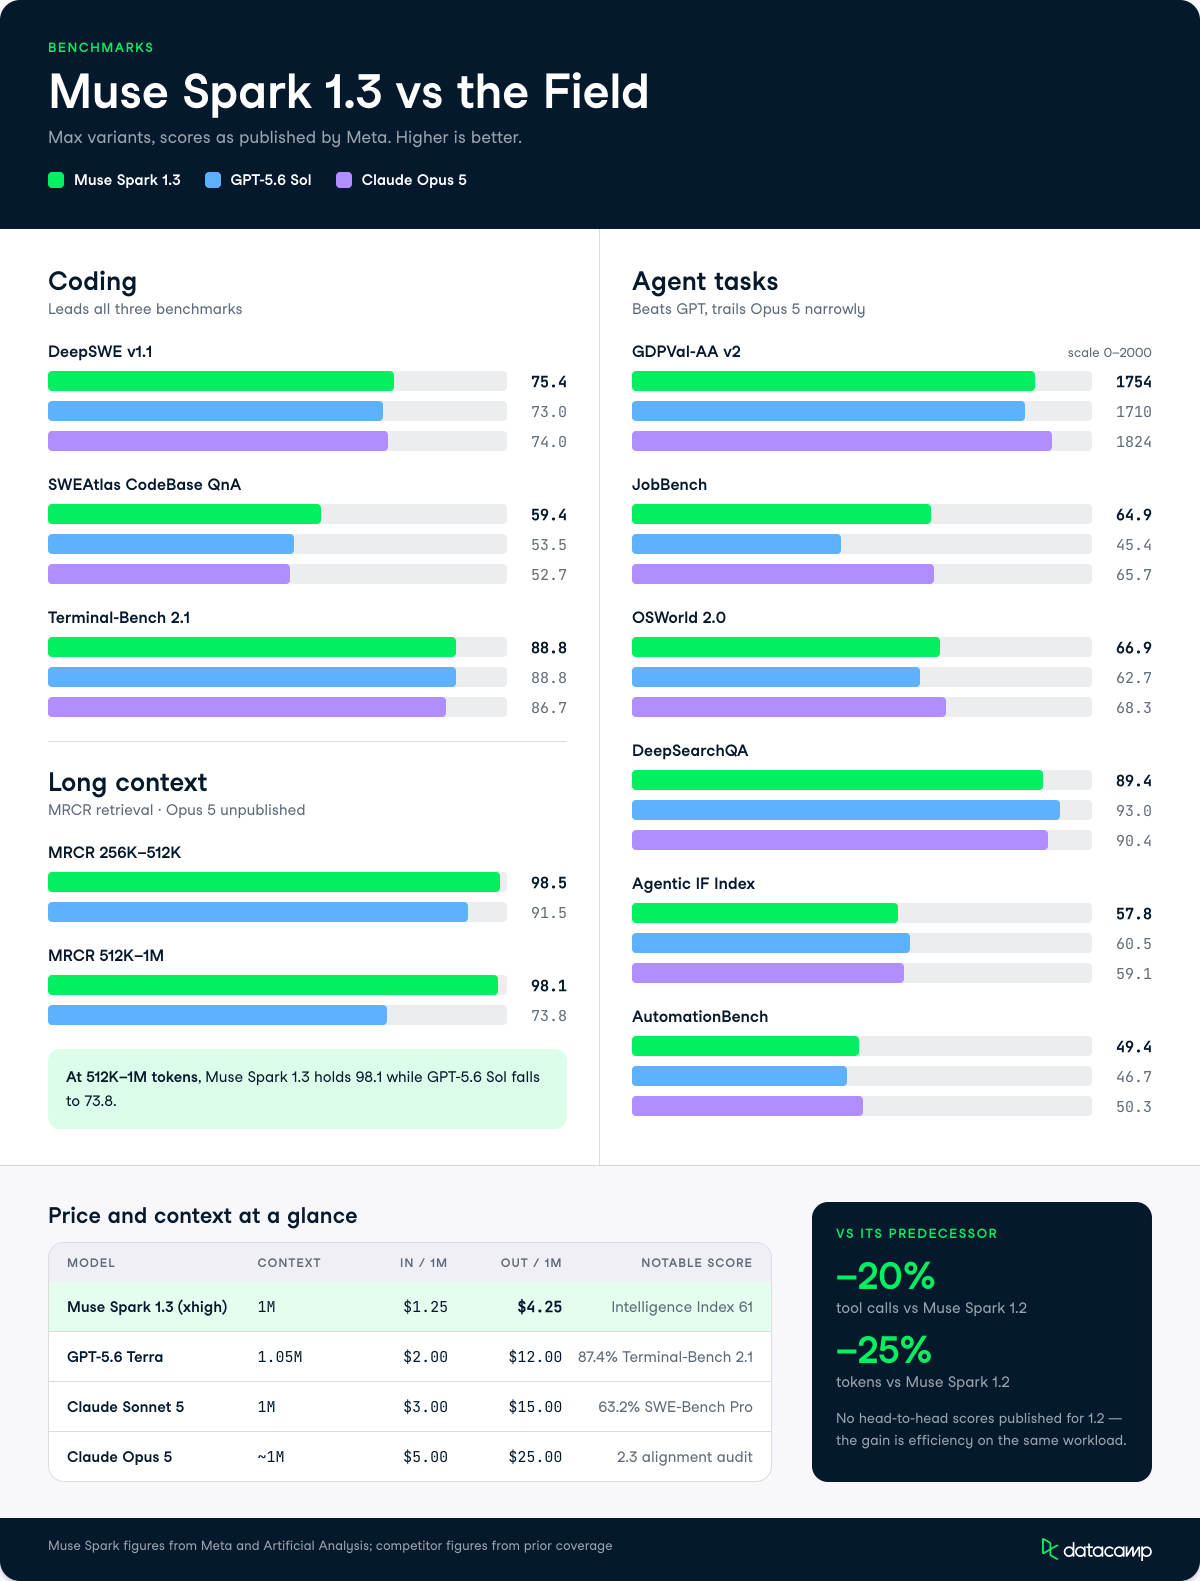
编码是 Muse Spark 1.3 表现最强的领域。它在三项基准中均名列前茅,其中在 Terminal-Bench 2.1 上与 GPT-5.6 Sol 并列。
| 基准 | Muse Spark 1.3(max) | GPT-5.6 Sol(max) | Opus 5(max) |
|---|---|---|---|
| DeepSWE v1.1 | 75.4 | 73.0 | 74.0 |
| SWEAtlas CodeBase QnA | 59.4 | 53.5 | 52.7 |
| Terminal-Bench 2.1 | 88.8 | 88.8 | 86.7 |
DeepSWE v1.1 的 75.4 分尤为亮眼。
该基准衡量长周期的代理式编码,模型需自主完成真实的软件工程任务。
在这项评测中同时击败 Opus 5 和 GPT-5.6 Sol,对评估编码代理的人来说意义重大。T
而 SWEAtlas 代码库理解得分(59.4)传达了类似信息:在这里,Muse Spark 1.3 对大型代码库的阅读与推理优于两位直接对手。
在长上下文检索上,Muse Spark 1.3 有明显领先,尤其是在上下文窗口极限端,大多数模型都会出现退化。
| 基准 | Muse Spark 1.3(max) | GPT-5.6 Sol(max) |
|---|---|---|
| MRCR 256K–512K | 98.5 | 91.5 |
| MRCR 512K–1M | 98.1 | 73.8 |
在 512K 至 100 万令牌处,GPT-5.6 Sol 降至 73.8,而 Muse Spark 1.3 仍保持在 98.1。若您的工作需要将整套代码库、长文档链或扩展的代理轨迹输入同一上下文,这一类别最为关键。Opus 5 未公布 MRCR 成绩,因此无法进行直接三方对比。
在代理基准上,Muse Spark 1.3 介于 GPT-5.6 Sol 与 Opus 5 之间。
它在多数类别上超过 GPT,但在整体上略微落后于 Opus 5。
| 基准 | Muse Spark 1.3(max) | GPT-5.6 Sol(max) | Opus 5(max) |
|---|---|---|---|
| GDPVal-AA v2 | 1754 | 1710 | 1824 |
| JobBench | 64.9 | 45.4 | 65.7 |
| OSWorld 2.0 | 66.9 | 62.7 | 68.3 |
| DeepSearchQA | 89.4 | 93.0 | 90.4 |
| Agentic IF Index | 57.8 | 60.5 | 59.1 |
| AutomationBench | 49.4 | 46.7 | 50.3 |
在 JobBench 上与 GPT-5.6 Sol 的差距(64.9 vs 45.4)是代理类别中最大的,这对在专业工作流中使用 AI 的人值得关注。
DeepSearchQA 是 GPT-5.6 Sol 领先的唯一领域(93.0 vs 89.4),指令跟随(Agentic IF Index)也略微偏向 GPT。
在计算机使用(OSWorld 2.0)上,Muse Spark 1.3 的 66.9 与 Opus 5 的 68.3 相当接近。
总体来看,Muse Spark 1.3 在编码和长上下文检索上领先,在代理任务上具备竞争力,而在知识型工作与通用代理编排上略落后于 Opus 5。
以下是我们评测过的中端与旗舰模型,与 Muse Spark 1.3 的快速对比。
Muse Spark 的数据来自 Artificial Analysis;竞品数据来自我们此前的报道。
| 模型 | 上下文 | 输入 / 100 万 | 输出 / 100 万 | 亮点得分 |
|---|---|---|---|---|
| Muse Spark 1.3(xhigh) | 1M | $1.25 | $4.25 | Intelligence Index 61 |
| GPT-5.6 Terra | 1.05M | $2.00 | $12.00 | 87.4% Terminal-Bench 2.1 |
| Claude Sonnet 5 | 1M | $3.00 | $15.00 | 63.2% SWE-Bench Pro |
| Claude Opus 5 | ~1M | $5.00 | $25.00 | 2.3 alignment audit |
价格差距在此一目了然;Muse Spark 1.3 的输出令牌费用大约是 Sonnet 5 的三分之一、Opus 5 的六分之一。
Muse Spark 1.3 今日已在 Muse Code 和 Meta Model API 上线。
Meta for Developers 指出,现有用户只需更换模型 ID,即可保留相同的端点、SDK 和定价,升级路径非常顺畅。
Meta Model API 的定价取决于层级:贡献者层以更低费率记录您的数据用于改进 Meta 产品,标准层则不记录。
| 层级 | 上下文 | 输入 / 100 万 | 缓存输入 / 100 万 | 输出 / 100 万 |
|---|---|---|---|---|
| 贡献者(数据用于改进产品) | 1M | $0.10 | $0.002 | $0.20 |
| 标准(xhigh) | 1M | $1.25 | $0.15 | $4.25 |
Artificial Analysis 报告称 xhigh 层的缓存折扣为 88%,OpenRouter 也反映了 $1.25 输入 / $4.25 输出的费率,并列出诸如网页搜索之类的增值项,每 1,000 次调用 $2.50。
发布分析时,max 变体的定价尚未公开。
截至撰写时,有两点来自社区的可用性提示值得注意:
Muse Spark 1.3 更像是一版有针对性的效率与可靠性更新,而非能力飞跃,Meta 对此定位也颇为坦诚。
相较 1.2,工具调用减少 20% 和令牌减少 25% 是对批量运行代理的人最重要的数字,因为它们直接转化为更低的成本与时延。
如果您已经在使用 Meta Model API 或 Muse Code,那么以更少令牌完成同等工作负载的平滑升级几乎是不言自明的选择。
如果您在为生产代理全新选型,在最终决定是否优先选择它而非文档更完备的替代品前,我会希望先观察其在真实环境中的表现以及 max 变体的定价。
若您想提升评估与在自有工作流中使用此类模型的技能,建议从我们的 AI Agent Fundamentals 技能路径 开始。
DataCamp 精品课程
课程
课程
学习路径