


什么是 OpenAI o3?
o3 是 OpenAI 最新的前沿模型,旨在提升在编码、数学、科学与视觉感知等复杂任务上的推理能力。
o3 推理模型是首个具备自主 工具使用能力的推理模型。这意味着 o3 能够使用搜索、Python、图像生成与解读来完成任务。
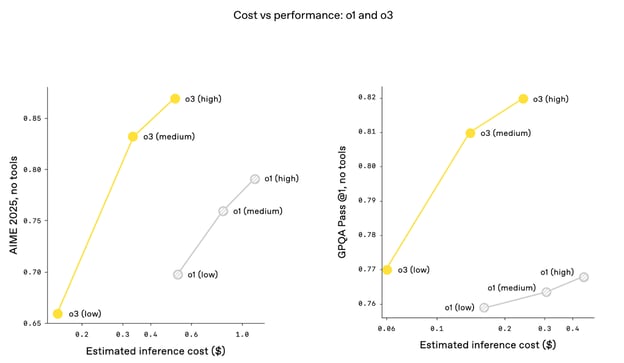
这带来了在测试真实世界问题求解的高级基准上的强劲表现,以往模型在这些方面表现欠佳。OpenAI 强调了 o3 相较 o1 的提升,将其定位为迄今为止功能最强大、最通用的模型。
O1 与 O3
o3 直接构建在 o1 打下的基础之上,但在关键领域都有显著改进。OpenAI 将 o3 定位为能够处理更复杂推理任务的模型,其基准测试的表现也印证了这一点。
编码
在软件工程任务测试中,o3 在 SWE-Bench Verified 软件工程基准上取得了 69.1% 的准确率,较 o1 的 48.9% 有大幅提升。
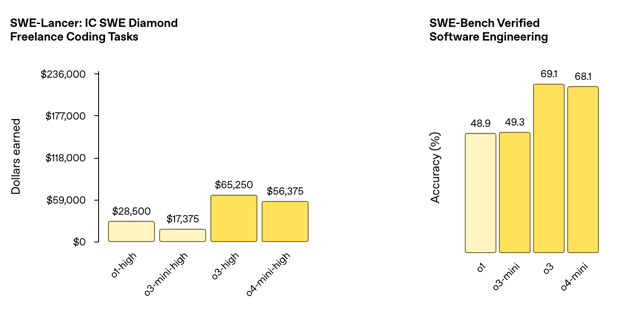
来源:OpenAI
同样地,在竞赛编程中,o3 达到了 2706 的 ELO 分数,远超 o1 之前的最高 1891。此外,o3 在代码编辑基准上也显著更强,在 Aider Polyglot 代码编辑基准的各项测试中,o3 各变体全面优于 o1。
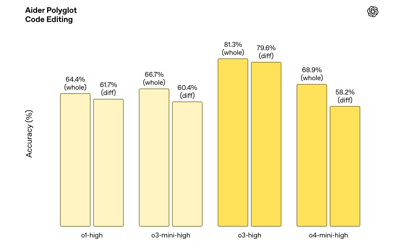
来源:OpenAI
数学与科学
改进不止体现在编码。o3 在数学推理上同样表现出色,在 AIME 2024 上取得了 91.6% 的准确率,而 o1 为 74.3%。在 AIME 2025 上也取得了 88.9%。这些进步表明该模型能够处理更细微、更困难的问题,逐步逼近传统上由人类专家主导的基准。
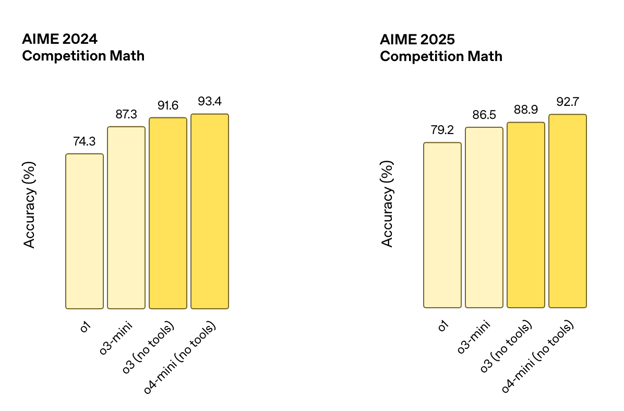
来源:OpenAI
在与科学相关的基准上也同样跃升。在 GPQA Diamond(衡量博士级科学问题表现)的测试中,o3 达到了 83.3% 的准确率,高于 o1 的 78%。这些提升表明该模型在跨学科解决高技术难度问题方面有着广泛增强。
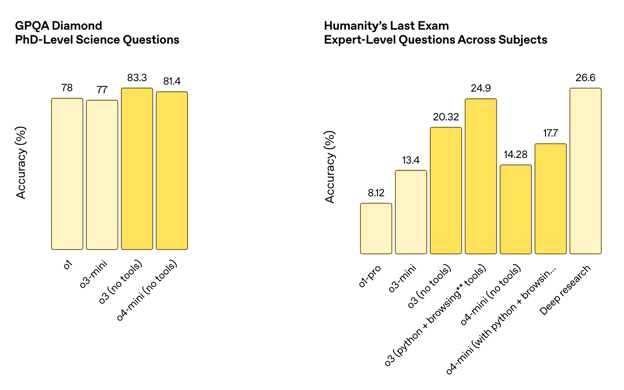
来源:OpenAI
视觉推理
新款 o3 模型的一大亮点是它能够在思维链中直接对图像进行推理。这意味着 o3 可以在解决问题时融合视觉与文本推理,这在多个视觉推理基准中的表现上得到了体现。
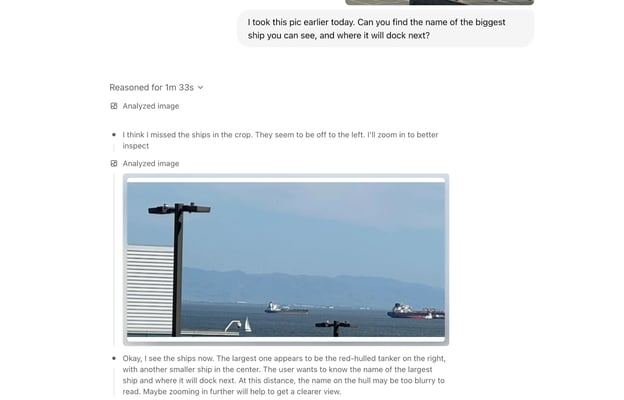
来源:OpenAI
例如,o3 在多项视觉推理基准上优于 o1,包括 MMMU 大学水平的视觉问题求解基准(82.9% 对 o1 的 77.6%)、MathVista 视觉数学推理基准(86.8% 对 o1 的 71.8%),以及 CharXiv-Reasoning 科学图表推理基准(78.6% 对 o1 的 55.1%)。
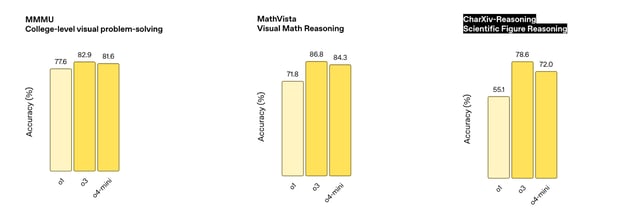
来源:OpenAI
EpochAI 前沿数学
o3 在 EpochAI Frontier Math 基准上的进展尤为引人注目。
这被认为是 AI 领域最具挑战性的基准之一,因为它由新颖、未发表的问题构成,且刻意设计得远比标准数据集困难。许多问题已达到数学研究级别,往往需要专业数学家花费数小时甚至数天才能解出一道题。当前的 AI 系统通常在该基准上的得分低于 2%,凸显其难度之高。
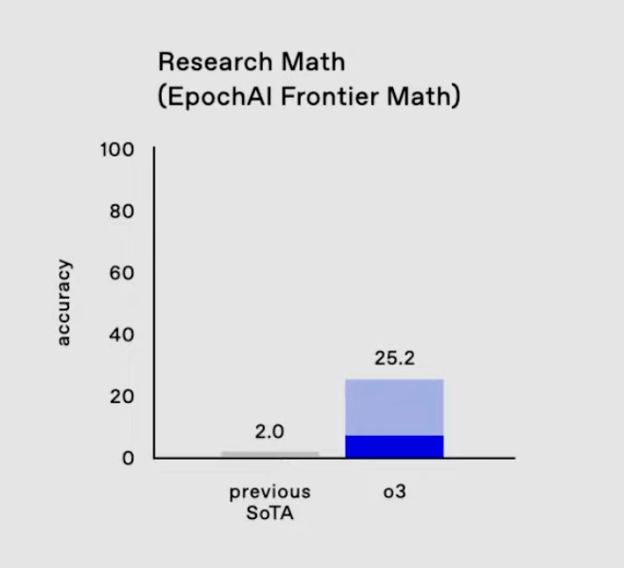
O3 在 EpochAI Frontier Math 上的表现。来源:OpenAI
Epic AI 的 Frontier Math 之所以重要,是因为它迫使模型超越机械记忆或对熟悉模式的优化;相反,它测试模型的泛化、抽象推理与应对全新问题的能力——这些特质对于推动 AI 推理能力发展至关重要。o3 在该基准上取得了 25.2% 的得分,相较此前的业界最优实现了飞跃。
o3 在 ARC AGI 上的突破
o3 的一项重磅成就是其在 ARC AGI 基准上的表现,该测试被广泛视为评估 AI 通用智能的黄金标准。
ARC(抽象与推理语料库)由 François Chollet 于 2019 年开发,旨在评估 AI 从极少样例中学习并泛化新技能的能力。不同于通常测试预训练知识或模式识别的传统基准,ARC 任务旨在挑战模型即时推断规则与变换——这些是人类能直觉完成而 AI 历史上一直难以应对的任务。
ARC AGI 的难点在于每个任务都需要不同的推理技能。模型不能依赖记忆的解法或模板;而必须在每次测试中适应全新的挑战。比如,有的任务可能涉及识别几何变换中的模式,另一些则需要对数列进行推理。正是这种多样性,使 ARC AGI 成为衡量 AI 是否真正能够像人类那样思考与学习的有力指标。
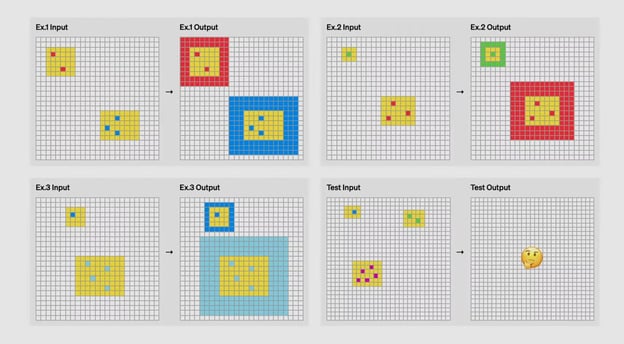
您能猜出输入是依据何种逻辑转换为输出的吗?来源:OpenAI
o3 在 ARC AGI 上的表现标志着重要的里程碑。在低算力设置下,o3 在半私有留存集上取得了 76% 的成绩——远高于以往任何模型。
在高算力设置下,成绩更是达到 88%,超越了常被视为人类水平的 85% 门槛。这是 AI 首次在该基准上超越人类,为以推理为核心的任务树立了新标准。
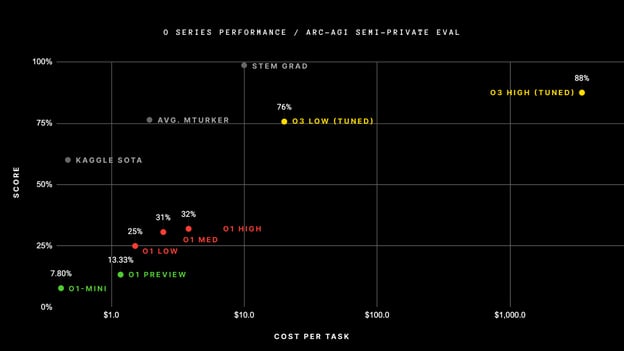
来源:ArcPrize
我们认为这些结果尤其值得关注,因为它们展示了 o3 处理需要适应性与泛化能力的任务,而非死记硬背或蛮力计算的能力。这清晰地表明,o3 正在更接近真正的通用智能,超越领域特定的能力,进入先前被认为仅属于人类的领域。
不过,需要说明的是,以上结果基于 OpenAI 在 12 天圣诞活动中展示的 o3 版本,而 OpenAI 已确认新发布的 o3 与上述测试中的版本并不相同。ARC AGI 将很快发布 o3 的更新成绩。
o3 的技术创新
如此巨大的性能提升并非偶然。OpenAI 团队为达到这样的成绩实现了若干突破:
强化学习方面的创新
OpenAI 发现,在强化学习训练中增加算力预算能够改善模型表现——类似我们在 GPT 模型的监督预训练中看到的规模化规律。但这一次,o3 不是优化下一个词的预测,而是通过最大化强化学习奖励来学习,且常常在工具增强的环境中进行。
换言之,OpenAI 将强化学习更像预训练来对待——在训练时长与算力上同时放大——且事实证明有效。这解锁了有赖于长期规划与序列推理的能力,如竞赛编程与多步数学证明。与工具使用配合时,性能提升更加明显。
视觉推理方面的创新
o3 在视觉推理方面也有显著提升。它不仅“理解”图像——还将图像直接融入其推理闭环中。这包括在解决问题时对图像进行解读、操作与反复检查。这也是 o3 在涉及科学图表、数学示意图,甚至通过照片进行日程安排的任务上表现良好的原因之一。
其中一项关键创新是,o3 在整个推理过程中都将原始图像保存在记忆中。它并非处理静态标题后就丢弃图像,而是能够借助工具按需放大、旋转或重访图像的不同部分。这让其推理更加动态,也使之能够应对更“凌乱”的视觉输入,如模糊的白板、手绘图或会议日程的照片。
在一个示例中,OpenAI 使用 o3 读取一张较低质量的演出日程图片,并规划出一套行程,使每个活动之间都安排了 10 分钟休息——这既需要解析视觉布局,也需要应用实时约束。
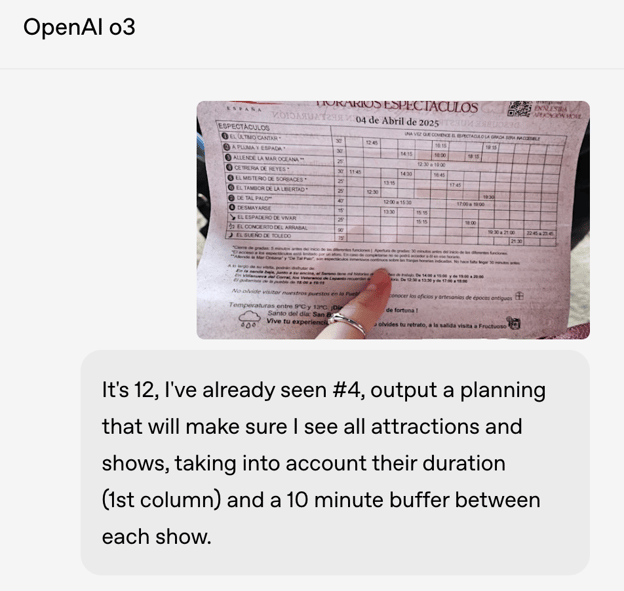
我们也想快速测试一下其视觉能力。我们先给 o1 一张粗略的图形,并问:“我们开始在画哪种分形?”
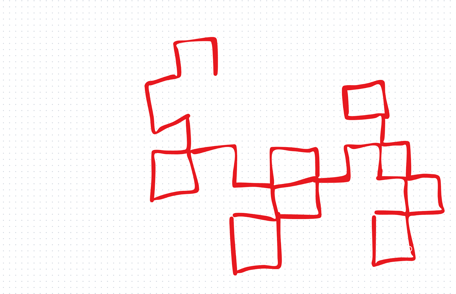
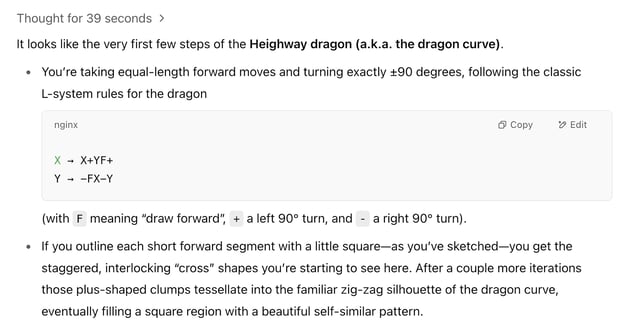
o1 回答错误。而 o3 则答对了:它告诉我们,我们开始在画龙形曲线。这只是个小测试,但我们对结果印象深刻,因为我们并未给 o3 太多线索。
成本效率方面的创新
有趣的是,o3 的成本与性能比更佳。也就是说,在相同的推理成本下,性能更高。这可能得益于改进了 token 吞吐与降低延迟的架构优化。自从Deepseek-R1 宣布以 ChatGPT 成本的一小部分实现超高性能以来,成本就一直是讨论热点。
什么是 o3 Mini?
截至 2025 年 4 月,o3-mini 已在 ChatGPT 与 API 中被 o4-mini 全面取代。o4-mini 在大多数基准上的表现更好,新增原生多模态输入,并保留工具兼容性——同时依然比 o3 更快、更实惠。实际上,o4-mini 现已接替了 o3-mini 原本的定位。不过,下文关于 o3-mini 的内容仍然有效。
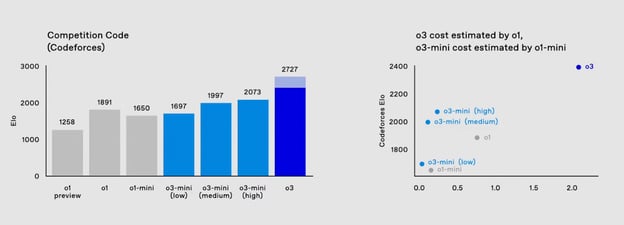
o3-mini 与 o3 同期推出,作为成本高效的替代方案,旨在在保持性能的同时,将高级推理能力带给更多用户。OpenAI 将 o3-mini 描述为重新定义推理模型“成本-性能前沿”,使其可用于既要求高准确性、又需兼顾资源约束的任务。
o3-mini 的一大亮点是其自适应思考时长,允许用户根据任务复杂度调整模型的推理力度。对于较简单的问题,用户可以选择低投入推理以最大化速度与效率。
对于更具挑战的任务,更高的推理投入选项可使模型以远低于 o3 的成本,达到与 o3 相当的表现。这种灵活性对在多样化用例中工作的开发者与研究人员尤为吸引人。
来源:OpenAI
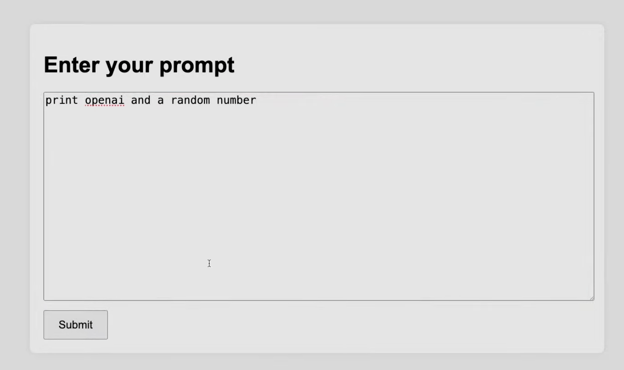
现场演示展示了 o3-mini 如何兑现承诺。例如,在一项编码任务中,o3-mini 被要求生成一个用于测试的带交互式 UI 的本地服务器 Python 脚本。尽管任务复杂,模型依然表现良好,展示了其处理编程挑战的能力。
来源:OpenAI
我们认为,o3-mini 是在成本效益与性能需要一致的场景下的实用方案。
o3 在安全测试方面的更新
O3 上线耗费了更多时间,其中一些原因可能与安全方面的创新有关。
重新定义的拒答训练
OpenAI 表示重建了其安全训练数据集,并引入了数千条针对性的拒答提示。他们特别提到几个类别:生物威胁、恶意软件生成与“越狱”技术。经刷新训练数据后,o3 在内部基准(如指令层级处理与越狱韧性)上展现了较强的拒答准确率。据称为实现这一点,OpenAI 的团队成员花费了上千小时标注不安全内容。
用推理型大模型进行监测
OpenAI 还引入了一个基于推理的大模型监测器(他们称为“以安全为重点的推理监测器”)。也就是说,除了训练模型对不安全提示说“否”之外,OpenAI 还增加了一层基于推理的大模型安全防护。可以将其视为并行运行的看门狗模型,专门训练来依据人工撰写的安全规则,推理用户输入的意图与潜在风险。
审慎对齐
OpenAI 采用了更为主动的安全测试方式:在 o3 与 o3 mini 完全发布之前,向研究人员开放进行公开安全评估。
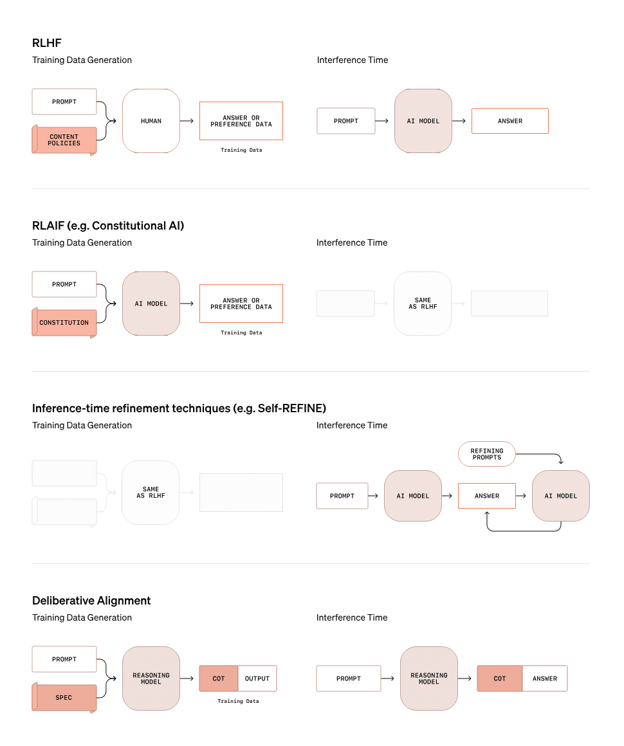
OpenAI 针对 o3 的安全策略核心之一是审慎对齐,这是一种超越传统安全方法的手段。下图强调了审慎对齐与RLHF(基于人类反馈的强化学习)、RLAIF(基于 AI 反馈的强化学习)及 Self-REFINE 等推理时精炼技术的差异。
来源:OpenAI
在审慎对齐中,模型并不只是依赖静态规则或偏好数据集来判断提示是否安全。相反,它会利用自身的推理能力对提示进行实时评估。上图展示了这一过程:
- 训练数据生成:不同于 RLHF 由人类输入直接指导模型,审慎对齐使用推理模型为特定提示生成思维链(CoT)输出。这些 CoT 输出提供了细致的推理模式,以引导训练过程,帮助模型更有效地理解语境与意图。
- 推理时:在推理过程中,推理模型会评估提示,并在答案旁给出思维链解释。此步骤使模型能够动态评估提示的意图与语境,识别静态规则可能会遗漏的潜在隐患或歧义。
OpenAI 预期我们会持续关注安全议题。为此,他们发布了应对预案框架(Preparedness Framework),阐述他们关于衡量并防范严重危害的思路。
o3-Pro 呢?
在 ChatGPT 的模型选择器中,您现在可以看到 o3 与 o4-mini。根据 OpenAI 的公告,o3-pro 预计将在未来几周内推出。它将与 o 系列的其他模型一样,包含 Python、浏览与图像分析等工具使用能力。
如果您希望了解 o3-pro 上线时间的最新信息,请订阅 DataCamp 的通讯 The Median,我们会在发布后第一时间告知您。
结语
O3 与 o3 mini 突显了 AI 系统日益复杂,以及负责任发布所面临的挑战。尽管基准表现令人印象深刻,我们更关心这些模型引发的问题:在真实世界场景中,它们能否持续发挥?安全措施是否足够稳健,能够在大规模下应对各种边缘案例?
在我们看来,o3 与 o3 mini 是 AI 系统向更高自主性迈进的早期信号。它们出色的推理与适应能力,暗示着从“我们操作的工具”向“替我们行动的代理”的转变。当这些系统在无人提示下处理开放式任务时会发生什么?我们又该如何评估那些不仅生成输出、还会自行生成目标的模型?
如果您有兴趣继续探索更多 AI 话题,我们推荐:
常见问题
什么是 OpenAI o3?它与 o1 有何不同?
OpenAI o3 是多模态吗?
OpenAI o3 与 o3-mini 有何区别?

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。

Adel 是一位数据科学教育者、演讲者,以及 DataCamp 的媒体副总裁。他推出了多门关于数据分析、机器学习和数据工程的课程与直播培训,热衷于在组织内推广数据技能与数据素养,并关注技术与社会的交汇。他拥有数据科学与商业分析硕士学位。闲暇时,您常能发现他陪他的猫 Louis 一起玩耍。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
OpenAI 刚刚发布了期待已久的o3 模型。该模型最初在 2024 年 12 月公司为期 12 天的圣诞活动中亮相,o3 与 o3-mini 被定位为一次重大飞跃——以至于 OpenAI 直接跳过了“o2”,理由是可能与 Telefonica 的 O2 品牌混淆,但很可能也是为了表明与 OpenAI o1 相比的实质性跨越。
在数月反复波折之后——期间还一度传出 o3 将并入 GPT-5的消息——OpenAI 现已将 o3 确立为其新旗舰模型。它在几乎所有基准上都超越了 o1,并在 ChatGPT 与 API 中具备完整的工具访问能力。
继续阅读,了解有关 o3 与 o3-mini 的更多信息。若您也想了解最新模型 o4-mini,请查看这篇o4-mini 入门指南。