2022 年 11 月,OpenAI 发布了 ChatGPT。短短几天内,它便以前所未有的能力风靡全球。生成式人工智能的革命由此开启,人人都在问同一个问题:接下来会怎样?
当时,ChatGPT 以及许多由大型语言模型(LLM)驱动的生成式 AI 工具都被设计为处理用户的文本输入并生成文本输出。换言之,它们被视为单模态 AI 工具。
不过,这只是开始。我们当时仅仅触及了 LLM 能力的冰山一角。ChatGPT 发布仅一年后,行业的进步已令人瞠目结舌,前沿边界难以捉摸,我们在另一篇关于ChatGPT 与生成式 AI 的长期影响的文章中对此进行了分析。
如今,如果要回答“接下来是什么?”这个问题,最好的答案或许是多模态学习。这是当前 AI 革命中最具前景的趋势之一。多模态生成式 AI 模型能够结合多种类型的输入,并生成可能同时包含多种类型的输出。
在本指南中,我们将带您了解多模态 AI 的概念。我们将探讨多模态 AI 的定义、核心概念、底层技术与应用,以及如何在真实场景中加以实现。准备好迎接多模态了吗?让我们开始吧!
理解多模态 AI
尽管大多数先进的生成式 AI 工具仍无法像人类那样思考,但它们已经带来了突破性成果,让我们离通用人工智能(AGI)的门槛更近一步。该术语指一种假想的 AI 系统,能够像人类一样在广泛任务中理解、学习并应用知识。
在如何实现 AGI 的讨论中,一个核心问题是我们必须理解人类如何学习,这就引出了人类大脑的工作方式。长话短说,我们的大脑依赖五感从周围环境中收集各类信息。随后,这些信息被存储于记忆中,经由处理以习得新见解,并被用来做出决策。
第一代现代生成式 AI 模型(如 ChatGPT)被认为是单模态的;也就是说,它们只能接收一种类型的数据作为输入,并生成同类型的输出。特别是,其中大多数模型被设计为处理文本提示并生成文本回应。
这很合理,因为这些模型需要海量数据进行训练,而文本不仅易于存储和处理,也极为易得。毫不奇怪,像 ChatGPT 这样的工具,其大部分训练数据来自互联网的不同来源。我们在《What is ChatGPT》一文中解释了这些技术细节,并直接向 ChatGPT 提出了相关问题。
然而,阅读只是人类学习新事物的众多方式之一,而且在许多任务中并非最有效的方式。
多模态学习是 AI 的一个分支领域,旨在通过使用海量文本以及其他数据类型(亦称感知数据,如图像、视频或音频录音)来训练机器,从而提升其学习能力。这使模型能够学习文本描述与其相关图像、视频或音频之间的新模式与关联。
多模态学习正在为智能系统解锁新的可能性。在训练过程中融合多种数据类型,使多模态 AI 模型能够接受多种模态的输入,并生成多种类型的输出。例如,作为 ChatGPT 的基础模型的 GPT-4,既能接收图像与文本输入并生成文本输出,而 OpenAI 近期发布的Sora则是文本生成视频模型。
多模态 AI 的核心概念
多模态生成式 AI 模型在最先进的 LLM 基础上增加了新的复杂性。这些模型基于一种称为 Transformer 的神经网络架构。该架构由谷歌研究人员提出,依赖编码器-解码器架构与注意力机制实现高效数据处理。
这一过程相当复杂,理解起来并不容易。如果您想更深入了解 LLM 与 Transformer 的工作原理,我们强烈建议阅读我们的《Transformer 如何工作》指南;或者如果您想亲自动手、逐步学习如何构建 LLM,请查看我们的《大型语言模型(LLM)概念》课程。
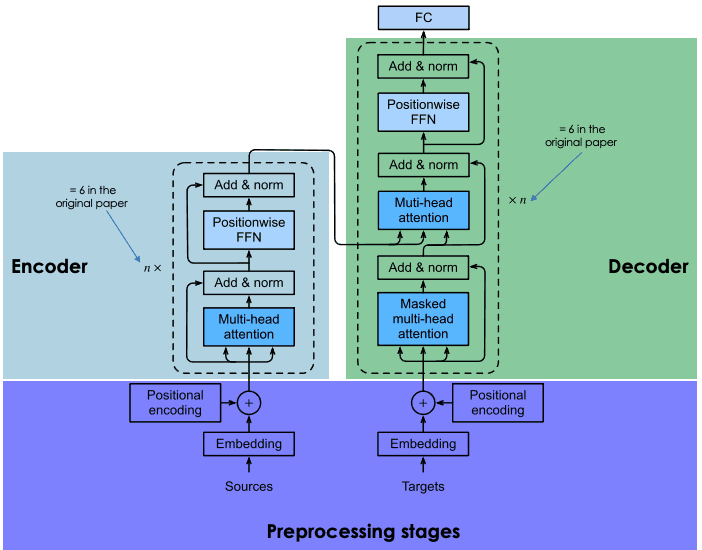
来源:DataCamp
多模态 AI 依赖数据融合技术来整合异构数据类型,从而对底层数据形成更完整、更准确的理解。其最终目标是通过融合不同模态所提供的互补信息,做出更优预测。
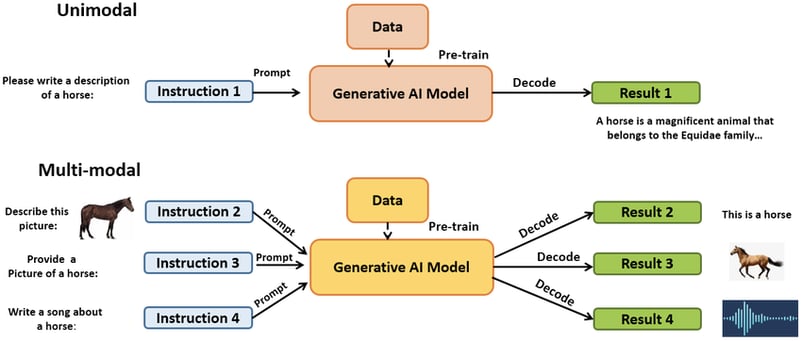
单模态 vs 多模态 AI。来源:ResearchGate
为解决多模态挑战,可以采用多种数据融合技术。根据融合发生的处理阶段不同,我们可将数据融合技术分为三类:
- 早期融合。将不同模态编码到模型中,以创建共同的表示空间。该过程会产生单一的模态不变输出,封装来自所有模态的语义信息。
- 中期融合。在不同的预处理阶段组合模态。通常通过在神经网络中创建专门用于数据融合的特殊层来实现。
- 后期融合。分别为不同模态创建多个模型,并在新的算法层中组合各模型的输出。
不存在一种适用于所有场景的通用数据融合技术。所选技术将取决于具体的多模态任务。因此,往往需要通过试错来找到最合适的多模态 AI 流水线。
驱动多模态 AI 的技术
多模态 AI 是多个 AI 分支领域累积知识的结晶。近年来,AI 从业者与学者在多种格式与模态的数据存储和处理方面取得了长足进展。
下面列出了推动多模态 AI 蓬勃发展的关键领域:
深度学习
深度学习是 AI 的一个分支,使用称为人工神经网络的算法来解决复杂任务。当前的生成式 AI 革命由深度学习模型驱动,尤其是作为一种神经网络架构的 Transformer。
多模态 AI 的未来同样取决于该领域的新进展。特别需要研究的是增强 Transformer 能力的新方法,以及新的数据融合技术。
查看我们的《Python 深度学习》技能路径,在这一前景广阔的领域更进一步。
自然语言处理(NLP)
NLP 是人工智能中的关键技术,架起了人类交流与计算机理解之间的桥梁。它是一个多学科领域,使计算机能够解释、分析与生成自然语言,从而实现人机无缝互动。
由于与机器沟通的主要方式是文本,NLP 对于确保生成式 AI 模型(包括多模态模型)的高性能至关重要,这并不令人意外。
对 NLP 感兴趣?查看我们的《Python 自然语言处理》技能路径,掌握将非结构化数据转化为有价值洞见的核心 NLP 技能。
计算机视觉
图像分析(也称计算机视觉)包含一系列使计算机能够“看见”并理解图像的技术。该领域的进步推动了多模态 AI 模型的发展,使其能够将图像与视频作为输入与输出进行处理。
如果您希望进一步探索这一迷人主题,请查看我们的《Python 图像处理》技能路径,将图像处理技能纳入您的数据科学工具箱。
音频处理
部分最先进的生成式 AI 模型能够将音频文件作为输入与输出进行处理。音频处理的可能性涵盖从语音消息理解到同声翻译与音乐创作。
查看我们的《Python 语音语言处理》课程,学习如何在 Python 中从原始音频文件加载、转换与转写语音。
多模态 AI 的应用
多模态学习让机器获得新的“感官”,提升其准确性与解读能力。这些能力正在为各行各业带来大量新应用,包括:
增强的生成式 AI
第一代大多数生成式 AI 模型都是文本到文本,能够处理用户的文本提示并给出文本答案。多模态模型,如GPT-4 Turbo、Google Gemini或DALL-E,带来了新的可能性,可在输入与输出两端改善用户体验。无论是接受多种模态的提示,还是以多种格式生成内容,多模态 AI 代理的潜力似乎无限。
自动驾驶汽车
自动驾驶汽车高度依赖多模态 AI。车辆配备多个传感器,以多种格式处理来自环境的信息。多模态学习对于有效高效地融合这些信息源、并在实时中做出智能决策至关重要。
生物医学
来自生物样本库、电子健康记录、临床影像与医疗传感器,以及基因组数据等生物医学数据的日益丰富,正在推动医疗领域多模态 AI 模型的诞生。这些模型能够处理以多种模态提供的多类数据源,帮助我们揭示人类健康与疾病之谜,并做出智能的临床决策。
地球科学与气候变化
地面传感器、无人机、卫星数据与其他测量技术的快速发展,正在提升我们理解地球的能力。多模态 AI 对准确整合这些信息至关重要,并可创建新的应用与工具,助力完成多种任务,例如温室气体排放监测、极端气候事件预测与精准农业。
实施多模态 AI 方案的挑战
多模态 AI 的兴起为企业、政府和个人带来了无尽可能。但与所有新兴技术一样,将其落地到日常运营中也并非易事。
首先,您需要找到契合自身需求的用例。从概念到部署并不总是顺利,尤其当您缺乏真正理解多模态 AI 技术细节的人才时。鉴于当前的数据素养技能缺口,寻找适合的人才将模型投入生产可能既困难又昂贵,因为企业愿意为这类稀缺人才支付高薪。
最后,谈到生成式 AI,成本问题必不可少。此类模型,尤其是多模态模型,需要大量计算资源才能运行,而这意味着资金投入。因此,在采用任何生成式 AI 解决方案之前,务必评估您希望投入的资源。
多模态 AI 的风险
与任何新技术一样,我们在使用多模态 AI 模型时必须警惕多种潜在陷阱:
- 缺乏透明度。算法不透明是与生成式 AI 相关的主要担忧之一,多模态 AI 亦然。这些模型常因其复杂性而被贴上“黑箱”标签,导致无法监控其推理与内部工作机制。
- 多模态 AI 的垄断。鉴于开发、训练与运行多模态模型所需的资源巨大,市场高度集中在少数具备必要专长与资源的大型科技公司。所幸,越来越多的开源 LLM进入市场,使开发者、AI 研究人员与社会更易理解与操作 LLM。
- 偏见与歧视。取决于用于训练多模态 AI 模型的数据,它们可能包含偏见,从而导致不公平决策,且常加剧对少数群体的歧视。如前所述,透明度在此至关重要,以便更好理解并应对潜在偏见。
- 隐私问题。多模态 AI 模型使用来自多个来源与格式的海量数据进行训练,其中很多情况下可能包含个人数据。这会引发与数据隐私和安全相关的问题与风险。
- 伦理考量。多模态 AI 有时会做出对我们生活影响重大的决定,并对基本权利产生显著影响。我们在另一篇文章中探讨了生成式 AI 的伦理。
- 环境考量。研究人员与环保组织对训练与运行生成式 AI 模型所带来的环境足迹表示担忧。专有多模态 AI 模型的拥有者很少公开模型的能耗与资源消耗信息,以及相关的环境足迹。随着这些工具的快速普及,这一情况尤为值得关注。
多模态 AI 的未来
多模态 AI 无疑是生成式 AI 革命的下一个前沿。多模态学习领域的快速发展,正在推动为各种目的构建新模型与新应用。我们仍处在这场革命的初期。随着用于融合更多、更新模态的技术不断涌现,多模态 AI 的应用范围将进一步扩大。
然而,能力越大,责任越大。多模态 AI 伴随严峻的风险与挑战,必须加以解决,以确保公正与可持续的未来。
如果您想开始学习生成式 AI,DataCamp 为您提供支持。请查看我们专门的课程、博客与资料:


2022 年 11 月,OpenAI 发布了 ChatGPT。短短几天内,它便以前所未有的能力风靡全球。生成式人工智能的革命由此开启,人人都在问同一个问题:接下来会怎样?
当时,ChatGPT 以及许多由大型语言模型(LLM)驱动的生成式 AI 工具都被设计为处理用户的文本输入并生成文本输出。换言之,它们被视为单模态 AI 工具。
不过,这只是开始。我们当时仅仅触及了 LLM 能力的冰山一角。ChatGPT 发布仅一年后,行业的进步已令人瞠目结舌,前沿边界难以捉摸,我们在另一篇关于ChatGPT 与生成式 AI 的长期影响的文章中对此进行了分析。
如今,如果要回答“接下来是什么?”这个问题,最好的答案或许是多模态学习。这是当前 AI 革命中最具前景的趋势之一。多模态生成式 AI 模型能够结合多种类型的输入,并生成可能同时包含多种类型的输出。
在本指南中,我们将带您了解多模态 AI 的概念。我们将探讨多模态 AI 的定义、核心概念、底层技术与应用,以及如何在真实场景中加以实现。准备好迎接多模态了吗?让我们开始吧!
理解多模态 AI
尽管大多数先进的生成式 AI 工具仍无法像人类那样思考,但它们已经带来了突破性成果,让我们离通用人工智能(AGI)的门槛更近一步。该术语指一种假想的 AI 系统,能够像人类一样在广泛任务中理解、学习并应用知识。
在如何实现 AGI 的讨论中,一个核心问题是我们必须理解人类如何学习,这就引出了人类大脑的工作方式。长话短说,我们的大脑依赖五感从周围环境中收集各类信息。随后,这些信息被存储于记忆中,经由处理以习得新见解,并被用来做出决策。
第一代现代生成式 AI 模型(如 ChatGPT)被认为是单模态的;也就是说,它们只能接收一种类型的数据作为输入,并生成同类型的输出。特别是,其中大多数模型被设计为处理文本提示并生成文本回应。
这很合理,因为这些模型需要海量数据进行训练,而文本不仅易于存储和处理,也极为易得。毫不奇怪,像 ChatGPT 这样的工具,其大部分训练数据来自互联网的不同来源。我们在《What is ChatGPT》一文中解释了这些技术细节,并直接向 ChatGPT 提出了相关问题。
然而,阅读只是人类学习新事物的众多方式之一,而且在许多任务中并非最有效的方式。
多模态学习是 AI 的一个分支领域,旨在通过使用海量文本以及其他数据类型(亦称感知数据,如图像、视频或音频录音)来训练机器,从而提升其学习能力。这使模型能够学习文本描述与其相关图像、视频或音频之间的新模式与关联。
多模态学习正在为智能系统解锁新的可能性。在训练过程中融合多种数据类型,使多模态 AI 模型能够接受多种模态的输入,并生成多种类型的输出。例如,作为 ChatGPT 的基础模型的 GPT-4,既能接收图像与文本输入并生成文本输出,而 OpenAI 近期发布的Sora则是文本生成视频模型。
多模态 AI 的核心概念
多模态生成式 AI 模型在最先进的 LLM 基础上增加了新的复杂性。这些模型基于一种称为 Transformer 的神经网络架构。该架构由谷歌研究人员提出,依赖编码器-解码器架构与注意力机制实现高效数据处理。
这一过程相当复杂,理解起来并不容易。如果您想更深入了解 LLM 与 Transformer 的工作原理,我们强烈建议阅读我们的《Transformer 如何工作》指南;或者如果您想亲自动手、逐步学习如何构建 LLM,请查看我们的《大型语言模型(LLM)概念》课程。
来源:DataCamp
多模态 AI 依赖数据融合技术来整合异构数据类型,从而对底层数据形成更完整、更准确的理解。其最终目标是通过融合不同模态所提供的互补信息,做出更优预测。
单模态 vs 多模态 AI。来源:ResearchGate
为解决多模态挑战,可以采用多种数据融合技术。根据融合发生的处理阶段不同,我们可将数据融合技术分为三类:
不存在一种适用于所有场景的通用数据融合技术。所选技术将取决于具体的多模态任务。因此,往往需要通过试错来找到最合适的多模态 AI 流水线。
驱动多模态 AI 的技术
多模态 AI 是多个 AI 分支领域累积知识的结晶。近年来,AI 从业者与学者在多种格式与模态的数据存储和处理方面取得了长足进展。
下面列出了推动多模态 AI 蓬勃发展的关键领域:
深度学习
深度学习是 AI 的一个分支,使用称为人工神经网络的算法来解决复杂任务。当前的生成式 AI 革命由深度学习模型驱动,尤其是作为一种神经网络架构的 Transformer。
多模态 AI 的未来同样取决于该领域的新进展。特别需要研究的是增强 Transformer 能力的新方法,以及新的数据融合技术。
查看我们的《Python 深度学习》技能路径,在这一前景广阔的领域更进一步。
自然语言处理(NLP)
NLP 是人工智能中的关键技术,架起了人类交流与计算机理解之间的桥梁。它是一个多学科领域,使计算机能够解释、分析与生成自然语言,从而实现人机无缝互动。
由于与机器沟通的主要方式是文本,NLP 对于确保生成式 AI 模型(包括多模态模型)的高性能至关重要,这并不令人意外。
对 NLP 感兴趣?查看我们的《Python 自然语言处理》技能路径,掌握将非结构化数据转化为有价值洞见的核心 NLP 技能。
计算机视觉
图像分析(也称计算机视觉)包含一系列使计算机能够“看见”并理解图像的技术。该领域的进步推动了多模态 AI 模型的发展,使其能够将图像与视频作为输入与输出进行处理。
如果您希望进一步探索这一迷人主题,请查看我们的《Python 图像处理》技能路径,将图像处理技能纳入您的数据科学工具箱。
音频处理
部分最先进的生成式 AI 模型能够将音频文件作为输入与输出进行处理。音频处理的可能性涵盖从语音消息理解到同声翻译与音乐创作。
查看我们的《Python 语音语言处理》课程,学习如何在 Python 中从原始音频文件加载、转换与转写语音。
多模态 AI 的应用
多模态学习让机器获得新的“感官”,提升其准确性与解读能力。这些能力正在为各行各业带来大量新应用,包括:
增强的生成式 AI
第一代大多数生成式 AI 模型都是文本到文本,能够处理用户的文本提示并给出文本答案。多模态模型,如GPT-4 Turbo、Google Gemini或DALL-E,带来了新的可能性,可在输入与输出两端改善用户体验。无论是接受多种模态的提示,还是以多种格式生成内容,多模态 AI 代理的潜力似乎无限。
自动驾驶汽车
自动驾驶汽车高度依赖多模态 AI。车辆配备多个传感器,以多种格式处理来自环境的信息。多模态学习对于有效高效地融合这些信息源、并在实时中做出智能决策至关重要。
生物医学
来自生物样本库、电子健康记录、临床影像与医疗传感器,以及基因组数据等生物医学数据的日益丰富,正在推动医疗领域多模态 AI 模型的诞生。这些模型能够处理以多种模态提供的多类数据源,帮助我们揭示人类健康与疾病之谜,并做出智能的临床决策。
地球科学与气候变化
地面传感器、无人机、卫星数据与其他测量技术的快速发展,正在提升我们理解地球的能力。多模态 AI 对准确整合这些信息至关重要,并可创建新的应用与工具,助力完成多种任务,例如温室气体排放监测、极端气候事件预测与精准农业。
实施多模态 AI 方案的挑战
多模态 AI 的兴起为企业、政府和个人带来了无尽可能。但与所有新兴技术一样,将其落地到日常运营中也并非易事。
首先,您需要找到契合自身需求的用例。从概念到部署并不总是顺利,尤其当您缺乏真正理解多模态 AI 技术细节的人才时。鉴于当前的数据素养技能缺口,寻找适合的人才将模型投入生产可能既困难又昂贵,因为企业愿意为这类稀缺人才支付高薪。
最后,谈到生成式 AI,成本问题必不可少。此类模型,尤其是多模态模型,需要大量计算资源才能运行,而这意味着资金投入。因此,在采用任何生成式 AI 解决方案之前,务必评估您希望投入的资源。
多模态 AI 的风险
与任何新技术一样,我们在使用多模态 AI 模型时必须警惕多种潜在陷阱:
多模态 AI 的未来
多模态 AI 无疑是生成式 AI 革命的下一个前沿。多模态学习领域的快速发展,正在推动为各种目的构建新模型与新应用。我们仍处在这场革命的初期。随着用于融合更多、更新模态的技术不断涌现,多模态 AI 的应用范围将进一步扩大。
然而,能力越大,责任越大。多模态 AI 伴随严峻的风险与挑战,必须加以解决,以确保公正与可持续的未来。
如果您想开始学习生成式 AI,DataCamp 为您提供支持。请查看我们专门的课程、博客与资料: