“R vs. Python”的语言之争由来已久。作为数据科学领域的事实标准编程语言,它们各自吸引了来自不同领域的拥趸。结果是,很多实践者没有充分利用两种语言的优势,而是只专精于其中一种工具。然而,作为一名同时掌握 R 和 Python 的双语数据科学家,您将在职业生涯中更好地解决遇到的各种问题。
随着 Python 的流行度不断攀升,越来越多的 R 用户开始转向 Python。因此,如果您是 R 用户,不妨将本文视为可融入您日常工作流程的 Python 库总览。有些库拥有与 R 相近的语法,便于平滑切换;另一些则在功能与速度上更具优势。
R 用户必看的顶级 Python 包
数据处理类库
R 拥有丰富的数据处理生态。不论是 dplyr、tidyr,还是 data.table,R 用户都能随手取用多种工具。不过,若追求更强的灵活性、速度与特性,不妨考虑一些 Python 替代方案。
Pandas
在 Python 的数据处理包中,pandas首屈一指。它是 Python 数据科学栈中最重要的数据处理库,拥有全球数百万用户。目前其周下载量超过 2,000 万次,位列最受欢迎的 Python 包之列。
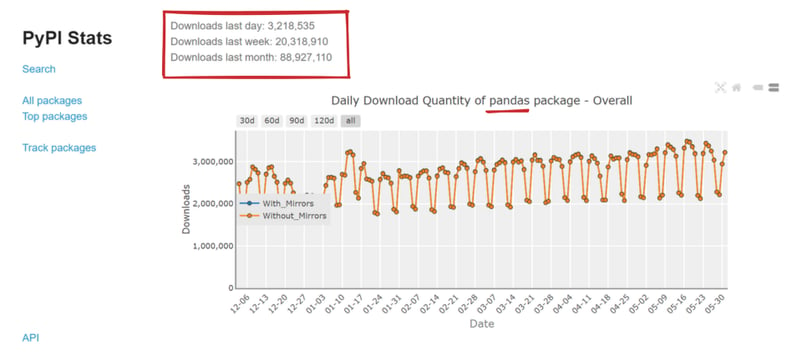
pandas 下载统计,来源于 PyPI Stats 网站。
它为数据处理提供了极为丰富的函数与类,即便有多年经验,您仍可能不断在 pandas 中学到新技巧。pandas 也是整个生态的基石库,本文提到的许多 Python 库都围绕 pandas 的数据结构来设计其功能。
尽管功能广泛,但它易学易用。掌握少量核心类与函数,便能对任意数据集开展复杂分析。
Python 的 datatable 包
如果 pandas 的语法对 R 用户来说过于陌生,那么使用 Python 的 datatable 包会更得心应手。它受 R 同名包启发而来,专为处理当今的海量数据而编写,能够在数秒内读取和处理以 GB 计的大文件。
一个常见用法是先用 datatable 读取大型数据集,然后转换为 pandas 的 DataFrame 格式,这通常比直接用 pandas 读取更快。不过,作为 R 用户,您甚至无需转换,因为 datatable 的语法与 R 的 data.table 几乎一致。
RapidsAI 与 cuDF
打算切换到 Python 的 R 用户,还能受益于 Python 库对 GPU 的广泛支持所带来的性能提升。RapidsAI 通过 cuDF 库提供了这样的机会。cuDF 是一个 dataframe 库,能借助 NVIDIA GPU 的算力来处理包含数十亿行的数据集。cuDF 的另一优势在于其语法与 pandas 相近。
数据可视化类库
R 的 ggplot2 为数据可视化包树立了标杆,也是数据科学中应用最广的库之一。不过——对于想在 Python 中进行数据可视化的 R 用户而言——有许多可堪比拟的替代方案。
Matplotlib
人们在开始学习 Python 数据科学时,最先接触的库之一就是 Matplotlib。它难得地在复杂度与灵活性之间达成了平衡。换言之,新手可以轻松上手制作高质量图表,而有经验的用户也拥有足够的工具来创建令人惊叹的自定义可视化。
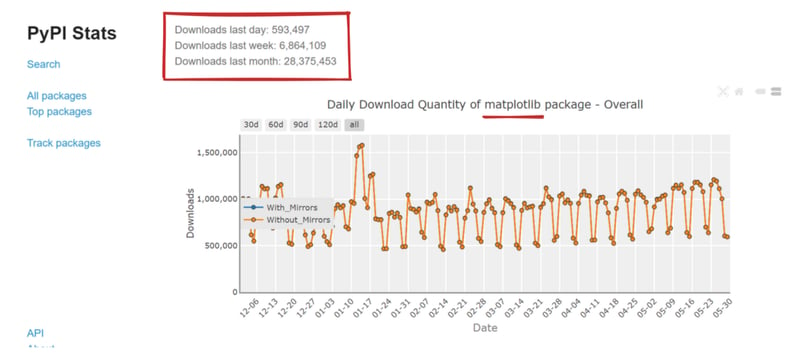
Matplotlib 下载统计,来源于 PyPI Stats 网站。
Seaborn
Matplotlib 的不足在于图表通常需要大量自定义。不过,如果您想更轻松地得到风格统一的图表,可以试试 Seaborn。它是 Matplotlib 的一层封装,使初学者更容易绘制美观的图表。Seaborn 还引入了 Matplotlib 中不易实现的新图表类型和子图工具。
Plotly 与 Dash
Python 还支持使用多种交互式可视化库来创建交互式图形。其中最值得一提的是 Plotly,它在 R 领域同样根基深厚。Plotly 擅长生成高质量的交互式图表,并提供丰富接口来自定义和创建复杂可视化。
此外,Python 的 Dash 框架构建于 Plotly 之上,可轻松创建用于承载仪表板的精美 Web 应用。另一个能轻松创建交互式图表的 Python 库是 Bokeh,它也支持将可视化轻松部署为 Web 应用。
Plotnine
若您在 Python 中寻找一个“原生”的 ggplot2 替代品,plotnine 提供了对图形语法的 Python 实现。它的语法与风格与 ggplot2 极为相似,可为希望立即在 Python 中开始数据可视化的 R 用户带来无缝体验。
数学与统计类库
原生 Python 并不像 R 那样自带大量统计函数,但它的类库足以弥补这一不足。
NumPy
首先是强大的 NumPy,很多其他关键的 Python 包都以它为基础。它是出色的数组运算库,提供了丰富的向量化数学函数。在矩阵运算速度上,它也许只与Julia这种编程史上最快的语言之一相媲美。
NumPy 的 n 维数组是诸多重要计算库的支柱,例如 TensorFlow 或 PyTorch。因此,NumPy 的下载量远高于 pandas 与 Matplotlib 之和。
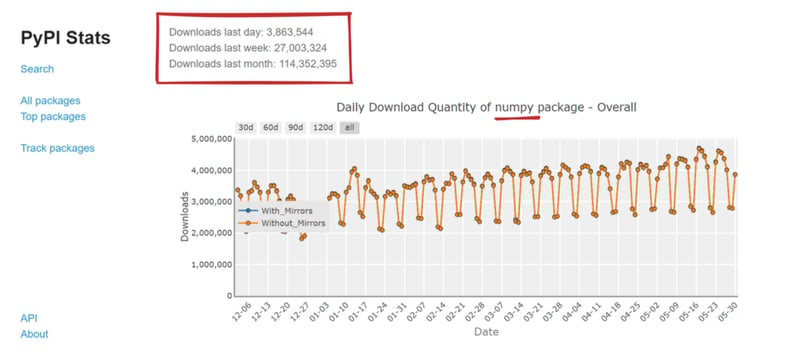
Numpy 下载统计,来源于 PyPI Stats 网站。
SciPy
如果在 NumPy 中找不到所需函数,SciPy 就是答案。它针对数学、物理与统计等各类计算应用提供了独立子模块。
其中的特殊函数模块为研究者提供了经过速度优化的数理物理函数。您可以使用其 optimization 模块来求解优化问题,而 integrate 与 fft 模块则负责微积分与傅里叶变换。它的 linalg 模块囊括了 NumPy linalg 的全部功能,并提供更多高级且小众的线性代数函数。该模块对 BLAS/LAPACK(线性代数标准基础软件库)支持出色,速度甚至快于 NumPy。
它还可高效处理多维图像。虽然 NumPy 处理 2D/3D 图像表现出色,但在医学、生物学等领域的高阶图像上并不轻松;这时就可以使用 SciPy 的 ndimage 模块。
Statsmodels
尽管上述包更偏重数学而非统计,Python 同样提供了 statsmodels。这是一个庞大的库,提供大量函数与类来估计各类统计模型、进行假设检验并探索数据。
它拥有完整的回归分析函数与成熟的广义线性模型 API。其时间序列分析模块尤为实用,内含执行与可视化时间序列的专用函数。
其他模块可用于生存与持续时间分析、非参数方法与多元统计。令 R 用户欣喜的是,这些模块在函数书写与输出格式上大多采用 R 式语法。对于纯统计分析而言,statsmodels 将 NumPy、SciPy 与 Matplotlib 有机融合。
机器学习类库
在这个领域,R 用户选择 Python 可能受益最大。Python 的机器学习库比 R 更加完整,提供了用于数据预处理、特征工程、超参数调优、建模等在内的大量算法与工具。
Scikit-learn
首先要提的是 scikit-learn。它是 Python 中最流行的机器学习框架,如今大多数机器学习从业者都在使用它。
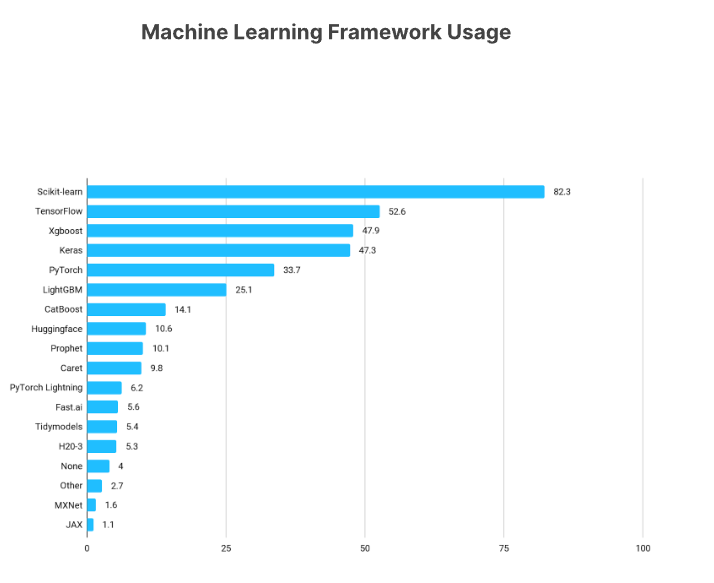
摘自 Kaggle 的《2021 年数据科学与机器学习现状调查》
Scikit-learn 提供了覆盖回归、二分类与多分类的海量监督学习算法。它还针对数据预处理、流水线、降维、特征工程、特征选择、缺失值填补与聚类等提供了专门子模块。
尽管类与功能众多,但其 API 直观简洁。Scikit-learn 在贯彻《Python 之禅》中 20 条代码设计理念方面表现卓越。
XGBoost
如果说 scikit-learn 有不足,那就是缺乏 GPU 支持。其全部算法运行在 CPU 上,因此当需要借助 GPU 加速计算时,人们自然会转向其他框架。R 用户已相当熟悉的 XGBoost 就是其中之一。
得益于最先进的 GPU 加速梯度提升树,它在保持高性能的同时,能比其他机器学习框架更快地解决监督学习任务。上图也显示,它在 Python 社区颇受欢迎,并在 Kaggle 的表格数据竞赛中长期占优。
LightGBM 与 Catboost
两款类似的库是 LightGBM 与 CatBoost。LightGBM 相比 XGBoost 对内存的需求显著更低,而 CatBoost 在速度与精度上具有优势。这三款梯度提升库都可采用 Scikit-learn 风格的 API,使用起来非常便捷。
超越语言之争:面向现代数据科学家的 R 与 Python
尽管 R 与 Python 各有长处,但将其描述为“语言之争”对数据科学家并无益处。在最近做客 DataFramed 播客时,《Python and R for the Modern Data Scientist》一书的作者 Rick Scavetta 与 Boyan Angelov 谈到了成为双语数据科学家的优势,以及现代数据团队如何从双语实践者中获益。
他们在节目中指出,将问题框定为语言之争的一个关键弊端,是 R 与 Python 社区内“单一文化”思维的抬头。对这种单一文化或“我们对他们”心态的最佳反驳之一,是“锤子与钉子”的类比——如果您手里只有一把锤子,看什么都像钉子。
换言之,“语言优先”的思维会限制您的创造力与有效解决问题的能力。若采用“解决方案优先”的方法,您会从“概念”层面来审视问题的解法,而非固守于某种语言所提供的固定手段。
同时掌握 R 与 Python,能让您在不同情境下各取所长。例如,作者指出,R 借助 ggplot2 在数据可视化方面表现出色,其汇报生态(结合 R Markdown 与 Shiny)也十分成熟;而 Python 则在机器学习、API 与 MLOps 方面更具优势。
作者在书中给出了一个精彩的案例,展示了如何让两种语言彼此通信。借助 RStudio 中的 reticulate 等工具,您可以在 R 中调用 Python 脚本并运行 Python 包,从而在两种语言之间自由传递对象。
如果您是 R 用户,如今要成为一名双语数据科学家从未如此容易。想进一步学习 Python,欢迎查阅我们的精选资源合集。
“R vs. Python”的语言之争由来已久。作为数据科学领域的事实标准编程语言,它们各自吸引了来自不同领域的拥趸。结果是,很多实践者没有充分利用两种语言的优势,而是只专精于其中一种工具。然而,作为一名同时掌握 R 和 Python 的双语数据科学家,您将在职业生涯中更好地解决遇到的各种问题。
随着 Python 的流行度不断攀升,越来越多的 R 用户开始转向 Python。因此,如果您是 R 用户,不妨将本文视为可融入您日常工作流程的 Python 库总览。有些库拥有与 R 相近的语法,便于平滑切换;另一些则在功能与速度上更具优势。
R 用户必看的顶级 Python 包
数据处理类库
R 拥有丰富的数据处理生态。不论是
dplyr、tidyr,还是data.table,R 用户都能随手取用多种工具。不过,若追求更强的灵活性、速度与特性,不妨考虑一些 Python 替代方案。Pandas
在 Python 的数据处理包中,
pandas首屈一指。它是 Python 数据科学栈中最重要的数据处理库,拥有全球数百万用户。目前其周下载量超过 2,000 万次,位列最受欢迎的 Python 包之列。pandas 下载统计,来源于 PyPI Stats 网站。
它为数据处理提供了极为丰富的函数与类,即便有多年经验,您仍可能不断在 pandas 中学到新技巧。
pandas也是整个生态的基石库,本文提到的许多 Python 库都围绕 pandas 的数据结构来设计其功能。尽管功能广泛,但它易学易用。掌握少量核心类与函数,便能对任意数据集开展复杂分析。
Python 的 datatable 包
如果
pandas的语法对 R 用户来说过于陌生,那么使用 Python 的 datatable 包会更得心应手。它受 R 同名包启发而来,专为处理当今的海量数据而编写,能够在数秒内读取和处理以 GB 计的大文件。一个常见用法是先用 datatable 读取大型数据集,然后转换为 pandas 的 DataFrame 格式,这通常比直接用
pandas读取更快。不过,作为 R 用户,您甚至无需转换,因为 datatable 的语法与 R 的data.table几乎一致。RapidsAI 与 cuDF
打算切换到 Python 的 R 用户,还能受益于 Python 库对 GPU 的广泛支持所带来的性能提升。RapidsAI 通过 cuDF 库提供了这样的机会。
cuDF是一个 dataframe 库,能借助 NVIDIA GPU 的算力来处理包含数十亿行的数据集。cuDF的另一优势在于其语法与 pandas 相近。数据可视化类库
R 的
ggplot2为数据可视化包树立了标杆,也是数据科学中应用最广的库之一。不过——对于想在 Python 中进行数据可视化的 R 用户而言——有许多可堪比拟的替代方案。Matplotlib
人们在开始学习 Python 数据科学时,最先接触的库之一就是 Matplotlib。它难得地在复杂度与灵活性之间达成了平衡。换言之,新手可以轻松上手制作高质量图表,而有经验的用户也拥有足够的工具来创建令人惊叹的自定义可视化。
Matplotlib 下载统计,来源于 PyPI Stats 网站。
Seaborn
Matplotlib 的不足在于图表通常需要大量自定义。不过,如果您想更轻松地得到风格统一的图表,可以试试 Seaborn。它是 Matplotlib 的一层封装,使初学者更容易绘制美观的图表。Seaborn 还引入了 Matplotlib 中不易实现的新图表类型和子图工具。
Plotly 与 Dash
Python 还支持使用多种交互式可视化库来创建交互式图形。其中最值得一提的是 Plotly,它在 R 领域同样根基深厚。Plotly 擅长生成高质量的交互式图表,并提供丰富接口来自定义和创建复杂可视化。
此外,Python 的 Dash 框架构建于 Plotly 之上,可轻松创建用于承载仪表板的精美 Web 应用。另一个能轻松创建交互式图表的 Python 库是 Bokeh,它也支持将可视化轻松部署为 Web 应用。
Plotnine
若您在 Python 中寻找一个“原生”的
ggplot2替代品,plotnine 提供了对图形语法的 Python 实现。它的语法与风格与ggplot2极为相似,可为希望立即在 Python 中开始数据可视化的 R 用户带来无缝体验。数学与统计类库
原生 Python 并不像 R 那样自带大量统计函数,但它的类库足以弥补这一不足。
NumPy
首先是强大的 NumPy,很多其他关键的 Python 包都以它为基础。它是出色的数组运算库,提供了丰富的向量化数学函数。在矩阵运算速度上,它也许只与Julia这种编程史上最快的语言之一相媲美。
NumPy 的 n 维数组是诸多重要计算库的支柱,例如 TensorFlow 或 PyTorch。因此,NumPy 的下载量远高于 pandas 与 Matplotlib 之和。
Numpy 下载统计,来源于 PyPI Stats 网站。
SciPy
如果在 NumPy 中找不到所需函数,SciPy 就是答案。它针对数学、物理与统计等各类计算应用提供了独立子模块。
其中的特殊函数模块为研究者提供了经过速度优化的数理物理函数。您可以使用其
optimization模块来求解优化问题,而integrate与fft模块则负责微积分与傅里叶变换。它的 linalg 模块囊括了 NumPylinalg的全部功能,并提供更多高级且小众的线性代数函数。该模块对 BLAS/LAPACK(线性代数标准基础软件库)支持出色,速度甚至快于 NumPy。它还可高效处理多维图像。虽然 NumPy 处理 2D/3D 图像表现出色,但在医学、生物学等领域的高阶图像上并不轻松;这时就可以使用 SciPy 的
ndimage模块。Statsmodels
尽管上述包更偏重数学而非统计,Python 同样提供了
statsmodels。这是一个庞大的库,提供大量函数与类来估计各类统计模型、进行假设检验并探索数据。它拥有完整的回归分析函数与成熟的广义线性模型 API。其时间序列分析模块尤为实用,内含执行与可视化时间序列的专用函数。
其他模块可用于生存与持续时间分析、非参数方法与多元统计。令 R 用户欣喜的是,这些模块在函数书写与输出格式上大多采用 R 式语法。对于纯统计分析而言,
statsmodels将 NumPy、SciPy 与 Matplotlib 有机融合。机器学习类库
在这个领域,R 用户选择 Python 可能受益最大。Python 的机器学习库比 R 更加完整,提供了用于数据预处理、特征工程、超参数调优、建模等在内的大量算法与工具。
Scikit-learn
首先要提的是
scikit-learn。它是 Python 中最流行的机器学习框架,如今大多数机器学习从业者都在使用它。摘自 Kaggle 的《2021 年数据科学与机器学习现状调查》
Scikit-learn 提供了覆盖回归、二分类与多分类的海量监督学习算法。它还针对数据预处理、流水线、降维、特征工程、特征选择、缺失值填补与聚类等提供了专门子模块。
尽管类与功能众多,但其 API 直观简洁。Scikit-learn 在贯彻《Python 之禅》中 20 条代码设计理念方面表现卓越。
XGBoost
如果说
scikit-learn有不足,那就是缺乏 GPU 支持。其全部算法运行在 CPU 上,因此当需要借助 GPU 加速计算时,人们自然会转向其他框架。R 用户已相当熟悉的 XGBoost 就是其中之一。得益于最先进的 GPU 加速梯度提升树,它在保持高性能的同时,能比其他机器学习框架更快地解决监督学习任务。上图也显示,它在 Python 社区颇受欢迎,并在 Kaggle 的表格数据竞赛中长期占优。
LightGBM 与 Catboost
两款类似的库是 LightGBM 与 CatBoost。LightGBM 相比 XGBoost 对内存的需求显著更低,而 CatBoost 在速度与精度上具有优势。这三款梯度提升库都可采用 Scikit-learn 风格的 API,使用起来非常便捷。
超越语言之争:面向现代数据科学家的 R 与 Python
尽管 R 与 Python 各有长处,但将其描述为“语言之争”对数据科学家并无益处。在最近做客 DataFramed 播客时,《Python and R for the Modern Data Scientist》一书的作者 Rick Scavetta 与 Boyan Angelov 谈到了成为双语数据科学家的优势,以及现代数据团队如何从双语实践者中获益。
他们在节目中指出,将问题框定为语言之争的一个关键弊端,是 R 与 Python 社区内“单一文化”思维的抬头。对这种单一文化或“我们对他们”心态的最佳反驳之一,是“锤子与钉子”的类比——如果您手里只有一把锤子,看什么都像钉子。
换言之,“语言优先”的思维会限制您的创造力与有效解决问题的能力。若采用“解决方案优先”的方法,您会从“概念”层面来审视问题的解法,而非固守于某种语言所提供的固定手段。
同时掌握 R 与 Python,能让您在不同情境下各取所长。例如,作者指出,R 借助 ggplot2 在数据可视化方面表现出色,其汇报生态(结合 R Markdown 与 Shiny)也十分成熟;而 Python 则在机器学习、API 与 MLOps 方面更具优势。
作者在书中给出了一个精彩的案例,展示了如何让两种语言彼此通信。借助 RStudio 中的 reticulate 等工具,您可以在 R 中调用 Python 脚本并运行 Python 包,从而在两种语言之间自由传递对象。
如果您是 R 用户,如今要成为一名双语数据科学家从未如此容易。想进一步学习 Python,欢迎查阅我们的精选资源合集。