De "R vs. Python"-taalstrijd gaat al jaren terug. Als de facto programmeertalen voor data science trekken ze verschillende supporters aan uit uiteenlopende domeinen. Daardoor benutten practitioners vaak niet het volle potentieel van beide talen en beperken ze zich tot het beheersen van slechts één tool. Maar als je als tweetalige data scientist zowel R als Python leert gebruiken, kun je problemen in je carrière effectiever aanpakken.
Nu Python steeds populairder wordt, stappen steeds meer R-gebruikers over op Python. Dus als je een R-gebruiker bent, zie dit artikel dan als een overzicht van Python-libraries die je in je dagelijkse workflow kunt opnemen. Sommige hebben R-achtige syntax voor een soepele overstap, terwijl andere meer functionaliteit en snelheid bieden.
Top Python-packages voor R-gebruikers
Libraries voor datamanipulatie
R heeft een rijk ecosysteem van libraries voor datamanipulatie. Of het nu dplyr, tidyr of data.table is, R-gebruikers hebben volop tools tot hun beschikking. Toch loont het om enkele Python-alternatieven te overwegen voor meer flexibiliteit, snelheid en features.
Pandas
De belangrijkste onder de Python-packages voor datamanipulatie is de pandas-library. Dit is hét toonaangevende pakket voor datamanipulatie in de Python data science-stack en wordt wereldwijd door miljoenen gebruikt. Het heeft momenteel meer dan 20 miljoen wekelijkse downloads en behoort tot de populairste Python-packages.
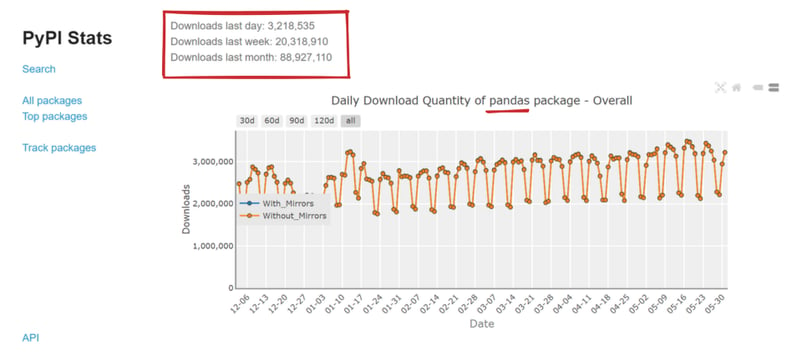
pandas-downloadstatistieken van de PyPI Stats-website.
Het biedt zo'n uitgebreide reeks functies en classes om met data te werken, dat je zelfs na jaren ervaring nog steeds nieuwe technieken met pandas kunt ontdekken. pandas is ook een hoeksteen in het ecosysteem, omdat veel andere Python-libraries in dit artikel zo zijn geschreven dat hun functionaliteit aansluit op de classes van pandas.
Hoewel het zo'n uitgebreide library is, is het eenvoudig te leren en te beheersen. Met een paar classes en functies kun je complexe analyses op elk dataset uitvoeren.
Het datatable-package van Python
Als de syntax van pandas te onwennig oogt voor R-gebruikers, voelen ze zich meteen thuis met het Python datatable-package. Het is geïnspireerd op de R-tegenhanger en speciaal gebouwd voor de enorme datasets van vandaag. Het kan gigabytes aan bestanden in enkele seconden inlezen en manipuleren.
Een alledaags gebruiksscenario is om een grote dataset met datatable in te lezen en te converteren naar het pandas DataFrame-formaat, wat veel sneller is dan het puur met pandas inlezen. Maar als R-gebruiker hoef je dat niet eens te doen, want datatable heeft bijna dezelfde syntax als het R-package data.table.
RapidsAI & cuDF
R-gebruikers die willen overstappen op Python kunnen ook profiteren van betere performance dankzij de brede GPU-ondersteuning in Python-libraries. RapidsAI biedt die mogelijkheid via de cuDF-library. cuDF is een dataframe-library waarmee je datasets met miljarden rijen kunt manipuleren door gebruik te maken van de rekenkracht van NVIDIA GPU’s. Een ander voordeel van cuDF is de vergelijkbare syntax met pandas.
Libraries voor datavisualisatie
R’s ggplot2 is de standaard voor datavisualisatie-packages en behoort tot de meest gebruikte libraries in data science. Maar voor elke R-gebruiker die wil overstappen op Python voor datavisualisatie zijn er volop waardige alternatieven.
Matplotlib
Matplotlib is een van de eerste libraries die mensen tegenkomen als ze beginnen met data science in Python. Het is een van de zeldzame libraries die complexiteit en flexibiliteit perfect in balans houden. Met andere woorden: het is voor beginners makkelijk om mooie grafieken te maken, terwijl gevorderde gebruikers alle tools hebben om werkelijk verbluffende, custom plots te creëren.
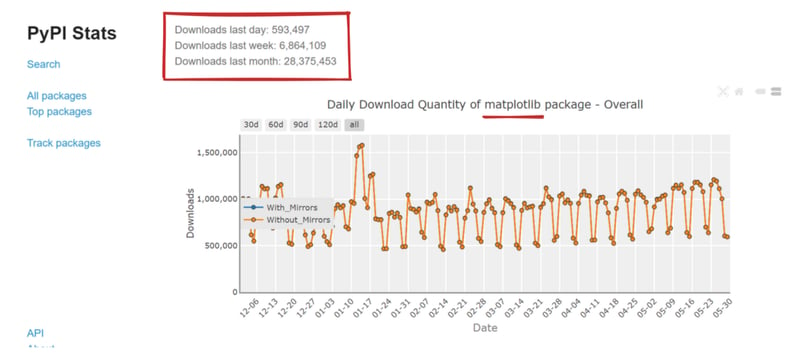
Matplotlib-downloadstatistieken van de PyPI Stats-website.
Seaborn
Het nadeel van Matplotlib is dat grafieken vaak veel maatwerk vereisen. Voor gemakkelijk te stylen grafieken kun je echter Seaborn bekijken. Het is een wrapper-API rond Matplotlib, waardoor het voor beginners aanzienlijk eenvoudiger is om zeer esthetische grafieken te maken. Seaborn introduceert ook nieuwe plottypes en subplot-tools die niet rechtstreeks in Matplotlib beschikbaar zijn.
Plotly & Dash
Met Python kun je ook interactieve datavisualisaties maken met diverse interactieve libraries. De bekendste is Plotly, dat ook stevige wortels in R heeft. Het is uitstekend voor hoogwaardige interactieve grafieken en biedt interfaces om complexe plots te customizen en te bouwen.
Bovendien is het Dash-framework van Python gebouwd op Plotly en maakt het eenvoudig om mooie webapps te maken om dashboards te hosten. Een andere Python-library waarmee je eenvoudig interactieve plots maakt is Bokeh, waarmee je visualisaties ook makkelijk als webapp kunt uitrollen.
Plotnine
Voor wie een natuurlijke ggplot2-alternatief in Python zoekt, biedt het plotnine-package een implementatie van de grammar of graphics in Python. De syntax en esthetiek lijken sterk op die van het ggplot2-package, wat R-gebruikers een naadloze ervaring geeft om direct te beginnen met visualiseren in Python.
Wiskunde- en statistieklibraries
Van zichzelf zit Python niet vol met statistische functies zoals R. Toch maken de libraries dit ruimschoots goed.
NumPy
De eerste is de machtige NumPy, die vele andere essentiële Python-packages draagt. Het is een uitstekende array-manipulatielibrary met een rijke selectie aan gevectoriseerde wiskundige functies. De snelheid in matrixmanipulatie wordt misschien alleen geëvenaard door Julia, een van de snelste programmeertalen ooit.
NumPy’s n-dimensionale arrays vormen de ruggengraat van andere belangrijke rekenlibraries zoals TensorFlow en PyTorch. Daarom liggen NumPy’s downloadcijfers veel hoger dan die van pandas en Matplotlib samen.
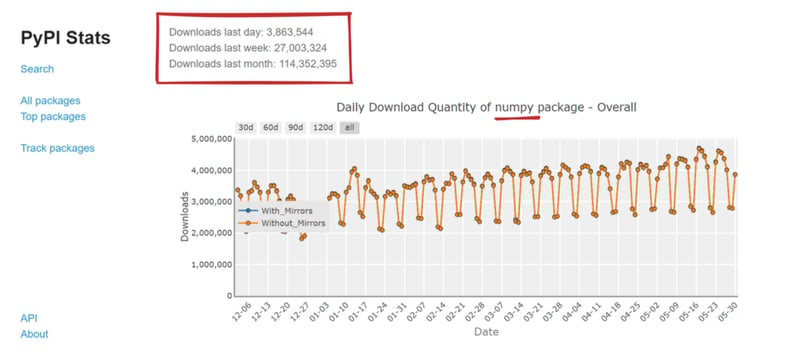
Numpy-downloadstatistieken van de PyPI Stats-website.
SciPy
Als je een functie niet in NumPy vindt, is SciPy het antwoord. Het heeft afzonderlijke submodules voor uiteenlopende computationele toepassingen in wiskunde, natuurkunde en statistiek.
De module met speciale functies bevat essentiële, snelheidsgeoptimaliseerde functies uit de mathematische natuurkunde voor onderzoekers. Je kunt optimalisatieproblemen oplossen met de module optimization, terwijl de modules integrate en fft calculus en Fouriertransformaties behandelen. De linalg-module bevat alles uit NumPy’s linalg plus meer geavanceerde en specialistische lineaire-algebrafuncties. Deze module heeft uitstekende ondersteuning van BLAS/LAPACK (standaardbasissites voor lineaire algebra), wat het nog sneller maakt dan NumPy.
Je kunt er ook efficiënt multidimensionale beelden mee verwerken. NumPy is geweldig voor 2D/3D-beelden, maar kan niet eenvoudig hogere-orde beelden uit domeinen als geneeskunde en biologie verwerken. Daarvoor kun je SciPy’s ndimage-module gebruiken.
Statsmodels
Hoewel de bovenstaande pakketten meer om wiskunde dan om statistiek draaien, biedt Python ook de statsmodels-library. Dit is een omvangrijke library met functies en classes waarmee je veel statistische modellen kunt schatten, hypothesetests kunt uitvoeren en data kunt verkennen.
Er zijn complete functies voor regressieanalyse en volwassen API’s voor generalized linear models. De module Time Series Analysis is bijzonder handig, met gespecialiseerde functies om tijdreeksen uit te voeren en te visualiseren.
Andere modules zijn te gebruiken voor survival- en duuranalyse, niet-parametrische methoden en multivariate statistiek. Tot vreugde van R-gebruikers hanteren de meeste genoemde modules een R-achtige syntax, zowel bij het schrijven van functies als bij het printen van de output. Voor pure statistische analyse is statsmodels de perfecte combinatie van NumPy, SciPy en Matplotlib.
Machine learning-libraries
Hier zullen R-gebruikers waarschijnlijk de meeste meerwaarde vinden in het oppakken van Python. De machine learning-libraries van Python zijn veelomvattender dan die van R en bieden tal van algoritmen en tools voor datapreprocessing, feature engineering, hyperparametertuning, modellering en meer.
Scikit-learn
Het eerste framework is scikit-learn. Dit is het populairste machine learning-framework in Python en wordt vandaag de dag door de meeste ML-practitioners gebruikt.
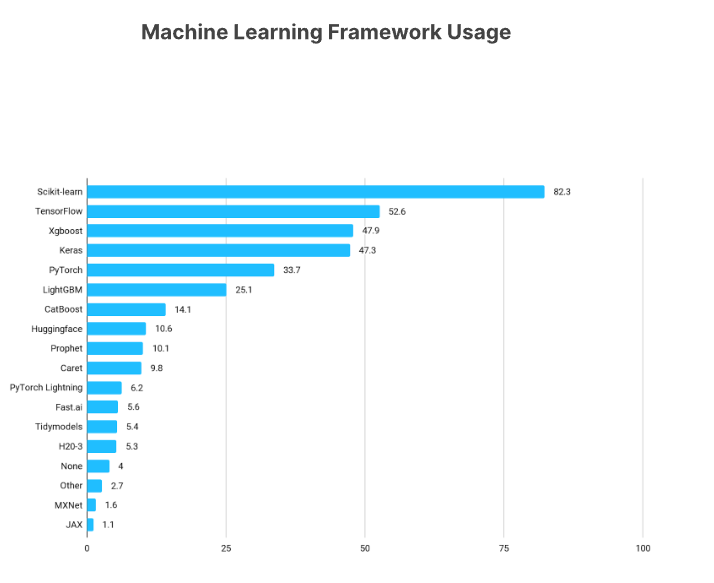
Uit Kaggle’s State of Data Science and Machine Learning Survey 2021
Scikit-learn heeft een enorme selectie aan supervised learning-algoritmen voor regressie en binaire en multiclass-classificatie. Het heeft speciale submodules voor datapreprocessing, pipelines, dimensiereductie, feature engineering, featureselectie, imputatie van missende data en clustering.
Ondanks het grote aantal classes en functionaliteiten heeft het een zeer intuïtieve en eenvoudige API. Scikit-learn slaagt er opmerkelijk goed in om alle 20 Python code design patterns uit de Zen of Python te implementeren.
XGBoost
Als scikit-learn een nadeel heeft, is het het ontbreken van GPU-ondersteuning. Alle algoritmen draaien op de CPU, dus mensen stappen vanzelf over op andere frameworks wanneer ze meer rekensnelheid met GPU-ondersteuning nodig hebben. Een library waar R-gebruikers al bekend mee zijn, is XGBoost.
Met state-of-the-art, GPU-versnelde Gradient Boosted Trees als kern kan het supervised learning-taken veel sneller oplossen dan andere machine learning-frameworks, met hoge performance. De bovenstaande afbeelding laat zien dat het behoorlijk populair is in de Python-community en tabulaire competities op Kaggle domineert.
LightGBM & CatBoost
Twee vergelijkbare libraries zijn LightGBM en CatBoost. Terwijl LightGBM aanzienlijk minder geheugen nodig heeft dan XGBoost, biedt CatBoost voordelen in snelheid en nauwkeurigheid. Alle drie de gradient-boosted libraries kunnen de Scikit-learn-API implementeren, waardoor ze heel eenvoudig te gebruiken zijn.
Voorbij de taalstrijd: R en Python voor de moderne data scientist
Hoewel R en Python elk hun eigen sterke punten hebben, is het framen als een “taaloorlog” contraproductief voor data scientists. In hun recente optreden in de DataFramed-podcast vertellen de auteurs van "Python and R for the Modern Data Scientist", Rick Scavetta en Boyan Angelov, over de voordelen van een tweetalige data scientist en hoe moderne datateams profiteren van tweetalige professionals.
Door de hele podcast heen bespreken ze hoe een belangrijk nadeel van de taalstrijd het ontstaan van monocultuurdenken binnen de R- en Python-gemeenschappen is. Een van de beste tegenargumenten tegen monocultuur of de "wij versus zij"-mentaliteit is de metafoor van de hamer en de spijker — als je alleen een hamer hebt, lijkt alles op een spijker.
Met andere woorden: de taal-eerstbenadering beperkt je creativiteit en je vermogen om problemen effectief op te lossen. Door een oplossing-eerstbenadering te hanteren, bekijk je de oplossing van je probleem in termen van concepten in plaats van je vast te houden aan wat rigide binnen één taal wordt geboden.
Als je zowel R als Python kent, kun je het beste van beide werelden doelgericht inzetten in contexten waar de één superieur is aan de ander. Zo geven de auteurs aan dat R uitblinkt in datavisualisatie met ggplot2 en hoe volwassen het rapportage-ecosysteem is dankzij R Markdown en Shiny, terwijl ze benadrukken dat Python excelleert in machine learning, API’s en MLOps.
De auteurs schetsen in het boek een sterk casestudy die laat zien hoe je beide talen met elkaar kunt laten communiceren. Met tools zoals reticulate in RStudio kun je Python-scripts aanroepen en Python-packages binnen R draaien, waardoor je objecten vrij tussen de talen kunt uitwisselen.
Als je R-gebruiker bent, is het nog nooit zo eenvoudig geweest om een tweetalige data scientist te worden. Voor meer over het leren van Python bekijk je onze uitgebreide verzameling resources.

 Adel Nehme · 15 min
De "R vs. Python"-taalstrijd gaat al jaren terug. Als de facto programmeertalen voor data science trekken ze verschillende supporters aan uit uiteenlopende domeinen. Daardoor benutten practitioners vaak niet het volle potentieel van beide talen en beperken ze zich tot het beheersen van slechts één tool. Maar als je als tweetalige data scientist zowel R als Python leert gebruiken, kun je problemen in je carrière effectiever aanpakken.
Nu Python steeds populairder wordt, stappen steeds meer R-gebruikers over op Python. Dus als je een R-gebruiker bent, zie dit artikel dan als een overzicht van Python-libraries die je in je dagelijkse workflow kunt opnemen. Sommige hebben R-achtige syntax voor een soepele overstap, terwijl andere meer functionaliteit en snelheid bieden.
Top Python-packages voor R-gebruikers
Libraries voor datamanipulatie
R heeft een rijk ecosysteem van libraries voor datamanipulatie. Of het nu
dplyr,tidyrofdata.tableis, R-gebruikers hebben volop tools tot hun beschikking. Toch loont het om enkele Python-alternatieven te overwegen voor meer flexibiliteit, snelheid en features.Pandas
De belangrijkste onder de Python-packages voor datamanipulatie is de
pandas-library. Dit is hét toonaangevende pakket voor datamanipulatie in de Python data science-stack en wordt wereldwijd door miljoenen gebruikt. Het heeft momenteel meer dan 20 miljoen wekelijkse downloads en behoort tot de populairste Python-packages.pandas-downloadstatistieken van de PyPI Stats-website.
Het biedt zo'n uitgebreide reeks functies en classes om met data te werken, dat je zelfs na jaren ervaring nog steeds nieuwe technieken met pandas kunt ontdekken.
pandasis ook een hoeksteen in het ecosysteem, omdat veel andere Python-libraries in dit artikel zo zijn geschreven dat hun functionaliteit aansluit op de classes van pandas.Hoewel het zo'n uitgebreide library is, is het eenvoudig te leren en te beheersen. Met een paar classes en functies kun je complexe analyses op elk dataset uitvoeren.
Het datatable-package van Python
Als de syntax van
pandaste onwennig oogt voor R-gebruikers, voelen ze zich meteen thuis met het Python datatable-package. Het is geïnspireerd op de R-tegenhanger en speciaal gebouwd voor de enorme datasets van vandaag. Het kan gigabytes aan bestanden in enkele seconden inlezen en manipuleren.Een alledaags gebruiksscenario is om een grote dataset met datatable in te lezen en te converteren naar het pandas DataFrame-formaat, wat veel sneller is dan het puur met
pandasinlezen. Maar als R-gebruiker hoef je dat niet eens te doen, want datatable heeft bijna dezelfde syntax als het R-packagedata.table.RapidsAI & cuDF
R-gebruikers die willen overstappen op Python kunnen ook profiteren van betere performance dankzij de brede GPU-ondersteuning in Python-libraries. RapidsAI biedt die mogelijkheid via de cuDF-library.
cuDFis een dataframe-library waarmee je datasets met miljarden rijen kunt manipuleren door gebruik te maken van de rekenkracht van NVIDIA GPU’s. Een ander voordeel vancuDFis de vergelijkbare syntax met pandas.Libraries voor datavisualisatie
R’s
ggplot2is de standaard voor datavisualisatie-packages en behoort tot de meest gebruikte libraries in data science. Maar voor elke R-gebruiker die wil overstappen op Python voor datavisualisatie zijn er volop waardige alternatieven.Matplotlib
Matplotlib is een van de eerste libraries die mensen tegenkomen als ze beginnen met data science in Python. Het is een van de zeldzame libraries die complexiteit en flexibiliteit perfect in balans houden. Met andere woorden: het is voor beginners makkelijk om mooie grafieken te maken, terwijl gevorderde gebruikers alle tools hebben om werkelijk verbluffende, custom plots te creëren.
Matplotlib-downloadstatistieken van de PyPI Stats-website.
Seaborn
Het nadeel van Matplotlib is dat grafieken vaak veel maatwerk vereisen. Voor gemakkelijk te stylen grafieken kun je echter Seaborn bekijken. Het is een wrapper-API rond Matplotlib, waardoor het voor beginners aanzienlijk eenvoudiger is om zeer esthetische grafieken te maken. Seaborn introduceert ook nieuwe plottypes en subplot-tools die niet rechtstreeks in Matplotlib beschikbaar zijn.
Plotly & Dash
Met Python kun je ook interactieve datavisualisaties maken met diverse interactieve libraries. De bekendste is Plotly, dat ook stevige wortels in R heeft. Het is uitstekend voor hoogwaardige interactieve grafieken en biedt interfaces om complexe plots te customizen en te bouwen.
Bovendien is het Dash-framework van Python gebouwd op Plotly en maakt het eenvoudig om mooie webapps te maken om dashboards te hosten. Een andere Python-library waarmee je eenvoudig interactieve plots maakt is Bokeh, waarmee je visualisaties ook makkelijk als webapp kunt uitrollen.
Plotnine
Voor wie een natuurlijke
ggplot2-alternatief in Python zoekt, biedt het plotnine-package een implementatie van de grammar of graphics in Python. De syntax en esthetiek lijken sterk op die van hetggplot2-package, wat R-gebruikers een naadloze ervaring geeft om direct te beginnen met visualiseren in Python.Wiskunde- en statistieklibraries
Van zichzelf zit Python niet vol met statistische functies zoals R. Toch maken de libraries dit ruimschoots goed.
NumPy
De eerste is de machtige NumPy, die vele andere essentiële Python-packages draagt. Het is een uitstekende array-manipulatielibrary met een rijke selectie aan gevectoriseerde wiskundige functies. De snelheid in matrixmanipulatie wordt misschien alleen geëvenaard door Julia, een van de snelste programmeertalen ooit.
NumPy’s n-dimensionale arrays vormen de ruggengraat van andere belangrijke rekenlibraries zoals TensorFlow en PyTorch. Daarom liggen NumPy’s downloadcijfers veel hoger dan die van pandas en Matplotlib samen.
Numpy-downloadstatistieken van de PyPI Stats-website.
SciPy
Als je een functie niet in NumPy vindt, is SciPy het antwoord. Het heeft afzonderlijke submodules voor uiteenlopende computationele toepassingen in wiskunde, natuurkunde en statistiek.
De module met speciale functies bevat essentiële, snelheidsgeoptimaliseerde functies uit de mathematische natuurkunde voor onderzoekers. Je kunt optimalisatieproblemen oplossen met de module
optimization, terwijl de modulesintegrateenfftcalculus en Fouriertransformaties behandelen. De linalg-module bevat alles uit NumPy’slinalgplus meer geavanceerde en specialistische lineaire-algebrafuncties. Deze module heeft uitstekende ondersteuning van BLAS/LAPACK (standaardbasissites voor lineaire algebra), wat het nog sneller maakt dan NumPy.Je kunt er ook efficiënt multidimensionale beelden mee verwerken. NumPy is geweldig voor 2D/3D-beelden, maar kan niet eenvoudig hogere-orde beelden uit domeinen als geneeskunde en biologie verwerken. Daarvoor kun je SciPy’s
ndimage-module gebruiken.Statsmodels
Hoewel de bovenstaande pakketten meer om wiskunde dan om statistiek draaien, biedt Python ook de
statsmodels-library. Dit is een omvangrijke library met functies en classes waarmee je veel statistische modellen kunt schatten, hypothesetests kunt uitvoeren en data kunt verkennen.Er zijn complete functies voor regressieanalyse en volwassen API’s voor generalized linear models. De module Time Series Analysis is bijzonder handig, met gespecialiseerde functies om tijdreeksen uit te voeren en te visualiseren.
Andere modules zijn te gebruiken voor survival- en duuranalyse, niet-parametrische methoden en multivariate statistiek. Tot vreugde van R-gebruikers hanteren de meeste genoemde modules een R-achtige syntax, zowel bij het schrijven van functies als bij het printen van de output. Voor pure statistische analyse is
statsmodelsde perfecte combinatie van NumPy, SciPy en Matplotlib.Machine learning-libraries
Hier zullen R-gebruikers waarschijnlijk de meeste meerwaarde vinden in het oppakken van Python. De machine learning-libraries van Python zijn veelomvattender dan die van R en bieden tal van algoritmen en tools voor datapreprocessing, feature engineering, hyperparametertuning, modellering en meer.
Scikit-learn
Het eerste framework is
scikit-learn. Dit is het populairste machine learning-framework in Python en wordt vandaag de dag door de meeste ML-practitioners gebruikt.Uit Kaggle’s State of Data Science and Machine Learning Survey 2021
Scikit-learn heeft een enorme selectie aan supervised learning-algoritmen voor regressie en binaire en multiclass-classificatie. Het heeft speciale submodules voor datapreprocessing, pipelines, dimensiereductie, feature engineering, featureselectie, imputatie van missende data en clustering.
Ondanks het grote aantal classes en functionaliteiten heeft het een zeer intuïtieve en eenvoudige API. Scikit-learn slaagt er opmerkelijk goed in om alle 20 Python code design patterns uit de Zen of Python te implementeren.
XGBoost
Als
scikit-learneen nadeel heeft, is het het ontbreken van GPU-ondersteuning. Alle algoritmen draaien op de CPU, dus mensen stappen vanzelf over op andere frameworks wanneer ze meer rekensnelheid met GPU-ondersteuning nodig hebben. Een library waar R-gebruikers al bekend mee zijn, is XGBoost.Met state-of-the-art, GPU-versnelde Gradient Boosted Trees als kern kan het supervised learning-taken veel sneller oplossen dan andere machine learning-frameworks, met hoge performance. De bovenstaande afbeelding laat zien dat het behoorlijk populair is in de Python-community en tabulaire competities op Kaggle domineert.
LightGBM & CatBoost
Twee vergelijkbare libraries zijn LightGBM en CatBoost. Terwijl LightGBM aanzienlijk minder geheugen nodig heeft dan XGBoost, biedt CatBoost voordelen in snelheid en nauwkeurigheid. Alle drie de gradient-boosted libraries kunnen de Scikit-learn-API implementeren, waardoor ze heel eenvoudig te gebruiken zijn.
Voorbij de taalstrijd: R en Python voor de moderne data scientist
Hoewel R en Python elk hun eigen sterke punten hebben, is het framen als een “taaloorlog” contraproductief voor data scientists. In hun recente optreden in de DataFramed-podcast vertellen de auteurs van "Python and R for the Modern Data Scientist", Rick Scavetta en Boyan Angelov, over de voordelen van een tweetalige data scientist en hoe moderne datateams profiteren van tweetalige professionals.
Door de hele podcast heen bespreken ze hoe een belangrijk nadeel van de taalstrijd het ontstaan van monocultuurdenken binnen de R- en Python-gemeenschappen is. Een van de beste tegenargumenten tegen monocultuur of de "wij versus zij"-mentaliteit is de metafoor van de hamer en de spijker — als je alleen een hamer hebt, lijkt alles op een spijker.
Met andere woorden: de taal-eerstbenadering beperkt je creativiteit en je vermogen om problemen effectief op te lossen. Door een oplossing-eerstbenadering te hanteren, bekijk je de oplossing van je probleem in termen van concepten in plaats van je vast te houden aan wat rigide binnen één taal wordt geboden.
Als je zowel R als Python kent, kun je het beste van beide werelden doelgericht inzetten in contexten waar de één superieur is aan de ander. Zo geven de auteurs aan dat R uitblinkt in datavisualisatie met ggplot2 en hoe volwassen het rapportage-ecosysteem is dankzij R Markdown en Shiny, terwijl ze benadrukken dat Python excelleert in machine learning, API’s en MLOps.
De auteurs schetsen in het boek een sterk casestudy die laat zien hoe je beide talen met elkaar kunt laten communiceren. Met tools zoals reticulate in RStudio kun je Python-scripts aanroepen en Python-packages binnen R draaien, waardoor je objecten vrij tussen de talen kunt uitwisselen.
Als je R-gebruiker bent, is het nog nooit zo eenvoudig geweest om een tweetalige data scientist te worden. Voor meer over het leren van Python bekijk je onze uitgebreide verzameling resources.