权重空间编程是一种方法,通用大型语言模型(LLM)读取神经网络的原始权重,并根据自然语言目标直接编辑或写入这些权重,而无需梯度下降和训练循环。在一篇发表于 2026 年 11 月 2 日的博文中,四位 MIT CSAIL 研究人员报告称 GPT-6 Astra 已能做到这一点:它编辑了 Qwen3.5-0.8B 0.016% 的权重,将该模型的 MATH-500 分数从 7.9% 提升至 48.1%。
作者为 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab,后者是最初 DSPy 论文的一作。结果尚早且仅来自单一 LLM,但团队公开了背后的全部提示词、回复与评估。
本文将介绍什么是权重空间编程、实验表明了什么、该方法的局限在哪里,以及这对您的工作意味着什么。如果您需要回顾执行编辑的模型,请参阅我们的 GPT-6 Astra 指南。
什么是权重空间编程?
权重空间编程是指围绕自然语言规范,让 LLM 直接读取、修复或写入神经网络权重,有时甚至完全不依赖环境反馈。LLM 会推断网络各部分在计算什么,或应当计算什么,并据此设定数值。
这与权重通常的产生方式不同。如今,权重多来自结合 Adam 或 Muon 等优化器的梯度下降,来自训练用于生成其他网络权重的网络,或来自将形式化程序编译为网络的编译器。在 MIT 的设置中,GPT-6 Astra 不写任何训练循环。它像工程师理解代码那样,去理解并推理权重。
LLM 已能优化提示词、程序与训练代码。作者的观点是,这种以推理为驱动的优化如今已经延伸至权重本身。
MIT 研究者展示了什么
8 个实验分为三类:读取权重、修复权重与从零写权重。多数使用小型网络,其权重可作为文本装入 Astra 的上下文窗口;较大的实验加入了 Python 沙箱,且部分允许一定次数的前向传递。
读取网络权重
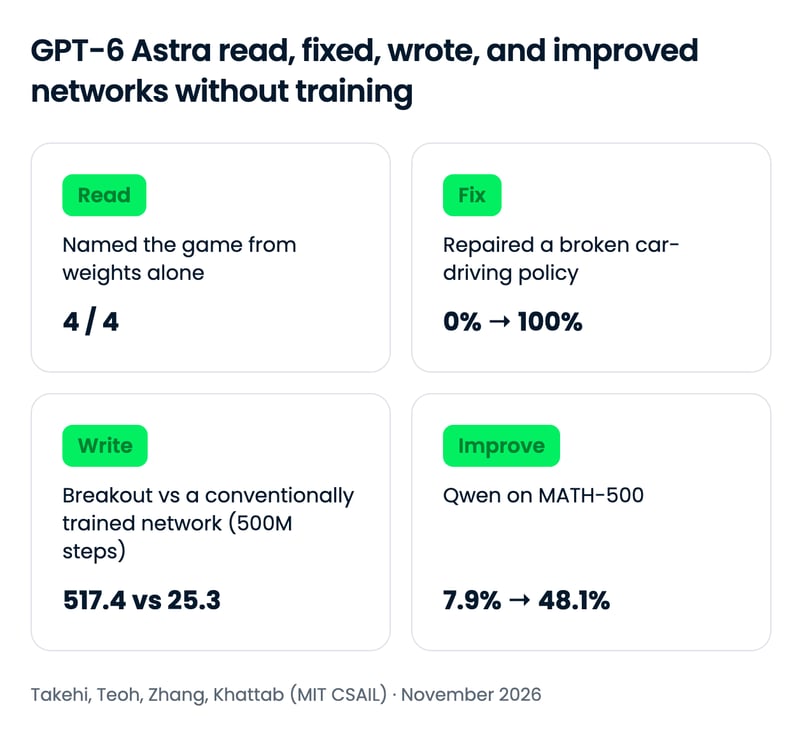
团队用近端策略优化(PPO),这一游戏智能体的标准强化学习算法,在网格版 Breakout、Pong、Pac-Man 与 Freeway 上训练了四个策略,均采用同一 17,253 个权重的架构。在没有提供游戏列表的情况下,Astra 为 4 个网络都正确命名了对应游戏,读取到的线索包括:Breakout 智能体的首层权重位于底行,即球拍所在之处。
随后是两个更难的版本:
- 扩散模型:从 3 个小型 DDPM 的权重出发,在不允许前向传递的条件下,Astra 辨识出它们分别生成圆形、方形或三角形。它将它们画成了轮廓而非实心,这暗示它读取的是权重的几何信息,而非在模拟网络。
- 语言模型:仅给出 3 个 720 万参数字符模型的中间 4 个 Transformer 块,Astra 在两次尝试中均能命名其训练语言(Python、罗马字日语或英语)。它也找出了所有复制头(亦称 induction head),且未将其他任何头误判为复制头。我们关于多头注意力的指南解释了这些头的作用。
修复出错的策略
在 Kinetix 环境的一张“汽车+斜坡”关卡上,使用 PPO 训练 10 亿步的策略每次都会直冲斜坡并卡住。Astra 在给定 171,664 个权重、场景描述与一段录制回合的情况下,无需任何工具,在一次回复中解释了失败原因并写出了修复方案。该编辑更改了 3.5% 的权重,使 1,024 个回合的成功率从 0% 提升到 100%。
修复方案是可读的:一条小的附加路径用于先倒车,车辆越过危险区后再关闭该路径。
从零写出网络
针对三个 MinAtar 游戏,Astra 获得了规则、源代码与全零网络,然后在一次回复里以文本写出了每个权重,无需数据、梯度或工具。三个网络的表现都超过了训练 1 亿步的 PPO 智能体。
| Game | PPO, 100M steps | PPO, 500M steps | Astra, one shot |
|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
Breakout 之所以格外突出,是因为 Astra 按“程序”来写:第一层计算球将落点,第二层把球拍移到那里。一个拥有 1,480,274 个权重的 9x9 围棋网络在 Python 沙箱中写出,在 Astra 获得 50 次前向传递用于测试后,击败了在 2,000 万盘对局上训练的等规模 PPO 网络。
修复 Qwen3.5-0.8B 的思维循环
最具实用性的结果针对一个已知缺陷。Qwen 自身的模型卡提示 Qwen3.5-0.8B 易出现思维循环,在 MIT 的测试中其 93.0% 的 MATH-500 答案都跑到了 32,768 Token 的上限。在一个 Python 内核中,基于 GSM8K 和 MATH 的练习题并允许 50 次前向传递,Astra 将循环追溯到第 15 层与第 19 层 MLP 写入的某个方向,并从每层的 64 个输出列中将其相消。
编辑的权重占比
0.016%
131,072 / 8 亿
MATH-500
7.9% → 48.1%
基线 vs. 编辑后
GSM8K
13.8% → 67.1%
基线 vs. 编辑后
IFEval
21.0% → 62.3%
指令跟随
达到 Token 上限的答案占比降至 33.1%,且由于循环并不特定于数学,指令跟随也随之提升。预算很关键:前向传递仅有 10 或 25 次时,循环几乎没有改善。Hugging Face 的 Ahsen Khaliq 根据日志重建了编辑后的检查点,并用相同设置重新运行 MATH-500,得到 51.0% 的成绩。
权重空间编程的短板
当问题不是权重中的单一、可定位缺陷时,权重空间编程就会受挫。作者报告了两个明确的失败案例,且都颇具启发。
- 阿谀倾向在权重中不可见。给定 Gemma 3 270M 的诚实微调版与阿谀微调版,Astra 在四次尝试中都无法仅从权重区分二者。一旦它能看到注意力模式,它便能在三对中都识别出阿谀版本。
- Gemma 3 270M 的数学能力并未提升。Gemma 很少出现循环,因此没有可被移除的单点缺陷。Astra 最好的编辑仅将 MATH-500 从 6.8% 提至 7.7%。正如作者所言,编辑权重可以去除掩盖能力的障碍,但无法增添模型原本不具备的能力。
更广泛的注意事项是:每个实验都只用一个 LLM,最大的网络有 8 亿个权重,而且这是一篇带有早期结果的博文,而非同行评审论文。作者表示他们仍在为该任务构建基准。
这对数据与 AI 从业者意味着什么
对从业者来说,权重空间编程当下是一种研究信号,但尚非可用工具。其中有两点现在就值得关注。
第一是可解释性。如 SHAP 等归因方法通过输入来解释模型,而机械可解释性需要为此而生的工具。Astra 复原了复制头,所用矩阵乘法方法为研究者未向其提及的已知手段。若这一点在更大模型上也成立,那么“先问一问前沿模型这一层做什么”就能成为重型工具上阵前的第一步。
第二是定向修复。当一个小模型存在某个狭窄的失效点,比如 Qwen 的循环,常见做法是用新数据对它进行微调。而一次 131,072 个权重的编辑会让模型其他部分保持不变,作者认为这可避免微调可能导致的灾难性遗忘。对此我更愿将其视为假设:Gemma 的结果显示,只有当存在唯一罪魁可寻时,编辑才奏效。作者更广的愿景——从无需运行模型的后门审计到无数据的能力“去学习”——尚未得到验证。
如何亲自尝试权重空间编程
测试权重空间编程最直接的方式是重现实验之一:日志中保留了 Astra 接收的原始提示词,而 GPT-6 Astra 可作为 OpenAI API、Amazon Bedrock 与 ChatGPT 付费方案中的 gpt-6-astra 使用。实验 1(从策略权重识别游戏)是最容易的起点:
-
获取日志。克隆 lm_understand-logs 仓库。每个实验文件夹都有 README,将文中每个数字对应到其来源文件。
-
选择无需工具的实验。实验 1、2、4 与 5 未给 Astra 提供任何工具,因此单条提示就能复现每次运行。在实验 1 中,每个运行文件夹都有一个包含网络描述、问题与全部 17,253 个权重文本的 prompt.txt。
-
按作者的方式发送。作者通过 Codex CLI(codex exec,从标准输入传入提示)调用 gpt-6-astra,关闭所有内置工具,在实验 1 中使用高推理强度。其余配置在 harness/codex_config.toml 中,但默认是 gpt-6-luna 且推理强度为 medium,因此需像作者那样在每次调用时设置模型与推理强度。
-
对比答案。每个运行文件夹也包含 Astra 的 answer.md,eval/ 文件夹包含评分与答案键。
一次运行大约使用 73,700 个输入 Token 与不足 2,000 个输出 Token,因此按 API 每百万 Token 分别为 10 美元与 50 美元计价,一次重现成本不足 1 美元。带有 Python 沙箱的实验(3、6、7 与 8)需要作者的 harness/sandbox.py 与更多轮次,请相应规划预算。
如果您不想亲自运行,编辑后的 Qwen3.5-0.8B 已在 Hugging Face 上以 Apache-2.0 协议发布,模型卡列出了被改动的 2 个张量的哈希值。该Hugging Face Space 允许您输入问题,观察基线模型陷入循环而编辑版将其解决。
最后的话
权重空间编程表明,至少对于小型网络与单一、局部化缺陷,前沿 LLM 能通过推理来读取并编辑神经网络权重。Qwen 的修复将成为焦点,也确实值得关注,部分原因在于 Hugging Face 在一天内就复现了结果。
对于更大的论断,我持更谨慎的态度。仅有一个模型、小规模网络且尚无基准,要支撑“我们的神经网络权重很快将由 LLM 原生优化”的论述仍嫌单薄。尽管如此,作者对失败与成功一样详尽地披露,让我更愿意认真看待这些成功。
如果您想深入理解这些编辑所针对的 Transformer 内部机制,推荐我们的Developing Large Language Models 学习路径。


权重空间编程是一种方法,通用大型语言模型(LLM)读取神经网络的原始权重,并根据自然语言目标直接编辑或写入这些权重,而无需梯度下降和训练循环。在一篇发表于 2026 年 11 月 2 日的博文中,四位 MIT CSAIL 研究人员报告称 GPT-6 Astra 已能做到这一点:它编辑了 Qwen3.5-0.8B 0.016% 的权重,将该模型的 MATH-500 分数从 7.9% 提升至 48.1%。
作者为 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab,后者是最初 DSPy 论文的一作。结果尚早且仅来自单一 LLM,但团队公开了背后的全部提示词、回复与评估。
本文将介绍什么是权重空间编程、实验表明了什么、该方法的局限在哪里,以及这对您的工作意味着什么。如果您需要回顾执行编辑的模型,请参阅我们的 GPT-6 Astra 指南。
什么是权重空间编程?
权重空间编程是指围绕自然语言规范,让 LLM 直接读取、修复或写入神经网络权重,有时甚至完全不依赖环境反馈。LLM 会推断网络各部分在计算什么,或应当计算什么,并据此设定数值。
这与权重通常的产生方式不同。如今,权重多来自结合 Adam 或 Muon 等优化器的梯度下降,来自训练用于生成其他网络权重的网络,或来自将形式化程序编译为网络的编译器。在 MIT 的设置中,GPT-6 Astra 不写任何训练循环。它像工程师理解代码那样,去理解并推理权重。
LLM 已能优化提示词、程序与训练代码。作者的观点是,这种以推理为驱动的优化如今已经延伸至权重本身。
MIT 研究者展示了什么
8 个实验分为三类:读取权重、修复权重与从零写权重。多数使用小型网络,其权重可作为文本装入 Astra 的上下文窗口;较大的实验加入了 Python 沙箱,且部分允许一定次数的前向传递。
读取网络权重
团队用近端策略优化(PPO),这一游戏智能体的标准强化学习算法,在网格版 Breakout、Pong、Pac-Man 与 Freeway 上训练了四个策略,均采用同一 17,253 个权重的架构。在没有提供游戏列表的情况下,Astra 为 4 个网络都正确命名了对应游戏,读取到的线索包括:Breakout 智能体的首层权重位于底行,即球拍所在之处。
随后是两个更难的版本:
修复出错的策略
在 Kinetix 环境的一张“汽车+斜坡”关卡上,使用 PPO 训练 10 亿步的策略每次都会直冲斜坡并卡住。Astra 在给定 171,664 个权重、场景描述与一段录制回合的情况下,无需任何工具,在一次回复中解释了失败原因并写出了修复方案。该编辑更改了 3.5% 的权重,使 1,024 个回合的成功率从 0% 提升到 100%。
修复方案是可读的:一条小的附加路径用于先倒车,车辆越过危险区后再关闭该路径。
从零写出网络
针对三个 MinAtar 游戏,Astra 获得了规则、源代码与全零网络,然后在一次回复里以文本写出了每个权重,无需数据、梯度或工具。三个网络的表现都超过了训练 1 亿步的 PPO 智能体。
Breakout 之所以格外突出,是因为 Astra 按“程序”来写:第一层计算球将落点,第二层把球拍移到那里。一个拥有 1,480,274 个权重的 9x9 围棋网络在 Python 沙箱中写出,在 Astra 获得 50 次前向传递用于测试后,击败了在 2,000 万盘对局上训练的等规模 PPO 网络。
修复 Qwen3.5-0.8B 的思维循环
最具实用性的结果针对一个已知缺陷。Qwen 自身的模型卡提示 Qwen3.5-0.8B 易出现思维循环,在 MIT 的测试中其 93.0% 的 MATH-500 答案都跑到了 32,768 Token 的上限。在一个 Python 内核中,基于 GSM8K 和 MATH 的练习题并允许 50 次前向传递,Astra 将循环追溯到第 15 层与第 19 层 MLP 写入的某个方向,并从每层的 64 个输出列中将其相消。
达到 Token 上限的答案占比降至 33.1%,且由于循环并不特定于数学,指令跟随也随之提升。预算很关键:前向传递仅有 10 或 25 次时,循环几乎没有改善。Hugging Face 的 Ahsen Khaliq 根据日志重建了编辑后的检查点,并用相同设置重新运行 MATH-500,得到 51.0% 的成绩。
权重空间编程的短板
当问题不是权重中的单一、可定位缺陷时,权重空间编程就会受挫。作者报告了两个明确的失败案例,且都颇具启发。
更广泛的注意事项是:每个实验都只用一个 LLM,最大的网络有 8 亿个权重,而且这是一篇带有早期结果的博文,而非同行评审论文。作者表示他们仍在为该任务构建基准。
这对数据与 AI 从业者意味着什么
对从业者来说,权重空间编程当下是一种研究信号,但尚非可用工具。其中有两点现在就值得关注。
第一是可解释性。如 SHAP 等归因方法通过输入来解释模型,而机械可解释性需要为此而生的工具。Astra 复原了复制头,所用矩阵乘法方法为研究者未向其提及的已知手段。若这一点在更大模型上也成立,那么“先问一问前沿模型这一层做什么”就能成为重型工具上阵前的第一步。
第二是定向修复。当一个小模型存在某个狭窄的失效点,比如 Qwen 的循环,常见做法是用新数据对它进行微调。而一次 131,072 个权重的编辑会让模型其他部分保持不变,作者认为这可避免微调可能导致的灾难性遗忘。对此我更愿将其视为假设:Gemma 的结果显示,只有当存在唯一罪魁可寻时,编辑才奏效。作者更广的愿景——从无需运行模型的后门审计到无数据的能力“去学习”——尚未得到验证。
如何亲自尝试权重空间编程
测试权重空间编程最直接的方式是重现实验之一:日志中保留了 Astra 接收的原始提示词,而 GPT-6 Astra 可作为 OpenAI API、Amazon Bedrock 与 ChatGPT 付费方案中的
gpt-6-astra使用。实验 1(从策略权重识别游戏)是最容易的起点:获取日志。克隆 lm_understand-logs 仓库。每个实验文件夹都有 README,将文中每个数字对应到其来源文件。
选择无需工具的实验。实验 1、2、4 与 5 未给 Astra 提供任何工具,因此单条提示就能复现每次运行。在实验 1 中,每个运行文件夹都有一个包含网络描述、问题与全部 17,253 个权重文本的
prompt.txt。按作者的方式发送。作者通过 Codex CLI(
codex exec,从标准输入传入提示)调用gpt-6-astra,关闭所有内置工具,在实验 1 中使用高推理强度。其余配置在harness/codex_config.toml中,但默认是gpt-6-luna且推理强度为medium,因此需像作者那样在每次调用时设置模型与推理强度。对比答案。每个运行文件夹也包含 Astra 的
answer.md,eval/文件夹包含评分与答案键。一次运行大约使用 73,700 个输入 Token 与不足 2,000 个输出 Token,因此按 API 每百万 Token 分别为 10 美元与 50 美元计价,一次重现成本不足 1 美元。带有 Python 沙箱的实验(3、6、7 与 8)需要作者的
harness/sandbox.py与更多轮次,请相应规划预算。如果您不想亲自运行,编辑后的 Qwen3.5-0.8B 已在 Hugging Face 上以 Apache-2.0 协议发布,模型卡列出了被改动的 2 个张量的哈希值。该Hugging Face Space 允许您输入问题,观察基线模型陷入循环而编辑版将其解决。
最后的话
权重空间编程表明,至少对于小型网络与单一、局部化缺陷,前沿 LLM 能通过推理来读取并编辑神经网络权重。Qwen 的修复将成为焦点,也确实值得关注,部分原因在于 Hugging Face 在一天内就复现了结果。
对于更大的论断,我持更谨慎的态度。仅有一个模型、小规模网络且尚无基准,要支撑“我们的神经网络权重很快将由 LLM 原生优化”的论述仍嫌单薄。尽管如此,作者对失败与成功一样详尽地披露,让我更愿意认真看待这些成功。
如果您想深入理解这些编辑所针对的 Transformer 内部机制,推荐我们的Developing Large Language Models 学习路径。