

1. 环境搭建
在实现 PPO 之前,我们需要安装前置软件库,并选择一个合适的环境来应用该策略。
安装 PyTorch 和所需库
需要安装以下软件:
- PyTorch 及其他软件库,如
numpy(用于数学与统计函数)和matplotlib(用于绘图)。 - OpenAI 的开源 Gym 软件包,这是一个 Python 库,可模拟不同的环境和游戏,供强化学习求解。您可以使用 Gym API 让算法与环境交互。由于
gym的功能在升级过程中有时会发生变化,在本示例中,我们将其版本固定为0.25.2。
在服务器或本地机器上安装,运行:
$ pip install torch numpy matplotlib gym==0.25.2在如 Google Colab 或b DataLab 的 Notebook 中安装,使用:
!pip install torch numpy matplotlib gym==0.25.2创建 CartPole 环境
使用 OpenAI Gym 创建两个 CartPole 环境实例(一个用于训练,另一个用于测试):
env_train = gym.make('CartPole-v1')
env_test = gym.make('CartPole-v1')2. 在 PyTorch 中实现 PPO
现在,让我们用 PyTorch 实现 PPO。
定义策略网络
如前所述,PPO 采用演员-评论家模型实现。Actor 实现策略并预测动作,Critic 预测其估计价值。二者的神经网络接受相同的输入——每个时间步的状态。因此,actor 与 critic 可以共享一个通用神经网络,称为骨干网络(backbone)。actor 和 critic 可以在骨干网络基础上扩展额外层。
定义骨干网络
以下步骤描述了骨干网络:
- 实现一个包含 3 层的网络——输入层、隐藏层和输出层。
- 在输入层与隐藏层之后使用激活函数。本教程选用 ReLU,因为其计算高效。
- 在输入层与隐藏层之后加入 dropout 函数以获得更稳健的网络。dropout 会随机将部分神经元置零,降低对特定神经元的依赖并防止过拟合,从而增强网络的鲁棒性。
下面的代码实现了骨干网络:
class BackboneNetwork(nn.Module):
def __init__(self, in_features, hidden_dimensions, out_features, dropout):
super().__init__()
self.layer1 = nn.Linear(in_features, hidden_dimensions)
self.layer2 = nn.Linear(hidden_dimensions, hidden_dimensions)
self.layer3 = nn.Linear(hidden_dimensions, out_features)
self.dropout = nn.Dropout(dropout)
def forward(self, x):
x = self.layer1(x)
x = f.relu(x)
x = self.dropout(x)
x = self.layer2(x)
x = f.relu(x)
x = self.dropout(x)
x = self.layer3(x)
return x定义演员-评论家网络
现在,我们可以使用该网络定义演员-评论家类 ActorCritic。Actor 建模策略并预测动作,Critic 建模价值函数并预测价值。它们都以状态为输入。
class ActorCritic(nn.Module):
def __init__(self, actor, critic):
super().__init__()
self.actor = actor
self.critic = critic
def forward(self, state):
action_pred = self.actor(state)
value_pred = self.critic(state)
return action_pred, value_pred实例化 actor 和 critic 网络
我们将使用上述网络创建一个 actor 和一个 critic。随后,我们将创建一个包含 actor 与 critic 的智能体。
在创建智能体之前,先初始化网络的参数:
- 隐藏层维度 H,这是一个可配置参数。隐藏层的大小与层数取决于问题复杂度。我们将使用一个 64 × 64 的隐藏层。
- 输入特征 N,其中 N 为状态数组的大小。输入层的维度为 N × H。在 CartPole 环境中,状态是一个 4 元素数组,因此 N 为 4。
- actor 网络的输出特征 O,O 为环境中的动作数量。actor 的输出层维度为 H × O。CartPole 环境有 2 个动作。
- critic 网络的输出特征。由于 critic 仅预测期望价值(给定一个输入状态),输出特征数量为 1。
- Dropout 比例。
下面的代码展示了如何基于骨干网络声明 actor 和 critic 网络:
def create_agent(hidden_dimensions, dropout):
INPUT_FEATURES = env_train.observation_space.shape[0]
HIDDEN_DIMENSIONS = hidden_dimensions
ACTOR_OUTPUT_FEATURES = env_train.action_space.n
CRITIC_OUTPUT_FEATURES = 1
DROPOUT = dropout
actor = BackboneNetwork(
INPUT_FEATURES, HIDDEN_DIMENSIONS, ACTOR_OUTPUT_FEATURES, DROPOUT)
critic = BackboneNetwork(
INPUT_FEATURES, HIDDEN_DIMENSIONS, CRITIC_OUTPUT_FEATURES, DROPOUT)
agent = ActorCritic(actor, critic)
return agent计算回报
环境会根据智能体每一步的动作给出奖励 R,表示为:
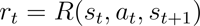
回报被定义为对未来期望奖励的累计。时间步更远的未来奖励不如即时奖励有价值。因此,回报通常计算为折扣回报 G,定义为:
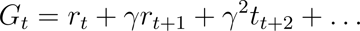
在本教程(以及许多其他参考资料)中,回报指的就是折扣回报。
计算回报的步骤:
- 从所有未来状态的期望奖励开始。
- 将每个未来奖励乘以折扣因子的幂。例如,2 个时间步后的期望奖励乘以 2 次幂。
- 将所有折扣后的未来奖励相加,得到回报。
- 对回报进行归一化。
函数 calculate_returns() 完成上述计算,如下所示:
def calculate_returns(rewards, discount_factor):
returns = []
cumulative_reward = 0
for r in reversed(rewards):
cumulative_reward = r + cumulative_reward * discount_factor
returns.insert(0, cumulative_reward)
returns = torch.tensor(returns)
# normalize the return
returns = (returns - returns.mean()) / returns.std()
return returns实现优势函数
优势等于评论家预测价值与 actor 根据策略选择动作后得到的期望回报之间的差异。对于给定动作,优势表达了采取该特定动作相对于任意(平均)动作的收益。
在原始 PPO 论文(公式 10)中,优势在向前看至时间步 T 的表达为:
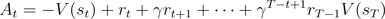
在编码实现时,通过批大小来约束“向前看固定步数”。因此,上式可简化为价值与期望回报之间的差异。期望回报由状态-动作价值函数 Q 来量化。
因此,下面的简化公式表达了在:
- 特定动作
- 给定状态
- 特定策略
- 特定时间步
下的优势,表示为:

OpenAI 也使用此公式实现 RL。下面的 calculate_advantages() 函数计算优势:
def calculate_advantages(returns, values):
advantages = returns - values
# Normalize the advantage
advantages = (advantages - advantages.mean()) / advantages.std()
return advantages代理损失与裁剪机制
若不使用 PPO 等特殊技巧,策略损失即为标准的策略梯度损失。标准策略梯度损失计算为以下两者的乘积:
- 策略的动作概率
- 优势函数,计算为以下差值:
- 策略的回报
- 期望价值
标准策略梯度损失无法对突发的策略变化进行修正。代理损失对标准损失进行修饰,以限制每次迭代策略变化的幅度。它取两者中的最小值:
- 以下两者的乘积:
- 策略比率。该比率表示新旧动作概率之间的差异。
- 优势函数
- 以下两者的乘积:
- 策略比率的截断(裁剪)值。该比率被裁剪,使得更新后的策略与旧策略的差异在一定百分比范围内。
- 优势函数
在优化过程中,代理损失被用作实际损失的替代。
裁剪机制
策略比率 R 是新策略与旧策略之间的差异,给出为在新旧参数下策略对数概率之比:
裁剪后的策略比率 R' 被约束为:
给定上一节中的优势 At 以及上述策略比率,代理损失计算为:
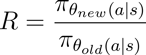
下面的代码展示如何实现裁剪机制与代理损失。
def calculate_surrogate_loss(
actions_log_probability_old,
actions_log_probability_new,
epsilon,
advantages):
advantages = advantages.detach()
policy_ratio = (
actions_log_probability_new - actions_log_probability_old
).exp()
surrogate_loss_1 = policy_ratio * advantages
surrogate_loss_2 = torch.clamp(
policy_ratio, min=1.0-epsilon, max=1.0+epsilon
) * advantages
surrogate_loss = torch.min(surrogate_loss_1, surrogate_loss_2)
return surrogate_loss3. 训练智能体
现在,让我们训练智能体。
计算策略损失与价值损失
我们现在可以计算策略与价值损失:
- 策略损失等于代理损失与熵奖励之和。
- 价值损失基于评论家预测的价值与策略产生的回报(累计奖励)之间的差异。价值损失计算使用Smooth L1 Loss 函数。这有助于平滑损失函数,使其对离群值不那么敏感。
上述两个损失都是张量。梯度下降基于标量值。要得到表示损失的单个标量值,请使用 .sum() 对张量元素求和。下面的函数展示了如何实现:
def calculate_losses(
surrogate_loss, entropy, entropy_coefficient, returns, value_pred):
entropy_bonus = entropy_coefficient * entropy
policy_loss = -(surrogate_loss + entropy_bonus).sum()
value_loss = f.smooth_l1_loss(returns, value_pred).sum()
return policy_loss, value_loss定义训练循环
在开始训练之前,将一组缓冲区初始化为空数组。训练算法将使用这些缓冲区存储每个时间步中智能体的动作、环境状态和奖励。下面的函数初始化这些缓冲区:
def init_training():
states = []
actions = []
actions_log_probability = []
values = []
rewards = []
done = False
episode_reward = 0
return states, actions, actions_log_probability, values, rewards, done, episode_reward每次训练迭代都用该迭代的策略参数运行智能体。智能体以时间步循环与环境交互,直到达到终止条件。
每个时间步之后,将智能体的动作、奖励与价值追加到各自的缓冲区中。当该回合结束时,函数返回更新后的缓冲区集合,概括该回合的结果。
在运行训练循环之前:
- 使用
agent.train()将模型设置为训练模式。 - 使用
env.reset()将环境重置为随机状态。这是本次训练迭代的起始状态。
训练循环中每个时间步发生的步骤如下:
- 将状态传给智能体。
- 智能体返回:
- 基于策略(actor)的、给定状态下的预测动作。将该预测动作张量通过 softmax 得到一组动作概率。
- 基于 critic 的状态预测价值。
- 智能体选择要执行的动作:
- 使用动作概率估计概率分布。
- 通过从该分布中采样随机选择一个动作。
dist.sample()函数实现此操作。 - 使用
env.step()将该动作传给环境,模拟该时间步的环境响应。基于智能体的动作,环境会生成: - 新的状态
- 奖励
- 布尔返回值
done(指示环境是否达到终止状态) - 将智能体的动作、奖励、预测价值与新状态的值追加到各自的缓冲区。
当 env.step() 返回的布尔值 done 为 true 时,训练回合结束。
回合结束后,使用每个时间步的累计值来计算该回合的累计回报,即对每个时间步的奖励求和。我们使用前文的 calculate_returns() 函数完成此操作。该函数的输入是折扣因子与每个时间步奖励的缓冲区。随后,我们使用这些回报与各时间步的累计值,通过 calculate_advantages() 函数计算优势。
下面的 Python 函数展示了如何实现这些步骤:
def forward_pass(env, agent, optimizer, discount_factor):
states, actions, actions_log_probability, values, rewards, done, episode_reward = init_training()
state = env.reset()
agent.train()
while not done:
state = torch.FloatTensor(state).unsqueeze(0)
states.append(state)
action_pred, value_pred = agent(state)
action_prob = f.softmax(action_pred, dim=-1)
dist = distributions.Categorical(action_prob)
action = dist.sample()
log_prob_action = dist.log_prob(action)
state, reward, done, _ = env.step(action.item())
actions.append(action)
actions_log_probability.append(log_prob_action)
values.append(value_pred)
rewards.append(reward)
episode_reward += reward
states = torch.cat(states)
actions = torch.cat(actions)
actions_log_probability = torch.cat(actions_log_probability)
values = torch.cat(values).squeeze(-1)
returns = calculate_returns(rewards, discount_factor)
advantages = calculate_advantages(returns, values)
return episode_reward, states, actions, actions_log_probability, advantages, returns更新模型参数
每次训练迭代会运行一个包含多个时间步的完整回合(直到达到终止条件)。在每个时间步,我们会存储策略参数、智能体的动作、回报与优势。每次迭代结束后,我们根据该迭代所有时间步中的策略表现来更新模型。
CartPole 环境的最大时间步数为 500。在更复杂的环境中,时间步数会更多,甚至数百万。在这种情况下,训练结果数据集必须拆分为批次。每个批次中的时间步数量称为优化批大小。
因此,更新模型参数的步骤为:
- 将训练结果数据集拆分为批次。
- 对于每个批次:
- 获取每个状态下智能体的动作与预测价值。
- 使用这些预测动作估计新的动作概率分布。
- 使用该分布计算熵。
- 使用该分布获取训练结果数据集中各动作的对数概率。这是训练结果数据集中这些动作的新对数概率集合。旧的对数概率集合已在上一节的训练循环中计算。
- 使用动作新旧概率分布计算代理损失。
- 使用代理损失、熵与优势计算策略损失与价值损失。
- 分别对策略损失与价值损失运行
.backward()。这会更新损失函数的梯度。 - 在优化器上运行
.step()更新策略参数。本例中使用 Adam 优化器以平衡速度与稳健性。 - 累计策略与价值损失。
- 根据参数
PPO_STEPS的取值,对每个批次重复若干次反向传播(上述操作)。对每个批次重复反向传播在计算上是高效的,因为它有效增大了训练数据集的规模,而无需运行额外的前向传播。每次采样与优化之间交替的环境步数称为迭代批大小。 - 返回平均策略损失与价值损失。
下面的代码实现了这些步骤:
def update_policy(
agent,
states,
actions,
actions_log_probability_old,
advantages,
returns,
optimizer,
ppo_steps,
epsilon,
entropy_coefficient):
BATCH_SIZE = 128
total_policy_loss = 0
total_value_loss = 0
actions_log_probability_old = actions_log_probability_old.detach()
actions = actions.detach()
training_results_dataset = TensorDataset(
states,
actions,
actions_log_probability_old,
advantages,
returns)
batch_dataset = DataLoader(
training_results_dataset,
batch_size=BATCH_SIZE,
shuffle=False)
for _ in range(ppo_steps):
for batch_idx, (states, actions, actions_log_probability_old, advantages, returns) in enumerate(batch_dataset):
# get new log prob of actions for all input states
action_pred, value_pred = agent(states)
value_pred = value_pred.squeeze(-1)
action_prob = f.softmax(action_pred, dim=-1)
probability_distribution_new = distributions.Categorical(
action_prob)
entropy = probability_distribution_new.entropy()
# estimate new log probabilities using old actions
actions_log_probability_new = probability_distribution_new.log_prob(actions)
surrogate_loss = calculate_surrogate_loss(
actions_log_probability_old,
actions_log_probability_new,
epsilon,
advantages)
policy_loss, value_loss = calculate_losses(
surrogate_loss,
entropy,
entropy_coefficient,
returns,
value_pred)
optimizer.zero_grad()
policy_loss.backward()
value_loss.backward()
optimizer.step()
total_policy_loss += policy_loss.item()
total_value_loss += value_loss.item()
return total_policy_loss / ppo_steps, total_value_loss / ppo_steps4. 运行 PPO 智能体
现在终于可以运行 PPO 智能体了。
评估性能
要评估智能体的性能,请创建一个全新的环境,并计算智能体在该新环境中运行得到的累计奖励。您需要使用 .eval() 将智能体设置为评估模式。步骤与训练循环相同。下面的代码片段实现了评估函数:
def evaluate(env, agent):
agent.eval()
rewards = []
done = False
episode_reward = 0
state = env.reset()
while not done:
state = torch.FloatTensor(state).unsqueeze(0)
with torch.no_grad():
action_pred, _ = agent(state)
action_prob = f.softmax(action_pred, dim=-1)
action = torch.argmax(action_prob, dim=-1)
state, reward, done, _ = env.step(action.item())
episode_reward += reward
return episode_reward可视化训练结果
我们将使用 Matplotlib 库来可视化训练过程的进展。下面的函数展示了如何绘制训练与测试循环的奖励:
def plot_train_rewards(train_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(train_rewards, label='Training Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Training Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(train_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()def plot_test_rewards(test_rewards, reward_threshold):
plt.figure(figsize=(12, 8))
plt.plot(test_rewards, label='Testing Reward')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Testing Reward', fontsize=20)
plt.hlines(reward_threshold, 0, len(test_rewards), color='y')
plt.legend(loc='lower right')
plt.grid()
plt.show()在下面的示例图中,我们展示了在训练与测试环境中应用策略所获得的训练与测试奖励。请注意,每次运行代码时,图形的形状都会不同。这是由于训练过程本身具有随机性。
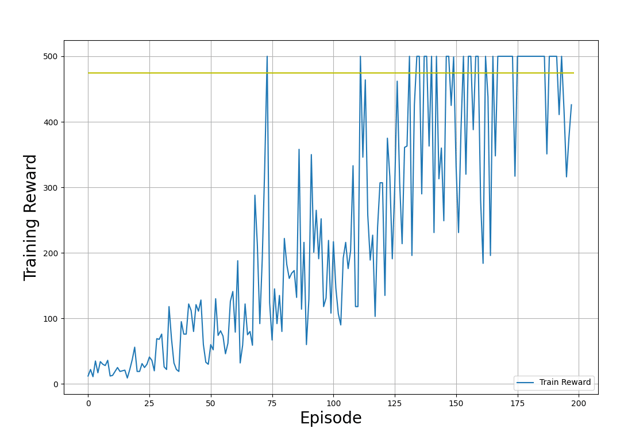
训练奖励(在训练环境中应用策略获得)。作者供图。
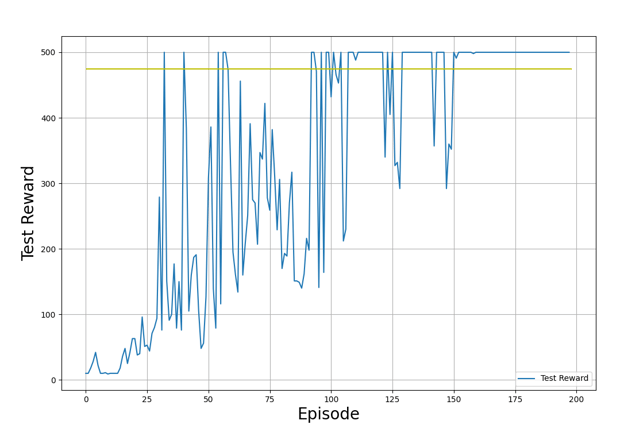
测试奖励(在测试环境中应用策略获得)。作者供图。
在上述输出图中,观察训练过程的进展:
- 奖励从较低值开始。随着训练推进,奖励逐步增加。
- 奖励在上升过程中随机波动。这是由于智能体在探索策略空间。
- 训练结束后,测试奖励在多个迭代中稳定在阈值(475)附近。
- 奖励上限为 500,这是环境(Gym CartPole v1)施加的限制。
类似地,您可以绘制各迭代中的价值与策略损失:
def plot_losses(policy_losses, value_losses):
plt.figure(figsize=(12, 8))
plt.plot(value_losses, label='Value Losses')
plt.plot(policy_losses, label='Policy Losses')
plt.xlabel('Episode', fontsize=20)
plt.ylabel('Loss', fontsize=20)
plt.legend(loc='lower right')
plt.grid()
plt.show()下面的示例图展示了训练回合中的损失变化:
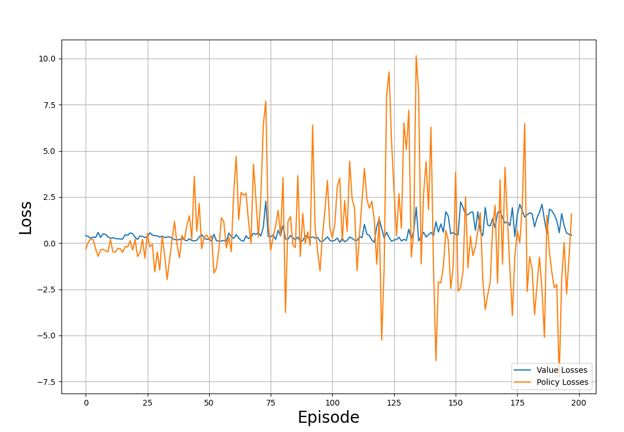
训练过程中价值与策略损失。作者供图
观察该图可以注意到:
- 损失看起来随机分布,并不遵循某种模式。
- 这在 RL 训练中很常见,其目标并非最小化损失,而是最大化奖励。
运行 PPO 算法
您现在已拥有使用 PPO 训练智能体的所有组件。要将其整合起来,您需要:
- 声明超参数,如折扣因子、批大小、学习率等。
- 实例化缓冲区为 null 数组,以存储每次迭代的奖励与损失。
- 使用
create_agent()函数创建智能体实例。 - 使用
forward_pass()与update_policy()函数迭代地运行前向与反向传播。 - 使用
evaluate()函数测试策略性能。 - 将训练与评估函数产生的策略与价值损失、奖励追加到各自的缓冲区。
- 计算最近若干时间步的奖励与损失平均值。下面的示例对最近 40 个时间步的奖励与损失取平均。
- 每隔若干步打印评估结果。下面的示例每 10 步打印一次。
- 当平均奖励超过某个阈值时终止过程。
下面的代码展示了如何在 Python 中声明一个执行上述操作的函数:
def run_ppo():
MAX_EPISODES = 500
DISCOUNT_FACTOR = 0.99
REWARD_THRESHOLD = 475
PRINT_INTERVAL = 10
PPO_STEPS = 8
N_TRIALS = 100
EPSILON = 0.2
ENTROPY_COEFFICIENT = 0.01
HIDDEN_DIMENSIONS = 64
DROPOUT = 0.2
LEARNING_RATE = 0.001
train_rewards = []
test_rewards = []
policy_losses = []
value_losses = []
agent = create_agent(HIDDEN_DIMENSIONS, DROPOUT)
optimizer = optim.Adam(agent.parameters(), lr=LEARNING_RATE)
for episode in range(1, MAX_EPISODES+1):
train_reward, states, actions, actions_log_probability, advantages, returns = forward_pass(
env_train,
agent,
optimizer,
DISCOUNT_FACTOR)
policy_loss, value_loss = update_policy(
agent,
states,
actions,
actions_log_probability,
advantages,
returns,
optimizer,
PPO_STEPS,
EPSILON,
ENTROPY_COEFFICIENT)
test_reward = evaluate(env_test, agent)
policy_losses.append(policy_loss)
value_losses.append(value_loss)
train_rewards.append(train_reward)
test_rewards.append(test_reward)
mean_train_rewards = np.mean(train_rewards[-N_TRIALS:])
mean_test_rewards = np.mean(test_rewards[-N_TRIALS:])
mean_abs_policy_loss = np.mean(np.abs(policy_losses[-N_TRIALS:]))
mean_abs_value_loss = np.mean(np.abs(value_losses[-N_TRIALS:]))
if episode % PRINT_INTERVAL == 0:
print(f'Episode: {episode:3} | \
Mean Train Rewards: {mean_train_rewards:3.1f} \
| Mean Test Rewards: {mean_test_rewards:3.1f} \
| Mean Abs Policy Loss: {mean_abs_policy_loss:2.2f} \
| Mean Abs Value Loss: {mean_abs_value_loss:2.2f}')
if mean_test_rewards >= REWARD_THRESHOLD:
print(f'Reached reward threshold in {episode} episodes')
break
plot_train_rewards(train_rewards, REWARD_THRESHOLD)
plot_test_rewards(test_rewards, REWARD_THRESHOLD)
plot_losses(policy_losses, value_losses)运行程序:
run_ppo()输出应类似于下面的示例:
Episode: 10 | Mean Train Rewards: 22.3 | Mean Test Rewards: 30.4 | Mean Abs Policy Loss: 0.37 | Mean Abs Value Loss: 0.39
Episode: 20 | Mean Train Rewards: 38.6 | Mean Test Rewards: 69.8 | Mean Abs Policy Loss: 0.46 | Mean Abs Value Loss: 0.37
.
.
.
Episode: 100 | Mean Train Rewards: 289.5 | Mean Test Rewards: 427.3 | Mean Abs Policy Loss: 1.73 | Mean Abs Value Loss: 0.21
Episode: 110 | Mean Train Rewards: 357.7 | Mean Test Rewards: 461.4 | Mean Abs Policy Loss: 1.86 | Mean Abs Value Loss: 0.22
Reached reward threshold in 116 episodes您可以在 此 DataLab 笔记本 上查看并运行完整程序!
5. 超参数调优与优化
在机器学习中,超参数控制训练过程。下面我将解释 PPO 中一些重要的超参数:
- 学习率: 学习率决定每次迭代中策略参数的变化幅度。在随机梯度下降中,每次迭代更新策略参数的幅度由学习率与梯度的乘积决定。
- 裁剪参数: 也称为 epsilon,ε。 它决定策略比率的裁剪幅度。新旧策略的比率被允许在 [1-ε, 1+ε] 范围内变化。超出该范围时,将被强制裁剪回范围内。
- 批大小: 指每次梯度更新所考虑的步数。在 PPO 中,批大小是应用策略并计算代理损失以更新策略参数所需的时间步数。本文使用了 64 的批大小。
- 迭代步数: 指每个批次被重复用于反向传播的次数。本文代码将其称为
PPO_STEPS。在复杂环境中,多次运行前向传播的开销很大,更高效的做法是对每个批次反复利用数次。通常建议取值在 5 到 10 之间。 - 折扣因子: 也称为 gamma,γ。 它表达了即时奖励相对于未来奖励的重要程度,这类似于时间价值计算中的利率。当 接近 0 时,意味着未来奖励更不重要,智能体应优先关注即时奖励;当 接近 1 时,意味着未来奖励也很重要。
- 熵系数: 熵系数决定熵奖励,其计算为熵系数与分布熵的乘积。熵奖励的作用是在策略中引入更多随机性,鼓励智能体探索策略空间。但当随机性过高时,训练会无法收敛到最优策略。
- 训练成功标准: 需要设置判断训练成功的标准。常见做法是:要求最近N 次试验(回合)的平均奖励超过某一阈值。在上述示例代码中,这通过变量
N_TRIALS表达。该值越大,训练用时越长,因为策略需要在更多回合中达到阈值奖励;这样会更稳健,但计算开销更大。请注意,PPO 属于随机策略,存在某些回合未能越过阈值的情况。因此,如果N_TRIALS设得过高,训练可能无法终止。
优化 PPO 性能的策略
优化 PPO 训练性能需要反复试验并对不同超参数值进行探索。不过,有一些总体指导:
- 折扣因子: 当长期奖励很重要时(如 CartPole 环境中需要长时间保持杆稳定),可从 0.99 这类适中的 gamma 值开始。
- 熵奖励: 在复杂环境中,智能体必须探索动作空间以找到最优策略。熵奖励促进探索。熵奖励会加到代理损失上。在决定熵系数前,请检查代理损失与分布熵的数量级。本文使用了 0.01 的熵系数。
- 裁剪参数: 裁剪参数决定更新后的策略与当前策略的差异程度。较大的裁剪参数有利于更好地探索环境,但也有 destabilize 训练的风险。您需要一个既允许渐进探索、又能防止破坏性更新的裁剪参数。本文使用了 0.2 的裁剪参数。
- 学习率: 当学习率过高时,策略以大步更新,每次迭代与训练过程可能变得不稳定;当过低时,训练耗时过长。本文使用了 0.001 的学习率,对该环境表现良好。在很多情况下,建议使用 1e-5 的学习率。
PPO 的挑战与最佳实践
在讲解了 PPO 的概念与实现细节之后,让我们讨论其挑战与最佳实践。
训练 PPO 的常见挑战
尽管 PPO 被广泛使用,但要成功解决现实问题,您仍需了解潜在挑战。其中包括:
- 收敛缓慢: 在复杂环境中,PPO 可能在样本利用上效率不高,需要与环境进行大量交互才能收敛到最优策略,这使得训练缓慢且昂贵。
- 对超参数敏感: PPO 依赖高效探索策略空间。训练稳定性与收敛速度对超参数取值敏感,往往只能通过试错找到最优取值。
- 过拟合: RL 环境通常以随机参数初始化。PPO 训练是基于智能体所处环境寻找最优策略。有时训练会收敛到对某个特定环境最优的一组参数,但对其他随机化环境则无效。通常通过进行大量迭代、并在每次迭代中采用不同随机化的训练环境来解决。
- 动态环境: 简单的 RL 环境(如 CartPole)是静态的——规则随时间不变。许多其他环境(如机器人在不稳定移动表面上学走路)是动态的——环境规则随时间变化。要在此类环境中表现良好,PPO 往往需要额外微调。
- 探索与利用的权衡: PPO 的裁剪机制确保策略更新位于可信区域,但同时也可能抑制智能体对动作空间的探索。这可能导致在复杂环境中收敛到局部最优。另一方面,若允许智能体过度探索,则可能无法收敛到任何最优策略。
训练 PPO 模型的最佳实践
为了使用 PPO 取得良好效果,我建议以下最佳实践:
- 归一化输入特征: 对回报与优势的值进行归一化可减少数据的变异性,带来更稳定的梯度更新。归一化使所有值落入一致的数值范围,降低异常值与极端值的影响,否则会扭曲梯度更新并减慢收敛。
- 使用合适的大批大小: 小批量更新更快,但可能导致收敛到局部最优并引发训练不稳定。较大的批量有助于学习鲁棒策略,使训练更稳定。然而,过大的批量也并非最佳:除了增加计算成本外,它会使基于大批量平均值的梯度更新对价值函数的响应性降低,且可能导致对该特定批次的过拟合。
- 迭代步数: 通常建议重用每个批次 5–10 次迭代,这会提升训练效率。过多重用同一批次会导致过拟合。代码中该超参数为
PPO_STEPS。 - 定期评估: 为了检测过拟合,必须定期监控策略有效性。如果策略在某些场景中效果不佳,可能需要进一步训练或微调。
- 调优超参数:如前所述,PPO 训练对超参数取值敏感。请尝试多种取值,以确定适合您具体问题的一组参数。
- 共享骨干网络: 如本文所示,使用共享骨干可避免 actor 与 critic 之间的不平衡。共享骨干有助于共享特征提取与对环境的共同理解,使学习过程更高效稳定,同时降低算法的空间与时间复杂度。
- 隐藏层数量与规模: 在更复杂环境中增加隐藏层的数量与维度。像 CartPole 这样的简单问题用单个隐藏层即可解决。本文使用的隐藏层维度为 64。让网络远大于必要规模会造成计算浪费并可能导致不稳定。
- 早停: 当评估指标达到要求时停止训练,有助于防止过度训练并避免资源浪费。常见的评估指标是:智能体在过去 N 次事件中的奖励超过阈值。
结论
本文讨论了使用 PPO 解决 RL 问题的方法,并详述了用 PyTorch 实现 PPO 的步骤。最后,我们给出了 PPO 的一些性能建议与最佳实践。
最好的学习方式是亲自实现代码。您还可以修改代码以适配 Gym 中其他经典控制环境。要学习如何使用 Python 和 OpenAI 的 Gymnasium 实现 RL 智能体,请学习课程Reinforcement Learning with Gymnasium in Python!

近端策略优化(PPO)是解决强化学习(RL)问题的常用算法之一。它由 OpenAI 联合创始人 John Schuman 于 2017 年提出。
PPO 在 OpenAI 被广泛用于训练模型模拟人类行为。它在早期方法(如信任域策略优化,TRPO)的基础上改进,因其稳健高效而流行。
在本教程中,我们将深入剖析 PPO。我们将讲解其理论,并演示如何用 PyTorch 实现。
理解近端策略优化(PPO)
传统的监督学习算法沿最陡梯度方向更新参数。如果这次更新过大,可以在后续彼此独立的训练样本中被纠正。
然而,在强化学习中,训练样本由智能体的动作与回报组成,因此训练样本之间是相关的。智能体需通过探索环境来寻找最优策略。因此,对梯度进行大幅修改可能会使策略陷入劣势区域并获得次优回报。由于智能体需要探索环境,策略的大幅变化会使训练过程不稳定。
基于信任域的方法旨在通过确保策略更新位于可信区域内来避免此问题。可信区域是在策略空间中人为设定的约束区域,仅允许在其中进行更新。更新后的策略必须与旧策略处于可信范围内。保证策略更新是渐进的,可避免不稳定。
信任域策略更新(TRPO)
信任域策略更新(TRPO)算法由 John Schulman 于 2015 年提出(他在 2017 年也提出了 PPO)。为衡量旧策略与更新后策略之间的差异,TRPO 使用Kullback-Leibler(KL)散度。KL 散度用于衡量两种概率分布之间的差异。TRPO 在实现信任域方面被证明是有效的。
TRPO 的问题在于 KL 散度带来的计算复杂性。应用 KL 散度需要使用泰勒展开等数值方法进行二阶展开,这在计算上代价高昂。PPO 被提出作为 TRPO 更简单高效的替代方案。PPO 对策略比率进行裁剪,以近似信任域,而无需依赖涉及 KL 散度的复杂计算。
这就是为什么在解决 RL 问题时,PPO 优于 TRPO。由于其估计信任域的方法更高效,PPO 在性能与稳定性之间取得了有效平衡。
近端策略近似(PPO)
PPO常被视为基于演员-评论家(actor-critic)方法的一个子类,它基于价值函数更新策略梯度。优势演员-评论家(A2C)方法使用一个称为“优势”的参数。它衡量评论家预测的回报与按照策略执行后实现的回报之间的差异。
要理解 PPO,您需要了解其组成部分:
理解裁剪机制
假设在旧策略 πold 下,在状态 s 采取动作 a 的概率为 πold(a|s)。在新策略下,从相同状态 s 采取相同动作 a 的概率更新为 πnew(a|s)。以策略参数 θ 为自变量,这些概率的比率为 r(θ)。当新策略使该动作(在同一状态下)更可能发生时,比率大于 1,反之亦然。
裁剪机制限制该概率比率,使得新动作概率必须落在旧动作概率的一定百分比范围内。例如,r(θ) 可以被约束在 0.8 到 1.2 之间。这可防止大的跳变,从而确保训练过程稳定。
在本文余下部分,您将学习如何组装各组件,用 PyTorch 实现一个简单的 PPO。