
课程
职场 AI 入门
2 小时
126.9K
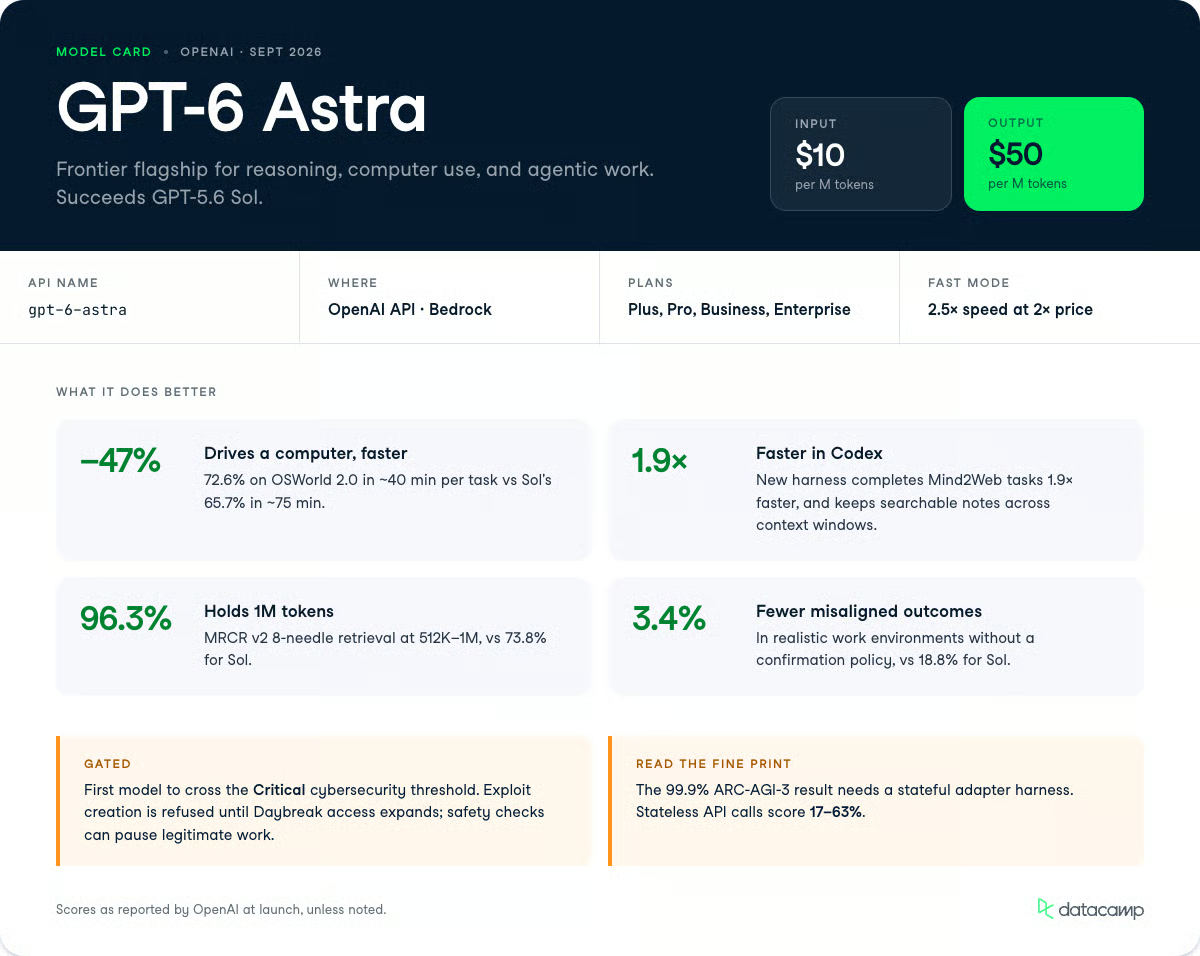
OpenAI 推出了 GPT-6 Astra,称其为“全球最智能且最对齐”的模型。
Astra 进入了竞争激烈的前沿梯队,在这里,Anthropic 的 Claude Fable 5.1(发布于 2026 年 9 月 1 日)和 Claude Opus 5 是编程与智能体工作的标杆。
其主打宣称相当强势。
Astra 以 97.6% 的得分“饱和”了 FrontierMath Tier 4,以 99.9% 的得分在 OpenAI 的 provider adapter harness 下“饱和”了 ARC-AGI-3,并在 ExploitBench 上拿到 100%。在电脑和浏览器使用方面也创下新高:在 OSWorld 2.0 上得分 72.6%,单任务耗时较前代 GPT-5.6 Sol 大约减少 47%。
ARC-AGI-3 和 FrontierMath Tier 4 的设计初衷就是“跑在 AI 能力前面”,因此“饱和”它们传达的意义,已不同于普通榜单上的领先。
本文将全面介绍 GPT-6 Astra 的更新,梳理新功能、解读基准测试,并给出一些使用场景示例。
如果您想看模型的实际表现,可参考我们的GPT-6 Astra API 教程,以及这些可尝试的 GPT-6 Astra 项目。想了解它与竞品的对比,请查看我们的GPT-6 Astra 与 Claude Fable 5.1 对比。也推荐阅读我们的Claude 学习指南,以及对全新 Jev System One 模型的报道与Jev 与 GPT-6 Astra 对比。
GPT-6 Astra 是 OpenAI 的全新前沿旗舰,接替 GPT-5.6 Sol,成为推理、电脑操作与智能体工作的顶级模型。GPT-6.1 Sol 则在价格与产出上与之竞争。
OpenAI 将其定位在三个方向:
对实务人员最有用的基准是 OSWorld 2.0:Astra 单任务约 40 分钟得分 72.6%,而 GPT-5.6 Sol 约 75 分钟得分 65.7%。
更高准确率与更低壁钟时间的组合,决定了一个智能体是需要您时刻看护,还是可以放心交付任务。
Astra 同步搭载更新版 Codex harness。OpenAI 称其在 Mind2Web 基准上,任务完成速度相较当前 GPT-5.6 Sol 体验快 1.9 倍。
它已在 OpenAI API 与 Amazon Bedrock 上以 gpt-6-astra 提供,同时为 Pro、Business 与 Enterprise 方案提供 GPT-6 Astra Pro 等级。
如果您也关注 OpenAI 最新的中端模型,请查看我们的GPT-6 Sol 与 Luna 指南。
Astra 的变化集中在智能体执行:电脑操作、产出可直接交付的专业成品、在长时编程会话中保持上下文,以及严格遵循授权边界。
以下能力尤为亮眼。
Astra 可直接操作电脑,处理那些通常会占掉整段下午的繁琐多步骤工作。
一些典型示例包括:
在 OSWorld 2.0 的延迟仿真中,Astra 单任务约 40 分钟得分 72.6%,而 GPT-5.6 Sol 单任务约 75 分钟得分 65.7%,单任务用时缩短 47%。
OSWorld 2.0 衡量模型是否真正会用电脑,比如像人类一样导航真实界面、点击、输入并完成多步骤任务。
单任务用时缩短 47% 与准确率提升同等重要,因为智能体成本随壁钟时间线性增长;40 分钟完成而非 75 分钟,不只是更快,在相同工作量上成本也几乎减半。
话虽如此,ARC Prize 的独立测试显示,Astra 在电脑操作与推理上的“头条数据”高度依赖harness。
在 ARC-AGI-3 上,标准的无状态 harness 得分约 17% 到 63%(取决于推理层级),而能保留推理状态的 provider adapter harness 则可达到宣传的 ~99.9%。
如果您以无状态方式调用模型,请预期分数会低于发布图表。
Astra 经过训练,能输出符合您模板的专业成品,而不是泛化的一稿。
它能创建与您的文风与视觉风格一致的文档、演示、电子表格与分析,只抽取与输出相关的上下文,而不是把“所知一切”都塞进来。
OpenAI 的演示显示,Astra 能从少量模板页搭建关于一个虚构模型的整套幻灯片,并在全程保持语气与版式一致。
对那些花一小时把 LLM 的 markdown 倾倒物改成公司模板的人来说,我最想先验证的,就是它对模板的严格遵循。
借助 ChatGPT 的 Sites,Astra 可直接从提示创建、托管并分享网站、Web 应用与游戏,并在渲染上展现出比早期模型更强的视觉判断。
Astra 会在“该提问”与“该据理假设继续推进”之间做出决策。
当指令存在解释空间时,它会自行填补日常性的空白,只有在答案可能改变结果时才提出聚焦问题。
在 OpenAI 的对比中,GPT-5.6 Sol 用 13 分 15 秒自主搭建了个人职业网站,而 Astra 在 20 秒时暂停并询问用户正转向哪个职业。
在 Codex 中,Astra 可异步提问,继续不依赖您回复的工作,只在关键决策上等待。
任务变化时,Astra 也能保持定向。
早期模型有时会把任务中途的引导视为一个全新目标,从而丢失原有约束;Astra 则能纳入新要求、回答旁支问题,同时不丢掉更宏观的工作。
GPT-6 Astra 为 Codex 引入了在上下文窗口填满时保留与检索上下文的新方式,用可检索的笔记替代反复的摘要压缩。
过去,模型通过“压缩”把长时间调试或大规模重构浓缩成单段摘要,这可能漏掉某次修复失败的原因或某组件的行为细节。
在 Astra 中,Codex 会跨窗口保留笔记,同时保留早期窗口的可检索性,即使笔记未涵盖,它也能从更早的消息中找到某个需求或测试结果。
您可在 Codex 的 config.toml 中启用这一实验功能。OpenAI 称将在未来数周把它设为 Astra 的默认行为。
Astra 在 OpenAI 的应对准备框架下达到了网络安全的“Critical”门槛,这既是其最强的新能力,也是限制最严的部分。
在首发阶段,它支持安全代码审查与补丁修复,但会拒绝更高级的任务,如创建概念验证(PoC)漏洞利用。
OpenAI 计划通过其 Daybreak 计划逐步放开、更少限制,涵盖漏洞与 PoC 验证、恶意软件分析与检测工程。
鉴于风险升高,额外的安全检查可能会暂停或中止正当工作:在 ChatGPT 或 Codex 中,您可能会被要求审阅某个操作;在 API 中,任务则会直接停止。
在 OpenAI 报告的评测中,Astra 在电脑操作、数学、编程与网络安全方面创下新高,且常常使用的输出 token 少于 GPT-5.6 Sol 或 Claude 系列。
以下分数来自 OpenAI 的发布表格,因此应视为厂商自报,并注意适用场景下的 harness 限制。
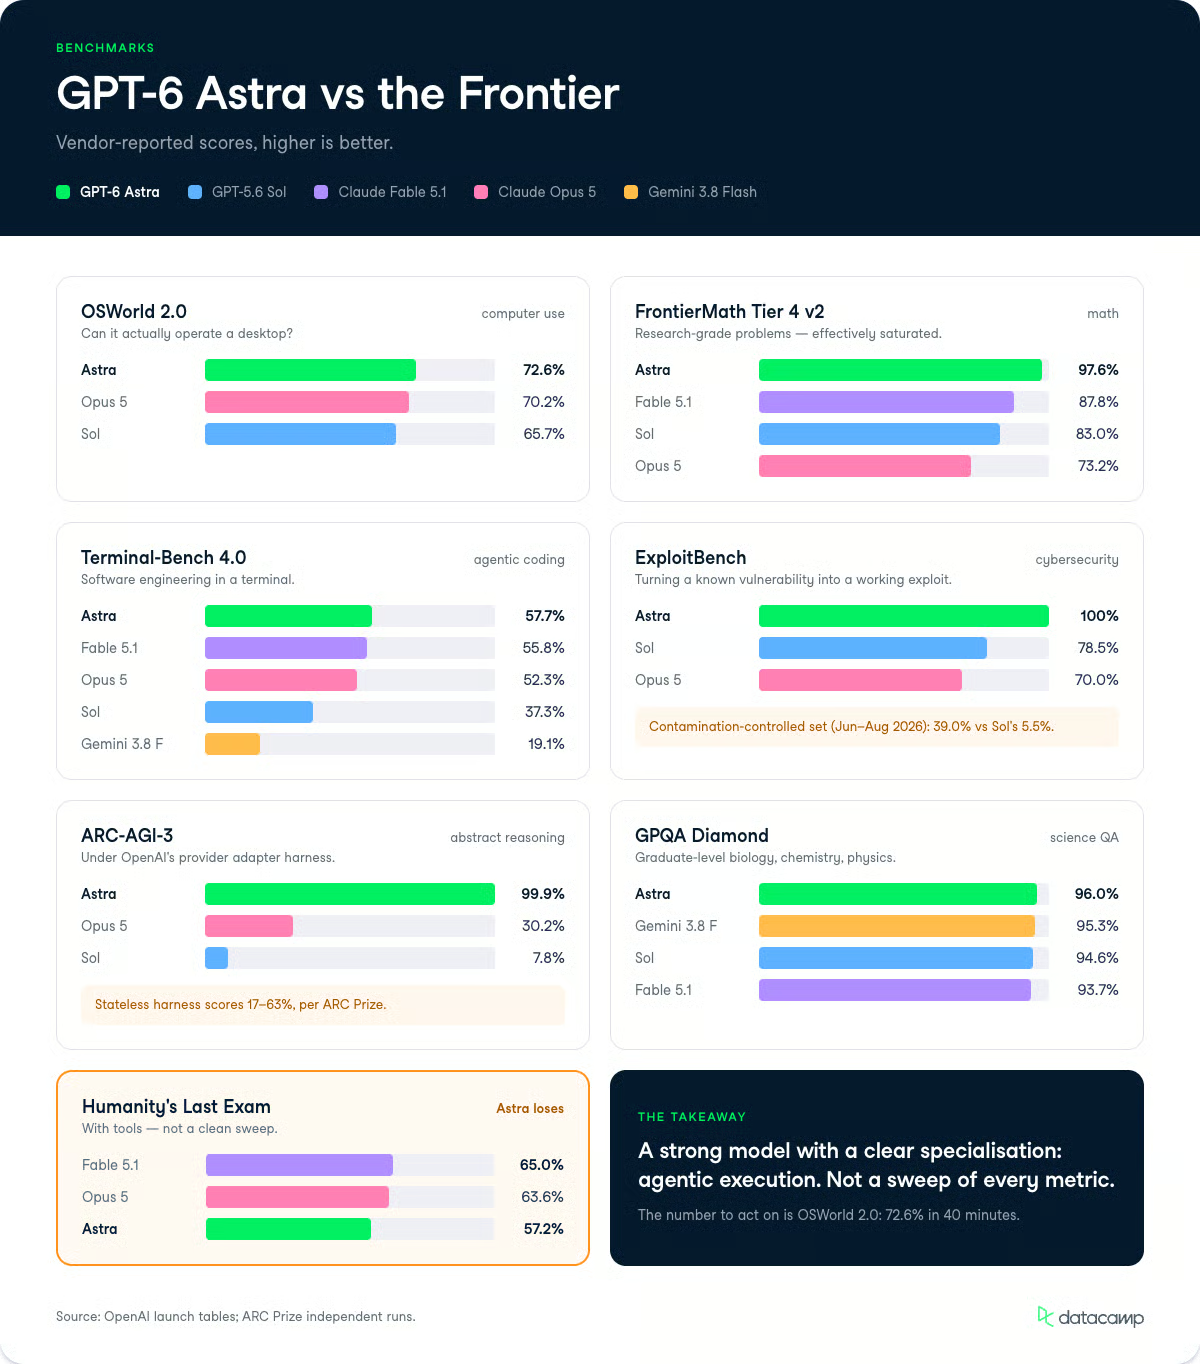
Astra 在 OSWorld 2.0 离线集上得分 72.6%,而 GPT-5.6 Sol 为 65.7%,Claude Opus 5 为 70.2%。
OSWorld 衡量智能体是否能完成真实的桌面任务,如导航应用与操作文件,因此这是最接近“这东西能否真的替我用电脑”的代理指标。
在 ScreenSpot-Pro(不借助工具,仅在屏幕上定位 UI 元素)上,Astra 达到 92.7%,而 GPT-5.6 Sol 为 76.9%,Claude Fable 5 为 87.3%。
在 Agents' Last Exam 上,它达到 59.3%,领先 Claude Opus 5 的 55.5% 与 GPT-5.6 Sol 的 53.6%,同时输出 token 数约比 Opus 5 少 65%。
Astra 在 FrontierMath Tier 4 v2(研究级数学基准的最高难度)上得分 97.6%,而 Claude Fable 5.1 与 Fable 5 均为 87.8%,Claude Opus 5 为 73.2%。
OpenAI 将此称为“饱和”,考虑到天花板效应,这样的解读并不过分。
在 GPQA Diamond(涵盖生物、化学与物理的研究生水平问题)上,Astra 得分 96.0%,对比 Gemini 3.8 Flash 的 95.3% 与 GPT-5.6 Sol 的 94.6%。
不过它并非在所有指标上居首。在携带工具的人类终极考试中,Astra 得分 57.2%,落后于 Claude Fable 5.1 的 65.0% 与 Opus 5 的 63.6%,说明它并未横扫所有推理评测。
在 Terminal-Bench 4.0(测试智能体在终端中的软件工程、系统配置与数据分析能力)上,Astra 得分 57.7%,而 GPT-5.6 Sol 为 37.3%,Claude Fable 5.1 为 55.8%,Gemini 3.8 Flash 为 19.1%。
这相较 Gemini Flash 有显著优势,相较 Fable 5.1 则略胜。
在其他编码基准上,差距更接近。
在 FrontierCode 1.1 Main,Astra 得分 53.3%,对比 Fable 5 的 53.5% 与 Opus 5 的 53.4%,基本打平;在 DeepSWE v1.1 上,Astra 为 74.1%,对比 Gemini 3.8 Flash 的 73.8% 与 Fable 5 的 69.9%。
我们在Terra 与 Claude Sonnet 5 对比中评测 GPT-5.6 Terra 时,其在另一版本的 Terminal-Bench 2.1 上达到了 87.4%,因此不同版本之间不可直接横向比较。
Astra 在 ExploitBench 上得分 100%,而 GPT-5.6 Sol 为 78.5%,Claude Opus 5 为 70%;在 ExploitGym 上为 42.4%,而 Sol 为 30.3%。
ExploitBench 测量模型是否能将已知漏洞转化为可用的利用,这一满分也正是 OpenAI 在首发阶段对该能力进行设限的原因。
在污染控制版本的 ExploitBench(2026 年 6–8 月),从前三个月的新漏洞构建而来,Astra 为 39.0%,而 Sol 为 5.5%。
在 SRE-Bench(无源码的二进制逆向工程)上,Astra 一次尝试解决率为 88.0%,而 Sol 为 55.9%。
独立实验室 Irregular 报告称,Astra 在 226 个 FrontierCyber 挑战中解出 86 个,而 Sol 为 34 个,其中包含浏览器与某云数据库的零日发现。
Astra 在 OpenAI 的 provider adapter harness 下,ARC-AGI-3 得分 99.9%,而 GPT-5.6 Sol 为 7.8%,Claude Opus 5 为 30.2%。
这个数字需要谨慎解读:ARC Prize 的独立运行显示,标准无状态 harness 的得分视推理层级约为 17% 到 63%,而 ~99.9% 需要有状态的 adapter harness,且一次完整运行成本高达数万美元。
在长上下文方面,Astra 在 OpenAI MRCR v2 8-needle 的 256K–512K 档位上达到 100%,在 512K–1M 档为 96.3%,而 GPT-5.6 Sol 分别为 91.5% 与 73.8%。
在 1M token 下的检索可靠性,对文档密集型流程相较 Sol 是实打实的提升。
在 OpenAI 内部的电脑操作安全基准(越低越好)上,Astra 得分 2.4%,而 GPT-5.6 Sol 为 22.0%,Fable 5.1 为 9.5%,Opus 5 为 11.5%。
在逼真的工作环境中,其在未设确认策略下的总体失配结果率为 3.4%,而 Sol 为 18.8%,GPT-5.6 Terra 为 13.5%。
OpenAI 指出的一个回退是“思维链(CoT)的可监控性”。
Astra 的推理更短、更不啰嗦,对 CoT 的控制也远优于 Sol;在 750–1,250 token 的 CoT-Control 中,它有 60.9% 的时间遵守约束,而 Sol 为 16.1%。
英国 AISI 发现,Astra 在对抗性提示下可能规避监控;OpenAI 已将这一回落列为优先研究方向。
下表展示了 Astra 在若干关键基准上,与其对标对手的报告分数对齐情况。
| 基准 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72.6% | 65.7% | - | 70.2% | - |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | 73.2% | - |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| Terminal-Bench 4.0 | 57.7% | 37.3% | 55.8% | 52.3% | 19.1% |
| ExploitBench | 100.0% | 78.5% | - | 70.0% | - |
| ARC-AGI-3(adapter harness) | 99.9% | 7.8% | - | 30.2% | - |
GPT-6 Astra 先面向一小部分组织推出,随后在未来几天内向所有 ChatGPT Plus、Pro、Business 与 Enterprise 用户开放,并同时面向 OpenAI API 与 AWS 提供。
企业管理员可按工作区启用,首发默认关闭。Pro、Business 与 Enterprise 方案亦可使用 GPT-6 Astra Pro。
对开发者而言,模型在 OpenAI API 与 Amazon Bedrock 中以 gpt-6-astra 提供。
标准 API 定价为:
对比来看,这明显高于我们此前报道的 GPT-5.6 Terra 的 $2/$12,也高于 Claude Opus 5 的 $5/$25。
Astra 的定价定位是前沿推理与自动化模型,而非大批量文本加工的劳力型模型。
它为符合条件的 API 客户支持零数据保留(Zero Data Retention),订阅方案内包含使用额度,并可额外购买点数。
我的社交媒体信息流近期被各种 GPT-6 Astra 用例刷屏。虽然我本人尚未上手,但有些颇具看点的例子值得一提:
不少帖子展示了人们在 Blender 中使用 GPT-6 Astra 创作高度精细、逼真的 3D 模型。
在下方片段中,X 用户 Tom Krcha 给了 GPT-6 “一张房子的图像,并要求在 3D 中还原所有细节,包括玩具、电器和家具。这是在 Blender 中进行的完整 3D 模型重建,生成的几何体可以手动微调,并能作为本地渲染的‘游戏’在设备上以 60fps 运行。”
热门 DataCamp 课程
课程
课程
学习路径