

机器学习中的 SHAP 值
SHAP 值是获取一致且客观解释以了解每个特征如何影响模型预测的常用方法。
SHAP 值基于博弈论,为模型中的每个特征分配一个重要性值。SHAP 值为正的特征对预测产生正向影响,而为负的特征则产生负向影响。其绝对值反映影响强度。
SHAP 值与模型无关(model-agnostic),也就是说它可用于解释任何机器学习模型,包括:
- 线性回归
- 决策树
- 随机森林
- 梯度提升模型
- 神经网络
SHAP 值的性质
SHAP 值具有多项有用性质,使其在解释模型时非常有效:
可加性
SHAP 值是可加的,意味着每个特征对最终预测的贡献可以独立计算并相加。即使在高维数据集上,这一性质也使得 SHAP 值的计算更高效。
局部准确性
对于给定输入,SHAP 值之和等于期望模型输出与实际输出之间的差值。这表示 SHAP 值为给定输入提供了准确且局部的预测解释。
缺失性
对于某次预测中缺失或无关的特征,其 SHAP 值为 0。这使 SHAP 值对缺失数据具有鲁棒性,并确保无关特征不会扭曲解释。
一致性
除非某个特征的贡献发生变化,否则模型改变时 SHAP 值不会变化。这意味着即使模型架构或参数发生变化,SHAP 值也能提供一致的模型行为解释。
总的来说,SHAP 值为理解机器学习模型如何进行预测,以及哪些特征影响最大,提供了一种一致且客观的方法。
如何在 Python 中实现 SHAP 值
本节我们将计算 SHAP 值,并可视化特征重要性、特征依赖、力导向图(force plot)和决策图(decision plot)。
在线运行和编辑此教程中的代码
运行代码环境设置
通过 PyPI 或 conda-forge 安装 SHAP:
或
加载 Telecom Customer Churn 数据集。该数据集较为干净,目标列为“Churn”。
import shap
import pandas as pd
import numpy as np
shap.initjs()
customer = pd.read_csv("data/customer_churn.csv")
customer.head()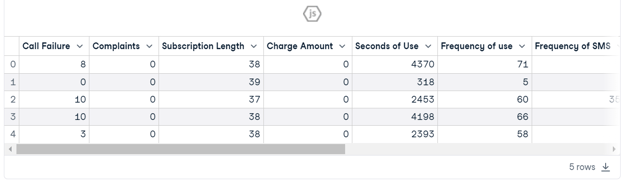
模型训练与评估
- 使用目标列创建 X 和 y,并将数据集划分为训练集与测试集。
- 在训练集上训练随机森林分类器。
- 使用测试集进行预测。
- 显示分类报告。
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split
X = customer.drop("Churn", axis=1) # Independent variables
y = customer.Churn # Dependent variable
# Split into train and test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1)
# Train a machine learning model
from sklearn.ensemble import RandomForestClassifier
clf = RandomForestClassifier()
clf.fit(X_train, y_train)
# Make prediction on the testing data
y_pred = clf.predict(X_test)
# Classification Report
print(classification_report(y_pred, y_test))由于数据集不平衡,模型在标签“0”上的表现优于“1”。整体来看,准确率为 94%,结果可以接受。
precision recall f1-score support
0 0.97 0.96 0.97 815
1 0.79 0.82 0.80 130
accuracy 0.94 945
macro avg 0.88 0.89 0.88 945
weighted avg 0.94 0.94 0.94 945查看我们的 机器学习中的分类指南,了解包含 Python 示例的分类任务。
设置 SHAP 解释器
接下来是模型解释部分。
我们将先通过提供随机森林分类模型创建一个解释器对象,然后使用测试集计算 SHAP 值。
explainer = shap.Explainer(clf)
shap_values = explainer.shap_values(X_test)汇总图(Summary Plot)
使用 SHAP 值与测试集绘制 summary_plot。
汇总图展示了模型中各特征的重要性。结果显示,“Status”“Complaints”和“Frequency of use”在决定结果方面起主要作用。
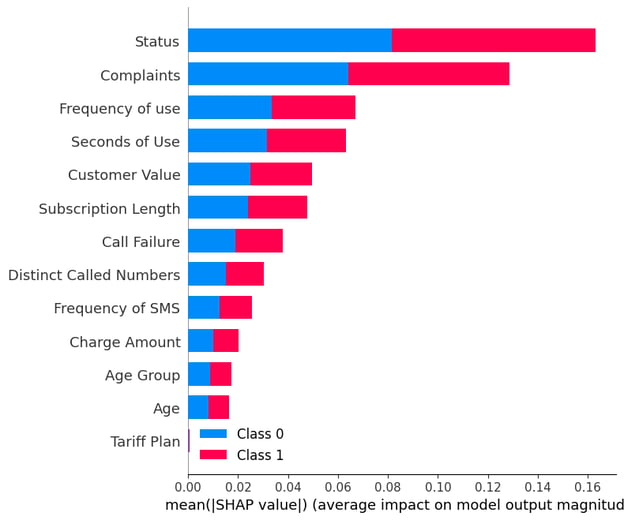
显示标签“0”的 summary_plot。
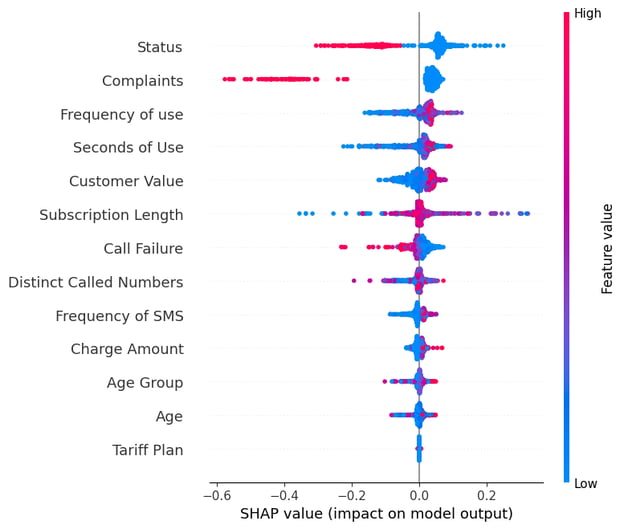
shap.summary_plot(shap_values[0], X_test)- 纵轴按从上到下的重要性顺序显示特征名称。
- 横轴表示 SHAP 值,对应对对数几率的变化幅度。
- 每个点的颜色表示对应特征的取值,高值为红色,低值为蓝色。
- 每个点代表原始数据集中的一行数据。
如果您查看特征“Complaints”,会发现其大多在负的 SHAP 值处取高值。这意味着更高的投诉次数往往会对输出产生负面影响。
注意:对于标签“1”,可视化将呈相反方向。
依赖图(Dependence Plot)
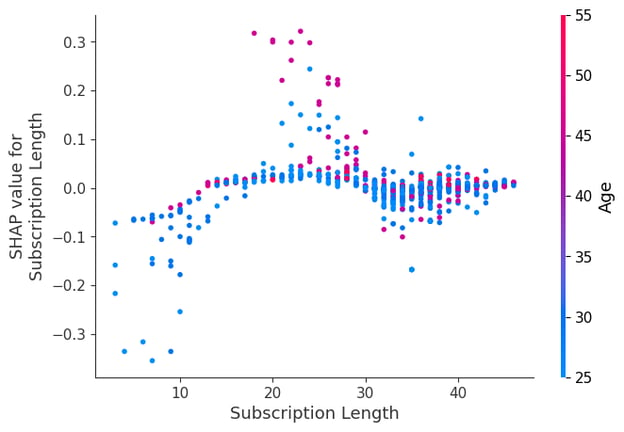
可视化特征“Subscription Length”和“Age”之间的 dependence_plot。
shap.dependence_plot("Subscription Length", shap_values[0], X_test,interaction_index="Age")依赖图是一种散点图,用于展示模型预测如何受某一特定特征(Subscription Length)的影响。整体来看,订阅时长对模型大多产生正向影响。
力导向图(Force Plot)
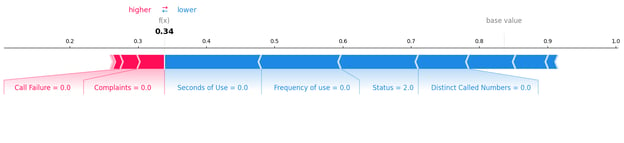
我们将检查测试集中的第一个样本,确定哪些特征促成了“0”的结果。为此,我们将使用力导向图,并提供期望值、SHAP 值和该测试样本。
shap.plots.force(explainer.expected_value[0], shap_values[0][0,:], X_test.iloc[0, :], matplotlib = True)我们可以清楚地看到,零投诉和零呼叫失败对客户不流失起到了负向推动作用。
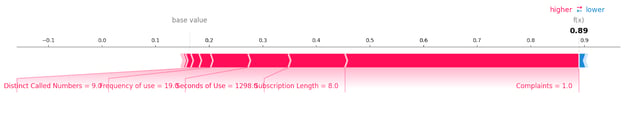
接着查看标签为“1”的客户流失样本。
shap.plots.force(explainer.expected_value[1], shap_values[1][6, :], X_test.iloc[6, :],matplotlib = True)您可以看到所有具有相应取值与影响强度的特征,它们共同促成了客户流失。看起来即使只有一条未解决的投诉,也可能让一家电信公司失去客户。
决策图(Decision Plot)
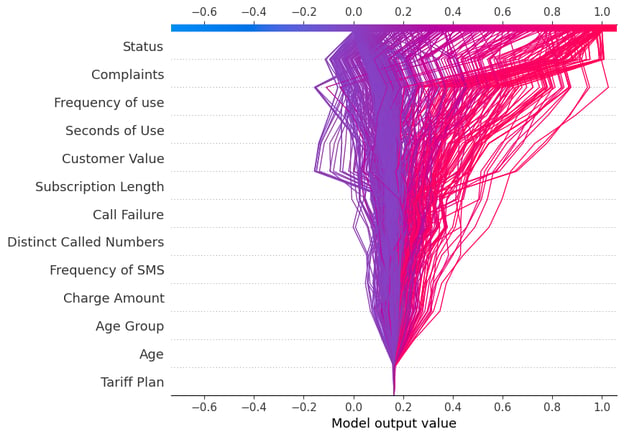
现在我们来显示 decision_plot。它通过映射每次预测的累计 SHAP 值来直观呈现模型的决策过程。
shap.decision_plot(explainer.expected_value[1], shap_values[1], X_test.columns)决策图中的每一条线展示了各个特征对单次模型预测的贡献强度,从而解释了哪些特征值推动了该预测。
注意:目标标签“1”的决策图会朝向“1”倾斜。
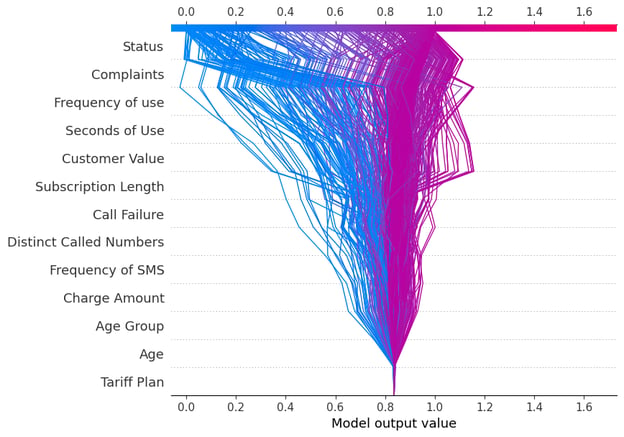
显示目标标签“0”的决策图
shap.decision_plot(explainer.expected_value[0], shap_values[0], X_test.columns)对于目标标签“0”,决策图会朝向“0”倾斜。
SHAP 值的应用
除了机器学习的可解释性与可说明性,SHAP 值还可用于:
- 模型调试。通过检查 SHAP 值,我们可以识别数据中可能导致模型出错的偏差或异常值。
- 特征重要性。识别并移除影响较小的特征,有助于构建更优化的模型。
- 锚定式解释。我们可以利用 SHAP 值解释单条预测,突出导致该预测的关键特征,帮助用户理解并信任模型决策。
- 模型概览。可通过 SHAP 值汇总图提供模型的全局概览,呈现整个数据集中最重要的特征。
- 偏差检测。SHAP 值分析有助于识别某些特征是否对特定群体产生不成比例的影响,从而发现并减少模型中的歧视。
- 公平性审计。可用于评估模型的公平性与伦理影响。
- 合规审批。通过解释模型决策,SHAP 值有助于获得监管机构的批准。
结论
我们探讨了 SHAP 值以及如何利用它来为机器学习模型提供可解释性。虽然模型准确性至关重要,但企业需要超越准确性,关注可解释性与透明度,以赢得用户和监管者的信任。
能够解释模型为何做出某个特定预测,有助于调试潜在偏差、识别数据问题,并为模型决策提供合理性依据。
如果您刚接触机器学习且希望为就业做好准备,建议学习 Machine Learning Scientist with Python 职业学习路径。该项目将帮助您掌握成为机器学习科学家所需的 Python 技能并获得相关岗位。

机器学习模型正变得愈发复杂、强大,并且能够做出准确预测。然而,随着这些模型逐渐成为“黑箱”,我们更难理解它们是如何得出这些预测的。这促使人们日益关注机器学习的可解释性与可说明性。
例如,您在银行申请贷款却被拒绝。您想知道被拒的原因,但客服人员回复说是一个算法否决了申请,他们无法确定具体原因。是不是很令人沮丧?影响到您的决策,理应给出解释。这也是企业努力让其机器学习模型更加透明、易懂的原因。
在这一过程中,最有前景的工具之一是 SHAP 值,它衡量每个特征(如收入、年龄、信用评分等)对模型预测的贡献。SHAP 值能帮助您了解模型中哪些特征最重要,以及它们如何影响结果。
在本教程中,我们将学习 SHAP 值及其在机器学习模型解释中的作用。我们还会使用
ShapPython 包来创建并分析用于解释模型的不同图表。什么是 SHAP 值?
SHAP(SHapley Additive exPlanations)值是一种解释任意机器学习模型输出的方式。它采用博弈论方法,衡量每个“玩家”对最终结果的贡献。在机器学习中,为每个特征分配一个重要性值,用于表示其对模型输出的贡献。
SHAP 值展示了每个特征如何影响每一次最终预测、各特征之间的重要性对比,以及模型对特征交互的依赖程度。