

什么是 Amazon Nova 模型?
Amazon 的 Nova 模型是备受期待的基础模型,可通过 Amazon Bedrock 服务访问。它们面向多种应用场景而设计,包括低成本的快速推理、多媒体理解和创意内容生成。下面逐一了解各个模型。
Amazon Nova Micro
家族中速度最快、算力成本最低的模型。Micro 最适合需要快速纯文本生成的应用,推理速度可达每秒 200 个 token。
Micro 的典型应用包括实时分析、交互式聊天机器人以及高并发文本生成服务。
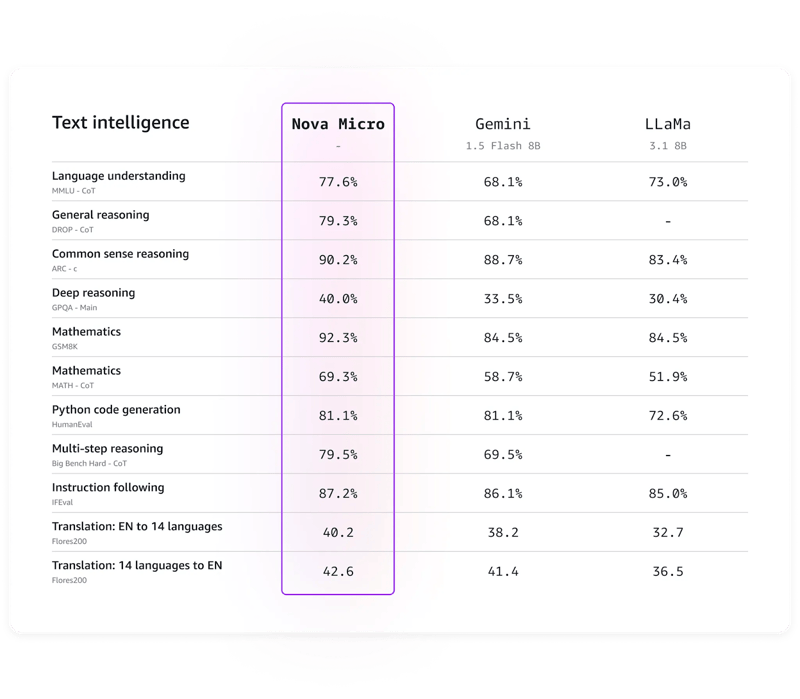
Nova Micro 基准测试。(来源: Amazon)
Amazon Nova Lite
Nova 家族中具成本效益的多模态成员,Lite 在速度与多任务高准确率之间取得了良好平衡,尤其在推理与翻译任务上,相较于其同类模型如GPT-4o 或 Llama 时表现突出。
它能高效处理大量请求,同时保持较强的准确性。当速度很关键且需要处理多模态的模型时,Lite 会是理想选择。
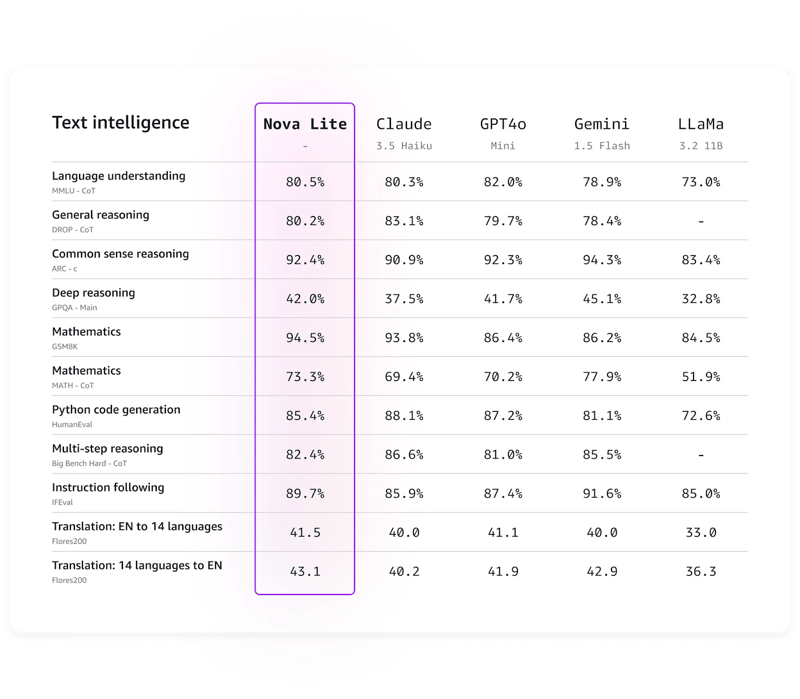
Nova Lite 基准测试。(来源: Amazon)
Amazon Nova Pro
Nova 家族中面向文本处理最先进的模型 Nova Pro,在保持相对较低算力成本的同时,提供了令人印象深刻的准确度,与具备相似能力的模型相比更具优势。
据 Amazon 介绍,Nova Pro 适用于视频摘要、问答、数学推理、软件开发,以及能够执行多步工作流的 AI 智能体等应用。与 Micro 和 Lite 一样,Nova Pro 目前支持微调。
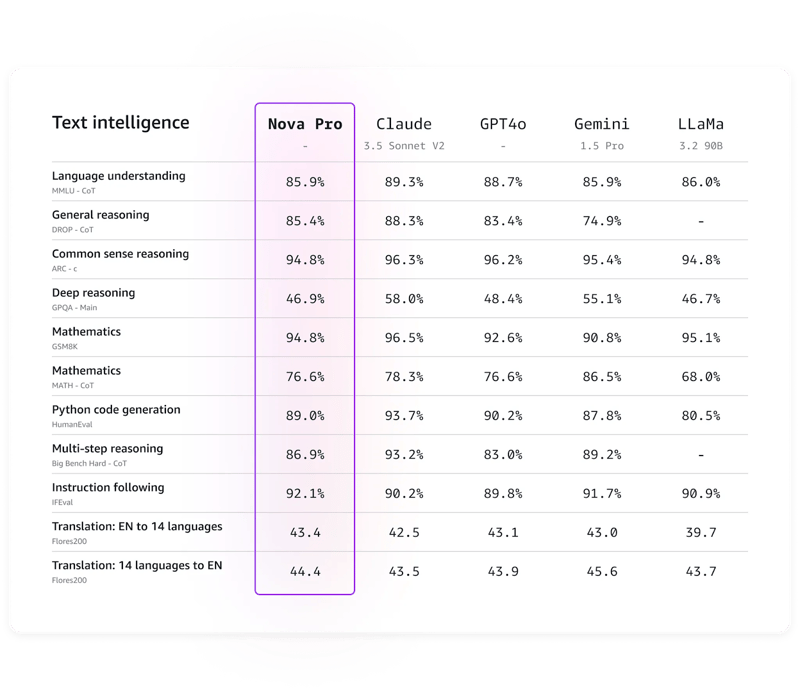
Nova Pro 基准测试。(来源: Amazon)
Amazon Nova Premier
家族中能力最强的多模态模型,预计将于 2025 年初发布,被视为 Pro 模型的进一步升级。
Amazon Nova Canvas
Canvas 是 Nova 的图像生成解决方案。它可以生成高质量图像,并提供配色方案与风格控制,支持修复填充(inpainting)、外延扩图(outpainting)、扩展图像、风格迁移和背景移除等功能。该模型非常适合创建营销图片、产品模型图等。
Amazon Nova Reel
Nova Reel 是一款视频生成模型,旨在产出高质量且易于自定义的视频。Nova Reel 使用户能够在视频中创建并控制视觉风格、节奏和镜头运动。与其他 Nova 模型一样,Reel 内置安全控制,支持生成与规范一致的内容。
如何通过 Amazon Bedrock Playground 访问 Amazon Nova 模型
您可以使用 Amazon Bedrock 的Playground,通过开箱即用的用户界面测试和对比多个模型。
我假设您已配置好 Amazon CLI 和 Bedrock 并可使用。若尚未完成,您可以参考我的教程AWS Multi-Agent Orchestrator,其中详细介绍了为使用 Bedrock 提供的模型而搭建环境的步骤。此外,Nils Durner 的博文也提供了分步截图,引导您完成 Bedrock 服务的设置。
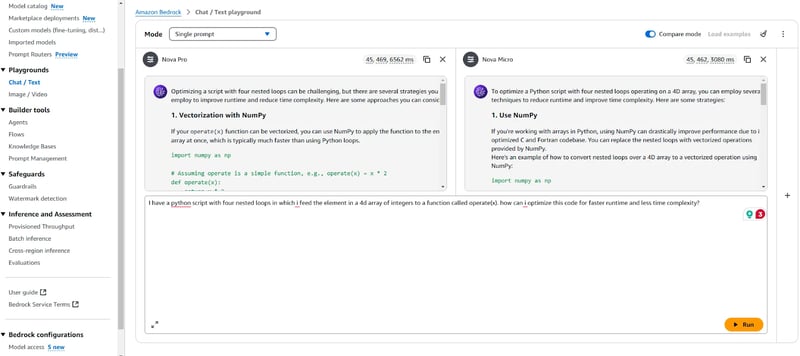
Amazon Bedrock Playground
在对比 Nova Micro 与 Pro 时,我注意到两者准确度差距并不明显。虽然 Micro 在文本生成上比 Pro 快两倍以上,但已能为大多数常规场景提供足够的回答;相较之下,Pro 倾向于产出更为细致、略长的响应。
如何通过 Amazon Bedrock API 访问 Amazon Nova 模型
若要通过 API 使用 Nova 模型并将其集成到您的代码中,请先确保已正确配置 AWS 账户、AWS CLI 以及对模型的访问权限(文档对此提供了指导)。
接着,安装 boto3 库,即 AWS 的 Python SDK,用于操作其模型。
pip install boto3您可以使用如下脚本以编程方式与模型交互:
import boto3
import json
client = boto3.client(service_name="bedrock-runtime")
messages = [
{"role": "user", "content": [{"text": "Write a short poem"}]},
]
model_response = client.converse(
modelId="us.amazon.nova-lite-v1:0",
messages=messages
)
print("\\n[Full Response]")
print(json.dumps(model_response, indent=2))
print("\\n[Response Content Text]")
print(model_response["output"]["message"]["content"][0]["text"])使用 Nova Micro 和 AWS Multi-Agent Orchestrator 的演示项目
现在我们实现一个演示项目,测试 Nova Micro 的智能体能力。我们将使用 AWS Multi-Agent Orchestrator 框架,搭建一个由两个智能体组成的简化 Python 应用:Python 开发者智能体与机器学习专家智能体。若您想搭建该编排器,可以参考这份AWS Multi-Agent Orchestrator 指南。
我们还将使用 Chainlit 这一开源 Python 包,为应用实现一个简单的界面。首先安装所需库:
chainlit==1.2.0
multi_agent_orchestrator==0.0.18我们先导入必要的库:
import uuid
import chainlit as cl
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator, OrchestratorConfig
from multi_agent_orchestrator.classifiers import BedrockClassifier, BedrockClassifierOptions
from multi_agent_orchestrator.agents import AgentResponse
from multi_agent_orchestrator.agents import BedrockLLMAgent, BedrockLLMAgentOptions, AgentCallbacks
from multi_agent_orchestrator.orchestrator import MultiAgentOrchestrator
from multi_agent_orchestrator.types import ConversationMessage
import asyncio
import chainlit as cl该框架使用分类器(Classifier)为传入的用户请求选择最佳智能体。我们将“anthropic.claude-3-haiku-20240307-v1:0”用作分类器的模型。
class ChainlitAgentCallbacks(AgentCallbacks):
def on_llm_new_token(self, token: str) -> None:
asyncio.run(cl.user_session.get("current_msg").stream_token(token))
# Initialize the orchestrator
custom_bedrock_classifier = BedrockClassifier(BedrockClassifierOptions(
model_id='anthropic.claude-3-haiku-20240307-v1:0',
inference_config={
'maxTokens': 500,
'temperature': 0.7,
'topP': 0.9
}
))
orchestrator = MultiAgentOrchestrator(options=OrchestratorConfig(
LOG_AGENT_CHAT=True,
LOG_CLASSIFIER_CHAT=True,
LOG_CLASSIFIER_RAW_OUTPUT=True,
LOG_CLASSIFIER_OUTPUT=True,
LOG_EXECUTION_TIMES=True,
MAX_RETRIES=3,
USE_DEFAULT_AGENT_IF_NONE_IDENTIFIED=False,
MAX_MESSAGE_PAIRS_PER_AGENT=10,
),
classifier=custom_bedrock_classifier
)接下来,我们定义两个由 Nova Micro 驱动的智能体,一个充当 Python 开发专家,另一个为机器学习领域专家。
def create_python_dev():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Python Developer Agent",
streaming=True,
description="Experienced Python developer specialized in writing, debugging, and evaluating only Python code.",
model_id="amazon.nova-micro-v1:0",
callbacks=ChainlitAgentCallbacks()
))
def create_ml_expert():
return BedrockLLMAgent(BedrockLLMAgentOptions(
name="Machine Learning Expert",
streaming=True,
description="Expert in areas related to machine learning including deep learning, pytorch, tensorflow, scikit-learn, and large language models.",
model_id="amazon.nova-micro-v1:0",
callbacks=ChainlitAgentCallbacks()
))
# Add agents to the orchestrator
orchestrator.add_agent(create_python_dev())
orchestrator.add_agent(create_ml_expert())最后,我们为 Chainlit 界面编写脚本主体,用于处理用户请求与智能体响应。
@cl.on_chat_start
async def start():
cl.user_session.set("user_id", str(uuid.uuid4()))
cl.user_session.set("session_id", str(uuid.uuid4()))
cl.user_session.set("chat_history", [])
@cl.on_message
async def main(message: cl.Message):
user_id = cl.user_session.get("user_id")
session_id = cl.user_session.get("session_id")
msg = cl.Message(content="")
await msg.send() # Send the message immediately to start streaming
cl.user_session.set("current_msg", msg)
response:AgentResponse = await orchestrator.route_request(message.content, user_id, session_id, {})
# Handle non-streaming responses
if isinstance(response, AgentResponse) and response.streaming is False:
# Handle regular response
if isinstance(response.output, str):
await msg.stream_token(response.output)
elif isinstance(response.output, ConversationMessage):
await msg.stream_token(response.output.content[0].get('text'))
await msg.update()
if __name__ == "__main__":
cl.run()最终即可得到 Chainlit 界面,使您能够以实践方式随时与 Nova 模型对话。
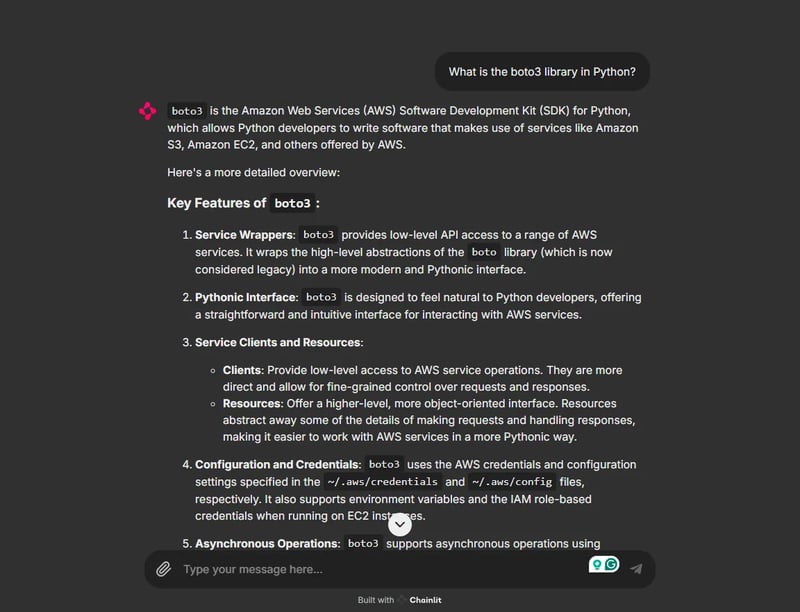
在 Chainlit 上运行我们的应用
图像与视频生成模型也可通过 API 使用。您可参考文档中的脚本示例,了解如何调用它们。
结论
Amazon Nova 模型在基础模型生态上更进一步,集前沿的准确度、速度、成本效益与多模态能力于一体。随着 Amazon LLM 套件不断推出新产品,它正成为在 AWS 基础上构建高性价比、可扩展应用的有力之选。
无论您是在开发具备智能体能力的 AI 应用、为客户服务构建聊天机器人,还是作为开发者进行探索,尝试 Nova 模型都值得一试。同时,深入了解 AWS、Bedrock 与 Amazon 的 LLM 工具也大有裨益。
本文介绍了这些模型的关键要点、如何进行试验,以及如何使用 Nova 模型构建一个基础的智能体 AI 应用。

人工智能硕士生与 AI 技术写作者。我分享最新的 AI 技术见解,让机器学习研究更易理解,并将复杂的 AI 主题加以简化,助您始终走在前沿。
Amazon 发布了一套面向大规模、低成本使用的最新基础模型。Nova 现已加入 Amazon 的 LLM 生态,集成于 Amazon Bedrock 服务,并支持文本、图像、视频等多种模态的生成。
在本文中,我将概述全新的 Amazon Nova 模型,说明如何通过 Bedrock 服务访问它们,重点介绍各模型的能力与优势,并展示其实际用法,包括集成到多智能体应用中。