

什么是 Llama 3.3?
Llama 3.3 是 Meta AI 最新的大语言模型,我们认为它是让先进 AI 更易用于各类项目的一步。它拥有 700 亿参数,性能可与更大的 Llama 3.1 405B 相当,但对硬件的要求显著降低。这意味着我们无需昂贵而专业的配置,也能探索更复杂的 AI 应用。
该模型专为文本输入和输出而设计,因此不处理图像、音频或其他媒体。我们发现它在多语言对话、编码辅助和合成数据生成等任务上尤其有效。它支持包括英语、西班牙语、印地语和德语在内的八种语言,对于需要多语言能力的项目是一个强有力的选择。
让我们印象深刻的是其对效率的关注。Llama 3.3 已针对常见 GPU 进行优化,便于本地部署和实验。它还引入了对齐技术,确保回复既有帮助又安全——这对于敏感型应用至关重要。
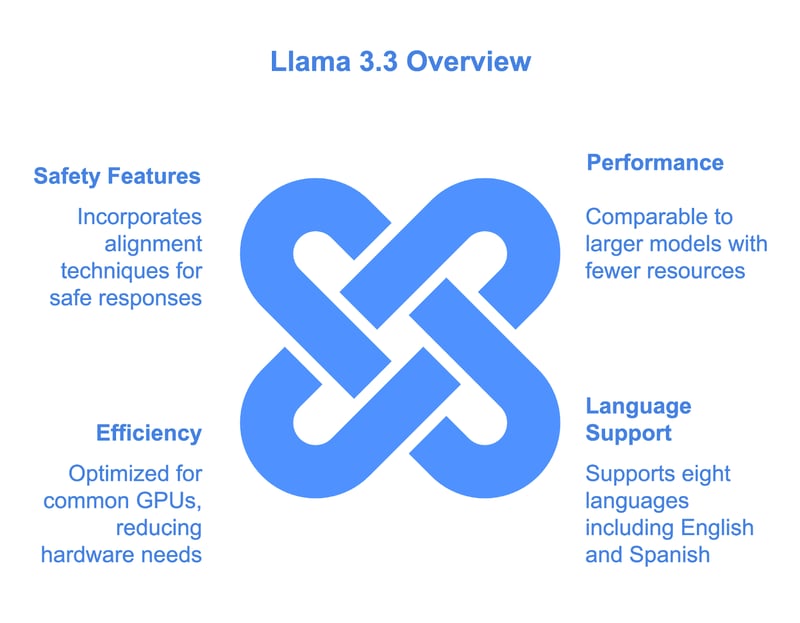
本节我们概述了 Llama 3.3 的基本情况,接下来将更深入地介绍其工作原理、如何上手以及基准表现,帮助您判断它是否适合您的工作。
Llama 3.3 的工作原理
下面是 Llama 3.3 的运行方式,我们尽量用通俗的方式来拆解,无论您是否熟悉大语言模型,都能看懂。
架构:高效且可扩展
Llama 3.3 的核心是基于Transformer 的架构,拥有 700 亿参数。如果您不熟悉,参数本质上是在训练中用来学习文本模式与关系的“旋钮”。正是这些让 Llama 3.3 能生成连贯、符合上下文的回复。
Llama 3.3 的不同之处在于采用了分组查询注意力(GQA)。这使模型能以更少的计算资源更快处理文本。因此,它在硬件要求远低于更大规模的 Llama 3.1 405B 的情况下,仍能取得相近的性能。
训练与微调
像 Llama 3.3 这样的模型,首先通过海量数据进行预训练——来自公开来源的 15 万亿个标记。这为模型提供了广泛的语言与知识理解。
但我们知道,单靠原始训练并不足以让模型在真实场景中好用。这就需要微调:
- 有监督微调(SFT):模型从精心挑选的优质回复示例中学习。可将其视为提供了行为的“黄金标准”。
- 基于人类反馈的强化学习(RLHF):收集人类对模型表现的反馈,并据此进一步优化模型行为。
这种双管齐下的方法确保 Llama 3.3 在有用性与安全性上都更贴近人类期望。
为易得硬件而设计
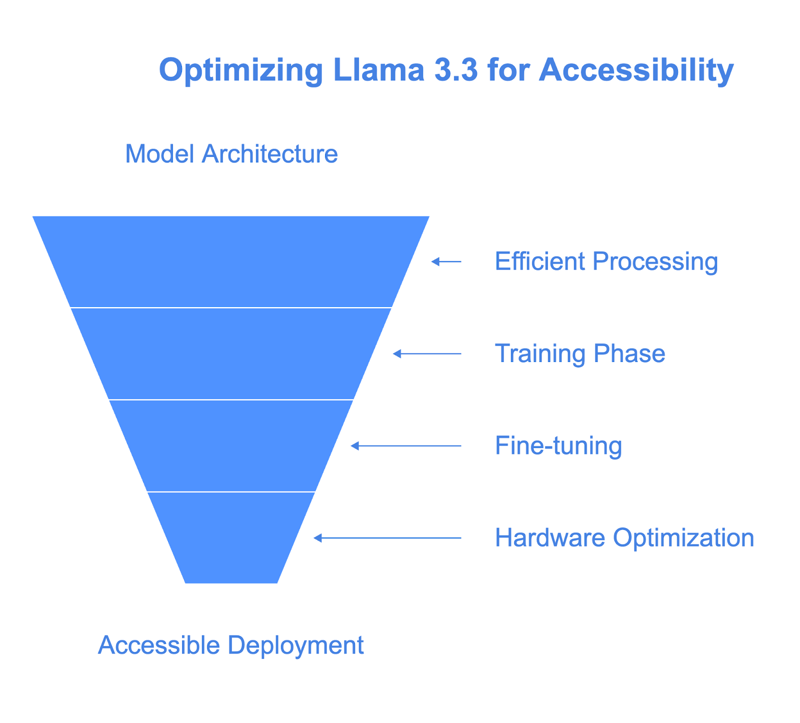
Llama 3.3 旨在本地运行于常见的开发者工作站,对没有企业级基础设施的开发者更为友好。与 Llama 3.1 405B 等更大模型不同,它在保持强劲性能的同时,所需算力大幅降低。
这种高效主要得益于分组查询注意力(GQA),通过降低内存占用、加速推理来优化文本处理。
该模型还支持量化技术,例如通过 bitsandbytes 实现 8 比特和 4 比特精度。这些技术能在性能损失很小的情况下大幅降低内存需求。
此外,它在从单卡到分布式系统的各种硬件配置上都有良好的扩展性,既适合本地实验,也能满足更大规模的部署。
实际而言,这意味着我们可以在更经济的硬件上实验或部署 Llama 3.3,避开通常与先进 AI 模型相伴的高昂成本。对于希望在性能与可及性之间取得平衡的开发者与团队来说,这是一个务实选择。
Llama 3.3 基准测试
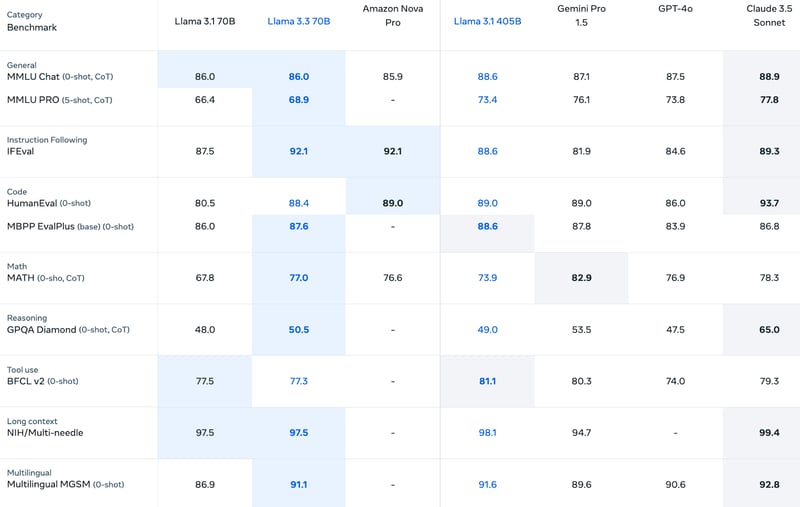
Llama 3.3 在多类基准测试中表现良好,尤其在指令跟随、编码与多语言推理方面表现突出。虽然并不总能超越 Llama 3.1 405B 或 Claude 3.5 Sonnet 等更大模型,但在大多数类别中都提供了稳定且有竞争力的结果。对于寻求兼顾多样任务处理能力与稳健性的开发者而言,Llama 3.3 是一个强有力的选择。
通用知识与推理
在通用知识任务上,Llama 3.3 表现稳健。其在MMLU Chat(0-shot,CoT)上得分 86.0,与前代 Llama 3.1 70B 持平,并与 Amazon Nova Pro(85.9)保持竞争力。但相比更大的 Llama 3.1 405B(88.6)与 Claude 3.5 Sonnet(88.9)略逊一筹。
在更具挑战性的MMLU PRO(5-shot,CoT)基准上,Llama 3.3 以68.9分超过了 Llama 3.1 70B,但仍落后于 Llama 3.1 405B(73.4)与 Claude 3.5 Sonnet(77.8)。
在推理任务中,Llama 3.3 在GPQA Diamond(0-shot,CoT)上获得50.5分,较 Llama 3.1 70B(48.0)略有提升。尽管与 Claude 3.5 Sonnet(65.0)等竞争对手相比仍有差距,但在结构化推理方面展现出进步。
指令跟随
Llama 3.3 在指令跟随任务上表现出色,在IFEval 上得分92.1,衡量的是模型对用户指令的遵循程度。该结果领先于 Llama 3.1 405B(88.6)和 GPT-4o(84.6),并接近 Claude 3.5 Sonnet(89.3)。这也突出体现了其对齐能力,对于聊天机器人和任务型助手等应用至关重要。
编码能力
编码基准是 Llama 3.3 的强项。在HumanEval(0-shot)上得分88.4,略低于 Llama 3.1 405B(89.0),与 Gemini Pro 1.5 大致相当。同样地,在MBPP EvalPlus(base)中取得87.6分,较 Llama 3.1 70B(86.0)略有提升。这些结果验证了其在生成代码和解决编程相关任务方面的有效性。
数学与符号推理
在符号推理方面,Llama 3.3 进步显著。其在MATH(0-shot,CoT)基准上获得77.0分,超过了 Llama 3.1 70B(67.8)与 Amazon Nova Pro(76.6),但仍落后于 Gemini Pro 1.5(82.9)。虽非该类别中的佼佼者,但足以应对许多结构化推理任务。
多语言能力
Llama 3.3 在多语言推理方面表现强劲,在MGSM(0-shot)上得分91.1。相较 Llama 3.1 70B(86.9)有大幅提升,且接近 Claude 3.5 Sonnet(92.8)。这使其成为翻译、全球客服等多语言应用的理想选择。
工具使用与长上下文表现
在工具使用方面,Llama 3.3 在BFCL v2(0-shot)上获得77.3分,与 Llama 3.1 70B(77.5)相当,但低于 Llama 3.1 405B(81.1)。在处理长上下文输入上,其在NIH/Multi-Needle 上得分97.5,与 Llama 3.1 70B 持平,略低于 Llama 3.1 405B(98.1)。这些结果表明它在工具辅助流程和长输入场景中具备强劲能力。
Llama 3.3 的用例
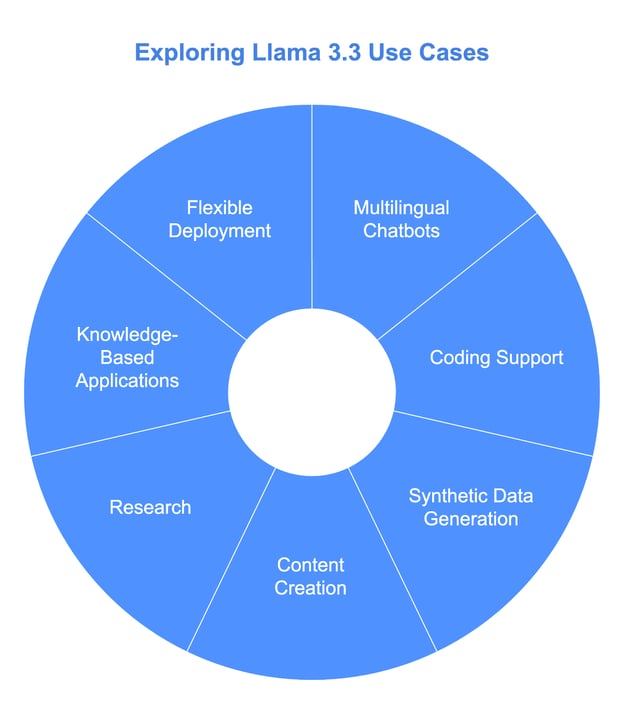
凭借性能与硬件效率的平衡,Llama 3.3 为开发者与研究人员带来了广泛可能。我们欣赏它能在标准开发者工作站上高效运行,使没有企业级基础设施的人也能轻松上手。以下是一些适用领域。
1. 多语言聊天机器人与助手
Llama 3.3 的一大强项是多语言处理。它原生支持包括英语、西班牙语、法语和印地语在内的八种核心语言,非常适合构建多语言聊天机器人或虚拟助手。
让我们注意到的一点是,您无需数据中心即可起步。开发者可以在自有硬件上完成原型与部署,无论是客服、教育工具还是其他对话式应用。
例如,我们可以用 Llama 3.3 创建一个客服聊天机器人,以多种语言解答咨询,同时在单张 GPU 上高效运行。
2. 编码支持与软件开发
凭借在 HumanEval 与 MBPP EvalPlus 等编码基准上的优异得分,Llama 3.3 可作为可靠助手用于生成代码、调试或补全部分脚本。
我们认为其在个人硬件上的良好表现尤为实用。无需依赖昂贵的云系统,您就能在本地运行 Llama 3.3 来自动化重复任务、生成样板代码或创建单元测试。对于团队或独立开发者来说,这让先进的 AI 编码支持既务实又经济。
3. 合成数据生成
Llama 3.3 在合成数据集生成方面同样出色。无论是构建聊天机器人、训练分类器,还是开展 NLP 项目,高质量的标注数据都能节省大量时间与精力。
这一用例对需要特定领域数据、却无力手动采集的小团队尤其有价值。由于 Llama 3.3 可在开发者级硬件上运行,您可以在本地生成数据,从而降低成本并简化流程。
4. 多语言内容创作与本地化
Llama 3.3 的多语言能力也使其适合内容创作。我们看好其在生成本地化营销素材、翻译技术文档或创作多语言博客方面的潜力。开发者可以对模型进行微调,使其语气或风格贴合目标受众。
例如,您可以用 Llama 3.3 起草多语种的产品描述,在无需专职翻译团队的情况下提升本地化效率。
5. 研究与实验
对于研究人员,Llama 3.3 提供了探索语言建模、对齐或微调技术的稳固平台。其吸引力在于高效——您无需庞大的云基础设施也能开展先进 AI 实验。
这使其非常适合学术项目或行业研究,尤其是在探索安全对齐,或通过蒸馏训练更小、更专用的模型时。
6. 基于知识的应用
Llama 3.3 出色的文本处理能力同样适用于问答、摘要与报告生成等应用。这些任务往往需要高效处理大量文本,而 Llama 3.3 即使在个人硬件上也能胜任。
例如,我们可以用它自动总结客户反馈或生成内部文档,在保证准确性的同时节省时间。
7. 面向小团队的灵活部署
最后,我们认为 Llama 3.3 对初创公司、独立开发者或小团队而言是极佳选择,他们希望拥有先进的 AI 能力,却不想承担企业级基础设施的成本。其可在本地服务器乃至单台工作站上运行,使之成为轻量级生产系统的务实方案。
如何获取 Llama 3.3
Meta 通过其官方网站提供 Llama 3.3 的获取方式:Llama Downloads。在这里,您可以找到官方模型卡、许可详情以及其他入门文档的链接。
如需深入指导,我们建议查阅以下官方资源:
- GitHub 上的模型卡与使用说明:Meta GitHub 仓库。
- Hugging Face 模型页面:Llama 3.3-70B on Hugging Face。
这些平台提供了详细文档与社区论坛,您可以在其中提问或解决问题。
Llama 3.3 的定价
在我们看来,这一定价使 Llama 3.3 对预算有限或需要扩展高标记量项目的开发者尤其具有吸引力。无论在本地运行还是通过平台使用,这些有竞争力的价格都确保您以可负担的成本获得高质量 AI。
输入标记成本
每处理 100 万个输入标记,Llama 3.3 的价格为 $0.1,与其前代 Llama 3.1 70B 相同。与其他模型相比,这是最低的费率之一:
- Amazon Nova Pro 收费 $0.80,是相同量级下的 8 倍。
- GPT-4o 与 Claude 3.5 Sonnet 分别为 $2.5 与 $3.0,显著高于 Llama 3.3。
较低的输入成本使 Llama 3.3 尤其适用于需要处理大量文本的应用,如聊天机器人或文本分析工具。
输出标记成本
每 100 万个输出标记,Llama 3.3 的价格为 $0.4,同样与 Llama 3.1 70B 持平。对比如下:
- Amazon Nova Pro 为 $1.8,是 Llama 3.3 的 4 倍多。
- GPT-4o 收费 $10.0,Claude 3.5 Sonnet 收费 $15.0,使 Llama 3.3 在成本上具备显著优势。
对于会生成大量文本的应用,如合成数据创建或内容生成,Llama 3.3 能带来可观的成本节省。
结语
我们认为,Llama 3.3 是大语言模型在能力与可及性之间取得平衡的一个有力例证。
作为一款 700 亿参数的模型,它在计算需求远低于 Llama 3.1 405B 的情况下,仍能提供相当的性能。
对于无法使用企业级硬件的开发者而言,这一模型为其工作流引入高质量 AI 提供了切实可行的途径。
常见问题
Llama 3.3 与 Llama 3.2 有何不同?
Llama 3.3 相比 Llama 3.2 的改进包括更好的微调(SFT 与 RLHF)、更完善的安全特性、多语言支持(8 种语言)、更长的上下文窗口(128k 标记),以及更强的基准表现。它还新增了工具使用能力、提升能效,并提供健全的负责任 AI 框架,使其更强大且更通用。
Llama 3.3 与 Llama 405B 有何不同?
Llama 3.3 提供与 Llama 3.1 405B 相当的性能,但效率显著更高,运行所需的计算能力要少得多。
Llama 3.3 支持哪些语言?
Llama 3.3 原生支持英语、法语、德语、印地语、意大利语、葡萄牙语、西班牙语和泰语。开发者可对其进行微调以支持其他语言,但需要增加相应的安全措施。
Llama 3.3 擅长哪些基准测试?
Llama 3.3 在 MMLU、HumanEval 和 MGSM 等基准中取得高分,在推理、编码和多语言能力等类别上超越了许多其他模型。
Llama 3.3 能在标准开发者硬件上运行吗?
是的。Llama 3.3 旨在运行于常见 GPU 和开发者级工作站上,使没有企业级基础设施的开发者也能轻松使用。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。

作者
Josef Waples
我是数据科学编辑,曾为科学期刊发表的研究论文撰稿。我的兴趣领域包括线性代数、统计学、R 等相关主题。
Meta AI 刚刚发布了 Llama 3.3,这是一款拥有 700 亿参数的模型,性能可与体量更大的 Llama 3.1 405B 相当,但对计算资源的需求要低得多。
我们对此尤为关注,因为它让高质量的 AI 更加易于被没有昂贵硬件的开发者使用。
Llama 3.3 专为基于文本的任务而设计,如多语言对话、编码辅助和合成数据生成;它只处理文本输入和输出——并不适用于图像或音频。
在这篇博文中,我们将带您了解这个模型的亮点,并帮助您判断它是否适合您的项目。