

设置 Azure OpenAI
本节演示如何设置 Azure OpenAI。假定您已具备一定 Azure 使用经验。
请注意,用户界面经常变更。因此,说明和截图中的各部分布局和文案可能会随时间或区域而变化。
步骤 1:创建 Azure 账户
访问 Azure OpenAI 主页,然后选择右上角的登录(Sign in)。使用您的 Microsoft 账户登录。如果您还没有 Microsoft 账户,请在登录页选择创建新账户并完成创建。
然后,按照以下步骤创建 Azure 账户:
- 使用您的 Microsoft 账户登录Azure 门户。选择从 Azure 免费试用开始(Start with an Azure free trial)。
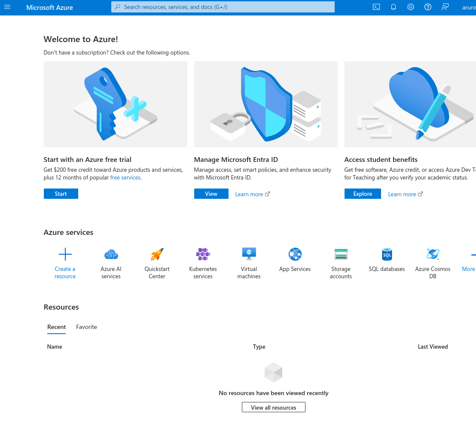
Microsoft Azure 门户。
- 在下一页,选择使用 200 美元免费额度创建Azure 免费账户(Azure free account)。
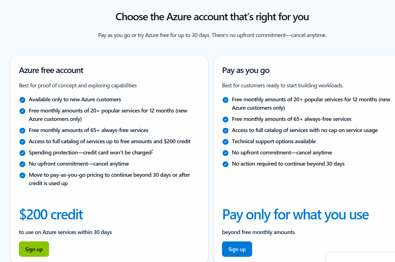
选择 Azure 账户类型。
- 填写表单中的个人信息。
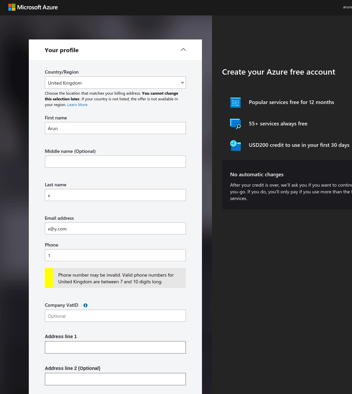
创建免费 Azure 账户。
- 使用信用卡或借记卡验证您的身份。请注意,您的账户可能会出现临时预授权扣款(通常为几美分或等值)。
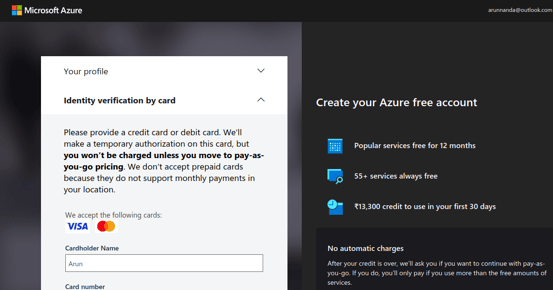
验证您的 Azure 账户(作者截图)
- 验证支付信息后,选择转到 Azure 门户(Go to Azure Portal)。系统将重定向到快速入门中心(Quickstart Center)。
- 请注意,200 美元的免费额度不能用于 Azure OpenAI 服务。只有付费账户才能访问 Azure OpenAI 模型。要将账户升级为按量付费订阅,请返回 Azure 门户并在顶部栏选择升级(Upgrade)。
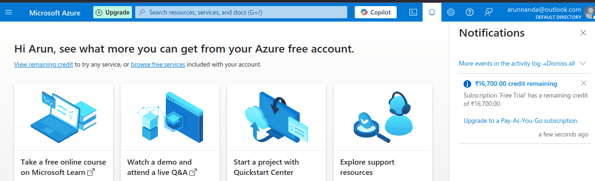
升级您的 Azure 账户。
- 在升级页面填写详细信息并选择升级为按需付费(Upgrade to pay as you go)。
升级为付费账户后,您即可访问 OpenAI 模型。
步骤 2:在 Azure 门户中访问 Azure OpenAI
- 返回 Azure 门户,您将看到多种服务,如 AI 服务、虚拟机、存储账户等。
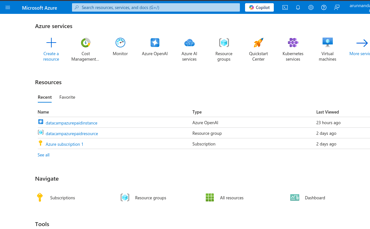
Azure 门户展示可用服务。
- 选择Azure AI services,进入 AI 服务主页。Azure 提供多种基于 AI 的服务,如人脸识别、异常检测、语音、计算机视觉、OpenAI 等。
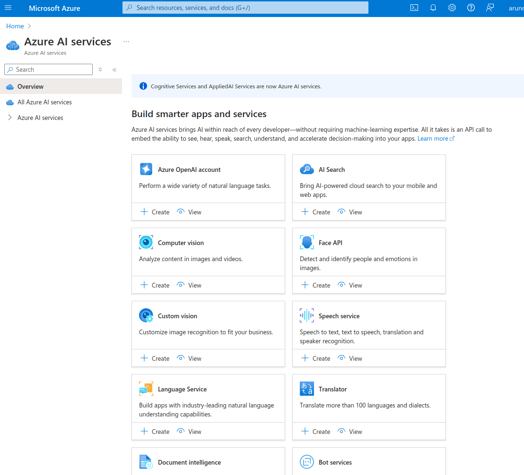
Azure AI 服务。
- 在Azure OpenAI account 选项卡中,选择View。
- 这会进入Azure OpenAI 页面,显示您账户下的 OpenAI 实例列表。选择Create Azure OpenAI 创建新实例。您也可以在上一页选择Create。
- 填写以下信息:
- 在Subscription 下,选择您的付费订阅名称。
- 在Resource group 下,选择Create new:
- 为新的资源组输入名称。
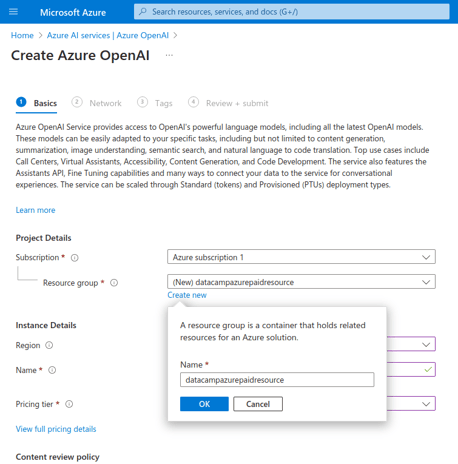
创建新的 Azure OpenAI 实例。
-
-
- 在 Region 下选择距离您最近的区域。
- 在Name 下输入唯一名称。
- 在Pricing tier 下选择Standard S0。
- 选择 Next 继续。
-
- 在Network 部分,选择"All networks, including the Internet, can access this resource." 然后继续下一步。
- 在Tags 部分,输入名称-值对以对该实例进行分类,有助于汇总计费。此步骤可选。
- 在下一部分选择Review + submit,仔细检查各项值并选择Create。这将部署一个新的 OpenAI 实例。
- 片刻之后,将显示消息"Your deployment is complete." 在该页面选择Go to resource。
- 在资源页面中,在Resources 选项卡下选择该资源的名称。
步骤 3:设置 API 访问
资源页面展示该实例的详细信息。
在Develop 选项卡中可查看该实例的 API 密钥和 API 端点 URL。密钥已为您自动生成。
- 将密钥和端点复制到一个文本文件中。
您会获得两个 API 密钥。这样当第一个密钥遭到泄露时,您可以使用第二个密钥;也可以在重新生成第一个密钥时使用第二个密钥。通过这种方式,您可以定期轮换密钥而不影响业务可用性。
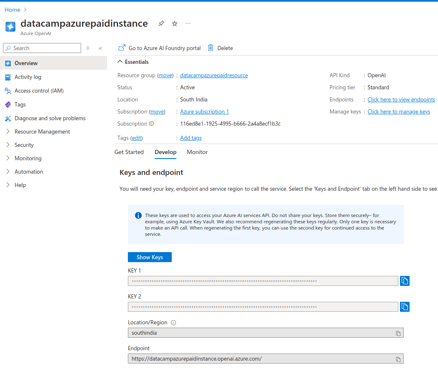
Azure OpenAI 实例 API 密钥
- 在Monitor 选项卡中查看该实例的使用指标。
- 在Get Started 选项卡中选择Explore Azure AI Foundry portal,在新页面打开 AI playground。
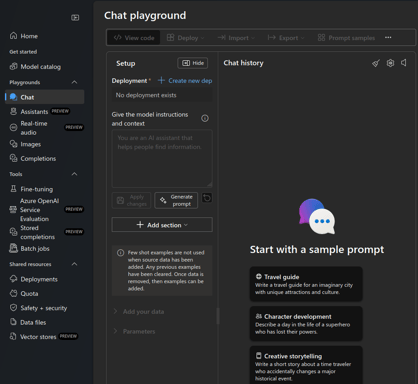
Azure OpenAI 对话 playground。
- 从左侧菜单选择Chat playground。
- 在Deployment 下选择Create new dep。
- 在新部署弹窗中选择From base models。
- 这会显示一个可选择模型的弹窗。
- 在搜索栏输入“gpt-3”。
- 从列表中选择gpt-35-turbo。这是一个经济型、针对对话补全优化的模型。待配置可用后,如有需要可切换到更高级(也更昂贵)的模型。
- 选择Confirm。
- 在Deploy model 弹窗中,选择Customize.
- 将Tokens per Minute Rate Limit 降到较低值(如每分钟 12 次请求)以便手动测试。投入生产后再酌情提高。
- 禁用dynamic quota。只有当部署收到大量流量时才需要启用。
- 选择Deploy。
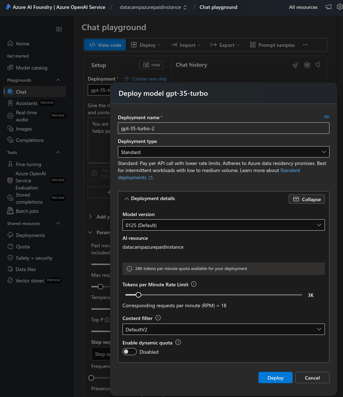
在对话 playground 中部署新模型。
就是这样!下一节我们将看看如何访问此 OpenAI gpt-35-turbo 模型的部署。
重新生成 API 密钥
建议定期重新生成 API 访问密钥。这样即使旧密钥意外泄露,也能降低账户被攻破的风险。以下步骤说明如何重新生成密钥:
- 在左侧菜单的 Resource Management 下,选择 Keys and Endpoint。
- 分别单独重新生成每个密钥。
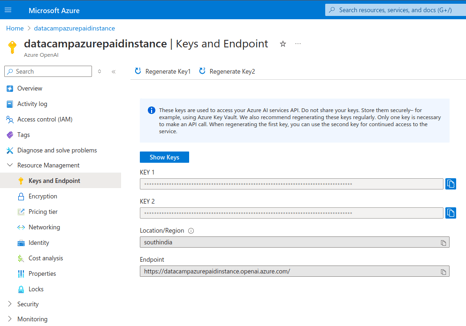
Azure OpenAI 实例 API 密钥。
在应用中使用 Azure OpenAI
在完成 Azure OpenAI 的设置并部署模型后,我们来看看如何以编程方式访问它。
步骤 1:设置开发环境
我将演示如何使用 Python 连接到 Azure OpenAI。安装所需库:
$ pip install openai如果您使用的是笔记本,请执行以下命令。注意:我使用的是DataLab 笔记本。
!pip install openai在 Python 交互式环境或笔记本中导入所需包:
import os
from openai import AzureOpenAIAzureOpenAI 模块用于访问 Azure 内的 OpenAI 服务。这与用于访问独立 OpenAI API 的 OpenAI 模块不同。
在使用 Azure OpenAI 之前,请在您的环境中设置 API 密钥和端点。上一节已展示如何找到这些值。原则上,您可以在编程环境中直接设置这些值,但我建议不要这样做。请不要在程序中暴露 API 密钥。
使用终端设置 API 密钥
如果在本地运行 Python,请在 shell 配置文件中设置环境变量。下面以 Bash shell 为例。
- 用文本编辑器编辑
.bashrc文件。 - 在文件末尾添加以下两行:
export AZURE_OPENAI_API_KEY=MY_API_KEY'export AZURE_OPENAI_ENDPOINT=MY_ENDPOINT'- 保存并关闭文件。
- 在终端中使用
source ~/.bashrc重新加载更改。 - 对于
sh或zsh等其他 shell,流程可能略有不同。 - 在同一终端会话中打开(或重新打开)Python 交互式环境。
在 Python 终端中导入 API 密钥和端点的值:
azure_openai_api_key = os.getenv["AZURE_OPENAI_API_KEY"]
azure_openai_endpoint = os.getenv["AZURE_OPENAI_ENDPOINT"]使用在线笔记本(DataLab)设置 API 密钥
DataLab 允许您直接为笔记本设置环境变量。
- 在顶部菜单栏选择 Environment,并在下拉菜单中选择 Environment variables。
- 选择添加环境变量。
- 添加两个变量
AZURE_OPENAI_API_KEY和AZURE_OPENAI_ENDPOINT,并填写各自的值。 - 为这组环境变量命名并保存更改。
在笔记本中按如下方式提取这些值:
azure_openai_api_key = os.environ["AZURE_OPENAI_API_KEY"]
azure_openai_endpoint = os.environ["AZURE_OPENAI_ENDPOINT"]步骤 2:向 Azure OpenAI 发起首次 API 调用
现在,您可以使用 AzureOpenAI() 函数创建一个可接受请求的 client 对象。此函数使用以下参数:
api_version:Azure OpenAI API 的版本。请从Azure 文档查阅最新版本。api_key:Azure OpenAI 的 API 密钥。请从您先前设置的环境变量获取,不要在此手动设置。azure_endpoint:Azure OpenAI API 端点的 URL(从环境中获取)。
client = AzureOpenAI(
api_version="2024-06-01",
api_key=azure_openai_api_key,
azure_endpoint=azure_openai_endpoint
)使用该 client 对象执行对话补全等任务,方法为 .chat.completions.create()。该函数接收以下参数:
model:模型名称。在较早版本的 OpenAI API 中,此参数曾为engine。注意model参数必须与部署时(在Azure AI Foundry portal)指定的模型一致。如果尝试使用与已部署不同的模型,会出现如下错误:
NotFoundError: Error code: 404 - {'error': {'code': 'DeploymentNotFound', 'message': 'The API deployment for this resource does not exist. If you created the deployment within the last 5 minutes, please wait a moment and try again.'}}messages:该参数指定用户与模型之间的对话,由一组消息对象组成。每个消息对象包含role(取值为system、user或assistant)和content(消息文本)键值对。它们为交互提供上下文并引导模型的回答。
下面给出不同 role 值对应的(role, content)键值对示例:
user:终端用户输入的提示词。
示例:{“role”: “user”, “content”: “explain the difference between rational and irrational numbers”}
system:对 OpenAI 在交互中扮演角色的描述。
示例:{“role”: “system”, “content”: “you are a helpful teacher to guide elementary mathematics students”}
assistant:OpenAI 预期生成的回应。
示例:{“role”: “assistant”, “content”: “the difference between rational and irrational numbers is … an example explanation …”}
仅在提供训练数据对模型进行微调时才需要 assistant 角色。对于对话补全等任务,仅 user 和 system 角色即足够。对于许多简单任务,仅 user 角色就足够了。
max_tokens:该参数决定处理该 API 调用的最大 token 数(包括输入和输出)。费用按使用的 token 直接计费。默认值为 16。对于简单用例,该值已足够,因此可省略。
simple_completion = client.chat.completions.create(
model="gpt-35-turbo",
messages=[
{
"role": "user",
"content": "Explain the difference between OpenAI and Azure OpenAI in 20 words",
},
],
)打印对话补全任务的输出:
print(simple_completion.to_json())输出是一个包含多组键值的 JSON 对象。它包含模型输出,如下例所示。注意,assistant 是分配给模型的默认角色。
"message": {
"content": "OpenAI is a research organization focused on advancing AI, while Azure OpenAI is a collaboration between Microsoft and OpenAI.",
"role": "assistant"
},步骤 3:将 OpenAI 模型用于不同任务
要通过 Azure OpenAI 访问任意模型,您必须先部署该模型。上一节中,您已部署了 gpt-35-turbo 模型。要使用其他模型:
- 返回Azure AI Foundry,按前述方法部署其他模型。可选择多种模型,如 GPT-35、GPT-4o、o1 和 o1-mini、o3 和 o3-mini 等。
- 将上面的提示(在
chat.completions.create()函数中)改写为新模型的名称。
在较早的 OpenAI 版本中,常会针对不同任务使用不同模型,如专用的代码生成、NLP 模型等。现代模型(如 GPT-3.5 和 GPT-4)能够完成所有文本生成类任务。因此,许多早期的任务特定模型(如用于代码生成的 davinci 系列)已逐步淘汰。
下面我们将使用 API 完成一些简单任务,如问答与文本摘要。以下示例使用同一模型——GPT-3.5。您也可以选择某个 GPT-4 模型。
由于这两者都是基于文本的任务,让我们先声明一段要处理的文本。我从某电商网站随意复制了一段关于一双靴子的评论。将该评论文本赋给变量 text。请确保转义文本中的单引号或双引号字符。
text = 'Comfort and Quality wise the boots are absolutely excellent. A 10 miles hike along the city Streets and the alps nearby felt like a smooth sail. The most plus it was quite well ventilated cause of the heavy duty Gore-tex material. After 12 hours when I removed it, there was just very little bit of perspiration (My foot sweats a lot) and absolutely no foul smell. Speaking of the Gore-Tex I would say, I sported this on a heavy rainy day after buying it in India, I was fearing the boot, though not very much like normal boots, would still be drenching with water, instead it was very little soaked. And some 5-6 hours later it was completely dry (Kept inside a closed room in the night). The only disadvantage I think is, that it fits my foot perfectly according to the size I chose, and there is no slight pain from 7 AM till 8 PM due to the shoe weight (of course its 1.2 KG, even though it doesn\'t feel like)' 文本摘要
要对上述文本进行摘要:
- 使用先前创建的
client对象。 - 在
messages参数中传入合适的角色,如下例所示:
summary_completion = client.chat.completions.create(
model="gpt-35-turbo",
messages=[
{
"role": "system",
"content": "You are a helpful assistant for summarizing text"
},
{
"role": "user",
"content": f"Summarize this text in 10 words: {text}",
},
],
)请注意我们如何在提示词中以变量形式传入文本。
print(summary_completion.to_json())输出包含助手对长文本的摘要,如下摘录所示:
"message": {
"content": "Excellent comfort and quality, well-ventilated, quick-drying, lightweight boots, minimal perspiration, no foul smell.",
"role": "assistant"
},问答
要(基于上面的输入文本)回答问题,我们将问题以字符串变量的形式传入提示词。同样,提示词中也包含该文本变量。模型会根据给定文本回答问题。
question = 'Are these shoes heavy?'
qna_completion = client.chat.completions.create(
model="gpt-35-turbo",
messages=[
{"role": "system",
"content": "You are a helpful assistant for answering questions"
},
{
"role": "user",
"content": f"Answer this question: {question} in 10 words based on this text: {text}",
},
],
)将输出转换为 JSON 并打印:
print(qna_completion.to_json())输出包含助手对问题的回答:
"message": {
"content": "Lightweight. Not heavy. Comfortable for long hikes. Well-ventilated Gore-tex material.",
"role": "assistant"
},Azure OpenAI 的使用场景
现在,让我们看看 Azure OpenAI 服务的不同使用场景。
自然语言处理(NLP)
作为语言模型,OpenAI 的通用模型(如 GPT-3 和 GPT-4)擅长以下 NLP 任务:
- 文本摘要:向 API 提供大段文本作为输入,并根据需要要求其进行总结。在前面的示例中,我们将一则冗长的客户评论总结为 10 个词。
- 文本分类:给定文档(或多份文档)与一组预定义标签,OpenAI 能将文档归入最合适的标签。
- 情感分析:API 可分析输入文本以判断情感。例如,可将客户评论归类为正面、负面或中立。
在下面的示例中,我们对先前定义的客户评论文本进行情感分析。
sentiment_classification = client.chat.completions.create(
model="gpt-35-turbo",
messages=[
{"role": "system",
"content": "You are a helpful assistant for classifying customer reviews into one of the following categories: very positive, positive, neutral, negative, very negative"
},
{
"role": "user",
"content": f"Classify this review: {text}",
},
],
#max_tokens=16
)
print(sentiment_classification.to_json())输出包含类似如下摘录的片段,给出助手对该评论的分类:
"message": {
"content": "This review can be classified as very positive.",
"role": "assistant"
},代码生成
OpenAI 模型可以生成多种编程语言的代码。早期版本中有专门的代码模型,如 Codex 与 code-davinci,它们针对代码生成进行了微调。
然而,较新的 OpenAI 版本(如 GPT-3.5 和 GPT-4)无需微调即可生成代码。基础模型在预训练时已使用了代码数据集。因此,Codex、code-davinci 以及其他许多旧版模型已被弃用,不再支持新部署。
OpenAI 模型可协助以多种常见编程语言编写代码。您可以用自然语言与模型交互,为以下编程任务提供指令:
- 生成代码:给定文本提示或注释,模型可生成代码片段。程序员可以将多个片段组合为完整程序,有助于自动化编写样板代码等重复性任务。
- 调试:模型可以分析错误与警告信息,用自然语言解释问题并提出修复建议。
- 优化:OpenAI 模型可帮助将代码重构为更清晰的结构,并为排序等常见任务采用更高效的算法。
- 解释:OpenAI 模型还能解释其生成的代码片段,有助于根据开发者需求进行定制,也能帮助新手理解编程概念。
考虑一个简单示例:编写一个 Python 函数来打开并读取文件。这是足够常见且易于自动化的任务。我们要求 OpenAI 生成并解释代码。使用先前创建的 client 对象。
code_completion = client.chat.completions.create(
model="gpt-35-turbo",
messages=[
{"role": "system",
"content": "You are a helpful assistant for generating programming code"
},
{
"role": "user",
"content": "Write and explain a Python function to open and read a file",
},
],
)打印输出:
print(code_completion.to_json())您会注意到输出的 JSON 对象中包含助手的内容,类似如下示例摘录:
"content": "Below is a Python function that opens a file, reads its contents, and returns the content as a string:\n\n```python\ndef read_file(file_path):\n try:\n with open(file_path, 'r') as file:\n …使用 DALL·E 进行图像生成
前面的示例均为文本类任务,它们将 OpenAI 作为大型语言模型(LLM)使用,通常基于 Transformer 架构。除了 LLM,OpenAI 还包含基于扩散模型的产品,如 DALL·E,可根据输入提示生成图像。
要使用 DALL·E,请提供一段对目标图像的详细文字描述。DALL·E 会基于该描述生成高质量图像。它适用于创作插图、设计产品概念、营销草图等任务。
DALL·E 目前并非在所有地理区域都可用。如果您的区域可用,请像本教程前面所述创建一个新部署,但将模型设为 DALL·E-3 而非 GPT-3。使用与前文相同的 client 对象访问 DALL·E 模型。使用 client.images.generate() 方法生成图像:
- 通过
model参数将模型名称设为dalle3。 - 用
prompt参数描述期望的图像。 - 您还可以指定
n的值,用于生成图像的数量。
result = client.images.generate(
model="dalle3",
prompt="An owl wearing a Christmas hat",
n=1
)从模型的响应中提取 JSON 响应对象:
import json
json_response = json.loads(result.model_dump_json())声明图像目录。请注意,目录 images 必须存在于当前工作目录(您启动 Python 交互式环境的目录)下。
image_dir = os.path.join(os.curdir, 'images')在该目录下指定图像路径:
image_path = os.path.join(image_dir, 'generated_image.png')从 JSON 响应对象中提取生成图像的 URL,下载图像(以流的形式)并写入图像文件:
image_url = json_response["data"][0]["url"]
generated_image = requests.get(image_url).content
with open(image_path, "wb") as image_file:
image_file.write(generated_image)显示图像:
from PIL import Image
image = Image.open(image_path)
image.show()使用 Azure OpenAI 的最佳实践
使用 Azure OpenAI 服务并不复杂,但与任何技术一样,仍有一些最佳实践可供遵循,以获得最佳效果。本节将对此进行回顾。
监控与管理 API 使用
Azure OpenAI 是 Azure 中较昂贵的服务之一。即便是新账户可用的免费额度也不能用于 OpenAI API。因此,即使对于新用户,也必须跟踪用量。未受控的 API 使用可能导致账单意外攀升。
OpenAI 的收费基于 token 的使用与消耗。Token 表示模型处理的文本单元——包括输入与输出。处理一段较大的文本会消耗更多 token,而生成较长的响应也会消耗更多 token。使用的 token 越多,费用越高。因此,请尽量精简传给模型的信息或要求其生成的内容。
使用 max_tokens 参数限制单次请求消耗的 token 数。在生产环境中,请先进行实验以确定请求或用户通常需要多少 token,并据此限制使用量。按实际情况逐步提高上限。
监控基础指标的方法:
- 在 Azure AI Services | Azure OpenAI 主页中,选择要监控的资源。
- 在资源页面选择Monitor 选项卡,以查看多种指标,例如每个模型和每个部署的 HTTP 请求数量与处理的 token 数等。
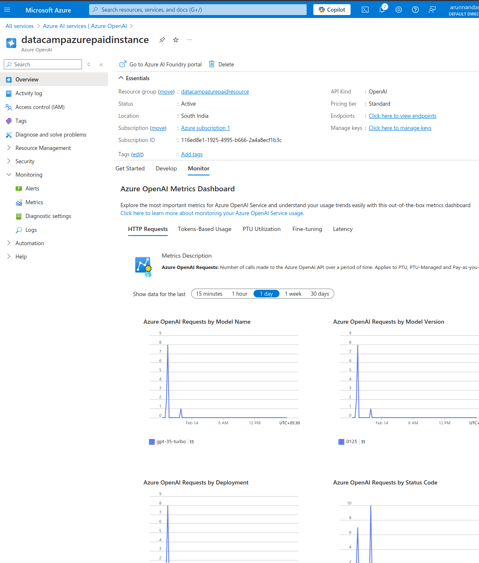
Azure OpenAI 指标仪表板。
您还可以查看更详细的指标:
- 在左侧菜单的Monitoring 中选择 Metrics。
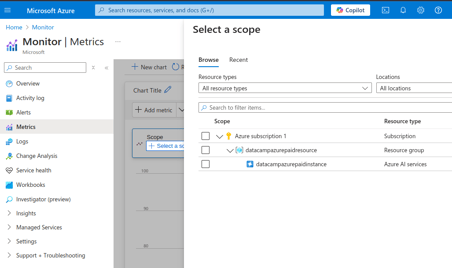
Azure OpenAI 详细指标。
- 在Select a scope 弹窗中,选择 OpenAI 实例(勾选复选框)
- 选择Apply.
在Metrics 页面:
- 在右上角选择时间窗口。
- 在(初始为空的)图表顶部菜单栏,从Metric 下拉菜单选择合适的指标。可选项包括:
- Azure OpenAI 请求数,
- token 使用统计(活动 token、生成 token 等)
- API 调用性能(首字节时间等)等更多指标。
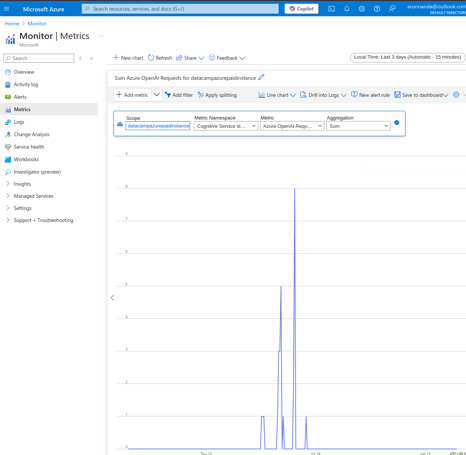
Azure OpenAI 监控示例。
最后,请务必为 API 账户设置预算上限,并配置在超过预算阈值时发送电子邮件提醒。
微调模型
OpenAI 的基础模型在覆盖众多领域的海量数据集上训练。通常有三种方式让 LLM 输出更符合需求:
- 提示工程:对大多数用例,只需在提示中加入更具体的说明即可。这被称为提示工程。
- 小样本学习(few-shot learning):当提示工程不足时,在提示中加入少量示例,帮助模型理解用户期望的回应。这被称为小样本学习,即模型基于少数示例进行学习。
- 微调:有时,您需要就非常小众的领域与模型对话,例如基于某款专业设备的维修手册。关于此类主题的文本往往包含特定术语和语言模式,公共数据集(基础模型的训练数据)中未必覆盖。
如果小样本学习与提示工程仍不足以得到理想结果,您可以对基础模型进行微调。
微调是指在专用数据集上对预训练的基础模型进行再训练。实践中,通常只会对基础模型的一部分层(而非整个模型)在新数据上进行再训练。Azure 微调教程讲解了微调常用 OpenAI 模型的步骤。
请记住,要成功微调基础模型,您需要大量相关且高质量的数据,包含成千上万条训练样本。此外,微调通常涉及较高的前期训练成本。并且,在部署之前,您还需要自费托管该微调模型。
保护您的 API 密钥
公开暴露的 API 密钥可能被滥用以访问敏感信息、执行不安全和/或非法操作,或发起未授权请求,导致账户持有人产生巨额账单。因此,务必妥善管理密钥,避免将其硬编码在源代码中。可采用多种方法:
- 在云服务中,使用 AWS Secrets Manager、Azure Key Vault 等密钥管理工具。
- 使用
.env文件以键值形式存储密钥。将该文件加入.gitignore列表,避免其被提交到代码仓库。 - 对于基于 Jupyter 的笔记本服务,使用环境设置存储密钥。本教程前文已介绍此方法。
建议限制密钥可执行任务的权限。同时,定期轮换或重新生成密钥也很有帮助,以防旧密钥泄露后被滥用。
结语
在本教程中,我们从创建 Azure 账户开始,设置 OpenAI 服务,创建新的 OpenAI 实例并部署模型。随后演示了使用 OpenAI 模型完成一些实用任务。我们还介绍了如何监控 Azure OpenAI 资源的使用与性能。
要更深入地了解 Microsoft Azure,请学习DataCamp Azure Fundamentals 路线。要进一步了解 OpenAI 的核心概念,请学习DataCamp OpenAI Fundamentals 路线。
FAQs
Azure OpenAI 与 OpenAI 有何不同?
Azure OpenAI 允许 Azure 用户在 Azure 平台内访问 OpenAI 模型。这样,Azure 用户无需额外配置和管理另一套软件平台,也更易与其他基于 Azure 的服务集成。
Azure OpenAI 是否支持微调模型?
可以。您可以提供针对特定用例的训练与验证数据集,并用其对基础模型进行微调。
但请注意,微调模型的性能高度依赖训练数据的质量。低质量或不相关的数据会导致其性能不如基础模型。
我可以通过哪些方式访问 Azure OpenAI?
您可以通过两种方式访问 Azure OpenAI 服务——使用 Azure Web 应用,或使用 API。Web 应用的交互方式类似 ChatGPT 网页界面。您也可以通过 API 以编程方式与模型交互,从而将 AI 工具集成到其他应用中。
我可以用哪些语言调用 Azure OpenAI API?
Azure OpenAI 支持多种语言,如 C#、Go、Java、JavaScript、Python 和 REST(HTTP 请求)。由于在数据科学与 AI/ML 领域的流行,Python 是最常用的语言之一。更重要的是,Python 生态包含大量用于处理大规模数据集的工具。
若要与服务端应用集成,请使用与您的应用其他部分相同的语言。
通过 Azure OpenAI 可以访问哪些模型?
Azure OpenAI 可访问的模型包括 GPT-4、GPT-4o、GPT-3.5、DALL-E(文生图)、Whisper(语音转文本)等。当前可用模型列表见Azure 文档。

Azure OpenAI 通过 Azure 云服务平台提供对 OpenAI 模型(如 GPT-4)的访问。
在本教程中,我将介绍 Azure OpenAI 并演示如何开始使用。我们将涵盖如何创建账户、部署 AI 模型,以及如何使用 API 执行多种简单任务。
什么是 Azure OpenAI?
Azure 提供了完整的 Web 服务体系,从SQL 数据库到如 Azure Synapse 等数据仓库与分析方案。许多这些服务的用户需要将 OpenAI 的模型集成进他们的工作流。
访问 OpenAI 模型的传统方式是通过 OpenAI API。Azure OpenAI 则是微软通过 Azure 平台提供的 OpenAI 模型服务。它允许 Azure 用户将 OpenAI 的各类服务(自然语言处理、代码生成、图像生成等)集成到基于 Azure 的基础设施中。
因此,开发者无需学习并接入一个全新的云服务平台。由于基于 Azure 平台,它易于扩展并能处理高负载。使用 Azure 平台的开发者和组织可以用相同且熟悉的界面来配置、管理、监控并为基于 AI 的服务做预算。这也便于合规与支付流程的管理。