数据科学这一不断发展的领域依赖数据而繁荣,但获取大规模、标注完善的数据集常常成为模型开发过程中的重大瓶颈。少样本学习正是在此背景下应运而生,它提供了一种革命性的方法,使我们仅凭寥寥数例就能提取有价值的洞见。
与要求海量数据的传统监督学习方法不同,少样本学习让模型能够快速学习与适应,因而在数据稀缺、采集成本高或具有敏感性的领域尤为重要。
本文将全面探讨少样本学习,深入其重要性、工作机制以及在各行业的多样应用。
什么是少样本学习?
少样本学习(FSL)是机器学习的一个分支,模型通过极少量的训练样本学习识别模式并进行预测。这与传统监督学习形成对比,后者通常需要大量标注数据才能有效训练。
FSL强调“泛化”而非“记忆”。早期代表性工作之一是 Tom B. Brown 等人的论文“Language Models are Few Shot Learners”,它对广泛的微调需求提出了挑战。
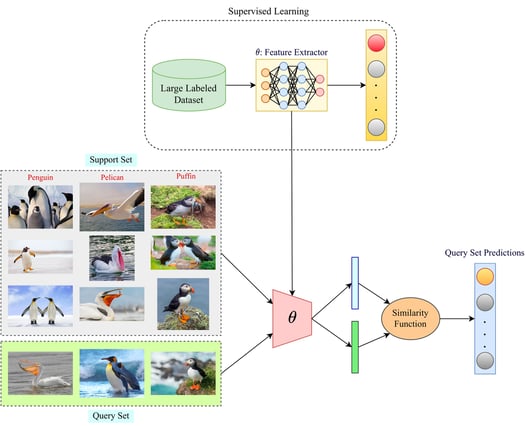
对比监督学习与少样本学习方法的示意图。监督学习部分展示了使用大型标注数据集来训练特征提取器模型;少样本学习部分展示了如何利用小规模的支持集样本和相似度函数来对查询集中的样本进行预测。来源:Paperspace
想象一个孩子学习辨认不同的动物。仅凭少数几张狗、猫和鸟的例子,他们就能很快在之后识别并区分这些生物,即使遇到以前未见过的品种或物种也一样。
从有限数据中进行泛化的能力是人类智能的标志,而少样本学习正是要实现这种能力。
关键在于识别出界定某一类别的底层结构与特征。
人类具备从有限经历中提炼关键信息并将其应用于新情境的先天能力。少样本学习模型尝试通过从以往经验中学习数据的底层结构的一般性理解来模拟这种能力。
随后,这些知识被用来以最少的额外信息快速适应新任务,就像孩子凭借已有的狗的知识识别出新的犬种一样。
少样本学习为何重要?
FSL 使开发者能够将重心放在模型开发而非数据获取上。从有限数据中学习的能力带来多重优势:
- 减少数据采集工作量。FSL 缓解了对海量数据集的需求,节省数据采集与标注的时间与资源。
- 节省算力,因为无需从零训练模型,而是将模型扩展到新的数据类别。
- 缓解数据稀缺。在数据本就稀缺或获取成本高的领域(如罕见疾病、濒危物种),FSL 使模型开发与知识提炼成为可能。
- 提升适应性。FSL 模型能迅速适应新任务与新情境,使其在动态环境中更通用、更稳健。
N-Shot 学习及其变体
少样本学习属于更广泛的n-shot 学习范畴,依据提供样本数量的不同,涵盖多种技术:
- 零样本学习:不给任何示例;模型完全依赖先验知识或描述。
- 一次学习:每个类别仅提供一个示例。
- 二次学习:每个类别提供两个示例进行训练。
- 少样本学习:每个类别仅有少量示例(通常 3 至 10 个)。
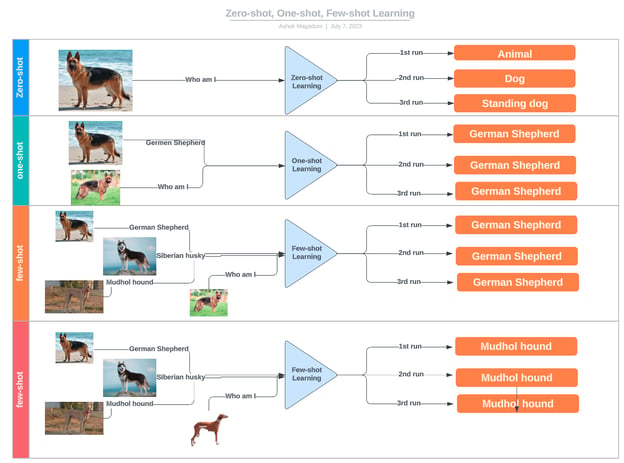
用犬种分类示例说明零样本、一次与少样本学习差异的示意图。来源:LinkedIn
少样本学习如何运作?
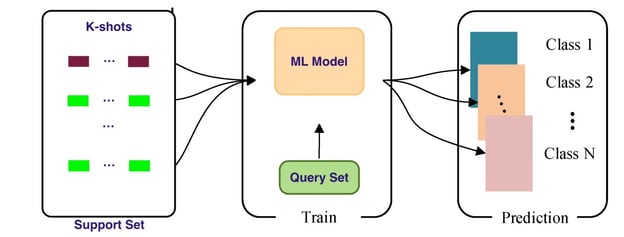
少样本学习流程示意图。图中包含每类 k-shot 的支持集、在查询集上训练的机器学习模型,以及模型对不同类别的新样本进行预测。来源:LinkedIn
不同于依赖大规模训练数据集的传统监督学习,少样本学习模型会利用先验知识与既有学习经验,在仅需极少新增数据的情况下快速适应新任务。通过识别界定概念的底层结构与关键特征,这些模型能够有效泛化,仅凭少量示例就能对新样本做出准确预测。
随后,模型通过相似度函数将查询集与支持集中的类别进行映射,在最少额外信息下快速适应新任务。
作为背景说明,此处的查询集指来自旧类与新类的样本,模型在其上进行泛化并用于评估性能。相对地,支持集由每个新类别的少量标注样本构成,用于更新模型参数:
- 支持集(S): 一小组标注样本,S={(x1,y1),…,(xk,yk)}S = \{(x₁, y₁), \ldots, (xₖ, yₖ)\}S={(x1,y1),…,(xk,yk)},其中每个样本由数据点xixᵢxi及其对应标签yiyᵢyi构成。
- 查询集(Q): 一组未标注的数据点,Q={x1′,…,xm′}Q = \{x'₁, \ldots, x'ₘ\}Q={x1′,…,xm′},模型需为其预测标签。
少样本学习的不同方法
与模型无关的元学习(MAML)
MAML 学习一种通用的模型初始化,仅需少量梯度步就能针对特定任务进行微调。这是一种通用且强大的元学习方法,使模型能以惊人的效率适应新任务。
其优势在于能够学习到一种模型初始化,使得在新任务上仅通过少数几步梯度下降即可快速学习。
这一特性有效地让模型“易于微调”,从而能以极少数据迅速把握新任务的细微差异。
MAML 的核心思想是在学习一组对任务变化高度敏感的初始参数 θ。这种敏感性确保参数的微小调整即可在沿该任务损失函数梯度方向更新时显著改善来自任务分布 p(T) 的任何任务的损失函数。
以下是 MAML 算法的分解:
- 初始化:模型以一组初始参数 θ 开始。
- 任务自适应:对每个从 p(T) 采样的任务 Tᵢ,使用包含 K 个样本的支持集 Sᵢ 通过梯度下降训练模型,得到任务特定参数 θ'ᵢ:其中 α 表示内环(任务特定)更新的学习率。
- 评估:使用适配后的参数 θ'ᵢ 在查询集 Qᵢ 上评估模型表现。
- 元更新:然后用查询集产生的梯度更新初始参数 θ。此更新旨在优化 θ,使其在新任务上经过少量梯度步即可取得最优表现:其中 β 表示外环(元)更新的学习率。
度量学习
度量学习致力于学习一个用于度量数据点间相似性的距离函数。它侧重学习一个距离函数,记作 d(x, x'),用于衡量数据点 x 与 x' 之间的相似性。这样,模型便可以通过与少量已知示例进行比较来对新的数据点进行分类。
- 孪生网络(Siamese networks):使用一对相同的网络来学习输入之间的相似性。
- 匹配网络(Matching networks):利用注意力机制,将查询图像与带标签的支持集进行比较。
- 原型网络(Prototypical networks):为每个类别学习一个原型表示,并根据新样本到这些原型的距离进行分类。
迁移学习
迁移学习利用来自源任务的知识来提升相关目标任务的表现。
- 预训练模型:使用在大型数据集上预训练的模型,并在少样本任务上对其进行微调。
少样本学习的应用
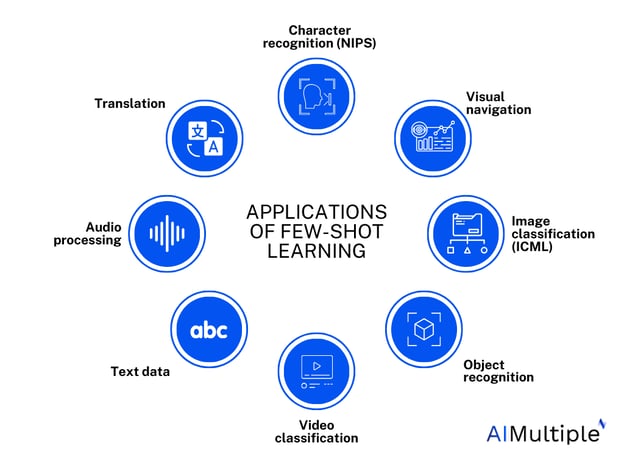
FSL 在各个领域的应用概览。来源:AI Multiple Research
少样本学习的应用广泛而深远,涵盖计算机视觉、自然语言处理、机器人、医疗等诸多领域。例如,在计算机视觉中,少样本学习可以让系统仅用少量训练样本就识别稀有目标,或在医学影像中辨识不常见的模式。
在自然语言处理方面,少样本学习有望推动个性化语言模型的发展,能够模仿个人独特的写作风格或方言,从而革新内容创作与交流。此外,它在保护与翻译低资源语言方面也具有巨大潜力,促进更广泛的文化理解与包容。
也许最具变革性的应用在于药物研发与医疗健康。通过在临床试验或罕见疾病病例的有限数据上训练模型,少样本学习有望加速拯救生命的疗法开发并提升诊断准确性,最终改善患者预后。
挑战与未来方向
尽管潜力巨大,少样本学习也并非没有挑战。首要难题之一是过拟合风险:模型可能对有限训练数据过度专化,无法有效泛化到新样本。此外,选择合适的相似度度量或距离函数对性能至关重要,而任务歧义或噪声数据也会进一步影响模型效果。
不过,这些挑战反而激发了该领域的研究与创新热潮。诸如元学习、度量学习与迁移学习等方法,已成为增强少样本学习能力的有前景策略。与模型无关的元学习(MAML)和原型网络等技术,已展示出在极少数据下快速适应新任务的卓越能力。
随着这一领域持续演进,我们有望看到更为复杂而稳健的少样本学习方法不断涌现,在有限数据条件下拓展 AI 的可能性。归根结底,少样本学习的真正力量在于让 AI 更加大众化,使那些曾受数据稀缺所限的领域与应用也能受益,开启数据高效、适应性强且包容的人工智能新纪元。
结语
少样本学习代表了机器学习领域的重要进步,使我们能够从有限数据中提取洞见。通过理解其多种方法与应用,初级数据从业者也能利用这一强大工具,解决各行业的真实问题。
随着研究不断推进,我们有望迎来更具创新性与更高效的少样本学习技术,进一步拓展数据科学的边界。
如果您希望掌握更多机器学习概念,欢迎查看我们的Python 机器学习科学家职业路径。

数据科学这一不断发展的领域依赖数据而繁荣,但获取大规模、标注完善的数据集常常成为模型开发过程中的重大瓶颈。少样本学习正是在此背景下应运而生,它提供了一种革命性的方法,使我们仅凭寥寥数例就能提取有价值的洞见。
与要求海量数据的传统监督学习方法不同,少样本学习让模型能够快速学习与适应,因而在数据稀缺、采集成本高或具有敏感性的领域尤为重要。
本文将全面探讨少样本学习,深入其重要性、工作机制以及在各行业的多样应用。
什么是少样本学习?
少样本学习(FSL)是机器学习的一个分支,模型通过极少量的训练样本学习识别模式并进行预测。这与传统监督学习形成对比,后者通常需要大量标注数据才能有效训练。
FSL强调“泛化”而非“记忆”。早期代表性工作之一是 Tom B. Brown 等人的论文“Language Models are Few Shot Learners”,它对广泛的微调需求提出了挑战。
对比监督学习与少样本学习方法的示意图。监督学习部分展示了使用大型标注数据集来训练特征提取器模型;少样本学习部分展示了如何利用小规模的支持集样本和相似度函数来对查询集中的样本进行预测。来源:Paperspace
想象一个孩子学习辨认不同的动物。仅凭少数几张狗、猫和鸟的例子,他们就能很快在之后识别并区分这些生物,即使遇到以前未见过的品种或物种也一样。
从有限数据中进行泛化的能力是人类智能的标志,而少样本学习正是要实现这种能力。
关键在于识别出界定某一类别的底层结构与特征。
人类具备从有限经历中提炼关键信息并将其应用于新情境的先天能力。少样本学习模型尝试通过从以往经验中学习数据的底层结构的一般性理解来模拟这种能力。
随后,这些知识被用来以最少的额外信息快速适应新任务,就像孩子凭借已有的狗的知识识别出新的犬种一样。
少样本学习为何重要?
FSL 使开发者能够将重心放在模型开发而非数据获取上。从有限数据中学习的能力带来多重优势:
N-Shot 学习及其变体
少样本学习属于更广泛的n-shot 学习范畴,依据提供样本数量的不同,涵盖多种技术:
用犬种分类示例说明零样本、一次与少样本学习差异的示意图。来源:LinkedIn
少样本学习如何运作?
少样本学习流程示意图。图中包含每类 k-shot 的支持集、在查询集上训练的机器学习模型,以及模型对不同类别的新样本进行预测。来源:LinkedIn
不同于依赖大规模训练数据集的传统监督学习,少样本学习模型会利用先验知识与既有学习经验,在仅需极少新增数据的情况下快速适应新任务。通过识别界定概念的底层结构与关键特征,这些模型能够有效泛化,仅凭少量示例就能对新样本做出准确预测。
随后,模型通过相似度函数将查询集与支持集中的类别进行映射,在最少额外信息下快速适应新任务。
作为背景说明,此处的查询集指来自旧类与新类的样本,模型在其上进行泛化并用于评估性能。相对地,支持集由每个新类别的少量标注样本构成,用于更新模型参数:
少样本学习的不同方法
与模型无关的元学习(MAML)
MAML 学习一种通用的模型初始化,仅需少量梯度步就能针对特定任务进行微调。这是一种通用且强大的元学习方法,使模型能以惊人的效率适应新任务。
其优势在于能够学习到一种模型初始化,使得在新任务上仅通过少数几步梯度下降即可快速学习。
这一特性有效地让模型“易于微调”,从而能以极少数据迅速把握新任务的细微差异。
MAML 的核心思想是在学习一组对任务变化高度敏感的初始参数 θ。这种敏感性确保参数的微小调整即可在沿该任务损失函数梯度方向更新时显著改善来自任务分布 p(T) 的任何任务的损失函数。
以下是 MAML 算法的分解:
度量学习
度量学习致力于学习一个用于度量数据点间相似性的距离函数。它侧重学习一个距离函数,记作 d(x, x'),用于衡量数据点 x 与 x' 之间的相似性。这样,模型便可以通过与少量已知示例进行比较来对新的数据点进行分类。
迁移学习
迁移学习利用来自源任务的知识来提升相关目标任务的表现。
少样本学习的应用
FSL 在各个领域的应用概览。来源:AI Multiple Research
少样本学习的应用广泛而深远,涵盖计算机视觉、自然语言处理、机器人、医疗等诸多领域。例如,在计算机视觉中,少样本学习可以让系统仅用少量训练样本就识别稀有目标,或在医学影像中辨识不常见的模式。
在自然语言处理方面,少样本学习有望推动个性化语言模型的发展,能够模仿个人独特的写作风格或方言,从而革新内容创作与交流。此外,它在保护与翻译低资源语言方面也具有巨大潜力,促进更广泛的文化理解与包容。
也许最具变革性的应用在于药物研发与医疗健康。通过在临床试验或罕见疾病病例的有限数据上训练模型,少样本学习有望加速拯救生命的疗法开发并提升诊断准确性,最终改善患者预后。
挑战与未来方向
尽管潜力巨大,少样本学习也并非没有挑战。首要难题之一是过拟合风险:模型可能对有限训练数据过度专化,无法有效泛化到新样本。此外,选择合适的相似度度量或距离函数对性能至关重要,而任务歧义或噪声数据也会进一步影响模型效果。
不过,这些挑战反而激发了该领域的研究与创新热潮。诸如元学习、度量学习与迁移学习等方法,已成为增强少样本学习能力的有前景策略。与模型无关的元学习(MAML)和原型网络等技术,已展示出在极少数据下快速适应新任务的卓越能力。
随着这一领域持续演进,我们有望看到更为复杂而稳健的少样本学习方法不断涌现,在有限数据条件下拓展 AI 的可能性。归根结底,少样本学习的真正力量在于让 AI 更加大众化,使那些曾受数据稀缺所限的领域与应用也能受益,开启数据高效、适应性强且包容的人工智能新纪元。
结语
少样本学习代表了机器学习领域的重要进步,使我们能够从有限数据中提取洞见。通过理解其多种方法与应用,初级数据从业者也能利用这一强大工具,解决各行业的真实问题。
随着研究不断推进,我们有望迎来更具创新性与更高效的少样本学习技术,进一步拓展数据科学的边界。
如果您希望掌握更多机器学习概念,欢迎查看我们的Python 机器学习科学家职业路径。