

什么是 GPT-4 Vision?
GPT-4 Vision(GPT-4V)是一种多模态模型,允许用户上传图像作为输入,并与模型进行对话。对话可以包含以提示形式提出的问题或指令,引导模型基于图像输入执行相应任务。
GPT-4V 模型构建在 GPT-4 既有能力之上,除了文本交互外,还提供视觉分析功能。我们已介绍过一份面向初学者的 OpenAI API 入门指南,可帮助您快速了解 GPT-4V 发布前的相关进展。
GPT-4 Vision 的核心能力
- 视觉输入:新发布的 GPT-4 Vision 的关键特性在于,它现在可以接受照片、截图和文档等视觉内容并执行多种任务。
- 目标检测与分析:模型可以识别图像中的对象并提供相关信息。
- 数据分析:GPT-4 Vision 擅长解读与分析以图形、图表和其他可视化形式呈现的数据。
- 文字识别与解读:模型能够读取并解读图像中的手写笔记和文本。
了解了 GPT-4 Vision 的部分能力后,让我们亲自上手,获得更直观的体验。
动手实践:开始使用 GPT-4 Vision
截至 2023 年 10 月,GPT-4 Vision 目前仅向 ChatGPT Plus 和 Enterprise 用户开放。ChatGPT Plus 订阅费用为每月 20 美元,您可以从免费的 ChatGPT 账户升级。
如果您对 ChatGPT 完全陌生,以下是访问 GPT-4 Vision 的方法:
- 访问 OpenAI ChatGPT 网站并注册账号。
- 登录账户,进入“Upgrade to Plus”(升级到 Plus)。
- 完成升级以获得 ChatGPT Plus 的访问权限(注意:这是每月 20 美元的订阅)。
- 在聊天窗口中选择“GPT-4”作为您的模型,如下图所示。
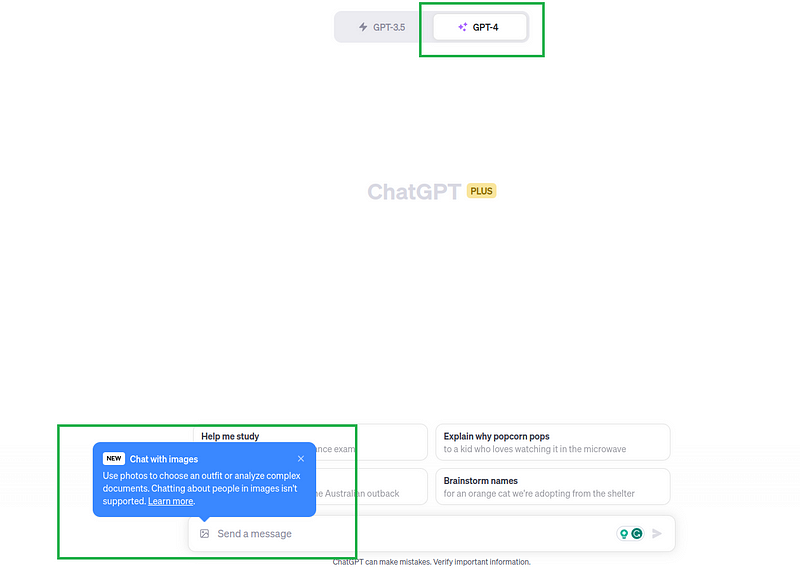
- 点击图片图标上传图像,并添加提示,指示 GPT-4 执行相应任务。
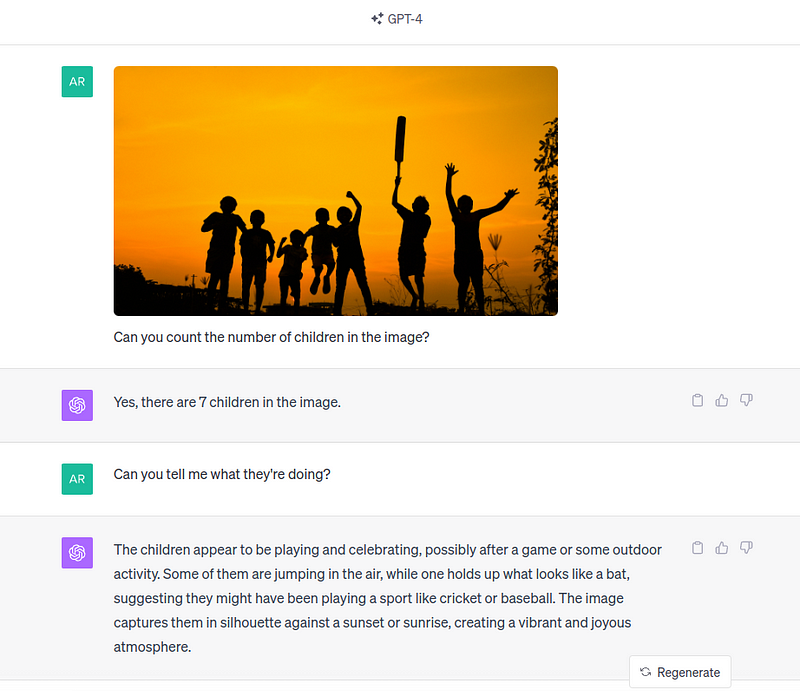
此处,GPT-4 Vision 能相当准确地根据孩子手中的球棒判断他们在打板球。在 AI 领域,这类任务称为目标检测,其中识别到的对象是孩子和球棒。欢迎查看我们的YOLO 目标检测教程了解更多。
同样地,您也可以根据自己的使用场景执行不同的任务。
GPT-4 Vision 的真实用例与示例
理解其能力后,让我们将其拓展到一些行业中的实际应用:
1. 学术研究
GPT-4 Vision 将先进的语言建模与视觉能力相结合,为学术领域带来新可能,尤其是在解读历史手稿方面。此类工作传统上需要经验丰富的古文字学家和历史学者进行细致而耗时的处理。
我们先提供一张看起来像是老报纸文章片段的图像:
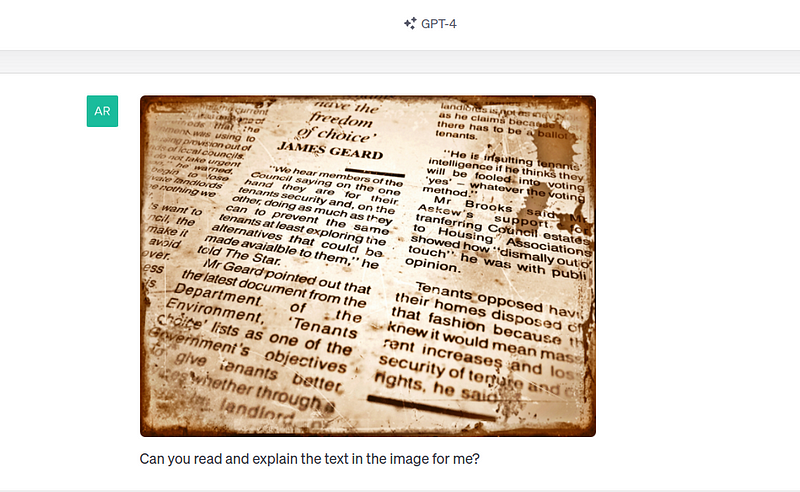
GPT-4 Vision 能较好地读取并解读图像内容:
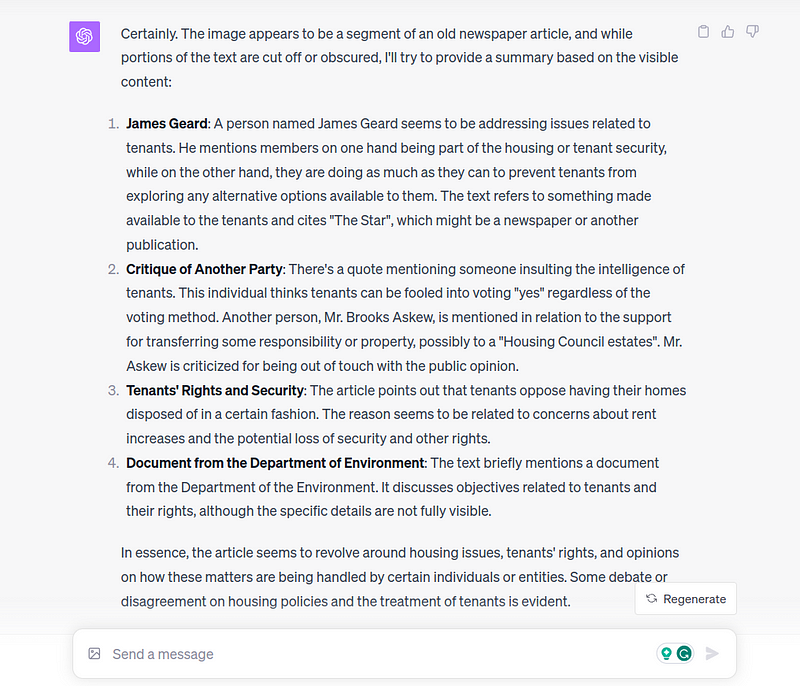
模型能够读取、破译内容并给出分析,同时也会现实地指出图像有部分缺失和遮挡。
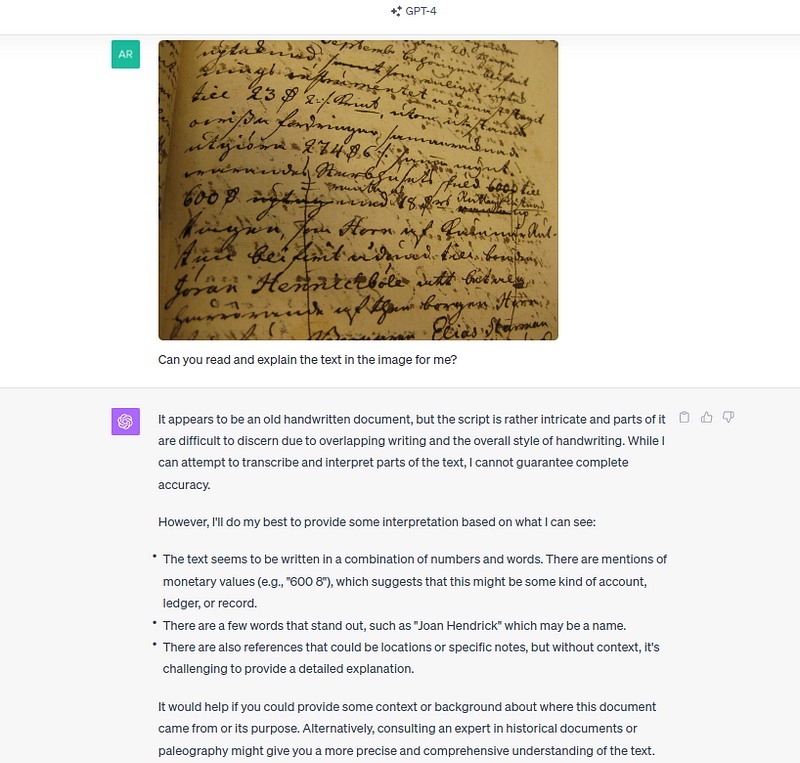
不过,同样需要注意的是,当给出复杂手稿,尤其是其他语言的手稿时(下文会提到更多),模型会显得吃力,如下所示:
2. 网站开发
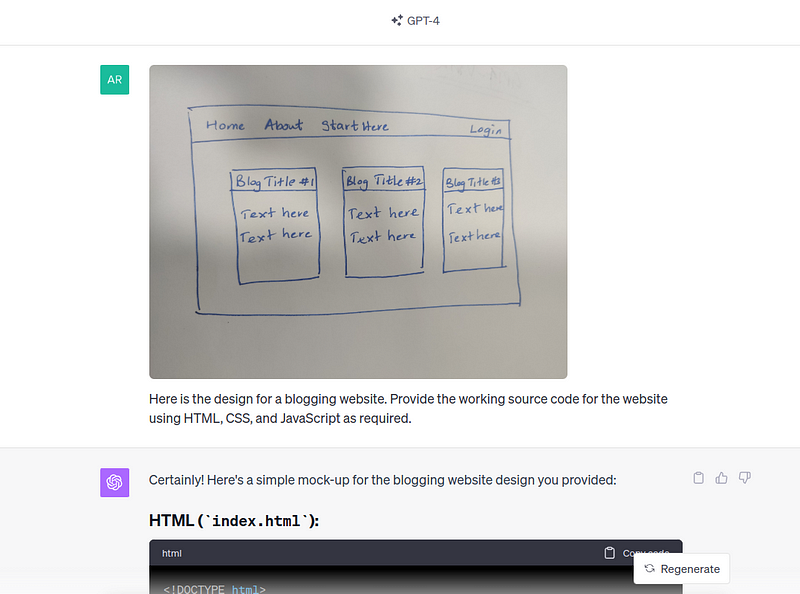
GPT-4 Vision 在提供所需设计的视觉图像后,可以为网站编写代码。它能从视觉设计直接生成网站的源代码。这一能力可大幅缩短构建网站所需的时间。
让我们用一张手绘的简易博客网站设计图来提示 GPT-4 Vision。
在它提供源代码后,我们只需按指示复制粘贴,创建 HTML 和 CSS 文件。网站效果如下:
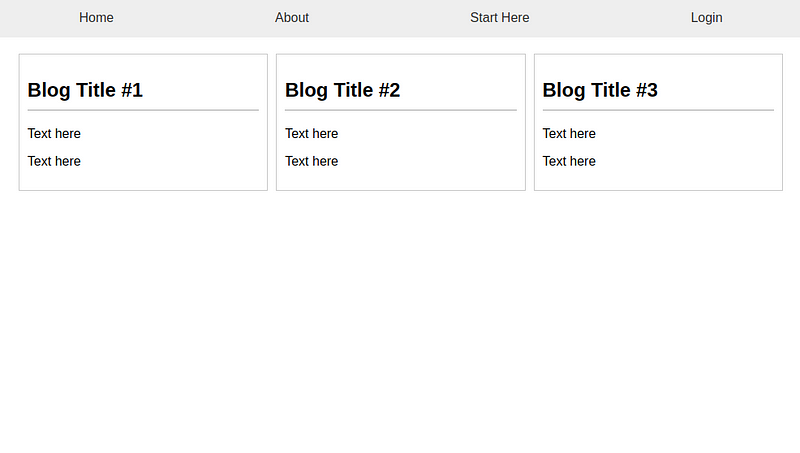
看起来是不是非常相似?当然,这里只是一个简单示例,但得益于新引入的 GPT-4 Vision 模型,您可以在此基础上,以更短时间开发更复杂、更贴合需求的网站。
3. 数据解读
该模型能够分析数据可视化,解读底层数据,并基于图形提供关键信息。为测试这一功能,我们可以直接给出一张图并请求洞见。
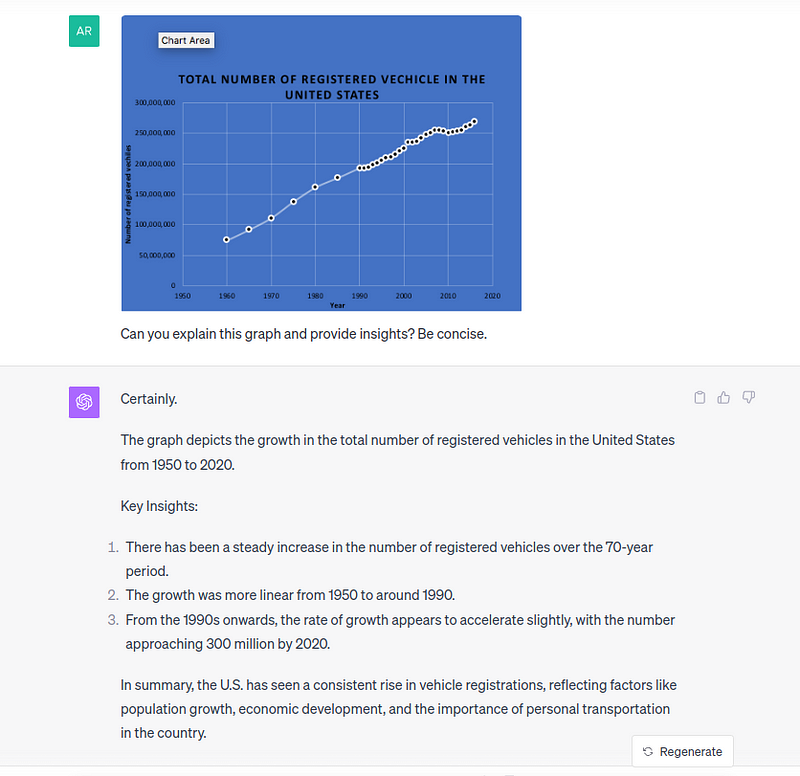
虽然它对图表的整体背景和线性趋势理解得不错,但也会出错,比如提到起始年份为 1950,而数据点其实从 1960 年才开始。模型还推断了人口增长和经济发展等因素——这些也许属实,但仅凭这张图并不能得出这些结论。
我们可以通过多轮追问来细化 GPT-4 Vision 的初始输出。根据我们的测试,在数据解读类用例中,仍然需要“人参与”的复核,而模型则可提升整体效率。
4. 创意内容创作
自 ChatGPT 面世以来,社交媒体上涌现出各种提示工程技巧,许多人找到了出人意料且富有创意的使用方式。
在本教程中,我们将把 DALL-E-3(在 ChatGPT Plus 中同样可用)与 GPT-4 Vision 结合,用于创作一条社交媒体帖子。
步骤 1:请 GPT-4 生成用于出图的提示词。比如,您想做一条对比初创公司与大型企业中数据科学家角色差异的帖子。
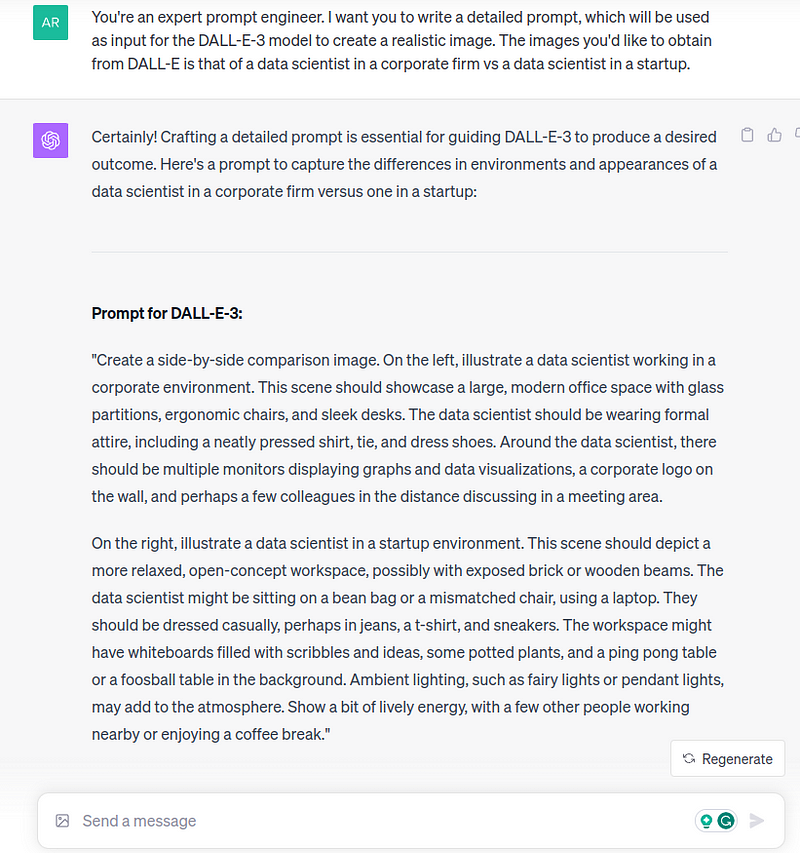
步骤 2:使用该提示词在 DALL-E 中生成图像。您可以不断微调提示词,直到对输出满意为止。
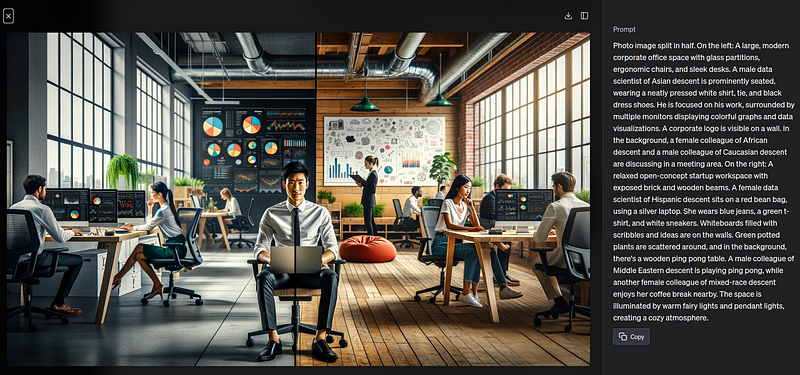
步骤 3:用这张图,请 GPT-4 Vision 生成一段配图文案。
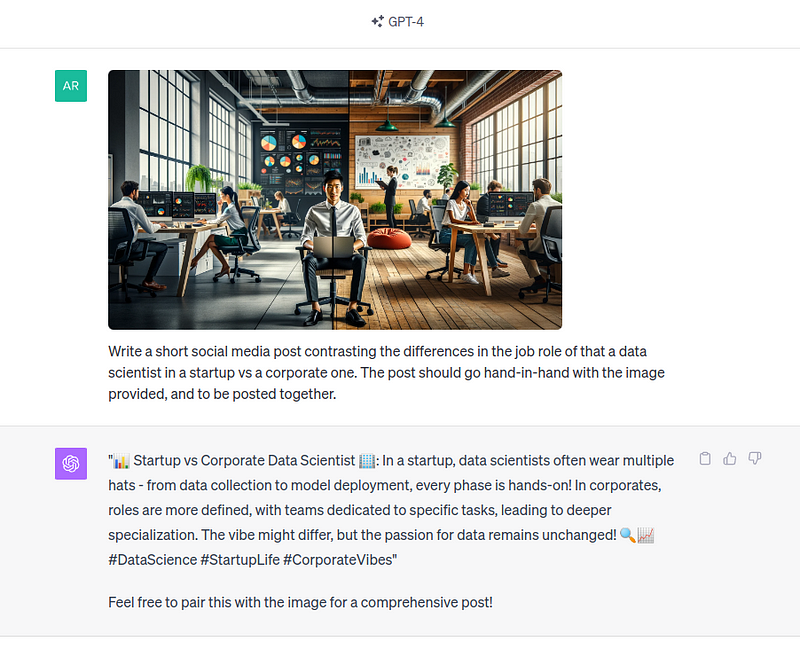
通过微调并提供更详细的提示词,可以获得更好的输出,从而进一步探索创意内容的生成。需要注意的是,不建议用 AI 生成内容在互联网上或社交媒体上进行刷屏,因为这类内容自有其局限。相反,请进行事实核查,并结合您的亲身经验进行打磨。
当然,这并不是可能用例的穷尽——GPT-4 Vision 的能力远不止于此。请将其视作启发和起点,把这项技术应用到您所选领域,尽情探索好奇心。
GPT-4 Vision 的局限与风险缓解
在将 GPT-4 Vision 用于实际场景之前,还有最后一件重要的事——了解它的局限与相关风险。
这点尤为重要,因为自 2023 年 3 月 GPT-4 发布后,OpenAI 又花了数月时间,通过内部与外部的“红队”演练来测试这项生成式技术的短板,并在系统卡片中进行了说明。
1. 准确性与可靠性
虽然 GPT-4 在可靠性与准确性方面取得了显著进步,但并非总是如此。根据 OpenAI 的内部测试,GPT-4 Vision 仍可能在某些时候不可靠或不准确。团队甚至在我们输入文本与图像时,会在聊天栏下方提示“ChatGPT 可能会出错。请核实重要信息。”
因此,用户务必对模型输出进行批判性评估并保持警惕。
2. 隐私与偏见问题
据 OpenAI 所述,与其前代模型类似,GPT-4 Vision 依然会强化社会偏见与世界观,包括对某些边缘群体的有害刻板印象与贬低性关联。因此,务必要理解这一局限,并在具体用例中采取必要措施来应对偏见,而不是指望模型自行解决。
除了偏见问题,与 ChatGPT 共享的数据可能会被用于训练模型,除非选择退出;因此,务必注意不要与模型共享任何敏感或私密信息。用户也可以在“Settings & Beta(设置与测试)”下的“Data Controls(数据控制)”中选择不共享用于改进模型的数据。
3. 高风险任务的限制
GPT-4 Vision 无法回答要求识别图像中特定个人的问题。这是一种符合预期的“拒绝”行为。此外,OpenAI 建议避免在高风险任务中使用 GPT-4 Vision,包括:
- 科学严谨性:模型可能漏读文本或字符、忽略科学信息图像中的数学符号,且无法正确识别空间位置与颜色映射。
- 医疗建议:模型在基于医学影像回答问题时有时正确、有时失误。鉴于其回答不一致,不应将模型的答案或输出视为专业医疗建议的替代。
- 虚假信息风险:当陈述附带图像时,人们往往更容易相信其内容(不论真伪)。模型可以基于图像输入生成看似合理、真实且具有针对性的文本内容,因此存在被用于传播虚假信息的风险。
- 仇恨内容:在某些情况下,模型会拒绝回应包含仇恨符号和极端主义内容的问题,但并非总是如此。这仍是 OpenAI 面临的难题。
因此,作为用户,我们需要负责任地使用 GPT-4 Vision,尤其是在上述高风险任务和敏感情境中保持警惕。
总结
本教程为您全面介绍了新发布的 GPT-4 Vision 模型。我们也提醒了模型的局限性与潜在风险,帮助您了解如何以及何时使用它。
掌握新技术最实际的方式,就是亲手尝试,提供多样的提示来评估其能力;随着时间推移,您会愈发驾轻就熟。
尽管这是一款相对较新的工具(发布仅一个月),但其构建基于大语言模型与 GPT-4 的原理。以下是一些相关资源,便于您深入理解 GPT-4 Vision 的基础与相关概念:

作为一名高级数据科学家,我设计、开发并部署大规模机器学习解决方案,帮助企业做出更明智的数据驱动决策。作为数据科学写作者,我分享所学心得、职业建议以及深入的实践型教程。
在 ChatGPT 发布、人工智能热潮涌动之际,OpenAI 推出了具备卓越生成式 AI 能力的旗舰产品——GPT-4。在 2023 年 3 月的发布会上,OpenAI 提到了通过 GPT-4 实现多模态生成式 AI 的可能性。生成式 AI 的多模态性,指的是系统能够处理、理解和/或为不止一种数据类型生成输出的能力。
在数月的沉寂之后,2023 年 9 月,OpenAI 将这一多模态能力带到了 ChatGPT,使其能够“看、听、说”,这意味着图像与语音功能已向 ChatGPT 开放。多模态 AI 系统一旦成熟,预计将为多个行业解锁新的可能性与创新。
在本教程中,我们将介绍图像能力并认识让 ChatGPT 能够“看见”的 GPT-4 Vision 模型。最后我们还将了解该模型当前的局限性,并提供进一步学习资源。