
Khóa học
Tìm hiểu ChatGPT
1 giờ
438.2K
GPT-4 Vision (GPT-4V) là một mô hình đa phương thức cho phép người dùng tải lên một hình ảnh làm đầu vào và trò chuyện với mô hình. Cuộc trò chuyện có thể bao gồm các câu hỏi hoặc hướng dẫn dưới dạng prompt, yêu cầu mô hình thực hiện các tác vụ dựa trên đầu vào là hình ảnh.
Mô hình GPT-4V được xây dựng dựa trên các khả năng sẵn có của GPT-4, bổ sung phân tích trực quan bên cạnh tính năng tương tác văn bản hiện có. Chúng tôi đã có phần giới thiệu thân thiện với người mới về OpenAI API giúp bạn bắt kịp những phát triển trước khi GPT-4V ra mắt.
Giờ khi đã nắm một số khả năng của GPT-4 Vision, hãy thực hành để tự mình trải nghiệm rõ hơn.
Hiện tại (tính đến tháng 10/2023), GPT-4 Vision chỉ khả dụng cho người dùng ChatGPT Plus và Enterprise. ChatGPT Plus có giá 20 USD/tháng, bạn có thể nâng cấp từ tài khoản ChatGPT miễn phí thông thường.
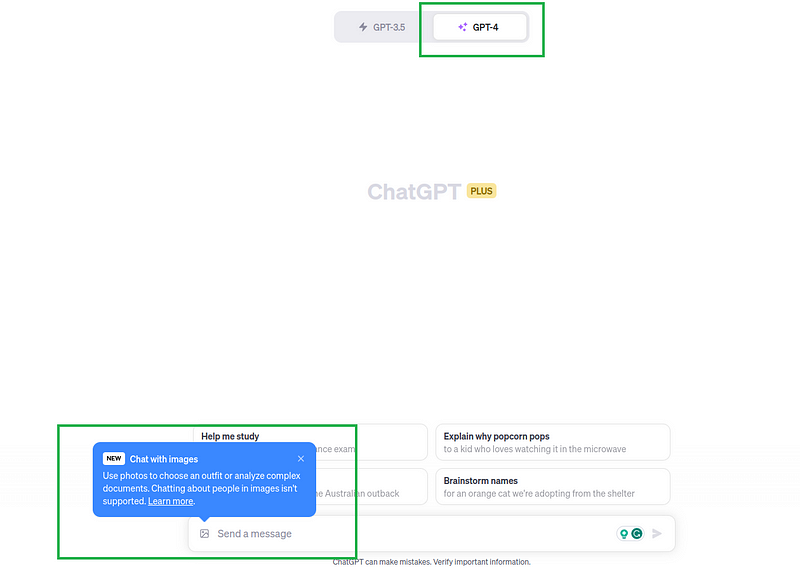
Nếu bạn hoàn toàn mới với ChatGPT, sau đây là cách truy cập GPT-4 Vision:
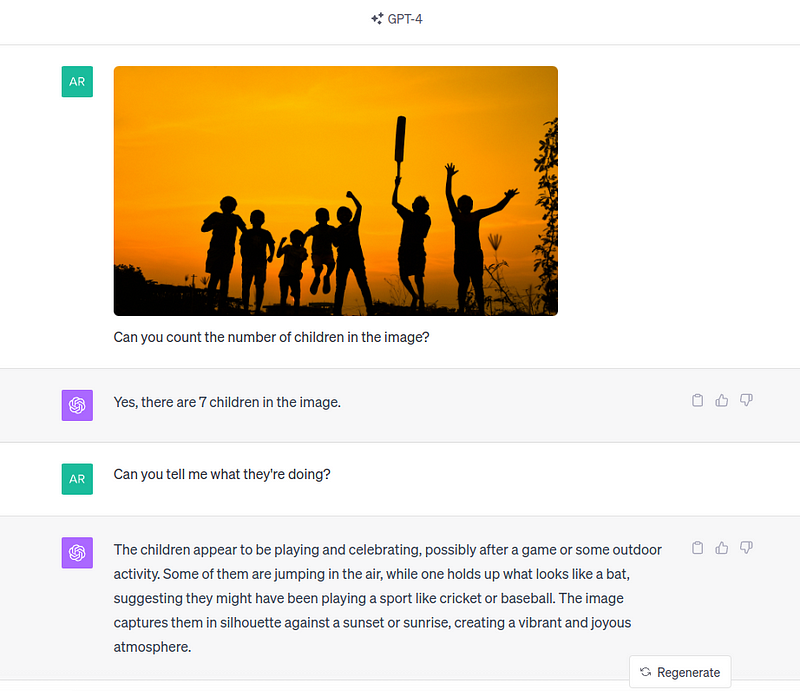
Ở đây, GPT-4 Vision làm khá tốt việc hiểu rằng bọn trẻ đang chơi cricket dựa trên cây gậy trong tay một đứa trẻ. Trong thế giới AI, tác vụ này được gọi là nhận diện đối tượng, trong đó các đối tượng được nhận dạng là những đứa trẻ và cây gậy. Xem hướng dẫn về nhận diện đối tượng YOLO để tìm hiểu thêm.
Tương tự, bạn có thể tiếp tục thực hiện các tác vụ khác phù hợp hơn tùy theo mục đích sử dụng.
Giờ khi đã hiểu các khả năng của nó, hãy mở rộng sang một số ứng dụng thực tiễn trong ngành:
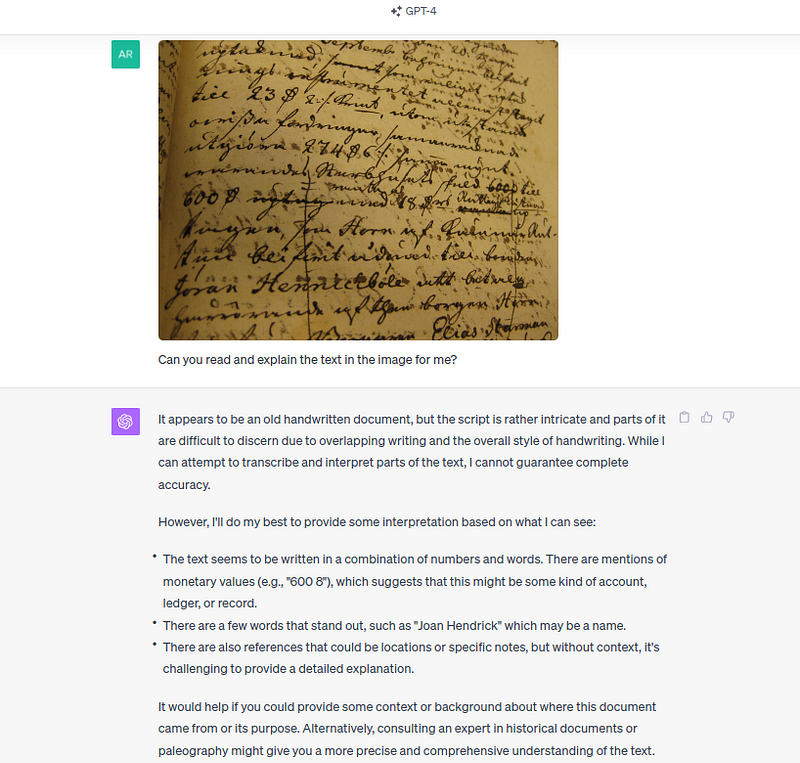
Việc GPT-4 Vision tích hợp mô hình ngôn ngữ tiên tiến với khả năng thị giác mở ra những khả năng mới trong các lĩnh vực học thuật, đặc biệt là trong việc giải mã các bản thảo lịch sử. Nhiệm vụ này vốn dĩ tỉ mỉ và tốn nhiều thời gian, do các nhà cổ tự học và sử gia giàu kinh nghiệm thực hiện.
Trước hết, chúng ta cung cấp một hình ảnh có vẻ là một phần của bài báo cũ:
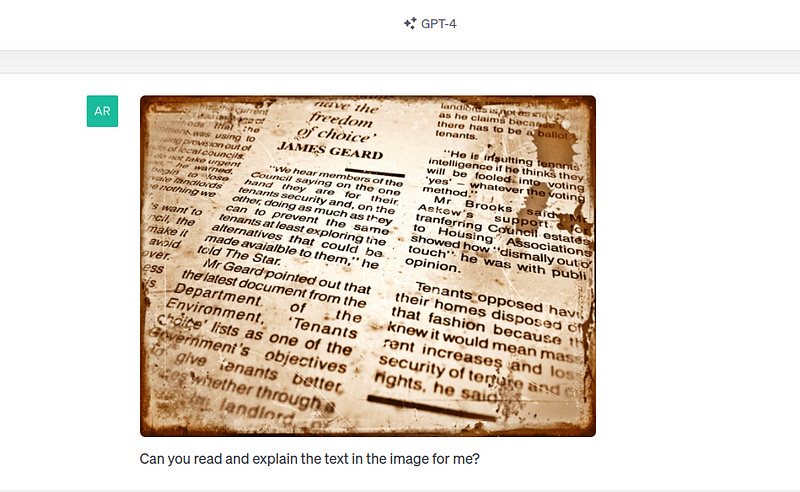
GPT-4 Vision đọc khá tốt nội dung hình ảnh và diễn giải nó:
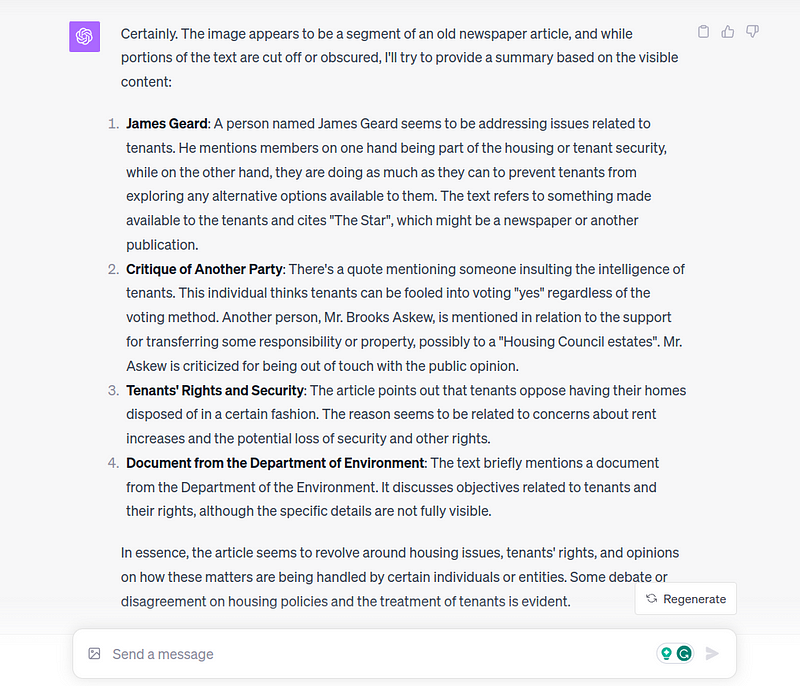
Mô hình có thể đọc, giải mã nội dung và đưa ra phân tích, đồng thời phản hồi thực tế rằng một số phần của hình ảnh bị cắt và che khuất.
Tuy nhiên, cũng cần lưu ý mô hình gặp khó khăn khi gặp các bản thảo phức tạp, đặc biệt ở ngôn ngữ khác (phần sau sẽ nói thêm), như thấy bên dưới:
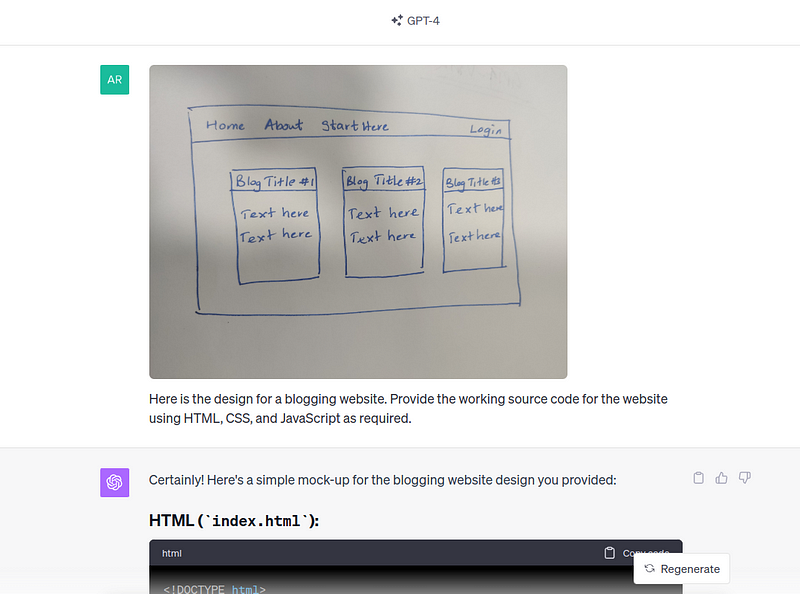
GPT-4 Vision có thể viết mã cho một trang web khi được cung cấp hình ảnh trực quan của thiết kế yêu cầu. Nó chuyển từ thiết kế trực quan sang mã nguồn cho một trang web. Chỉ riêng khả năng này có thể rút ngắn đáng kể thời gian xây dựng website.
Hãy đưa cho GPT-4 Vision một bản phác tay đơn giản cho một website blog.
Khi đã cung cấp mã nguồn, chúng ta chỉ cần sao chép-dán và tạo các tệp HTML và CSS theo hướng dẫn. Website trông như sau:
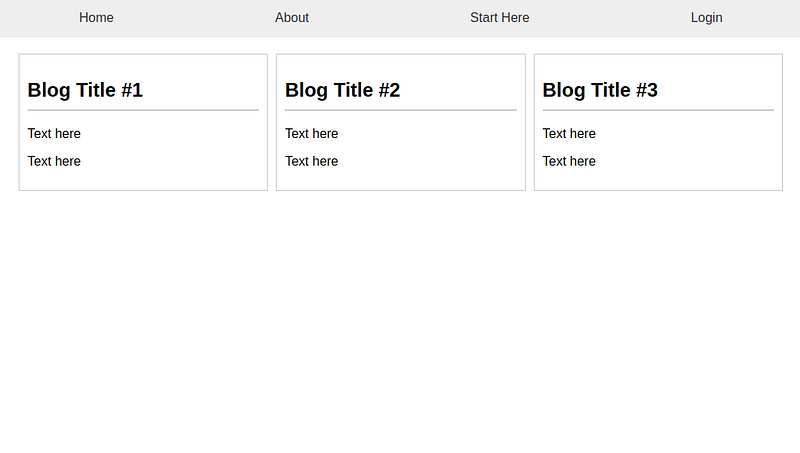
Trông rất giống nhau phải không? Tất nhiên, ví dụ này đơn giản, nhưng bạn có thể bắt đầu từ đây để phát triển một website phức tạp và phù hợp hơn trong thời gian ngắn, nhờ mô hình GPT-4 Vision mới.
Mô hình có thể phân tích các trực quan hóa dữ liệu để diễn giải dữ liệu nền và cung cấp những insight chính dựa trên các biểu đồ. Để thử tính năng này, ta chỉ cần cung cấp một biểu đồ và yêu cầu insight.
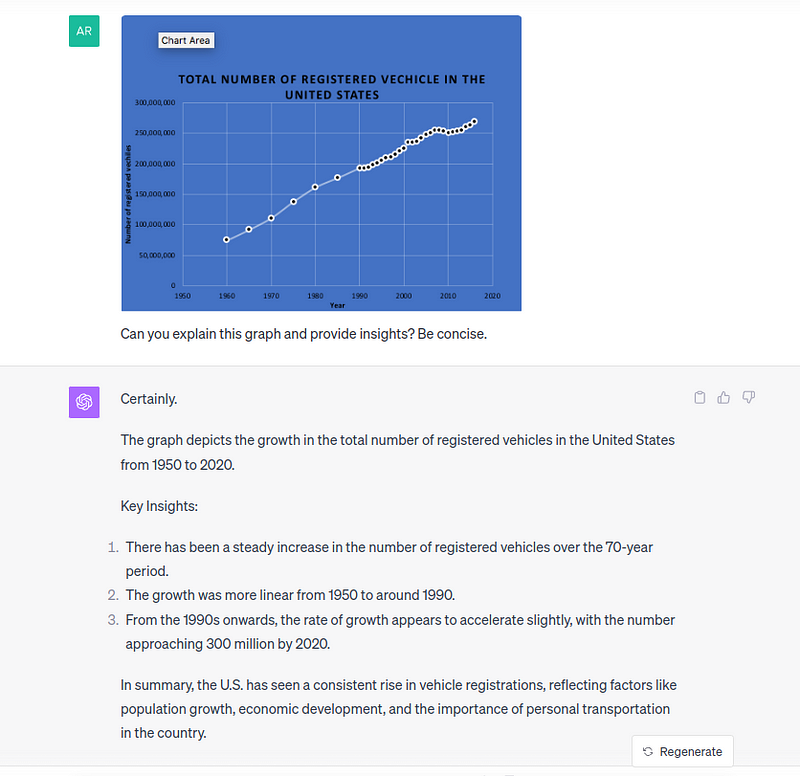
Dù hiểu khá tốt ngữ cảnh tổng thể của biểu đồ và xu hướng tuyến tính, mô hình mắc lỗi khi đề cập năm bắt đầu là 1950, trong khi dữ liệu chỉ bắt đầu từ 1960. Mô hình cũng suy ra các yếu tố như tăng trưởng dân số và phát triển kinh tế — dù có thể đúng, nhưng những insight này không thể rút ra chỉ từ biểu đồ này.
Bạn có thể đặt nhiều câu hỏi tiếp theo để tinh chỉnh đầu ra ban đầu từ GPT-4 Vision. Dựa trên thử nghiệm của chúng tôi, vẫn cần yếu tố con người để rà soát insight, và mô hình có thể nâng cao năng suất cho các trường hợp sử dụng diễn giải dữ liệu.
Với sự xuất hiện của ChatGPT, mạng xã hội tràn ngập các kỹ thuật prompt engineering, và nhiều người đã tìm ra những cách sáng tạo, bất ngờ để tận dụng công nghệ tạo sinh.
Trong hướng dẫn này, chúng ta sẽ dùng DALL-E-3 (cũng có trong ChatGPT Plus) cùng với GPT-4 Vision để sáng tạo một bài đăng mạng xã hội.
Bước 1: Yêu cầu GPT-4 tạo một prompt để sinh ảnh. Giả sử bạn muốn tạo một bài đăng so sánh sự khác biệt giữa vai trò data scientist ở startup và ở doanh nghiệp lớn.
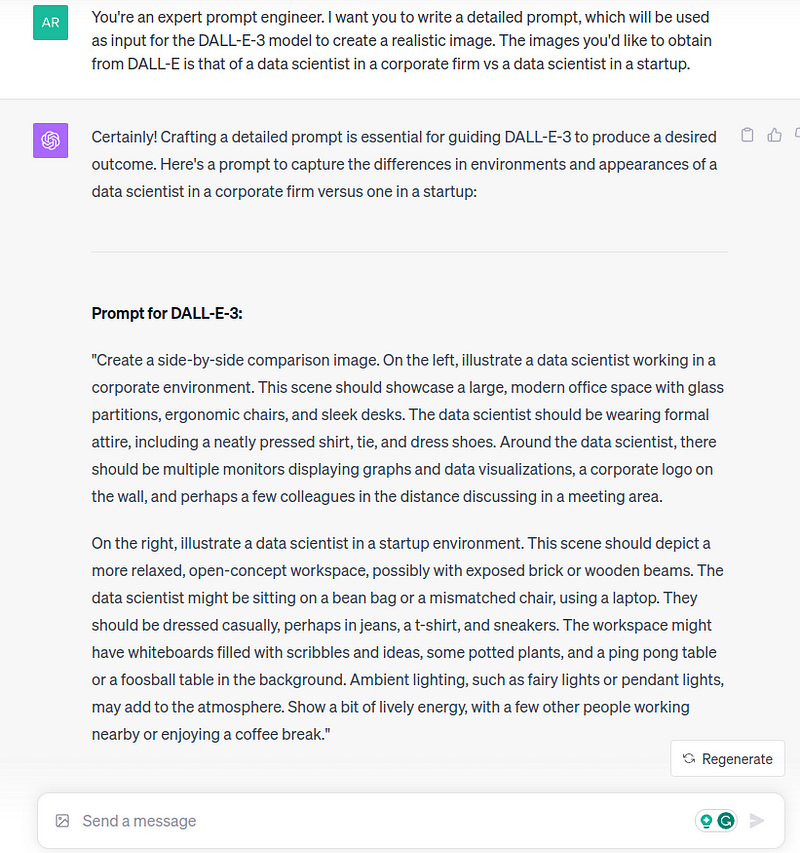
Bước 2: Dùng prompt đó để tạo ảnh bằng DALL-E. Bạn có thể tinh chỉnh prompt cho đến khi hài lòng với kết quả.
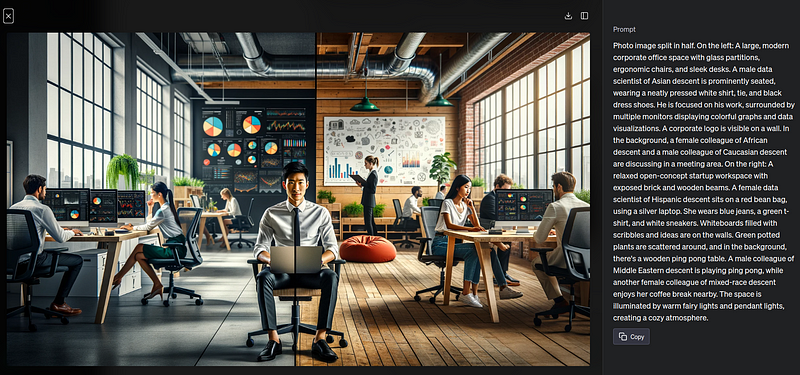
Bước 3: Dùng hình ảnh và yêu cầu GPT-4 Vision tạo một bài đăng đi kèm hình.
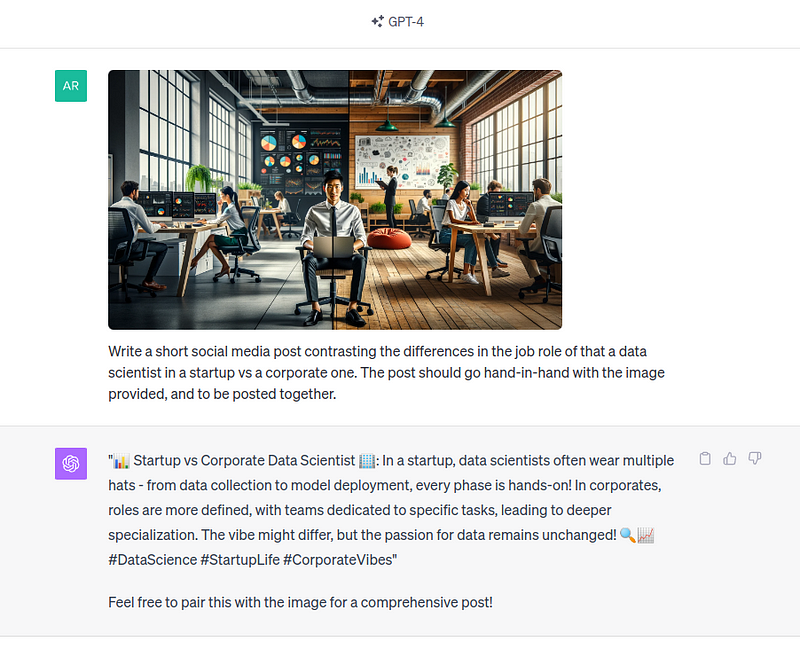
Bằng cách tinh chỉnh và cung cấp prompt chi tiết hơn, bạn có thể nhận được đầu ra tốt hơn, và tiếp tục khám phá việc tạo nội dung sáng tạo. Lưu ý rằng việc làm ngập internet hay mạng xã hội bằng nội dung do AI tạo không được khuyến khích, vì loại nội dung này có những hạn chế riêng. Thay vào đó, hãy kiểm chứng và bổ sung bằng trải nghiệm của chính bạn.
Tất nhiên, đây không phải là danh sách đầy đủ các trường hợp sử dụng khả thi — GPT-4 Vision còn làm được nhiều hơn nữa. Hãy coi đây là nguồn cảm hứng và điểm khởi đầu để bạn khám phá sự tò mò bằng cách áp dụng công nghệ vào lĩnh vực mình chọn.
Trước khi dùng GPT-4 Vision cho các trường hợp sử dụng, có một điều cuối cùng bạn cần lưu ý — những hạn chế và rủi ro đi kèm.
Điều này đặc biệt quan trọng vì chính OpenAI đã dành thêm vài tháng kể từ khi ra mắt GPT-4 vào tháng 3/2023 để kiểm thử bằng các bài “red-teaming” nội bộ và bên ngoài nhằm xác định điểm yếu của công nghệ tạo sinh này, và họ đã nêu trong system card.
Dù mô hình GPT-4 thể hiện bước tiến lớn về độ tin cậy và chính xác, điều đó không phải lúc nào cũng đúng. Theo OpenAI, dựa trên kiểm thử nội bộ, GPT-4 Vision đôi khi vẫn thiếu tin cậy và không chính xác. Đội ngũ thậm chí còn ghi “ChatGPT có thể mắc lỗi. Hãy xác minh thông tin quan trọng.” bên dưới thanh chat khi chúng ta nhập văn bản và hình ảnh.
Vì vậy, người dùng cần hết sức quan trọng trong việc đánh giá phê phán đầu ra của mô hình và luôn cảnh giác.
Theo OpenAI, tương tự các phiên bản trước, GPT-4 Vision tiếp tục củng cố các thiên kiến xã hội và thế giới quan, bao gồm cả những liên hệ rập khuôn gây hại và xúc phạm đối với một số nhóm yếu thế. Do đó, cần hiểu rõ hạn chế này và thực hiện các bước cần thiết khác để xử lý thiên kiến trong chính trường hợp sử dụng, không trông cậy vào mô hình để giải quyết.
Bên cạnh vấn đề thiên kiến, dữ liệu bạn chia sẻ với ChatGPT có thể được dùng để huấn luyện mô hình trừ khi bạn chọn không tham gia; vì vậy, cần thận trọng không chia sẻ thông tin nhạy cảm hoặc riêng tư với mô hình. Người dùng cũng có thể chọn không chia sẻ dữ liệu để cải thiện mô hình bằng cách vào “Data Controls” trong phần “Settings & Beta”.
GPT-4 Vision không thể trả lời các câu hỏi yêu cầu nhận dạng cá nhân cụ thể trong hình ảnh. Đây là hành vi “từ chối” theo thiết kế. Hơn nữa, OpenAI khuyến cáo không sử dụng GPT-4 Vision cho các tác vụ rủi ro cao, bao gồm:
Vì vậy, với vai trò người dùng, chúng ta cần thận trọng sử dụng GPT-4 Vision một cách có trách nhiệm, đặc biệt trong các tác vụ rủi ro cao và bối cảnh nhạy cảm nêu trên.
Hướng dẫn này đã cung cấp cho bạn phần giới thiệu toàn diện về mô hình GPT-4 Vision mới. Bạn cũng đã được lưu ý về những hạn chế và rủi ro của mô hình, và nay hiểu cách dùng cũng như thời điểm nên dùng.
Cách thực tế nhất để làm chủ công nghệ mới là trực tiếp trải nghiệm và thử nghiệm bằng cách đưa ra nhiều prompt để đánh giá khả năng của nó; theo thời gian, bạn sẽ thấy quen thuộc hơn.
Dù đây là công cụ còn tương đối mới, chỉ khoảng một tháng tuổi, nó được xây dựng dựa trên các nguyên lý của Mô hình Ngôn ngữ Lớn và GPT-4. Sau đây là một số tài nguyên liên quan nếu bạn muốn đào sâu các khái niệm nền tảng và liên quan của mô hình GPT-4 Vision:
Bắt đầu hành trình ChatGPT của bạn ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
