
Kursus
Memahami ChatGPT
1 jam
438.3K
GPT-4 Vision (GPT-4V) adalah model multimodal yang memungkinkan pengguna mengunggah gambar sebagai masukan dan berinteraksi dengan model melalui percakapan. Percakapan dapat berupa pertanyaan atau instruksi dalam bentuk prompt, mengarahkan model untuk melakukan tugas berdasarkan masukan yang diberikan dalam bentuk gambar.
Model GPT-4V dibangun di atas kemampuan GPT-4 yang sudah ada, menawarkan analisis visual selain fitur interaksi teks yang ada. Kami telah membahas pengantar OpenAI API yang ramah pemula yang akan membantu Anda mengikuti perkembangan sebelum rilis model GPT-4V.
Sekarang setelah kita memahami sebagian dari banyak kemampuan GPT-4 Vision, mari praktik langsung untuk merasakannya sendiri.
Saat ini (per Okt 2023), GPT-4 Vision tersedia hanya untuk pengguna ChatGPT Plus dan Enterprise. ChatGPT Plus berharga $20/bulan, yang dapat di-upgrade dari akun ChatGPT gratis Anda.
Jika Anda benar-benar baru dengan ChatGPT, berikut cara mengakses GPT-4 Vision:
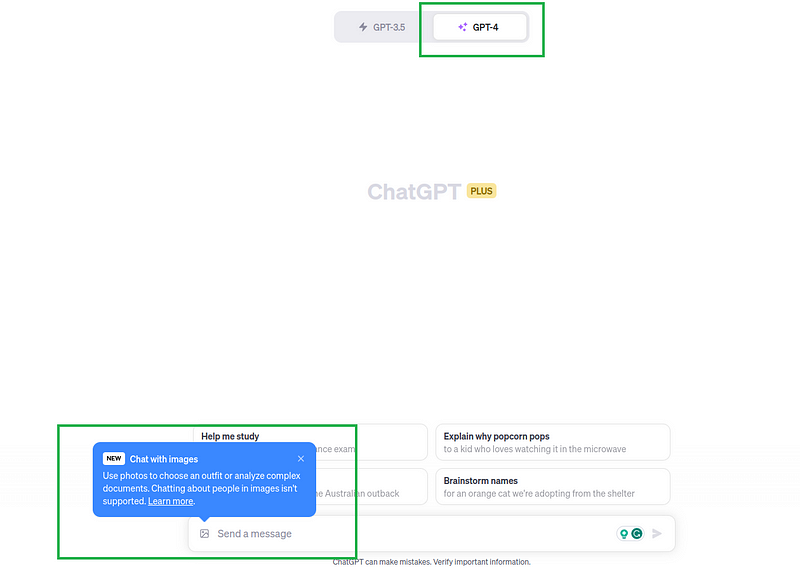
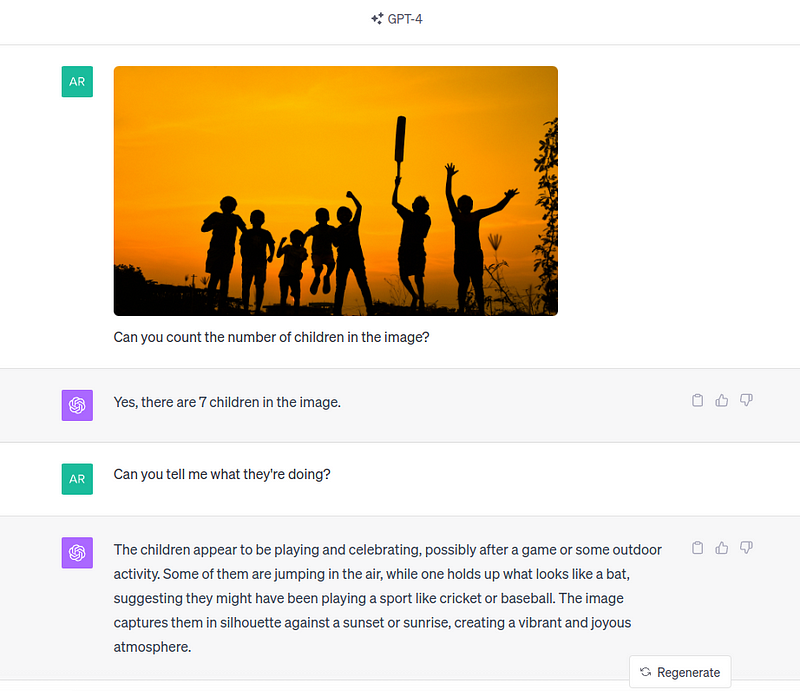
Di sini, GPT-4 Vision cukup baik dalam memahami bahwa anak-anak sedang bermain kriket berdasarkan pemukul di tangan seorang anak. Dalam dunia AI, tugas ini dikenal sebagai deteksi objek, di mana objek yang teridentifikasi adalah anak-anak dan pemukul. Lihat tutorial kami tentang deteksi objek YOLO untuk mempelajari lebih lanjut.
Demikian pula, Anda dapat melanjutkan melakukan berbagai tugas lain yang sesuai dengan kasus penggunaan Anda.
Setelah memahami kemampuannya, mari kita terapkan pada beberapa aplikasi praktis di industri:
Integrasi pemodelan bahasa tingkat lanjut dengan kemampuan visual pada GPT-4 Vision membuka kemungkinan baru di bidang akademik, khususnya dalam menguraikan naskah bersejarah. Tugas ini secara tradisional merupakan pekerjaan teliti dan memakan waktu yang dilakukan oleh para paleografer dan sejarawan terampil.
Pertama, kita berikan gambar yang tampak seperti bagian dari artikel koran lama:
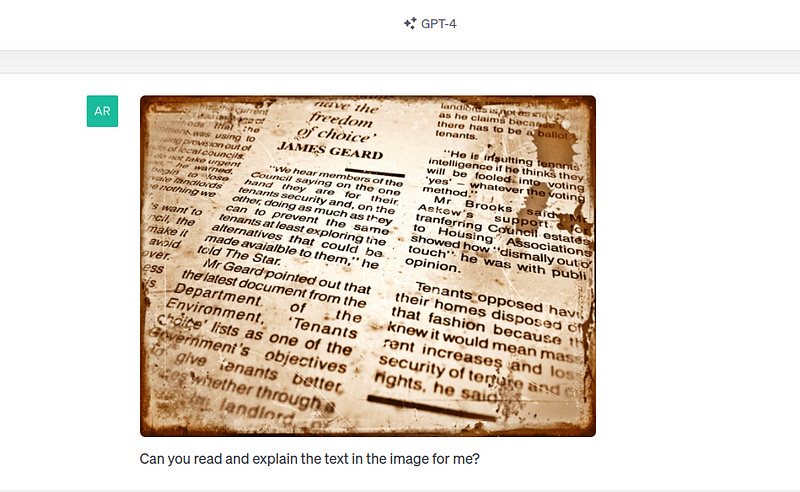
GPT-4 Vision cukup baik dalam membaca isi gambar dan menafsirkannya:
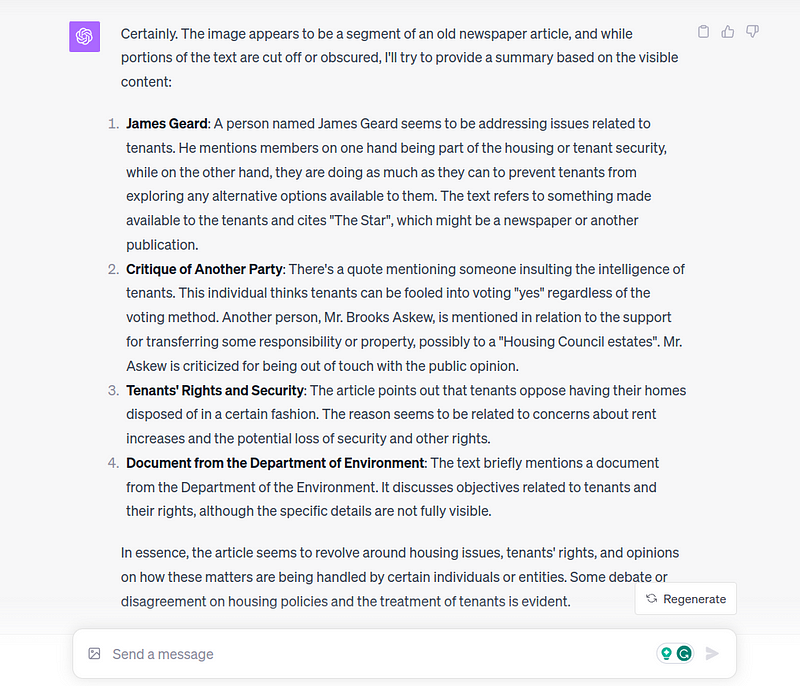
Model mampu membaca, mengurai isi, dan memberikan analisis seraya menyampaikan jawaban realistis bahwa sebagian gambar terpotong dan tertutup.
Namun, perlu dicatat bahwa model kesulitan ketika diberi naskah yang kompleks, terutama dalam bahasa lain (lebih lanjut tentang ini nanti), seperti terlihat di bawah:
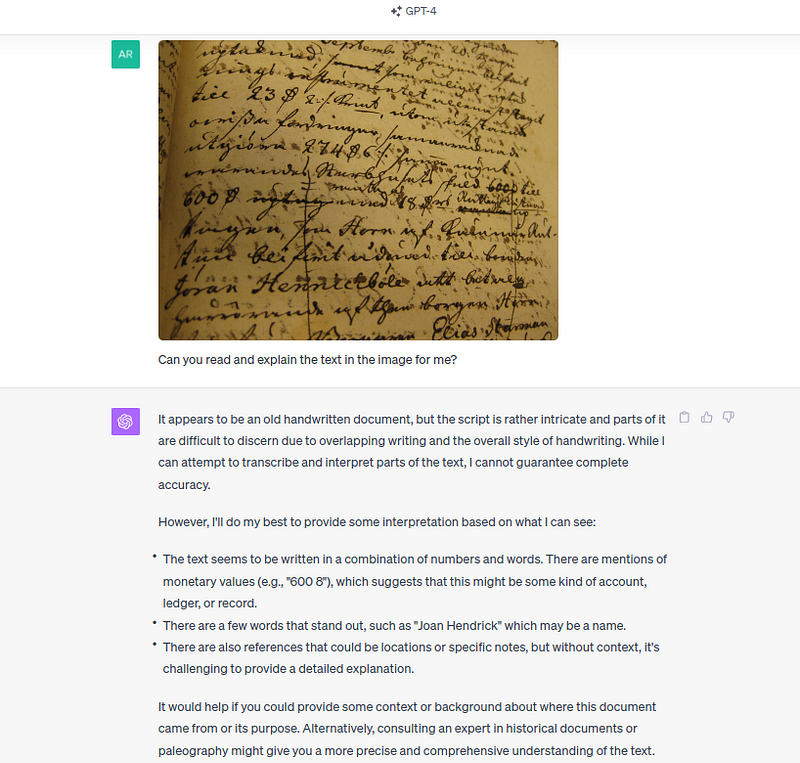
GPT-4 Vision dapat menulis kode untuk sebuah situs web saat diberikan gambar visual dari desain yang diinginkan. Model ini mengubah desain visual menjadi kode sumber untuk situs web. Kemampuan tunggal ini dapat memangkas waktu pembuatan situs secara drastis.
Mari kita beri GPT-4 Vision sebuah desain sederhana buatan tangan untuk situs web blog.
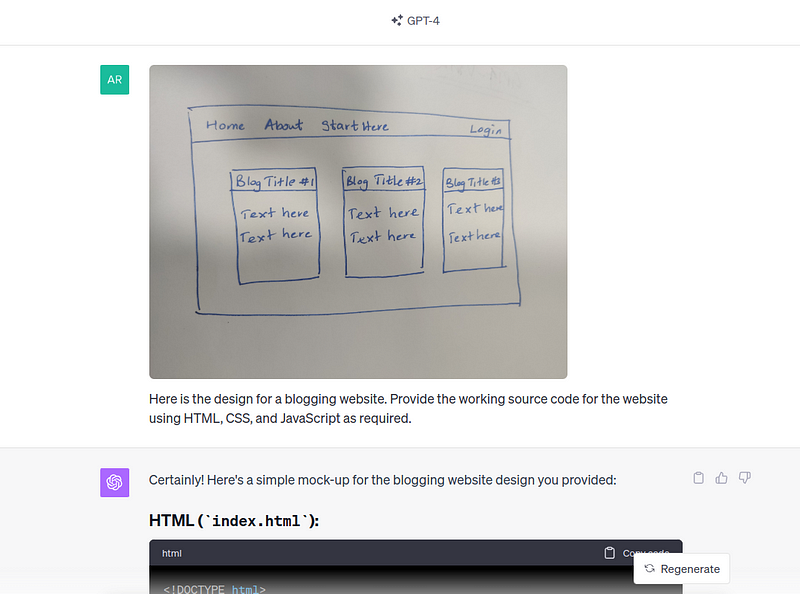
Setelah memberikan kode sumber, kita cukup menyalin-tempel dan membuat file HTML dan CSS sesuai instruksi. Berikut tampilan situsnya:
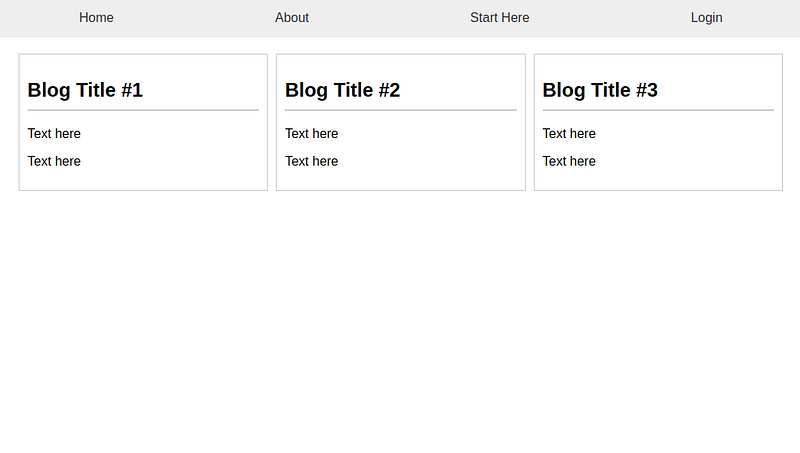
Bukankah tampilannya sangat mirip? Tentu, kita memberikan contoh sederhana, tetapi dari sini Anda bisa mengembangkannya menjadi situs yang lebih kompleks dan sesuai kebutuhan dalam waktu yang jauh lebih singkat, berkat model GPT-4 Vision yang baru diperkenalkan.
Model mampu menganalisis visualisasi data untuk menafsirkan data yang mendasarinya dan memberikan wawasan utama berdasarkan visualisasi tersebut. Untuk mencoba fitur ini, kita bisa memberikan sebuah plot dan meminta wawasan.
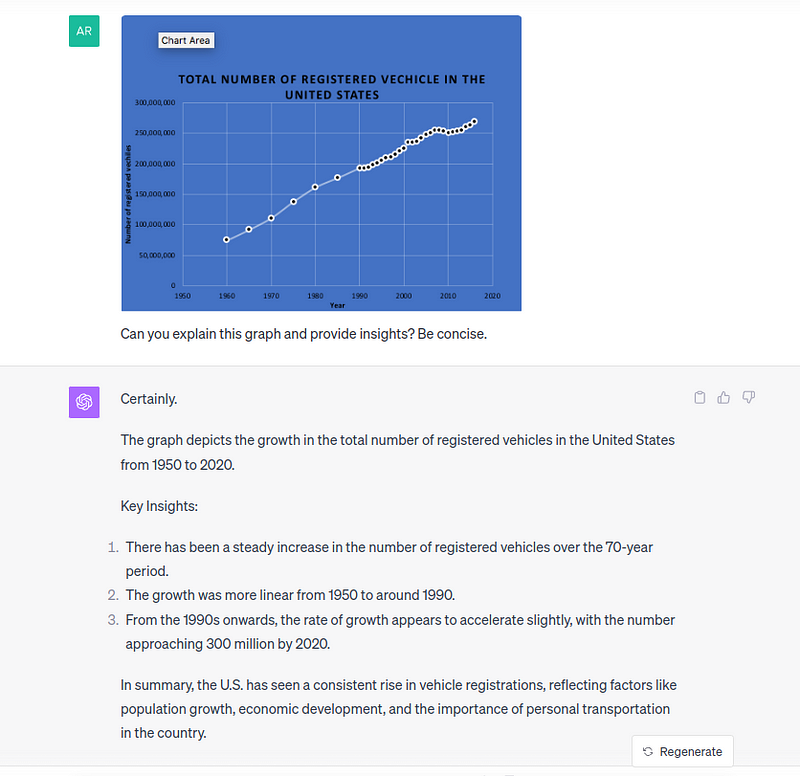
Meski cukup baik dalam memahami konteks umum plot dan tren linear, model membuat kesalahan dengan menyebutkan tahun awal 1950, padahal titik data baru dimulai pada 1960. Model juga menyimpulkan faktor seperti pertumbuhan penduduk dan pembangunan ekonomi — meski bisa saja benar, wawasan tersebut tidak dapat disimpulkan dari grafik ini saja.
Kita dapat mengajukan beberapa pertanyaan lanjutan untuk memperbaiki keluaran awal dari model GPT-4 Vision. Berdasarkan pengujian kami, kehadiran manusia dalam loop masih diperlukan untuk meninjau wawasan, dan model dapat meningkatkan produktivitas pada kasus penggunaan interpretasi data.
Dengan hadirnya ChatGPT, media sosial dipenuhi berbagai teknik prompt engineering, dan banyak yang menemukan cara kreatif dan mengejutkan untuk memanfaatkan teknologi generatif.
Untuk tutorial ini, kita akan menggunakan DALL-E-3 (yang juga tersedia di ChatGPT Plus) bersama GPT-4 Vision untuk secara kreatif membuat sebuah unggahan media sosial.
Langkah 1: Minta GPT-4 membuat prompt untuk menghasilkan gambar. Misalnya, Anda ingin membuat unggahan yang membandingkan perbedaan peran data scientist di startup vs di korporasi.
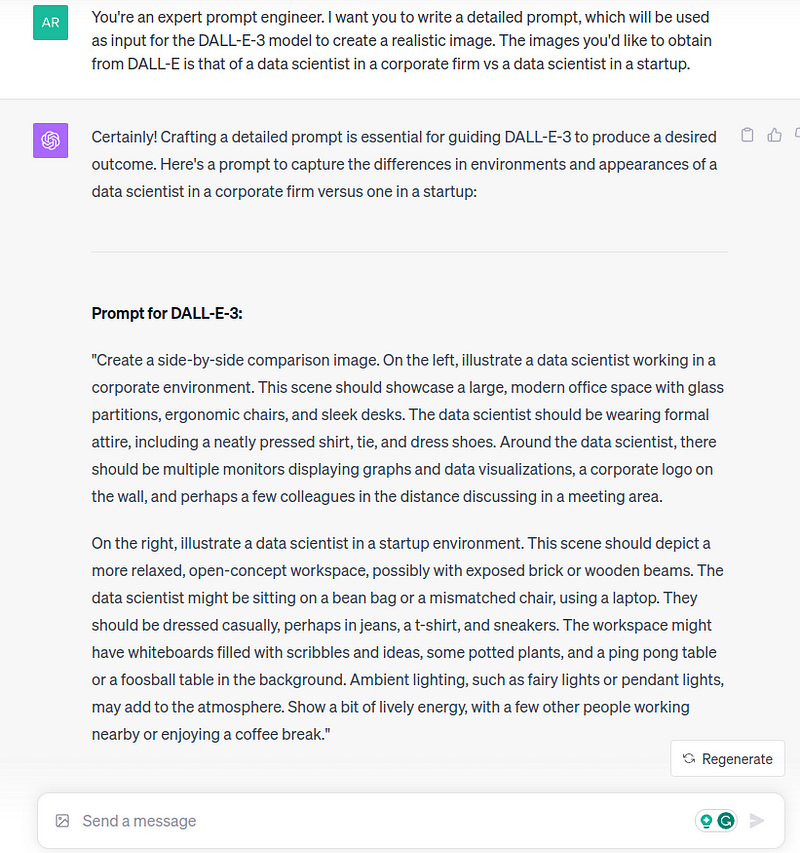
Langkah 2: Gunakan prompt tersebut dan hasilkan gambar dari DALL-E. Anda dapat mengubah dan menyempurnakan prompt sampai puas dengan hasilnya.
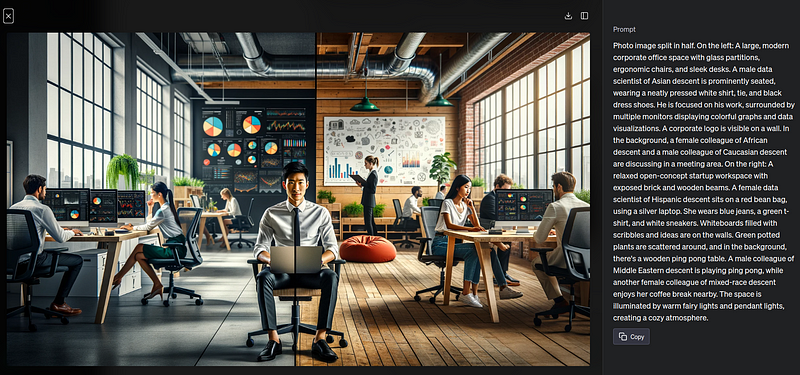
Langkah 3: Gunakan gambar tersebut dan minta GPT-4 Vision membuat unggahan yang menyertai gambar.
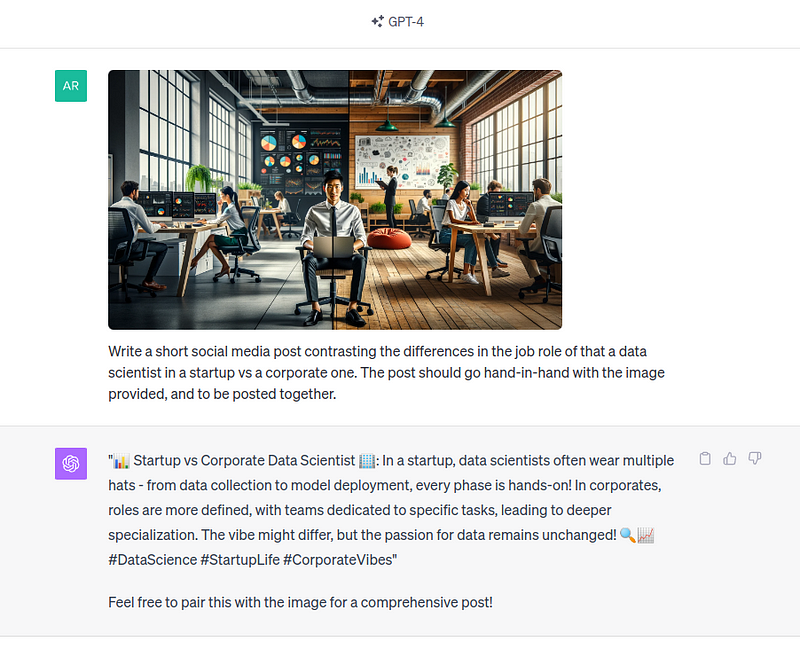
Dengan mengutak-atik dan memberikan prompt yang lebih terperinci, Anda bisa mendapatkan keluaran yang lebih baik, dan pembuatan konten kreatif dapat dieksplorasi lebih jauh. Perlu diingat bahwa melakukan spam di internet atau media sosial dengan konten buatan AI tidak disarankan, karena konten ini memiliki keterbatasannya sendiri. Sebaliknya, verifikasi fakta dan sempurnakan dengan pengalaman Anda sendiri.
Tentu saja, ini bukan daftar lengkap use case yang mungkin — GPT-4 Vision mampu melakukan banyak hal lainnya. Anggap ini sebagai inspirasi dan titik awal untuk mengeksplorasi rasa ingin tahu Anda dengan menerapkan teknologi pada domain pilihan Anda.
Ada satu hal terakhir yang perlu Anda ketahui sebelum menggunakan GPT-4 Vision dalam use case — keterbatasan dan risikonya.
Hal ini penting, karena OpenAI sendiri membutuhkan beberapa bulan tambahan sejak peluncuran GPT-4 pada Maret 2023 untuk mengujinya melalui latihan “red-teaming” internal dan eksternal guna mengidentifikasi kekurangan teknologi generatif ini, yang mereka uraikan dalam system card.
Meskipun model GPT-4 mewakili kemajuan signifikan menuju keandalan dan akurasi, hal tersebut tidak selalu terjadi. Menurut OpenAI, berdasarkan pengujian internal, GPT-4 Vision masih dapat tidak andal dan tidak akurat pada waktu tertentu. Tim bahkan menampilkan peringatan “ChatGPT dapat membuat kesalahan. Verifikasikan informasi penting.” di bawah bilah chat saat kita memasukkan teks dan gambar.
Karena itu, sangat penting bagi pengguna untuk secara kritis menilai keluaran model dan tetap waspada.
Menurut OpenAI, serupa dengan pendahulunya, GPT-4 Vision masih menguatkan bias sosial dan pandangan dunia tertentu, termasuk asosiasi stereotip dan merendahkan yang berbahaya terhadap kelompok yang termarjinalkan. Maka, penting untuk memahami batasan ini dan mengambil langkah lain yang diperlukan untuk menangani bias dalam use case itu sendiri dan tidak bergantung pada model untuk menyelesaikannya.
Selain kekhawatiran soal bias, data yang dibagikan ke ChatGPT dapat digunakan untuk melatih model kecuali Anda memilih untuk tidak ikut serta; oleh karena itu, penting untuk berhati-hati agar tidak membagikan informasi sensitif atau pribadi kepada model. Pengguna juga dapat memilih untuk tidak ikut berbagi data untuk peningkatan model dengan masuk ke “Data Controls” di bagian “Settings & Beta.”
GPT-4 Vision tidak dapat menjawab pertanyaan yang meminta mengidentifikasi individu tertentu dalam sebuah gambar. Ini adalah perilaku “penolakan” yang diharapkan sesuai desain. Selain itu, OpenAI menyarankan untuk tidak menggunakan GPT-4 Vision pada tugas berisiko tinggi, yang mencakup:
Karena itu, sebagai pengguna, kita perlu waspada dan menggunakan GPT-4 Vision secara bertanggung jawab, terutama pada tugas berisiko tinggi dan konteks sensitif di atas.
Tutorial ini memberikan pengantar komprehensif tentang model GPT-4 Vision yang baru dirilis. Anda juga telah diingatkan mengenai keterbatasan dan risikonya, serta kini memahami cara dan kapan menggunakan model tersebut.
Cara paling praktis untuk menguasai teknologi baru adalah dengan mencobanya langsung dan bereksperimen dengan berbagai prompt untuk mengevaluasi kemampuannya, dan seiring waktu, Anda akan semakin terbiasa.
Meskipun ini adalah alat yang relatif baru dan berusia satu bulan, ia dibangun di atas prinsip-prinsip Large Language Model dan GPT-4. Berikut beberapa sumber terkait jika Anda ingin menyelami konsep dasar dan terkait dari model GPT-4 Vision:
Mulai Perjalanan ChatGPT Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



