

我们将使用可在 DataLab(DataCamp 的 AI 驱动数据笔记本)中获取的独角兽公司数据库。这些公司被称为独角兽,是指估值超过 10 亿美元的初创企业。为简化起见,我们将聚焦三张表:companies、sales 和 product_emissions。要亲自运行本教程中的全部示例代码,您可以免费创建一个 DataLab 工作簿,数据库与所有代码示例均已为您预加载。
使用 SQL GROUP BY
GROUP BY 是常用来对数据进行聚合以获取洞见的 SQL 命令。对数据进行分组时通常经历三个阶段:
- 拆分:根据选定用于聚合的变量取值,将数据集拆分为多段行块
- 应用:计算聚合函数,如均值、最小值、最大值,返回单一值
- 合并:将所有结果输出合并为一张表。这样,每个关注变量的每种取值都会对应一个单一值。
SQL GROUP BY 示例 1
先从一个简单的 GROUP BY 示例开始。假设我们要找出拥有独角兽公司数量最多的前十个国家。
SELECT *
FROM companies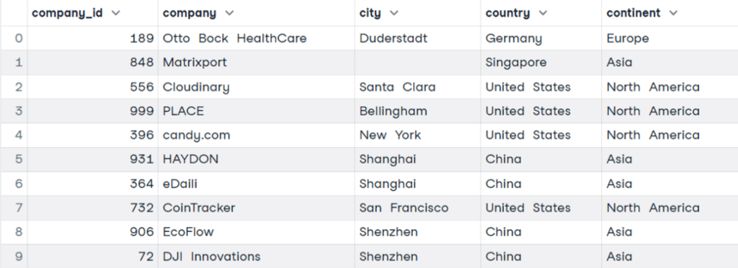
同时,我们也希望按照公司数量从高到低排序结果。
SELECT country, COUNT(*) AS n_companies
FROM companies
GROUP BY country
ORDER BY n_companies DESC
LIMIT 10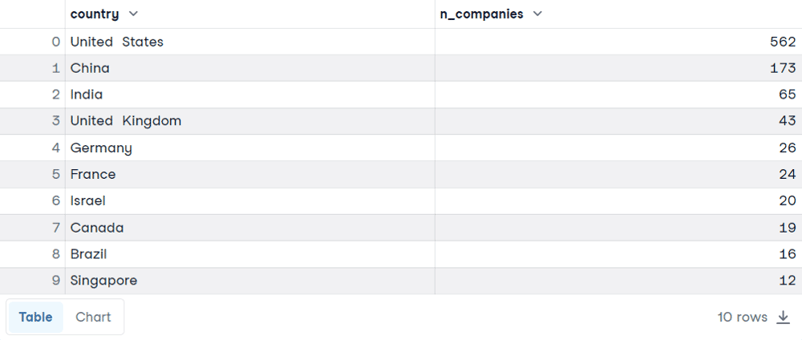
结果如上。美国、中国和印度的上榜并不意外。我们来解释一下这条查询背后的考量:
-
首先,请注意我们使用了
COUNT(*)来统计每个分组(国家)内的行数。我们还使用了 SQL 别名将该列重命名为更易理解的名称,这是通过关键字AS加新名称实现的。关于COUNT的更多内容,请参阅 COUNT() SQL FUNCTION 教程。 -
字段选自 companies 表,其中每一行对应一家独角兽公司。
-
随后,需要在
GROUP BY后指定用于按国家聚合数据的列名。 -
使用
ORDER BY可以按从多到少的顺序正确展示各国的公司数量。 -
通过
LIMIT将结果限制为 10 行,后接所需的结果行数。
SQL GROUP BY 示例 2
接下来,我们分析销售表。对于每个订单号,我们有客户类型、产品线、数量、单价、合计等信息。
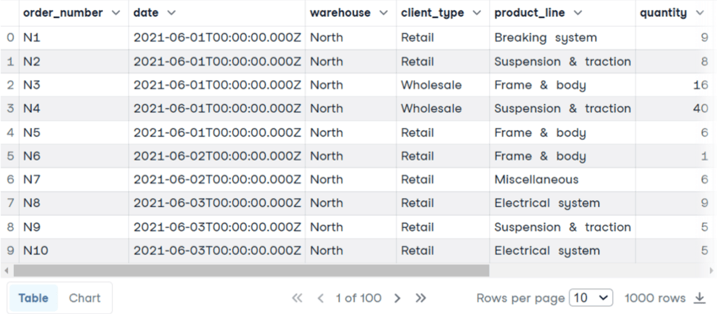
这次,我们希望找出每条产品线的平均单价、订单总数以及总收益:
SELECT
product_line,
AVG(unit_price) AS avg_price,
SUM(quantity) AS tot_pieces,
SUM(total) AS total_gain
FROM sales
GROUP BY product_line
ORDER BY total_gain DESC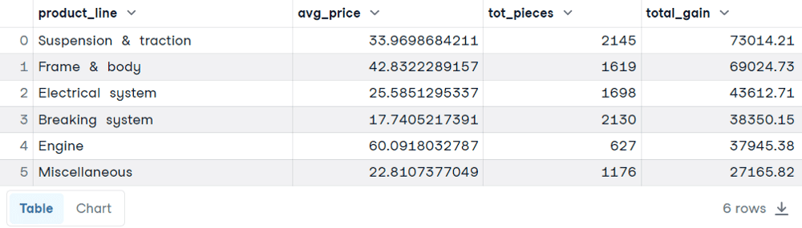
-
这次我们没有统计行数,而是使用
AVG()函数得到平均价格,使用SUM()函数计算每条产品线的订单总数和总收益。 -
与之前一样,我们先指定用于将数据集拆分成多段的列名。随后,聚合函数会让我们按每种产品线取值得到一行结果。
-
这次
ORDER BY是可选的。这里包含它是为了突出:更高的总收益并不总是与更高的平均价格或更多的件数成正比。
WHERE 的局限
我们再看上一例。现在,我们想为查询添加条件:只保留订单总数高于 40,000 的结果。试试使用 WHERE 子句:
SELECT
product_line,
AVG(unit_price) AS avg_price,
SUM(quantity) AS tot_pieces,
SUM(total) AS total_gain
FROM sales
WHERE SUM(total) > 40000
GROUP BY product_line
ORDER BY total_gain DESC这条查询会返回如下错误:
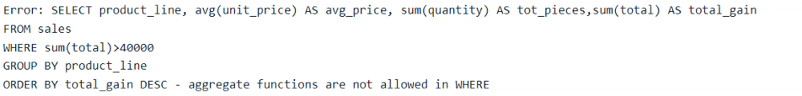
也就是说,WHERE 子句中不允许使用聚合函数。我们需要一个新命令来解决这个问题。
使用 SQL HAVING
与 WHERE 类似,HAVING 子句用于筛选表中的行。不同之处在于,WHERE 尝试筛选整张表,而 HAVING 则在 GROUP BY 定义的各个分组内筛选行。
SQL HAVING 示例 1
将上一例中的 WHERE 替换为 HAVING:
SELECT
product_line,
AVG(unit_price) AS avg_price,
SUM(quantity) AS tot_pieces,
SUM(total) AS total_gain
FROM sales
GROUP BY product_line
HAVING SUM(total) > 40000
ORDER BY total_gain DESC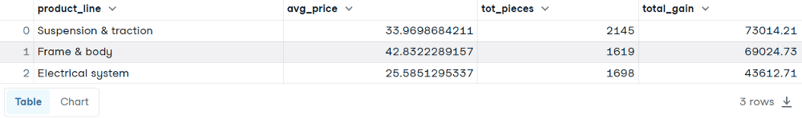
这次返回了三行。其他产品线未满足条件,因此结果从六行变为三行。
您还能从查询中发现什么?我们没有把列别名传给 HAVING,而是传入了原始字段的聚合。为什么呢?下一例会揭晓答案。
SQL HAVING 示例 2
最后一个示例中,我们使用名为 product_emissions 的表,其中包含公司提供的产品排放信息。
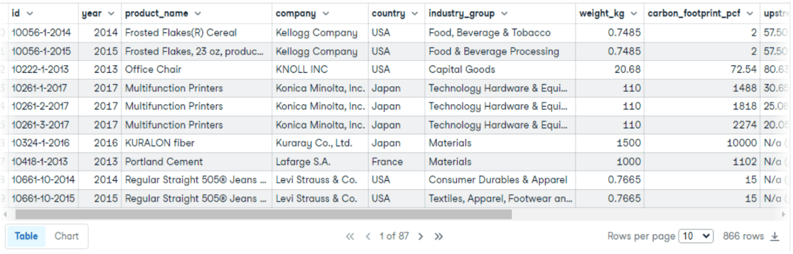
这次,我们要展示属于“Technology Hardware & Equipment”行业组的各家公司,其平均产品碳足迹(pcf)。此外,查看每家公司对应的产品数量也很有帮助,以便判断产品数量与碳足迹之间是否存在某种关系。我们还将再次使用 HAVING 提取平均碳足迹超过 100 的公司。
SELECT pe.company, count(product_name) AS n_products, avg(carbon_footprint_pcf) AS avg_carbon_footprint_pcf
FROM product_emissions AS pe
WHERE industry_group = 'Technology Hardware & Equipment'
GROUP BY pe.company, industry_group
having avg_carbon_footprint_pcf>100
ORDER BY n_products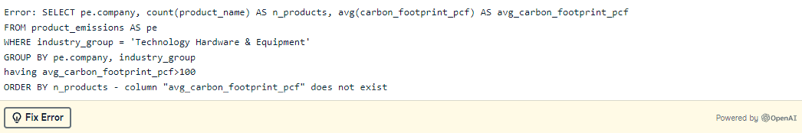
在尝试使用别名后出现了错误。对于 HAVING 子句,新列名并不存在,因此无法据此过滤查询。我们来修正请求:
SELECT pe.company, count(product_name) AS n_products, avg(carbon_footprint_pcf) AS avg_carbon_footprint_pcf
FROM product_emissions AS pe
WHERE industry_group = 'Technology Hardware & Equipment'
GROUP BY pe.company, industry_group
having avg(carbon_footprint_pcf)>100
ORDER BY n_products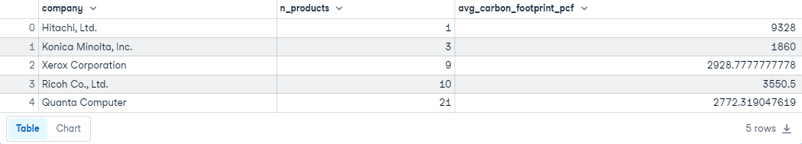
这一次条件生效了,我们可以直观看到表中的结果。我们刚刚了解到,HAVING 不能使用列别名,因为该条件在 SELECT 之前应用。因此它无法识别使用新名称的字段。
SQL 的执行顺序
我们编写查询时的命令顺序如下:
SELECT
FROM
WHERE
GROUP BY
HAVING
ORDER BY但您需要思考一个问题:SQL 命令的实际执行顺序是什么?我们常常理所当然地认为计算机会自上而下读取并解释 SQL,但事实并非如此。正确的执行顺序是:
FROM
WHERE
GROUP BY
HAVING
SELECT
ORDER BY
LIMIT也就是说,查询处理器并不是从 SELECT 开始,而是先确定包含哪些表;SELECT 在 HAVING 之后执行。这也解释了为何 HAVING 不允许使用 ALIAS,而 ORDER BY 却可以。除此之外,这个执行顺序也说明了为什么要将 HAVING 与 GROUP BY 搭配,用于对聚合数据施加条件,而 WHERE 则做不到。
如果您想进一步了解,建议阅读我们的教程SQL 的执行顺序:理解查询如何运行,其中有详尽讲解。
更进一步
读完本教程后,您应已清楚理解 GROUP BY 与 HAVING 的区别。您可以在 DataLab 上练习,巩固这些概念。
如果您想在 SQL 学习路径上更进一步,可以学习我们的 Intermediate SQL 课程。若您仍需夯实 SQL 基础,可回到Introduction to SQL 课程,学习该语言的基本原理。
“聚合”是将多个数据点汇总为单一值的另一种说法。例如,计算均值或最小值。但有时,把所有数据都聚合成一个值并不实用。
比如,您在分析门店的购买行为,且进店人群既有拮据的学生,也有富裕的职场人士,那么分别计算这些群体的平均消费会更有意义。也就是说,您需要按照不同的客户细分来聚合消费金额。
本教程讲解 SQL 的
GROUP BY语句,以及用于控制每个分组所包含数据行的HAVING语句。HAVING与WHERE语句关系密切,您可先阅读SQL 中 WHERE 子句入门教程。此外,您还需要理解SELECT和FROM语句,详见 SQL 查询示例与教程。