
课程
R 数据科学的线性代数
4 小时
21.8K
本教程将探讨哈达玛积的数学基础、计算特性及其广泛应用。通过动手示例,您将了解这一运算如何在理论数学与数据科学应用之间搭起桥梁,使其成为处理矩阵和高维数据的关键工具。
要夯实矩阵运算基础,欢迎学习我们的 Linear Algebra for Data Science in R 课程,其中涵盖了与哈达玛积相辅相成的核心概念。
哈达玛积(Hadamard product),又称按元素乘法,是矩阵代数中应用极为广泛的运算之一。不同于标准矩阵乘法,它通过逐元素相乘来合并矩阵,在实现局部变换的同时保留原有维度。
给定两个矩阵A 与 B,其尺寸均为 m × n,则它们的哈达玛积 A ∘ B(有时记作 A ⊙ B)通过对应元素相乘得到:
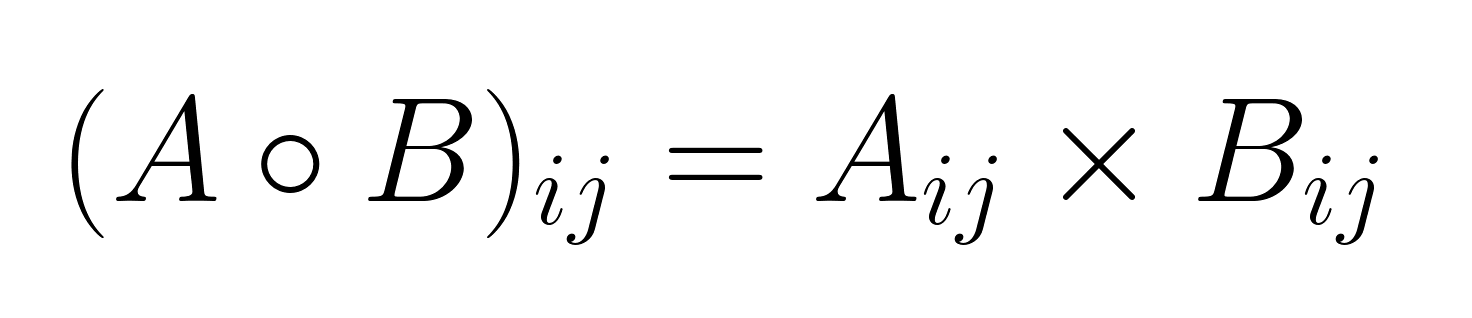
其中 i 从 1 到 m,j 从 1 到 n。
所得矩阵 C = A ∘ B 与输入矩阵尺寸相同,每个元素彼此独立计算。
哈达玛积常见的记号有:
记号的选择通常取决于具体语境与应用领域,但∘仍是数学文献中的标准写法。
用两个 3×2 矩阵来直观演示哈达玛积:
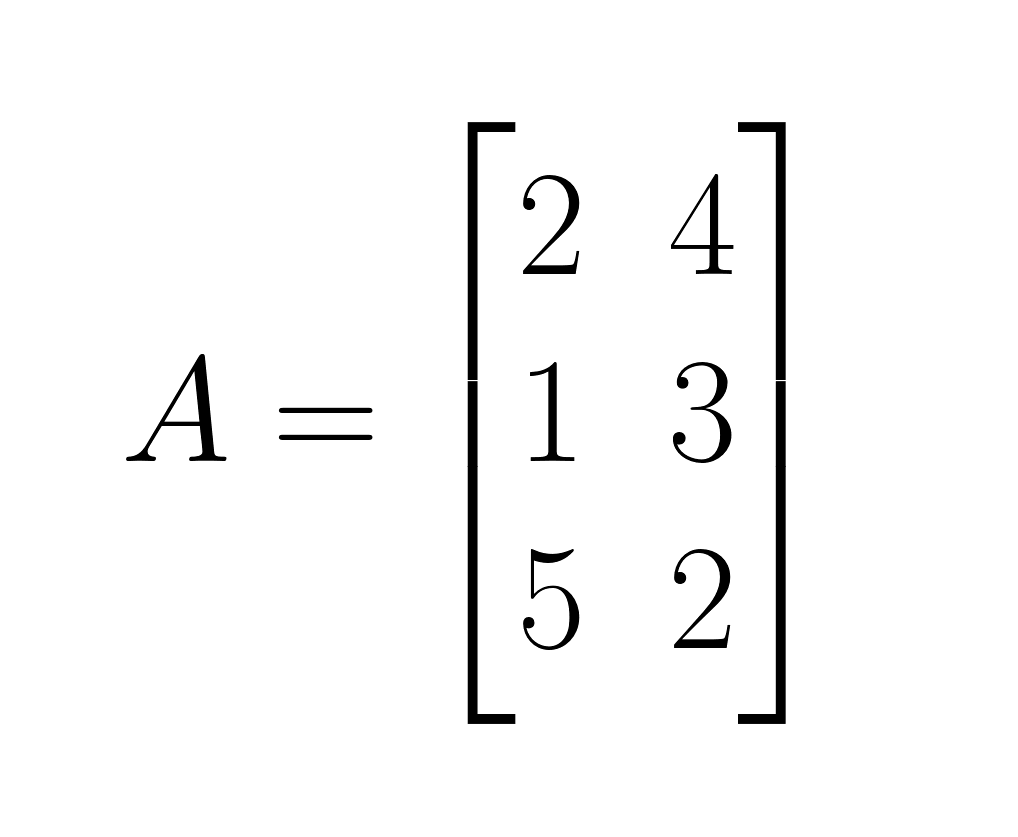
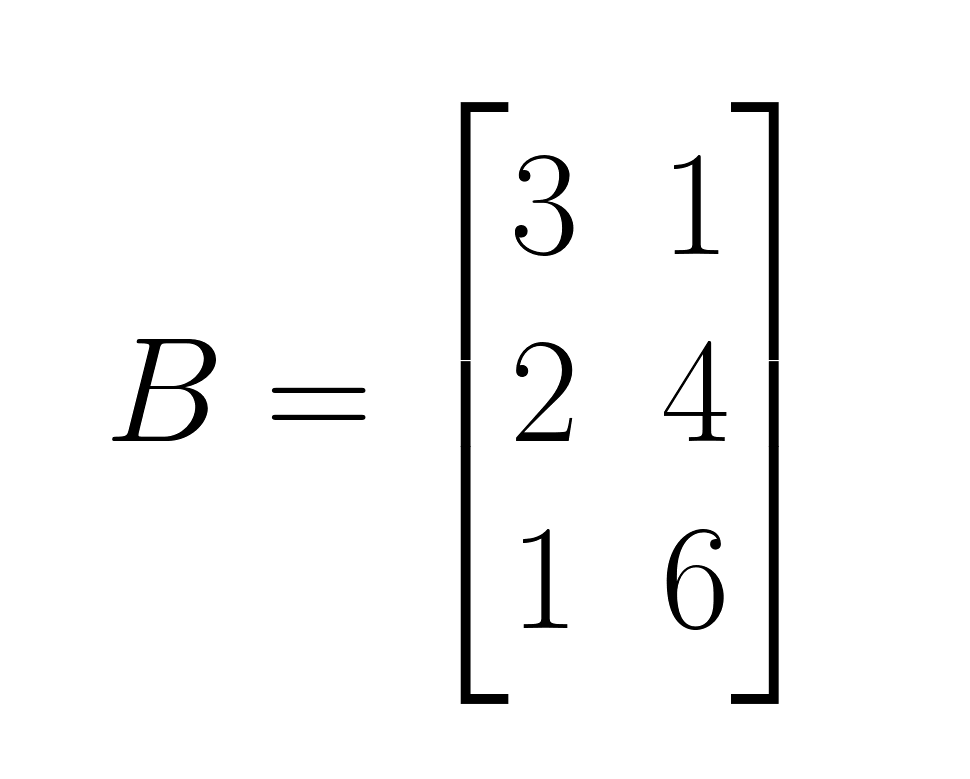
结果如下:
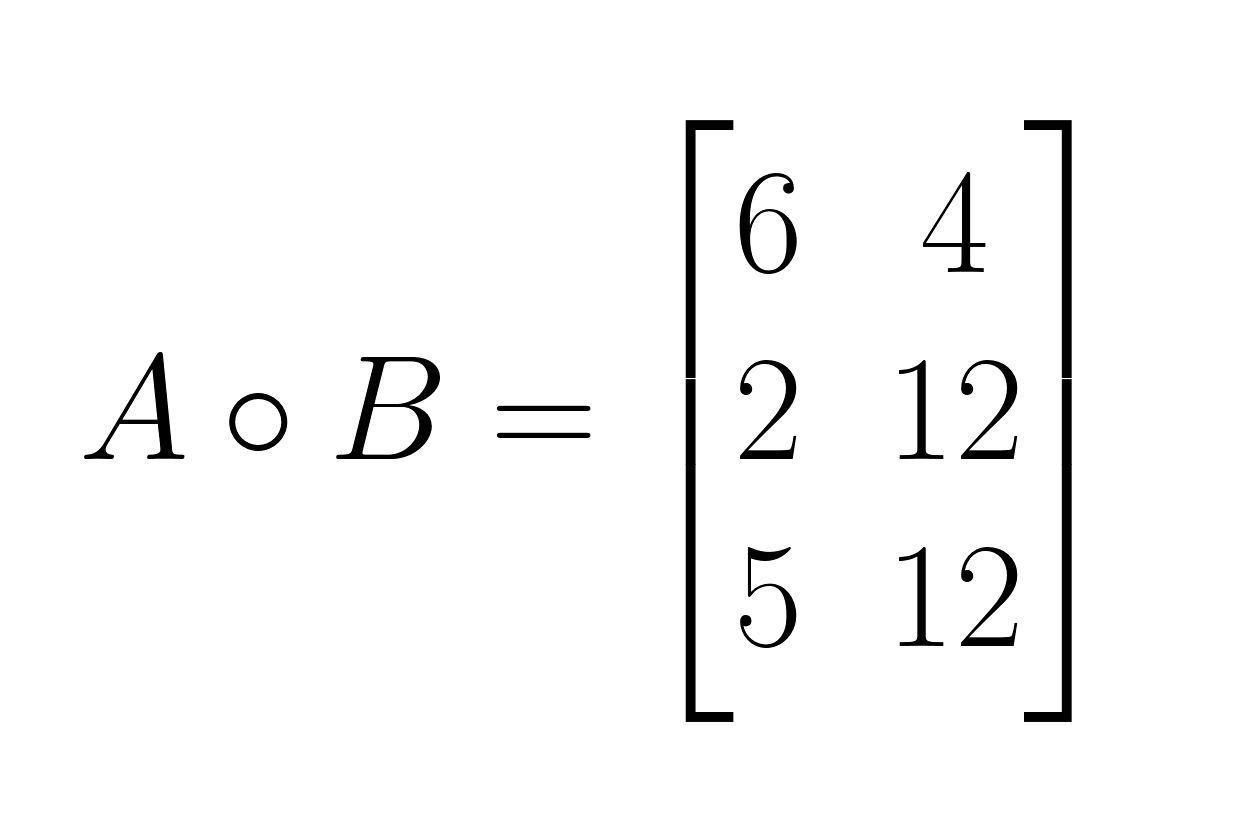
哈达玛积对维度有严格要求:两个矩阵的尺寸必须完全一致。不同于标准矩阵乘法只需内维匹配,哈达玛积要求完整的维度一致性。该约束确保一个矩阵中的每个元素在另一矩阵中都有对应元素参与相乘。当矩阵尺寸不一致时,哈达玛积无定义。
哈达玛积具备一系列与标准矩阵乘法不同的代数性质。理解这些性质有助于把握按元素乘法的行为差异,并洞见其数学结构。
哈达玛积是可交换的,即运算次序不影响结果:
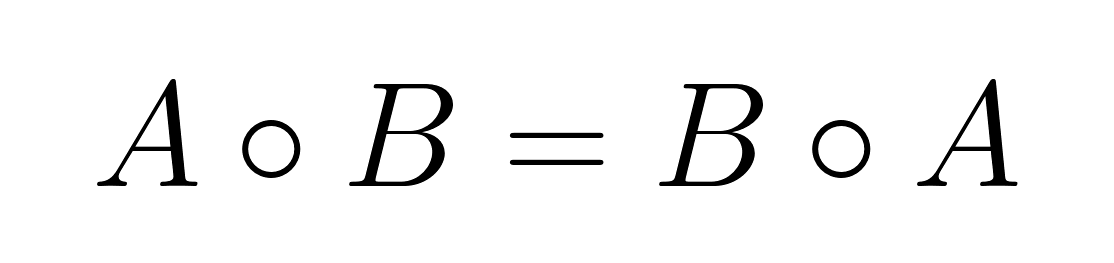
这一性质成立是因为实数的逐元素乘法可交换:aᵢⱼ × bᵢⱼ = bᵢⱼ × aᵢⱼ。
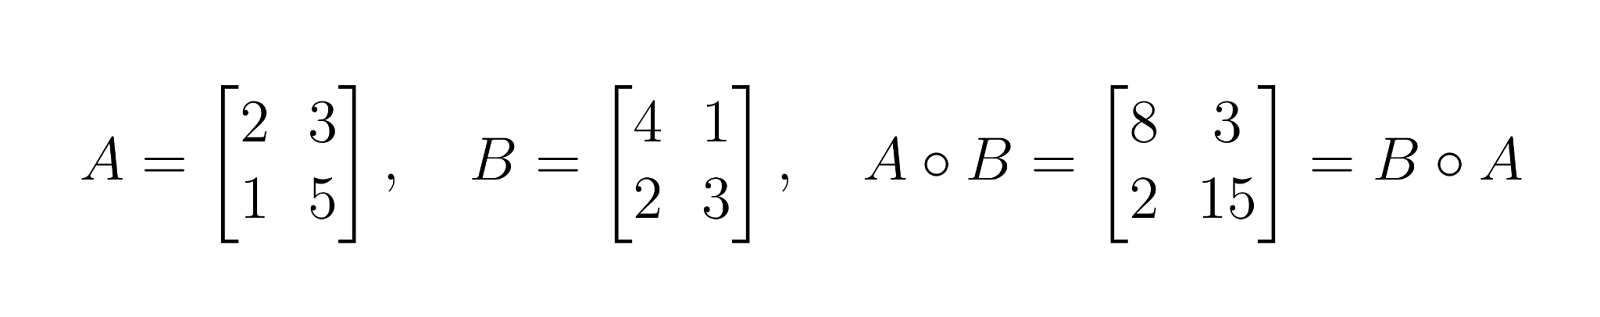
这与矩阵乘法不同,后者通常不可交换。
哈达玛积满足结合性,因而可以更改分组而不改变结果:
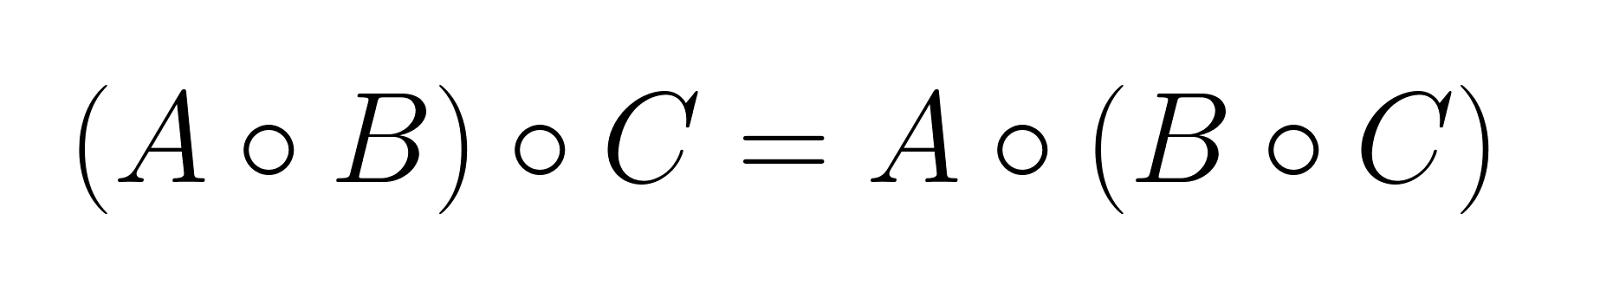
该性质可扩展至任意数量的矩阵,前提是它们的尺寸完全一致。
哈达玛积对矩阵加法满足分配律:
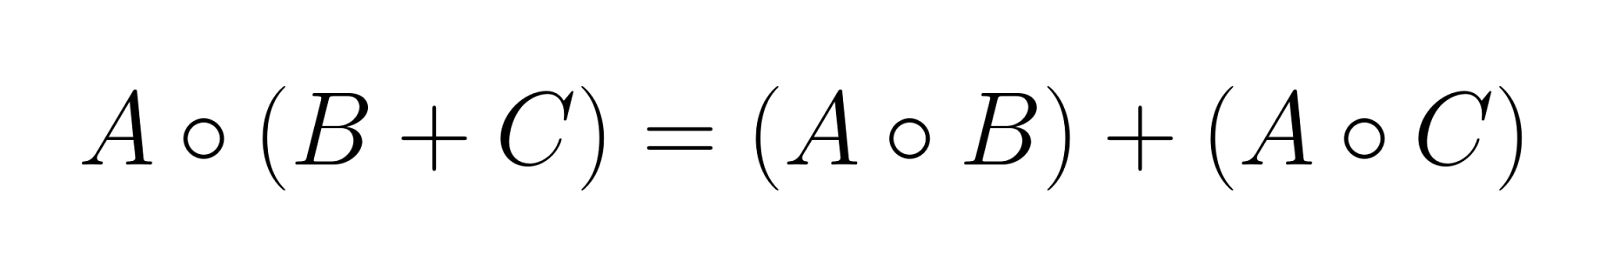
这使哈达玛积可与矩阵的线性组合良好兼容。
哈达玛积的单位元是一切元素为 1 的矩阵 J。对于任意矩阵 A:
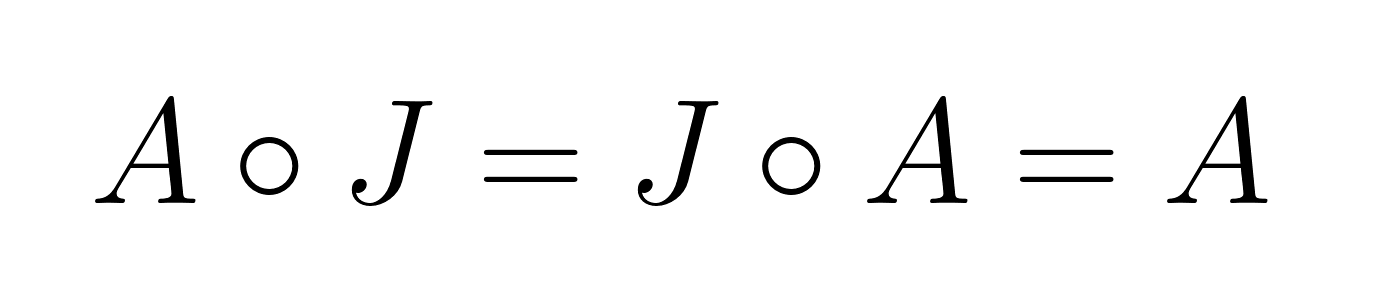
这与标准矩阵乘法显著不同,后者的单位矩阵仅主对角线上为 1,其余为 0。
与标准矩阵乘法不同,哈达玛积:
混合乘积性质建立了哈达玛积与矩阵转置之间的关系:
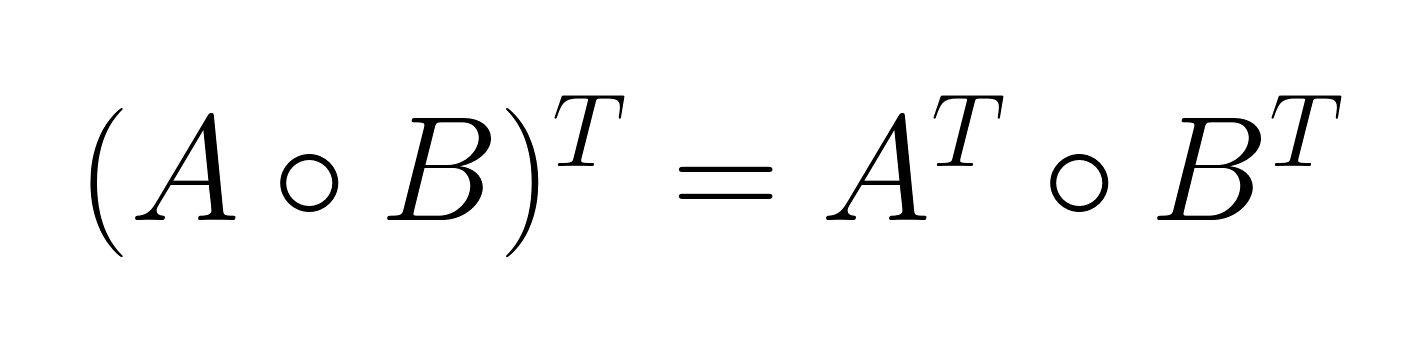
该性质在优化问题与统计应用中尤为有用,因为转置矩阵经常出现。
x例如:在协方差矩阵估计中,研究者常常处理转置的数据矩阵。混合乘积性质允许在转置前或转置后进行按元素运算,为算法设计提供了计算上的灵活性。
舒尔乘积定理(Schur Product Theorem)是关于哈达玛积最重要的理论结果之一。它指出:两个半正定矩阵的哈达玛积仍为半正定矩阵。
定理:若 A 与 B 为同尺寸的半正定矩阵,则 A ∘ B 亦为半正定。
该定理带来若干重要影响:
哈达玛积的计算特性使其在大规模数据处理应用中尤具吸引力。理解其效率特征与实现考量,有助于在计算环境中优化性能。
对于两个尺寸为 m × n 的矩阵,哈达玛积的时间复杂度为 O(mn),每个元素仅需一次乘法运算。与此形成鲜明对比的是,使用传统算法进行方阵的标准矩阵乘法其复杂度为 O(n³)。
|
操作 |
时间复杂度 |
空间复杂度 |
|
哈达玛积 |
O(mn) |
O(mn) |
|
标准矩阵乘法 |
O(n³) |
O(n²) |
|
矩阵加法 |
O(mn) |
O(mn) |
线性复杂度使哈达玛积尤为适合于:
计算哈达玛积时需注意的实际问题包括:
扩展到更高维张量时,会出现额外复杂性:
NumPy 可直接使用 * 运算符实现哈达玛积:
import numpy as np

# Define matrices
A = np.array([[2, 4], [1, 3], [5, 2]])
B = np.array([[3, 1], [2, 4], [1, 6]])

# Compute Hadamard product
C = A * B
print(C)
# Output: [[ 6  4]
#          [ 2 12]
#          [ 5 12]]

# Alternative explicit notation
C_explicit = np.multiply(A, B)
NumPy 的性能优化:
# For large matrices, ensure proper data types
A = A.astype(np.float32)  # Use float32 for memory efficiency
B = B.astype(np.float32)

# Pre-allocate output array for memory efficiency
C = np.empty_like(A)
np.multiply(A, B, out=C)R:
# C <- A * B  # Element-wise multiplication is default

matrix1 <- matrix(
  c(1, 2, 3,
    4, 5, 6,
    7, 8, 9),
  nrow = 3,
  ncol = 3,
  byrow = TRUE
)

# Create the second matrix (3x3)
matrix2 <- matrix(
  c(9, 8, 7,
    6, 5, 4,
    3, 2, 1),
  nrow = 3,
  ncol = 3,
  byrow = TRUE
)

matrix1
matrix2
matrix1 * matrix2
[,1] [,2] [,3]
[1,] 1 2 3
[2,] 4 5 6
[3,] 7 8 9
[,1] [,2] [,3]
[1,] 9 8 7
[2,] 6 5 4
[3,] 3 2 1
[,1] [,2] [,3]
[1,] 9 16 21
[2,] 24 25 24
[3,] 21 16 9Julia:
C = A .* B # Broadcasting element-wise multiplication 类型兼容性:确保矩阵数据类型兼容,避免意外的类型提升或精度损失。
# Avoid mixing integer and float types unnecessarily
A = np.array([[1, 2]], dtype=np.int32)
B = np.array([[1.5, 2.5]], dtype=np.float64)
C = A * B # Results in float64, may not be intended理解广播机制:理解广播如何工作,以避免意料之外的维度扩展。
# Be explicit about intended operations
A = np.array([[1, 2, 3]])      # Shape: (1, 3)
B = np.array([[1], [2], [3]])  # Shape: (3, 1)
C = A * B # Results in (3, 3) matrix due to broadcasting内存管理:对于大规模运算,考虑使用就地操作与预分配内存。
# In-place operation to save memory
A *= B  # Modifies A directly

# Pre-allocate for repeated operations
result = np.empty((1000, 1000))
for i in range(iterations):
np.multiply(matrix1, matrix2, out=result)流水线集成:在机器学习工作流中,确保哈达玛运算能与自动微分框架顺畅集成并保持梯度传递。
哈达玛积用于那些既需进行局部变换、又需保留矩阵结构的操作。
在 JPEG 解码中,哈达玛积用于将量化矩阵与变换后的图像系数相结合,以重建视觉数据。在图像增强任务中,它通过与滤波掩膜的按元素相乘实现选择性操作(如噪声抑制),并通过对像素邻域施加空间权重矩阵来实现可控的锐化或模糊。
哈达玛积可通过对设计矩阵施加按元素权重来实现加权回归,并通过对矩阵元素进行选择性缩放来支持稳健的协方差估计。该运算在核方法与半定规划中至关重要,因为它能保持有效统计模型所需的半正定性,也因此有利于对协方差结构施加按元素约束的正则化技术。
哈达玛积广泛出现在循环神经网络架构中,尤其是 GRU 与 LSTM,通过按元素的门控机制控制信息流。StyleGAN、SENet 等现代架构利用其进行自适应特征缩放;注意力机制也采用按元素乘法来为特征表示加权,从而显著提升序列建模与生成任务的效率与表现。
在信号处理中,哈达玛积用于频域滤波与谱分析,通过与传递函数按元素相乘来改变信号特性。在图论中,它支持在邻接矩阵上进行按顶点的操作;在组合数学中,它适用于对计数矩阵的按元素处理与离散优化问题。
如果您希望进一步探索支撑现代机器学习与深度学习的更多数学概念,我们的 Demystifying Mathematical Concepts for Deep Learning 教程将为您提供更多关于推动当今 AI 创新的数学基础见解,此外也可报名我们的 Linear Algebra for Data Science in R 课程来夯实基础。
与 DataCamp 一起学习
课程
课程
课程