
课程
Python 中的超参数调优
4 小时
25.4K
模型准确率不佳并不是因为您选错了算法——而是因为您从未对它进行调优。
大多数人用默认设置训练一个模型,看到准确率徘徊在 80% 左右,就断言该算法不适合他们的任务。但算法不是问题所在。每个机器学习模型都有控制其学习方式的参数,这些参数在训练开始之前就已设定。如果设得合适,您可以在相同模型和相同数据上再多拿出 10%–20% 的准确率。
这些参数称为超参数。是否选得好,决定了模型只是“还行”还是“几乎总能答对”。超参数调优就是搜索能带来最佳性能的组合的过程。
本文将带您了解什么是超参数调优、哪些搜索策略最有效、如何在不自欺的情况下评估结果,以及如何在 Python 和 R 中完成这一切。
如果您是数据科学与机器学习新手,建议先学习Python 机器学习基础课程,再开展更高级的主题。
超参数调优是寻找能让模型学得最好的设置的过程。
每个机器学习模型都有两类数值。一类在训练过程中从数据中学习得到,比如神经网络中的权重,或决策树中的分裂点。另一类在训练开始前就设定好,即超参数。它们控制模型如何学习——多快、多深、是更应当泛化还是更倾向记忆。
默认超参数的存在是为了让模型跑起来,并非为了让它在您的特定数据集上达到最佳。一个适用于图像分类的默认学习率,逻辑上并不一定适合表格数据。对干净数据集尚可的默认树深度,在噪声较多的数据上会过拟合。道理就是这样。
调优的过程会在不同的超参数取值组合间搜索,对每个组合训练一个模型,并保留在验证数据上表现最好的那个。
通常,这带来的提升甚至优于切换到一个更“高级”但未调优的算法。
区别在于由谁、何时设定。
模型参数由算法在训练期间学习得到。您不会手动设置它们。训练过程通过查看数据并最小化损失函数来调整参数。例如:
超参数由您在训练开始前选择。它们控制学习过程的工作方式,但算法本身不会对其做任何调整。如果您不设置,库就会使用默认值。例如:
下面是并排对比:
| 模型参数 | 超参数 | |
|---|---|---|
| 设定者 | 训练算法 | 您 |
| 设定时机 | 训练期间 | 训练之前 |
| 是否从数据中学习 | 是 | 否 |
| 示例 | 权重、系数、分裂点 | 学习率、树深、正则化强度 |
| 不同运行间是否变化 | 每次重新训练都会变化 | 仅当您改变它们时才变化 |
模型参数回答“学到了什么”。超参数回答“如何去学”。
调优是一个循环。
您先选定要搜索的超参数,并为每个超参数定义一个取值范围。随后用某个取值组合训练模型,在验证数据上评估效果,再根据结果决定下一步尝试什么。
循环大致如下:
迭代间如何更新,决定了不同搜索方法的区别。手动调优靠直觉更新;网格搜索依次遍历预定义列表;贝叶斯方法会建立一个关于哪些组合可能有效的模型来更新。
下面逐一介绍这些方法。
您选择的搜索方法决定了计算消耗多少,以及找到好超参数的可能性有多大。
手动搜索是最简单的方法。您选定一组超参数,训练模型,查看结果,再基于所见进行调整。
当模型较小、超参数不多,且您对算法有经验时,这种方法可行。如果您已经知道 XGBoost 往往喜欢 0.05 左右的学习率和 6 的树深,就可以从这里开始,再根据观察调整。
当搜索空间变大时,手动搜索就不行了。三个超参数各有五个合理取值,就已经是 125 种组合了,没有人会手动调 125 个模型。
网格搜索会检查预定义取值列表中的每一种组合。
您定义一个网格——例如学习率取 [0.01, 0.05, 0.1],树深取 [3, 5, 7]——网格搜索就会为这九种组合各训练一个模型。它穷举且可复现。
问题在于计算成本。
再增加一个有五个取值的超参数,训练次数就会乘以五。网格搜索也会在不重要的取值上浪费精力——如果树深对分数几乎没影响,网格搜索仍会为您列出的每个深度训练一个模型。
对于只有两三个超参数的小搜索空间,网格搜索是不错的默认选择。
随机搜索会从取值范围中随机抽样组合,而不是按固定网格逐一遍历。
您为每个超参数定义一个分布,随机搜索就从这些分布中抽取组合。它比网格搜索更高效,因为不会在无关紧要的取值上浪费训练——如果三项超参数中只有一项影响性能,随机搜索仍会在很多不同取值上探索那一项重要超参数。
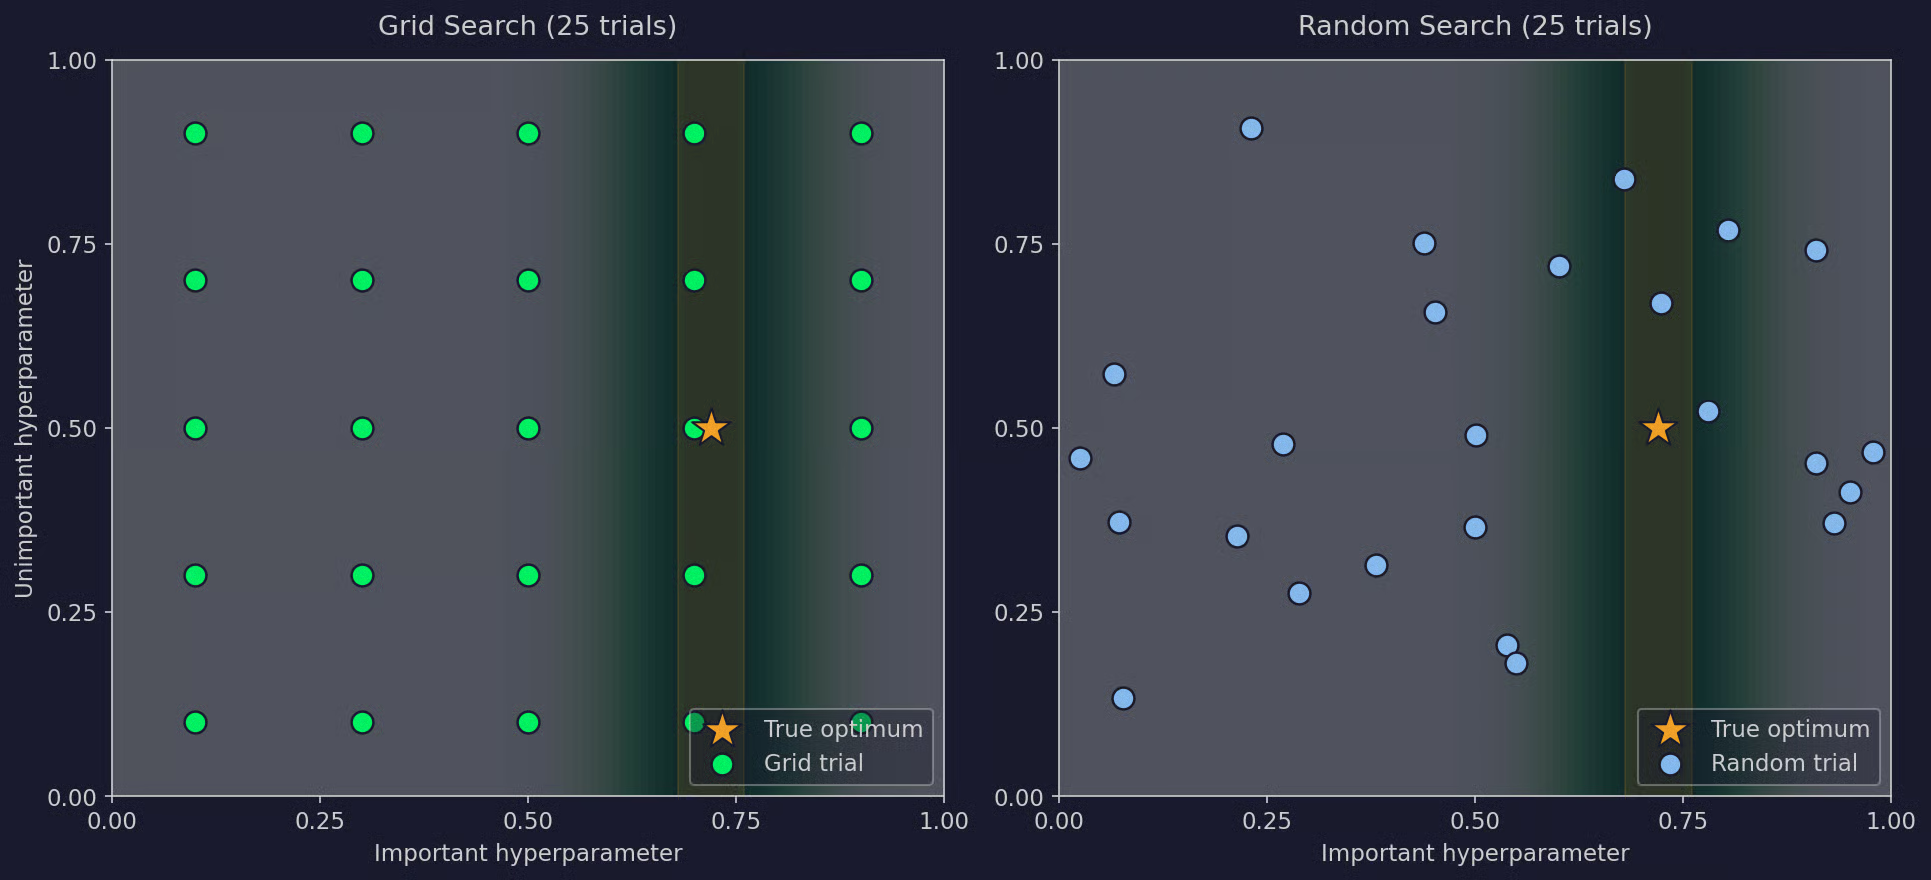
网格搜索 vs 随机搜索
对于超参数多于两项的情况,随机搜索是更好的默认选择。
贝叶斯优化会利用先前试验的结果来决定下一步尝试什么。
它构建一个关于“超参数组合如何映射到性能”的概率模型,然后选择下一个组合,该组合要么具有最高的期望得分,要么具有最高的不确定性。这就是探索与利用的权衡:要么探索可能不错的新区域,要么利用已知不错的区域。
与随机或网格搜索相比,贝叶斯方法用远更少的试验就能找到好的超参数。代价是每次试验会稍慢些,因为算法在选择下一个点前需要拟合其内部模型。Optuna 和 Hyperopt 等库可帮您完成这些。
当训练代价高昂、您只能负担少量运行时,使用贝叶斯优化。
逐次淘汰与 Hyperband 通过及早停止表现差的运行来降低计算时间。
逐次淘汰会用较小的训练预算启动许多超参数组合,淘汰最差的一半,为留下来的组合将预算加倍,并重复上述过程。
Hyperband 是逐次淘汰的封装器,会用不同的预算划分多次运行,这样您就无需猜测正确的起始配置。
当训练很慢且搜索空间很大时,这两种方法都很有用。它们在“早期性能能够较好指示最终性能”的情形下效果最佳,如神经网络与梯度提升。
以下是各方法对比:
| 计算成本 | 搜索效率 | 最佳适用场景 | |
|---|---|---|---|
| 手动搜索 | 低 | 低 | 小型模型、具备先验经验 |
| 网格搜索 | 高 | 低 | 2–3 个超参数、小范围取值 |
| 随机搜索 | 中 | 中 | 4 个以上超参数、重要性未知 |
| 贝叶斯优化 | 中 | 高 | 训练代价高、预算小 |
| 逐次淘汰 / Hyperband | 低到中 | 高 | 大搜索空间、训练缓慢 |
如果您不选择合适的取值范围,调优走不远。
如果评估方式有误,您会选错超参数。需要处理好四件事——如何划分数据、如何度量性能、优化哪个指标,以及如何保持测试集的“干净”。
在调优前,将数据分为三部分。
训练集用于模型学习。验证集用于在调优期间为每个超参数组合打分。测试集只在最后一次使用,用于衡量最终模型在未见数据上的表现。
如果您针对测试集调优,会得到一个看似很好的准确率数字,但模型在生产中的表现会打折。您基于测试集做的每个调优决策,都会将它的信息泄漏进模型。
常见的划分是中等规模数据集 60/20/20,或更大数据集 80/10/10。
当验证集偏小,交叉验证是一种更好的超参数打分方式。
将训练数据分为 k 折——通常为 5 或 10。对每个超参数组合,在 k-1 折上训练、在剩余一折上验证,然后轮换。最终分数是所有折的平均值。
交叉验证能更稳定地估计某个超参数组合的泛化能力,因为您不再依赖于某一次“幸运”或“不幸”的验证划分。代价是每个组合需要训练 k 个模型,而不是一个。
当数据集较小、单次验证划分不够可靠且您能负担额外训练成本时,使用交叉验证。
您要优化的指标应与您真正关心的目标一致。
准确率适用于类别均衡的分类,但对不均衡问题就没意义。比如,一个把所有样本都预测为“非欺诈”的欺诈检测模型,准确率也能达到 99%,却漏掉所有实际案例。针对不均衡分类,用精确率、召回率、F1 或 ROC-AUC。针对回归,根据是否在意离群点,使用 RMSE、MAE 或 R 平方。
在开始调优前,选定一个主要指标并始终坚持使用它。
当验证集或测试集的信息进入训练过程时,就发生了数据泄漏。
以下是一些常见情形:
所有预处理步骤只在训练集上拟合,再应用到验证与测试。在 scikit-learn 中,这正是 Pipeline 的用途——将预处理与建模封装为一个对象,严格遵守数据划分。
大多数机器学习库都内置了搜索与交叉验证工具,您无需从零实现。
Scikit-learn 提供了两类覆盖大多数用例的调优类——用于网格搜索的 GridSearchCV 和用于随机搜索的 RandomizedSearchCV。二者可包裹任意 scikit-learn 估计器,对每个组合执行交叉验证,并最终返回最佳模型。
GridSearchCV 接收一个估计器、一个超参数取值字典以及交叉验证折数。它会为每个组合训练模型,并保留得分最高的那个。
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, random_state=42)

param_grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [5, 10, 20],
    "min_samples_leaf": [1, 5, 10],
}

grid = GridSearchCV(RandomForestClassifier(random_state=42), param_grid, cv=5)
grid.fit(X, y)

print(grid.best_params_)
print(grid.best_score_)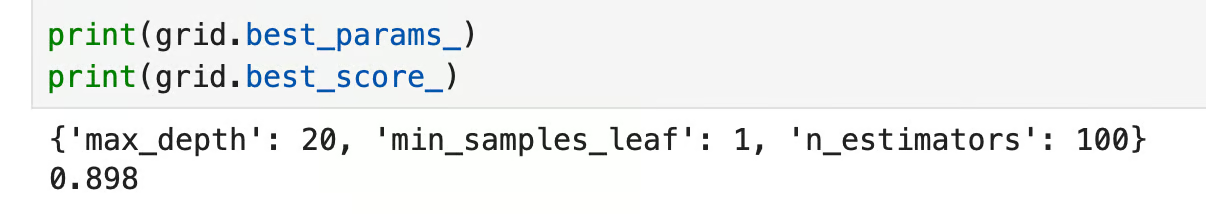
Python 中的 GridSearchCV 结果
RandomizedSearchCV 使用相同的接口,但会从分布中抽样,而非遍历固定列表。这让您在固定试验次数下覆盖更广范围。
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

param_dist = {
    "n_estimators": randint(100, 500),
    "max_depth": randint(3, 20),
    "min_samples_leaf": randint(1, 10),
}

random_search = RandomizedSearchCV(
    RandomForestClassifier(random_state=42),
    param_dist,
    n_iter=30,
    cv=5,
    random_state=42,
)
random_search.fit(X, y)

print(random_search.best_params_)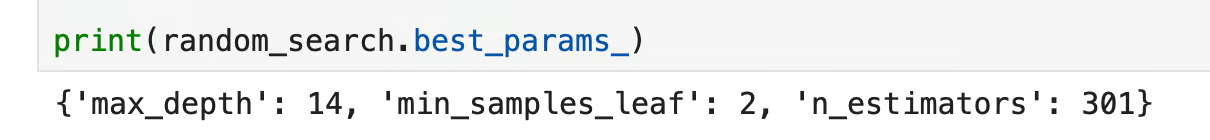
Python 中的 RandomizedSearchCV 结果
对于贝叶斯优化,Optuna 是标准之选。它会基于以往结果选择下一个组合,因此当训练代价较高时,比随机搜索收敛更快。
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 100, 500),
        "max_depth": trial.suggest_int("max_depth", 3, 20),
        "min_samples_leaf": trial.suggest_int("min_samples_leaf", 1, 10),
    }
    model = RandomForestClassifier(**params, random_state=42)
    return cross_val_score(model, X, y, cv=5).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)

print(study.best_params)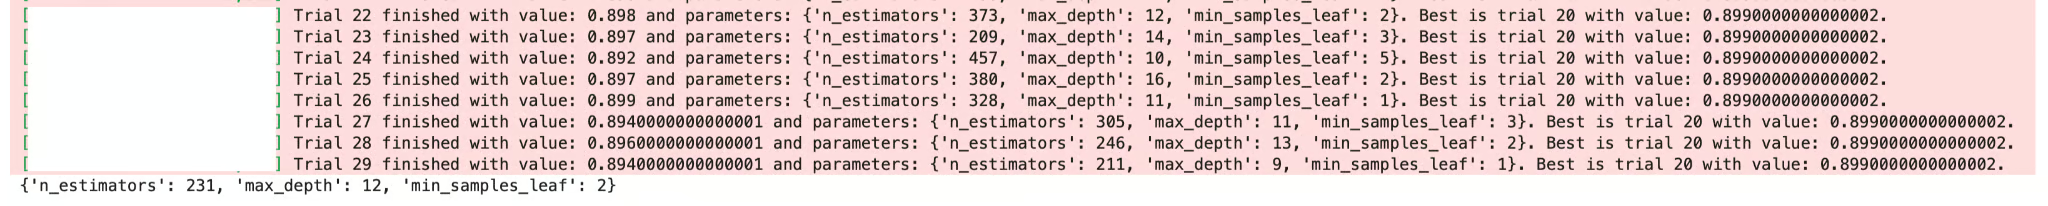
Python 中的 Optuna 结果
trial.suggest_* 方法定义搜索空间,Optuna 根据目前看到的得分来决定下一步尝试的组合。
R 有两个很棒的选择——caret 和 tidymodels。两者都能完成相同的事情——定义网格、运行交叉验证、返回最佳模型——但 tidymodels 是现代默认之选。
使用 caret,您将调优网格传给 train() 函数,并指定重采样方法。
library(caret)

data <- iris
ctrl <- trainControl(method = "cv", number = 5)

grid <- expand.grid(
  mtry = c(2, 3, 4)
)

model <- train(
  Species ~ .,
  data = data,
  method = "rf",
  trControl = ctrl,
  tuneGrid = grid
)

print(model$bestTune)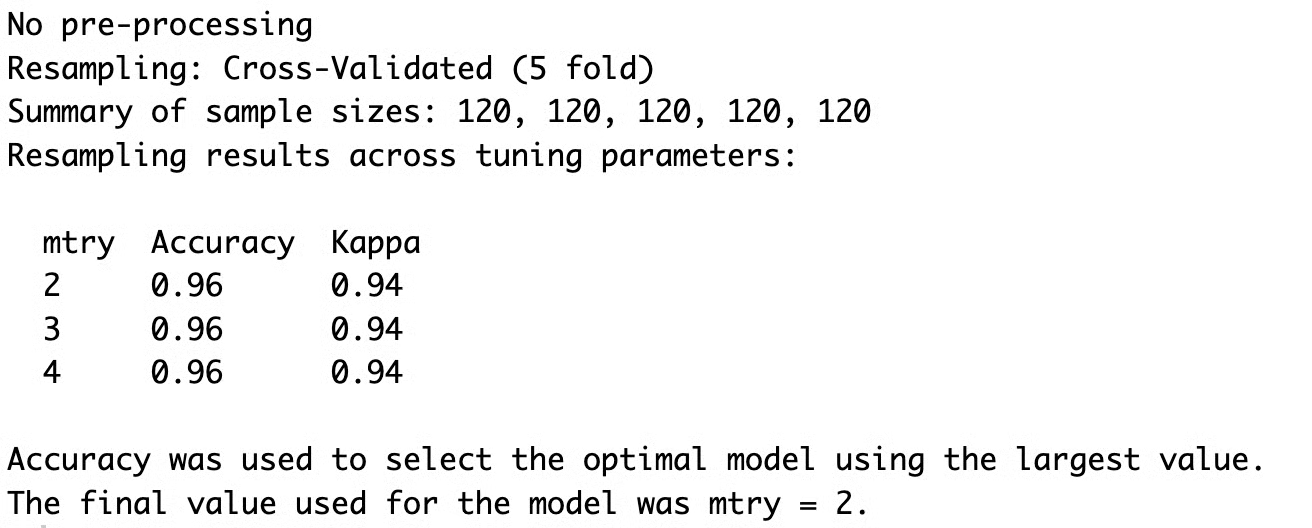
R 中的 Caret 结果
tidymodels 将工作流程拆分为清晰的步骤——模型规范、预处理配方和调优网格。更为详尽,但在实践中更具可扩展性。
library(tidymodels)

data <- iris
split <- initial_split(data, prop = 0.8)
train_data <- training(split)

rf_spec <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")

grid <- grid_regular(
  mtry(range = c(2, 4)),
  trees(range = c(100, 500)),
  min_n(range = c(1, 10)),
  levels = 3
)

folds <- vfold_cv(train_data, v = 5)

results <- tune_grid(
  rf_spec,
  Species ~ .,
  resamples = folds,
  grid = grid
)

show_best(results, metric = "accuracy")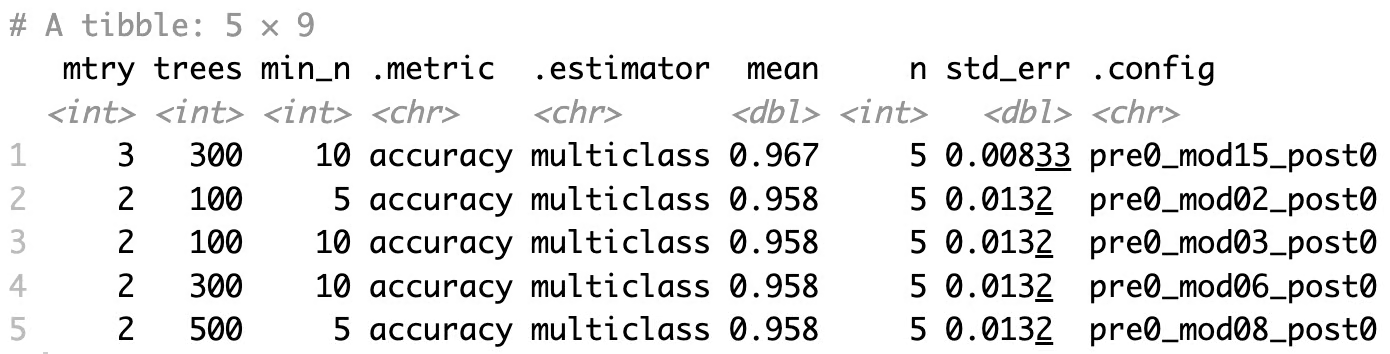
R 中的 Tidymodels 结果
该工作流程与 Python 完全一致——定义要搜索的内容、定义打分方式,然后交由库运行循环。
不是每个超参数都值得调,因为通常只有少数几个主导性能。下面按模型家族列出通常最先要调的那些。
这三个应始终调优:
梯度提升(XGBoost、LightGBM、CatBoost)对超参数比随机森林更敏感。关注这些:
对于 SVM,超参数选择影响很大,甚至可能超过其他模型:
rbf 开始,高维稀疏数据用 linear。神经网络在常见模型家族中拥有最大的搜索空间。先调这些:
1e-4、1e-3、1e-2。调优很耗资源,尤其当您想为每个参数测试多个取值且参数很多时。以下是一些常见挑战。
计算成本是最大的约束。您尝试的每个组合都意味着训练一个完整模型,交叉验证还要将其乘以折数。一个包含 100 种组合且 5 折的网格就是 500 次拟合。如果每次拟合耗时 10 分钟,那就是三天多。
庞大的搜索空间呈乘法增长。五个超参数、每个五个取值就是 3,125 种组合。此时网格搜索已不现实,需要用随机搜索或贝叶斯方法替代。
边际收益递减往往比多数人预期来得更早。前几轮调优通常带来最大收益。后续 50 轮可能只再挤出 1% 的准确率提升。到某个节点,额外算力更值得花在获取更多数据或改进特征上。
准确率与时间的权衡在生产中比在开发中更重要。若一个模型高出 0.5% 的得分,却需要双倍训练时间,而您需要每日重训,那可能不值得。您应事先决定:多少准确率值得花多少算力。
调优机器学习模型的超参数时,建议遵循以下良好习惯:
[0.001, 100],您会在永远不奏效的取值上浪费时间。先用已知对该算法合理的范围,再基于观察逐步收窄。多数调优失败源于一些容易避免的错误。以下是几个例子:
两者都能提升模型,但发力点不同。
特征工程提升输入数据。您从现有特征中构造新特征、对类别变量编码、处理缺失值并去除噪声。更好的特征能为模型提供更有用的学习信号。
超参数调优则提升模型如何从给定特征中学习。它改变的是算法在数据上的行为,而不是改变数据本身。
两者相辅相成。项目早期、数据仍较原始且模型缺失明显信号时,特征工程通常带来最大收益。特征足够好后,超参数调优能带来更小但稳定的提升。
如果模型遇到瓶颈、不确定该先做哪一个,就看错误分析。如果模型错过了数据中看似显而易见的模式,是特征问题;如果过拟合或欠拟合,是调优问题。
调优是任何机器学习工作流中的标准步骤。
它常常比更换算法带来更大的收益。比如,在同一数据上,一个调优良好的随机森林往往能胜过一个调优糟糕的梯度提升模型,尽管后者更为复杂。
调优也有助于泛化。像最大深度、dropout 率这样的超参数,直接控制模型的过拟合程度。把这些设对,是区分“只会背训练集”与“在新数据上也表现良好”的关键。
在生产中,调优能将概念验证变成可靠的系统。
默认设置能让您起步,但并不能在重训与业务要求下保持模型的竞争力。每个严肃的机器学习团队都会把调优视为流程的一部分。
超参数调优是围绕“搜索—评估—聚焦”的迭代循环,旨在找到适合您特定数据的有效方案。
最佳结果来自三者的结合——匹配您算力预算的搜索方法、能产出相关分数的验证方式,以及可回溯尝试历史的实验跟踪。
从随机搜索或网格搜索起步。当训练成本高到“试验次数本身很重要”时,转向贝叶斯优化。无论采用何法,都要调与您的模型相关的超参数,保持测试集干净,并记录每一次运行。
如果您考虑从事机器学习职业,欢迎报名我们的机器学习工程师学习路径,助您在 2026 年胜任岗位。
与 DataCamp 一起学习
课程
课程
课程