
Khóa học
Tinh chỉnh siêu tham số trong Python
4 giờ
25.4K
Độ chính xác của mô hình không tệ vì bạn chọn sai thuật toán - mà vì bạn chưa từng điều chỉnh nó.
Đa số mọi người huấn luyện mô hình với thiết lập mặc định, thấy độ chính xác quanh quẩn 80% rồi kết luận thuật toán không phù hợp. Nhưng vấn đề không nằm ở thuật toán. Mỗi mô hình ML đều có các tham số kiểm soát cách nó học, và chúng được đặt trước khi quá trình huấn luyện bắt đầu. Nếu chọn đúng, bạn có thể tăng thêm 10–20% độ chính xác với cùng mô hình trên cùng dữ liệu.
Những tham số này gọi là siêu tham số (hyperparameter), và việc chọn tốt sẽ phân biệt một mô hình tạm ổn với mô hình gần như luôn đúng. Điều chỉnh siêu tham số là quá trình tìm kiếm tổ hợp mang lại hiệu năng cao nhất.
Trong bài viết này, tôi sẽ hướng dẫn bạn siêu tham số là gì, các chiến lược tìm kiếm hiệu quả, cách đánh giá kết quả mà không tự đánh lừa mình, và cách chạy tất cả bằng Python và R.
Nếu bạn mới bắt đầu với khoa học dữ liệu và học máy, hãy xem khóa Những nền tảng Học máy bằng Python trước khi làm các chủ đề nâng cao hơn.
Điều chỉnh siêu tham số là quá trình tìm ra các thiết lập giúp mô hình học tốt nhất.
Mỗi mô hình ML có hai loại con số. Một số được học từ dữ liệu trong quá trình huấn luyện, như trọng số trong mạng nơ-ron hay điểm chia trong cây quyết định. Số khác được đặt trước khi huấn luyện bắt đầu, đó là siêu tham số. Chúng kiểm soát cách mô hình học - nhanh chậm ra sao, sâu đến mức nào, nên tổng quát hóa hay ghi nhớ bao nhiêu.
Giá trị mặc định của siêu tham số tồn tại để mô hình có thể chạy. Chúng không nhằm tạo ra mô hình tốt nhất cho bộ dữ liệu cụ thể của bạn. Tốc độ học mặc định hợp lý cho phân loại ảnh sẽ khó mà tốt trên dữ liệu dạng bảng. Độ sâu cây mặc định ổn với dữ liệu sạch sẽ bị quá khớp trên dữ liệu nhiễu. Bạn hiểu ý rồi đấy.
Quá trình điều chỉnh sẽ tìm kiếm qua các tổ hợp giá trị siêu tham số khác nhau, huấn luyện mô hình cho mỗi tổ hợp, và giữ lại tổ hợp có hiệu năng tốt nhất trên dữ liệu xác thực của bạn.
Kết quả thường tốt hơn cả việc chuyển sang một thuật toán “tốt hơn” nhưng chưa được điều chỉnh.
Khác biệt nằm ở người đặt và thời điểm đặt.
Tham số mô hình được thuật toán học trong quá trình huấn luyện. Bạn không tự đặt chúng. Quá trình huấn luyện điều chỉnh chúng bằng cách quan sát dữ liệu và tối thiểu hóa hàm mất mát. Ví dụ:
Siêu tham số do bạn chọn trước khi huấn luyện bắt đầu. Chúng kiểm soát cách quá trình học diễn ra, và thuật toán sẽ không tự điều chỉnh chúng. Nếu bạn không đặt, thư viện sẽ dùng mặc định. Ví dụ:
So sánh nhanh như sau:
| Tham số mô hình | Siêu tham số | |
|---|---|---|
| Đặt bởi | Thuật toán huấn luyện | Bạn |
| Khi nào | Trong khi huấn luyện | Trước khi huấn luyện |
| Học từ dữ liệu | Có | Không |
| Ví dụ | Trọng số, hệ số, điểm chia | Tốc độ học, độ sâu cây, độ mạnh điều chuẩn |
| Thay đổi giữa các lần chạy | Mỗi lần bạn huấn luyện lại | Chỉ khi bạn thay đổi chúng |
Tham số mô hình trả lời mô hình đã học gì. Siêu tham số trả lời nó đã học như thế nào.
Điều chỉnh là một vòng lặp.
Bạn bắt đầu bằng cách chọn các siêu tham số cần tìm kiếm và xác định khoảng giá trị cho mỗi cái. Sau đó huấn luyện mô hình với một tổ hợp, đo lường hiệu năng trên dữ liệu xác thực, và dùng kết quả đó để quyết định bước tiếp theo.
Vòng lặp trông như sau:
Cách bạn cập nhật giữa các vòng lặp là thứ phân biệt các phương pháp tìm kiếm. Điều chỉnh thủ công dựa vào trực giác. Grid search đi qua danh sách định sẵn. Phương pháp Bayes xây dựng mô hình xác suất về những tổ hợp có khả năng tốt.
Tiếp theo tôi sẽ đi sâu vào các phương pháp này.
Phương pháp tìm kiếm bạn chọn quyết định mức độ tiêu tốn tài nguyên và khả năng tìm ra siêu tham số tốt.
Tìm kiếm thủ công là phương pháp đơn giản nhất. Bạn chọn một tổ hợp siêu tham số, huấn luyện mô hình, xem kết quả, và điều chỉnh dựa trên quan sát.
Hữu ích khi mô hình nhỏ, ít siêu tham số, và bạn có kinh nghiệm trước đó với thuật toán. Nếu bạn đã biết XGBoost thường thích tốc độ học khoảng 0.05 và độ sâu cây là 6, bạn có thể bắt đầu ở đó rồi điều chỉnh theo những gì quan sát được.
Tìm kiếm thủ công không hiệu quả khi không gian tìm kiếm lớn. Ba siêu tham số với năm giá trị hợp lý mỗi cái đã cho 125 tổ hợp, và không ai điều chỉnh tay 125 mô hình cả.
Grid search kiểm tra mọi tổ hợp trong một danh sách giá trị định sẵn.
Bạn định nghĩa một lưới - ví dụ, tốc độ học [0.01, 0.05, 0.1] và độ sâu cây [3, 5, 7] - và grid search sẽ huấn luyện mô hình cho cả chín tổ hợp. Nó toàn diện và có thể tái lập.
Vấn đề là chi phí tính toán.
Thêm một siêu tham số với năm giá trị sẽ nhân số lần huấn luyện của bạn lên năm lần. Grid search cũng lãng phí công sức ở các giá trị ít quan trọng - nếu độ sâu cây hầu như không ảnh hưởng điểm số, grid search vẫn huấn luyện mô hình cho mọi độ sâu bạn liệt kê.
Grid search là lựa chọn mặc định tốt cho không gian nhỏ với hai hoặc ba siêu tham số.
Random search lấy mẫu ngẫu nhiên các tổ hợp từ một khoảng giá trị thay vì đi theo lưới cố định.
Bạn định nghĩa một phân phối cho mỗi siêu tham số và random search sẽ rút mẫu tổ hợp từ các phân phối đó. Nó hiệu quả hơn grid search vì không lãng phí lần chạy ở các giá trị không quan trọng - nếu chỉ một trong ba siêu tham số ảnh hưởng đến hiệu năng, random search vẫn khám phá sâu siêu tham số quan trọng đó với nhiều giá trị khác nhau.
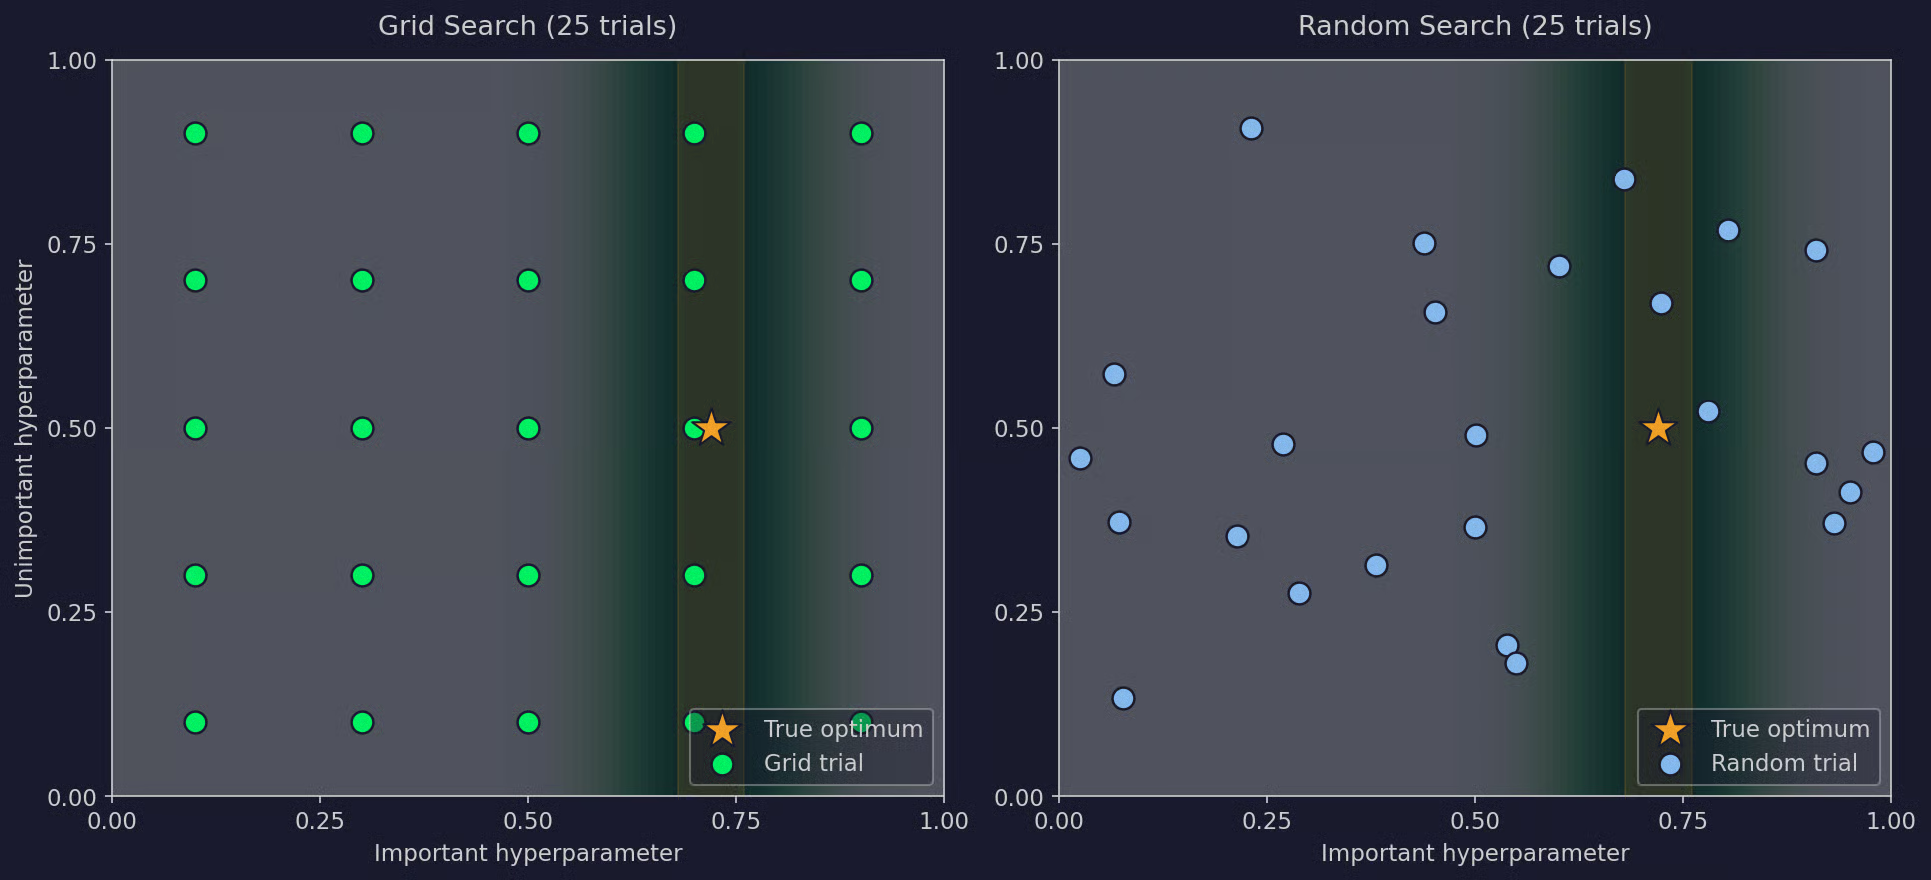
Grid search và random search
Random search là lựa chọn mặc định tốt hơn cho bất cứ thứ gì có hơn hai siêu tham số.
Tối ưu hóa Bayes dùng kết quả từ các lần thử trước để quyết định thử gì tiếp theo.
Nó xây dựng một mô hình xác suất ánh xạ từ tổ hợp siêu tham số tới hiệu năng, rồi chọn tổ hợp tiếp theo hoặc có điểm kỳ vọng cao nhất, hoặc có độ bất định cao nhất. Đây là đánh đổi thăm dò - khai thác: hoặc bạn thăm dò vùng mới có tiềm năng, hoặc khai thác vùng đã biết là tốt.
Phương pháp Bayes tìm siêu tham số tốt trong ít lần thử hơn nhiều so với random hay grid search. Đánh đổi là mỗi lần thử tốn thêm chút thời gian vì thuật toán phải khớp mô hình nội bộ trước khi chọn điểm kế tiếp. Thư viện như Optuna và Hyperopt làm việc này cho bạn.
Dùng tối ưu hóa Bayes khi huấn luyện đắt đỏ và bạn chỉ đủ khả năng chạy ít lần.
Successive halving và Hyperband giảm thời gian tính toán bằng cách dừng sớm các lần chạy kém.
Successive halving khởi động nhiều tổ hợp siêu tham số với ngân sách huấn luyện nhỏ, loại bỏ một nửa tệ nhất, nhân đôi ngân sách cho phần còn lại, và lặp lại.
Hyperband là lớp bọc quanh successive halving, chạy nhiều lần với các cách chia ngân sách khác nhau, để bạn không phải đoán cấu hình khởi đầu phù hợp.
Cả hai hữu ích khi huấn luyện chậm và không gian tìm kiếm lớn. Chúng hiệu quả nhất khi hiệu năng sớm là tín hiệu khá tốt cho hiệu năng cuối, thường đúng với mạng nơ-ron và boosting theo gradient.
So sánh các phương pháp như sau:
| Chi phí tính toán | Hiệu quả tìm kiếm | Phù hợp nhất cho | |
|---|---|---|---|
| Tìm kiếm thủ công | Thấp | Thấp | Mô hình nhỏ, có kinh nghiệm trước |
| Grid search | Cao | Thấp | 2–3 siêu tham số, khoảng nhỏ |
| Random search | Trung bình | Trung bình | 4+ siêu tham số, tầm quan trọng chưa rõ |
| Tối ưu hóa Bayes | Trung bình | Cao | Huấn luyện đắt đỏ, ngân sách nhỏ |
| Successive halving / Hyperband | Thấp đến trung bình | Cao | Không gian lớn, huấn luyện chậm |
Điều chỉnh sẽ không đi xa nếu bạn không chọn đúng khoảng giá trị.
Nếu đánh giá sai, bạn sẽ chọn siêu tham số không đúng. Có bốn thứ cần làm đúng - cách bạn chia dữ liệu, cách đo lường hiệu năng, chỉ số bạn tối ưu, và cách giữ tập kiểm tra sạch.
Chia dữ liệu thành ba phần trước khi điều chỉnh.
Tập huấn luyện là nơi mô hình học. Tập xác thực dùng để chấm điểm mỗi tổ hợp siêu tham số trong quá trình điều chỉnh. Tập kiểm tra chỉ dùng một lần, ở cuối cùng, để đo mô hình cuối cùng hoạt động ra sao trên dữ liệu chưa thấy.
Nếu bạn điều chỉnh dựa trên tập kiểm tra, bạn sẽ có một con số độ chính xác đẹp mắt nhưng mô hình kém trong sản xuất. Mỗi quyết định điều chỉnh dựa trên tập kiểm tra đều làm rò rỉ thông tin của nó vào mô hình.
Một cách chia phổ biến là 60/20/20 cho bộ dữ liệu cỡ trung hoặc 80/10/10 cho bộ lớn.
Cross-validation là cách chấm điểm siêu tham số tốt hơn khi tập xác thực nhỏ.
Bạn chia dữ liệu huấn luyện thành k phần - thường là 5 hoặc 10. Với mỗi tổ hợp siêu tham số, bạn huấn luyện trên k-1 phần và xác thực trên phần còn lại, rồi xoay vòng. Điểm cuối là trung bình qua tất cả các phần.
Cross-validation cho ước lượng ổn định hơn về khả năng tổng quát hóa của tổ hợp siêu tham số, vì bạn không phụ thuộc vào một lần chia xác thực may rủi. Chi phí là bạn huấn luyện k mô hình cho mỗi tổ hợp thay vì một.
Dùng cross-validation khi bộ dữ liệu đủ nhỏ để một lần chia xác thực không đáng tin, và khi bạn chịu được chi phí huấn luyện tăng thêm.
Chỉ số bạn tối ưu phải khớp với điều bạn thực sự quan tâm.
Accuracy ổn cho phân loại cân bằng nhưng không hợp cho bài toán mất cân bằng. Ví dụ, mô hình phát hiện gian lận dự đoán “không gian lận” cho tất cả có thể đạt 99% accuracy nhưng bỏ lỡ mọi ca. Với phân loại mất cân bằng, hãy dùng precision, recall, F1, hoặc ROC-AUC. Với hồi quy, dùng RMSE, MAE, hoặc R bình phương tùy việc ngoại lệ có quan trọng không.
Hãy chọn một chỉ số chính trước khi bắt đầu điều chỉnh và bám theo nó.
Rò rỉ dữ liệu xảy ra khi thông tin từ tập xác thực hoặc kiểm tra lọt vào huấn luyện.
Một số cách phổ biến gây ra điều này:
Fit tất cả bước tiền xử lý trên tập huấn luyện, rồi áp dụng cho xác thực và kiểm tra. Trong scikit-learn, đó là mục đích của Pipeline - nó gói tiền xử lý và mô hình hóa vào một đối tượng, tôn trọng cách bạn chia tập.
Hầu hết thư viện ML đều có công cụ thực hiện tìm kiếm và cross-validation, nên bạn không cần tự triển khai từ đầu.
Scikit-learn có hai lớp điều chỉnh bao phủ hầu hết trường hợp - GridSearchCV cho grid search và RandomizedSearchCV cho random search. Cả hai bọc quanh bất kỳ estimator nào của scikit-learn, chạy cross-validation cho mỗi tổ hợp, và trả lại mô hình tốt nhất.
GridSearchCV nhận một estimator, một từ điển giá trị siêu tham số, và số nếp gập cross-validation. Nó huấn luyện mô hình cho mọi tổ hợp và giữ tổ hợp có điểm tốt nhất.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, random_state=42)

param_grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [5, 10, 20],
    "min_samples_leaf": [1, 5, 10],
}

grid = GridSearchCV(RandomForestClassifier(random_state=42), param_grid, cv=5)
grid.fit(X, y)

print(grid.best_params_)
print(grid.best_score_)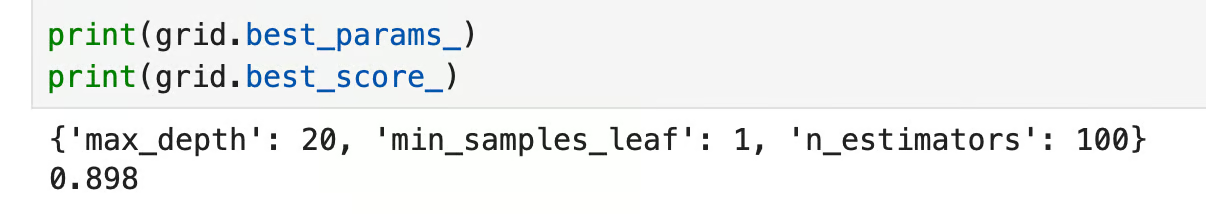
Kết quả GridSearchCV trong Python
RandomizedSearchCV dùng cùng giao diện nhưng lấy mẫu từ phân phối thay vì đi qua danh sách cố định. Cách này cho phép bạn bao phủ phạm vi rộng hơn với số lần thử cố định.
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

param_dist = {
    "n_estimators": randint(100, 500),
    "max_depth": randint(3, 20),
    "min_samples_leaf": randint(1, 10),
}

random_search = RandomizedSearchCV(
    RandomForestClassifier(random_state=42),
    param_dist,
    n_iter=30,
    cv=5,
    random_state=42,
)
random_search.fit(X, y)

print(random_search.best_params_)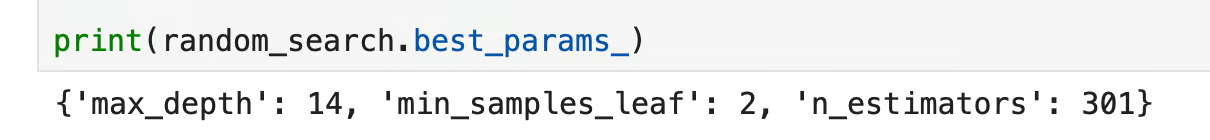
Kết quả RandomizedSearchCV trong Python
Với tối ưu hóa Bayes, Optuna là lựa chọn tiêu chuẩn. Nó chọn tổ hợp kế tiếp dựa trên kết quả trước đó, nên hội tụ nhanh hơn random search khi huấn luyện đắt đỏ.
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 100, 500),
        "max_depth": trial.suggest_int("max_depth", 3, 20),
        "min_samples_leaf": trial.suggest_int("min_samples_leaf", 1, 10),
    }
    model = RandomForestClassifier(**params, random_state=42)
    return cross_val_score(model, X, y, cv=5).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)

print(study.best_params)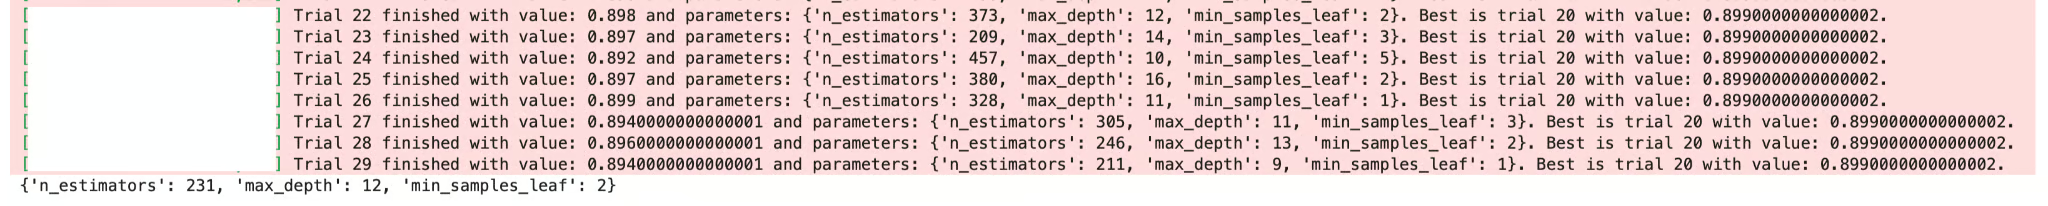
Kết quả Optuna trong Python
Các phương thức trial.suggest_* định nghĩa không gian tìm kiếm, và Optuna quyết định tổ hợp nào sẽ thử tiếp dựa trên các điểm số đã thấy.
R có hai lựa chọn tuyệt vời - caret và tidymodels. Cả hai làm điều tương tự - định nghĩa lưới, chạy cross-validation, trả lại mô hình tốt nhất - nhưng tidymodels là mặc định hiện đại.
Với caret, bạn truyền một lưới điều chỉnh vào hàm train() và chỉ định phương pháp lấy mẫu lại.
library(caret)

data <- iris
ctrl <- trainControl(method = "cv", number = 5)

grid <- expand.grid(
  mtry = c(2, 3, 4)
)

model <- train(
  Species ~ .,
  data = data,
  method = "rf",
  trControl = ctrl,
  tuneGrid = grid
)

print(model$bestTune)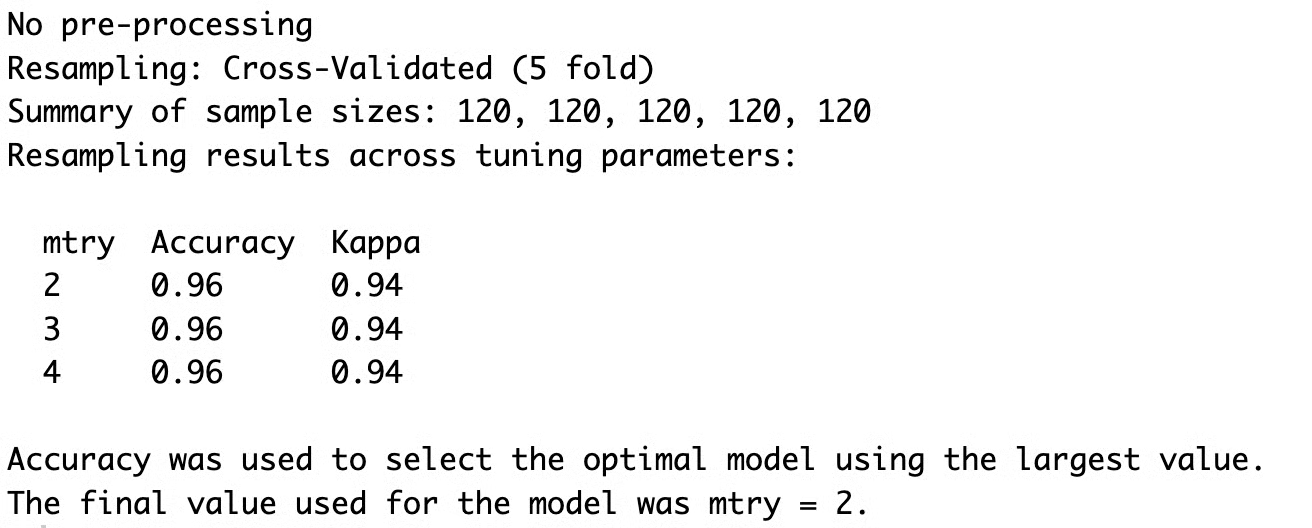
Kết quả Caret trong R
tidymodels chia quy trình công việc thành các bước rõ ràng - đặc tả mô hình, công thức tiền xử lý, và lưới điều chỉnh. Dài dòng hơn nhưng trên thực tế mở rộng tốt hơn.
library(tidymodels)

data <- iris
split <- initial_split(data, prop = 0.8)
train_data <- training(split)

rf_spec <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")

grid <- grid_regular(
  mtry(range = c(2, 4)),
  trees(range = c(100, 500)),
  min_n(range = c(1, 10)),
  levels = 3
)

folds <- vfold_cv(train_data, v = 5)

results <- tune_grid(
  rf_spec,
  Species ~ .,
  resamples = folds,
  grid = grid
)

show_best(results, metric = "accuracy")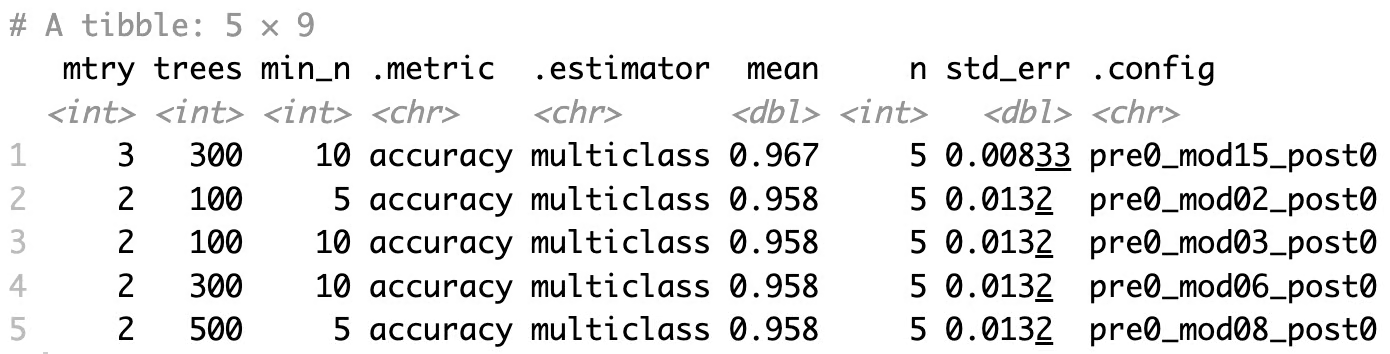
Kết quả Tidymodels trong R
Quy trình hoàn toàn giống như trong Python - bạn định nghĩa phạm vi tìm kiếm, định nghĩa cách chấm điểm, và để thư viện chạy vòng lặp.
Không phải siêu tham số nào cũng đáng điều chỉnh vì thường chỉ một vài cái quyết định phần lớn hiệu năng. Dưới đây là những cái thường quan trọng trước, theo họ mô hình.
Bạn luôn nên điều chỉnh ba thứ này:
Boosting (XGBoost, LightGBM, CatBoost) nhạy với siêu tham số hơn rừng ngẫu nhiên. Hãy chú ý đến:
Với SVM, lựa chọn siêu tham số rất quan trọng, có lẽ còn hơn các mô hình khác:
rbf cho bài toán phi tuyến và linear cho dữ liệu thưa, nhiều chiều.Mạng nơ-ron có không gian tìm kiếm lớn nhất trong các họ mô hình phổ biến. Hãy điều chỉnh các mục sau trước:
1e-4, 1e-3, 1e-2.Điều chỉnh tốn kém, đặc biệt khi bạn muốn thử nhiều giá trị cho mỗi tham số và có nhiều tham số cần điều chỉnh. Dưới đây là một số thách thức thường gặp.
Chi phí tính toán là ràng buộc lớn nhất. Mỗi tổ hợp bạn thử nghĩa là huấn luyện một mô hình đầy đủ, và cross-validation nhân số lần đó với số nếp gập. Một lưới 100 tổ hợp với CV 5 nếp là 500 lần fit. Nếu mỗi lần mất 10 phút, đó là hơn ba ngày.
Không gian tìm kiếm lớn tăng theo cấp số nhân. Năm siêu tham số với năm giá trị mỗi cái là 3.125 tổ hợp. Đây là lúc grid search không còn khả thi và nên dùng random search hoặc phương pháp Bayes.
Lợi ích giảm dần xuất hiện sớm hơn bạn nghĩ. Vài lượt điều chỉnh đầu thường mang lại mức tăng lớn nhất. 50 lượt tiếp theo có thể chỉ thêm được khoảng 1% độ chính xác. Tới một điểm, tài nguyên đó nên dành cho thu thập thêm dữ liệu hoặc cải thiện đặc trưng.
Đánh đổi giữa độ chính xác và thời gian quan trọng hơn trong sản xuất so với phát triển. Một mô hình cao hơn 0,5% nhưng mất gấp đôi thời gian huấn luyện có thể không đáng nếu bạn cần huấn luyện lại hằng ngày. Hãy quyết định trước mức độ chính xác đáng đổi lấy bao nhiêu tài nguyên.
Một số thói quen nên theo khi điều chỉnh siêu tham số cho mô hình học máy:
[0.001, 100], bạn sẽ tốn thời gian ở các giá trị không bao giờ hiệu quả. Bắt đầu với khoảng đã biết là hợp lý cho thuật toán, rồi thu hẹp theo quan sát.Đa phần thất bại khi điều chỉnh là do những lỗi dễ tránh. Dưới đây là vài lỗi:
Cả hai đều cải thiện mô hình, nhưng tác động lên những phần khác nhau của vấn đề.
Kỹ thuật đặc trưng cải thiện dữ liệu đầu vào. Bạn tạo đặc trưng mới từ đặc trưng cũ, mã hóa biến phân loại, xử lý thiếu dữ liệu, và khử nhiễu. Đặc trưng tốt hơn cho mô hình nhiều tín hiệu hữu ích hơn để học.
Điều chỉnh siêu tham số cải thiện cách mô hình học từ bất kỳ đặc trưng nào bạn cung cấp. Nó thay đổi hành vi thuật toán trên dữ liệu thay vì thay đổi dữ liệu.
Hai cách này bổ trợ cho nhau. Kỹ thuật đặc trưng thường mang lại lợi ích lớn nhất ở giai đoạn đầu của dự án, khi dữ liệu còn thô và mô hình bỏ lỡ các tín hiệu hiển nhiên. Điều chỉnh siêu tham số mang lại lợi ích nhỏ hơn nhưng ổn định khi đặc trưng đã đủ tốt.
Nếu mô hình bế tắc và bạn không chắc nên thử cái nào trước, hãy xem lỗi dự đoán. Nếu mô hình bỏ lỡ các mẫu có vẻ hiển nhiên từ dữ liệu, bạn có vấn đề về đặc trưng. Nếu nó quá khớp hoặc thiếu khớp, bạn có vấn đề về điều chỉnh.
Điều chỉnh là bước tiêu chuẩn trong bất kỳ quy trình ML nào.
Nó thường mang lại tiến bộ lớn hơn là đổi thuật toán. Ví dụ, một rừng ngẫu nhiên được điều chỉnh tốt thường đánh bại một mô hình boosting theo gradient điều chỉnh kém trên cùng dữ liệu, dù boosting tinh vi hơn.
Điều chỉnh cũng giúp tổng quát hóa. Các siêu tham số như độ sâu tối đa và tỷ lệ dropout kiểm soát trực tiếp mức độ mô hình có thể quá khớp. Chọn đúng những thứ này tạo khác biệt giữa mô hình ghi nhớ tập huấn luyện và mô hình hoạt động tốt trên dữ liệu mới.
Trong sản xuất, điều chỉnh biến bản mẫu thành hệ thống đáng tin cậy.
Thiết lập mặc định giúp bạn khởi động, nhưng không phải là thiết lập sẽ giữ mô hình cạnh tranh trước việc huấn luyện lại và yêu cầu kinh doanh. Mọi đội ML nghiêm túc đều coi điều chỉnh là một phần của quy trình.
Điều chỉnh siêu tham số là vòng lặp lặp đi lặp lại của tìm kiếm, đánh giá, và thu hẹp vào những gì hiệu quả cho dữ liệu của bạn.
Kết quả tốt nhất đến từ việc kết hợp ba yếu tố - phương pháp tìm kiếm phù hợp ngân sách tính toán, cách xác thực cho điểm số liên quan, và ghi chép thí nghiệm cho phép bạn xem lại những gì đã thử.
Bắt đầu với random search hoặc grid search. Chuyển sang tối ưu hóa Bayes khi việc huấn luyện đủ đắt để số lần thử thực sự quan trọng. Dù chọn cách nào, hãy điều chỉnh các siêu tham số phù hợp với mô hình của bạn, giữ tập kiểm tra sạch, và ghi log mọi lần chạy.
Nếu bạn đang cân nhắc sự nghiệp trong học máy, hãy ghi danh vào lộ trình Kỹ sư Học máy để sẵn sàng cho công việc trong năm 2026.
Học cùng DataCamp
Khóa học
Khóa học
Khóa học