
{count, plural, one {कोर्स} other {कोर्स}}
Python में Hyperparameter Tuning
{hours} घंटा
25.4K
आपके मॉडल की सटीकता इसलिए खराब नहीं है कि आपने गलत एल्गोरिद्म चुना — बल्कि इसलिए कि आपने उसे कभी ट्यून ही नहीं किया।
अधिकांश लोग डिफॉल्ट सेटिंग्स के साथ मॉडल ट्रेन करते हैं, सटीकता ~80% के आसपास स्थिर होती देखते हैं, और मान लेते हैं कि एल्गोरिद्म उनके कार्य के लिए उपयुक्त नहीं है। लेकिन समस्या एल्गोरिद्म में नहीं है। हर ML मॉडल में ऐसे पैरामीटर होते हैं जो यह नियंत्रित करते हैं कि वह कैसे सीखे, और ये पैरामीटर प्रशिक्षण शुरू होने से पहले सेट होते हैं। यदि आप इन्हें सही सेट कर लें, तो उसी मॉडल और उसी डेटा पर 10–20% तक अधिक सटीकता पा सकते हैं।
इन पैरामीटरों को हाइपरपैरामीटर कहा जाता है, और इन्हें ठीक से चुनना एक साधारण मॉडल को उस मॉडल से अलग करता है जो लगातार सही जवाब देता है। हाइपरपैरामीटर ट्यूनिंग वह प्रक्रिया है जिसमें उस संयोजन की खोज की जाती है जो सर्वोत्तम प्रदर्शन देता है।
इस लेख में, मैं बताऊँगा कि हाइपरपैरामीटर ट्यूनिंग क्या है, कौन-सी खोज रणनीतियाँ सबसे बेहतर काम करती हैं, बिना खुद को भ्रमित किए परिणामों का मूल्यांकन कैसे करें, और यह सब Python और R में कैसे चलाएँ।
यदि आप डेटा साइंस और मशीन लर्निंग में नए हैं, तो Machine Learning Fundamentals in Python कोर्स देखें, फिर उन्नत विषयों पर काम करें।
हाइपरपैरामीटर ट्यूनिंग वह प्रक्रिया है जिसमें वे सेटिंग्स खोजी जाती हैं जो मॉडल को सबसे बेहतर तरीके से सीखने में मदद करें।
हर ML मॉडल में दो तरह की संख्याएँ होती हैं। कुछ प्रशिक्षण के दौरान डेटा से सीखी जाती हैं, जैसे न्यूरल नेटवर्क के वेट्स या निर्णय वृक्ष में विभाजन बिंदु। अन्य प्रशिक्षण शुरू होने से पहले सेट की जाती हैं — यही हाइपरपैरामीटर हैं। ये नियंत्रित करते हैं कि मॉडल कैसे सीखे — कितनी तेज़ी से, कितनी गहराई तक, कितना सामान्यीकरण करे या कितना याद रखे।
डिफॉल्ट हाइपरपैरामीटर केवल मॉडल को चलाने के लिए दिए गए होते हैं। वे आपके विशिष्ट डेटासेट के लिए सर्वश्रेष्ठ मॉडल देने के लिए बने नहीं होते। जो डिफॉल्ट learning rate इमेज क्लासिफिकेशन के लिए ठीक है, वह टेब्युलर डेटा पर अच्छा प्रदर्शन नहीं करेगा। जो डिफॉल्ट tree depth साफ-सुथरे डेटासेट पर सही है, वह शोर-युक्त डेटासेट पर ओवरफिट कर सकता है। बात समझ में आ गई होगी।
ट्यूनिंग की प्रक्रिया विभिन्न हाइपरपैरामीटर मानों के संयोजनों में खोज करती है, प्रत्येक के लिए मॉडल को प्रशिक्षित करती है, और वह संयोजन रखती है जो आपके वैलिडेशन डेटा पर सबसे अच्छा प्रदर्शन करता है।
इससे मिलने वाला लाभ अक्सर एक बेहतर लेकिन बिना-ट्यून किए गए एल्गोरिद्म पर स्विच करने से भी अधिक होता है।
अंतर इस पर निर्भर करता है कि उन्हें कौन और कब सेट करता है।
मॉडल पैरामीटर प्रशिक्षण के दौरान एल्गोरिद्म द्वारा सीखे जाते हैं। आप उन्हें स्वयं सेट नहीं करते। प्रशिक्षण प्रक्रिया डेटा देखकर और एक loss function को न्यूनतम करके इन्हें समायोजित करती है। उदाहरण:
हाइपरपैरामीटर आप प्रशिक्षण शुरू होने से पहले चुनते हैं। ये सीखने की प्रक्रिया को नियंत्रित करते हैं, लेकिन एल्गोरिद्म इन्हें समायोजित नहीं करता। यदि आप इन्हें सेट नहीं करते, तो लाइब्रेरी अपने डिफॉल्ट्स इस्तेमाल करती है। उदाहरण:
यहाँ साथ-साथ तुलना देखें:
| मॉडल पैरामीटर | हाइपरपैरामीटर | |
|---|---|---|
| किसके द्वारा सेट | ट्रेनिंग एल्गोरिद्म | आप |
| कब | ट्रेनिंग के दौरान | ट्रेनिंग से पहले |
| डेटा से सीखे जाते हैं | हाँ | नहीं |
| उदाहरण | वेट्स, गुणांक, स्प्लिट पॉइंट | learning rate, tree depth, regularization strength |
| हर रन में बदलते हैं | हर बार रीट्रेन करने पर | सिर्फ जब आप बदलें |
मॉडल पैरामीटर बताते हैं कि मॉडल ने क्या सीखा। हाइपरपैरामीटर बताते हैं कि उसने कैसे सीखा।
ट्यूनिंग एक लूप है।
आप जिन हाइपरपैरामीटरों पर खोज करनी है, उन्हें चुनते हैं और प्रत्येक के लिए मानों की एक रेंज तय करते हैं। फिर एक संयोजन के साथ मॉडल ट्रेन करते हैं, वैलिडेशन डेटा पर प्रदर्शन मापते हैं, और अगले प्रयास के लिए उसी परिणाम का उपयोग करते हैं।
लूप इस प्रकार दिखता है:
हर इटरेशन के बीच आप कैसे अपडेट करते हैं, यही एक खोज विधि को दूसरी से अलग करता है। मैनुअल ट्यूनिंग अंतर्ज्ञान से अपडेट करती है। Grid search पूर्व-परिभाषित सूची में क्रम से चलती है। Bayesian विधियाँ यह मॉडल बनाकर अपडेट करती हैं कि किन संयोजनों के अच्छे होने की संभावना है।
आइए, अब इन विधियों में गहराई से देखते हैं।
आप कौन-सी खोज विधि चुनते हैं, यह तय करता है कि कितनी compute खपत होगी और अच्छे हाइपरपैरामीटर मिलने की कितनी संभावना है।
मैनुअल सर्च सबसे सरल तरीका है। आप हाइपरपैरामीटरों का एक संयोजन चुनते हैं, मॉडल ट्रेन करते हैं, परिणाम देखते हैं, और जो देखा उसके आधार पर समायोजन करते हैं।
यह तब काम करता है जब मॉडल छोटा हो, हाइपरपैरामीटर कम हों, और एल्गोरिद्म का पूर्व अनुभव हो। अगर आपको पहले से पता है कि XGBoost आमतौर पर ~0.05 के learning rate और 6 की tree depth पर अच्छा रहता है, तो आप वहीं से शुरुआत कर सकते हैं और देखे गए व्यवहार के आधार पर समायोजित कर सकते हैं।
जब खोज-स्पेस बड़ा हो जाता है, तो मैनुअल सर्च काम नहीं करता। तीन हाइपरपैरामीटर और प्रत्येक के पाँच उचित मान — कुल 125 संयोजन — और कोई भी व्यक्ति 125 मॉडल हाथ से ट्यून नहीं करता।
Grid search पूर्व-परिभाषित मानों की सूची में हर संयोजन की जाँच करता है।
आप एक ग्रिड तय करते हैं — उदाहरण के लिए, learning rates [0.01, 0.05, 0.1] और tree depths [3, 5, 7] — और grid search नौों संयोजनों में से प्रत्येक के लिए मॉडल ट्रेन करता है। यह व्यापक और पुनरुत्पाद्य है।
समस्या compute लागत है.
एक और हाइपरपैरामीटर जोड़ना, जिसके पाँच मान हों, आपके प्रशिक्षण रन को पाँच गुना बढ़ा देता है। Grid search उन मानों पर भी प्रयास बर्बाद करता है जो मायने नहीं रखते — यदि tree depth आपके स्कोर को मुश्किल से प्रभावित करता है, तब भी grid search आपके सूचीबद्ध हर depth के लिए मॉडल ट्रेन करेगा।
दो या तीन हाइपरपैरामीटर वाले छोटे खोज-स्पेस के लिए grid search अच्छा डिफॉल्ट है।
Random search स्थिर ग्रिड के बजाय एक रेंज से यादृच्छिक संयोजन चुनता है।
आप प्रत्येक हाइपरपैरामीटर के लिए एक वितरण परिभाषित करते हैं और random search उन वितरणों से संयोजन निकालता है। यह grid search से अधिक कुशल है क्योंकि यह गैर-महत्वपूर्ण मानों पर रन बर्बाद नहीं करता — यदि तीन में से केवल एक हाइपरपैरामीटर प्रदर्शन को प्रभावित करता है, तो random search उसी महत्वपूर्ण पैरामीटर के विभिन्न मानों पर अधिक अन्वेषण करता है।
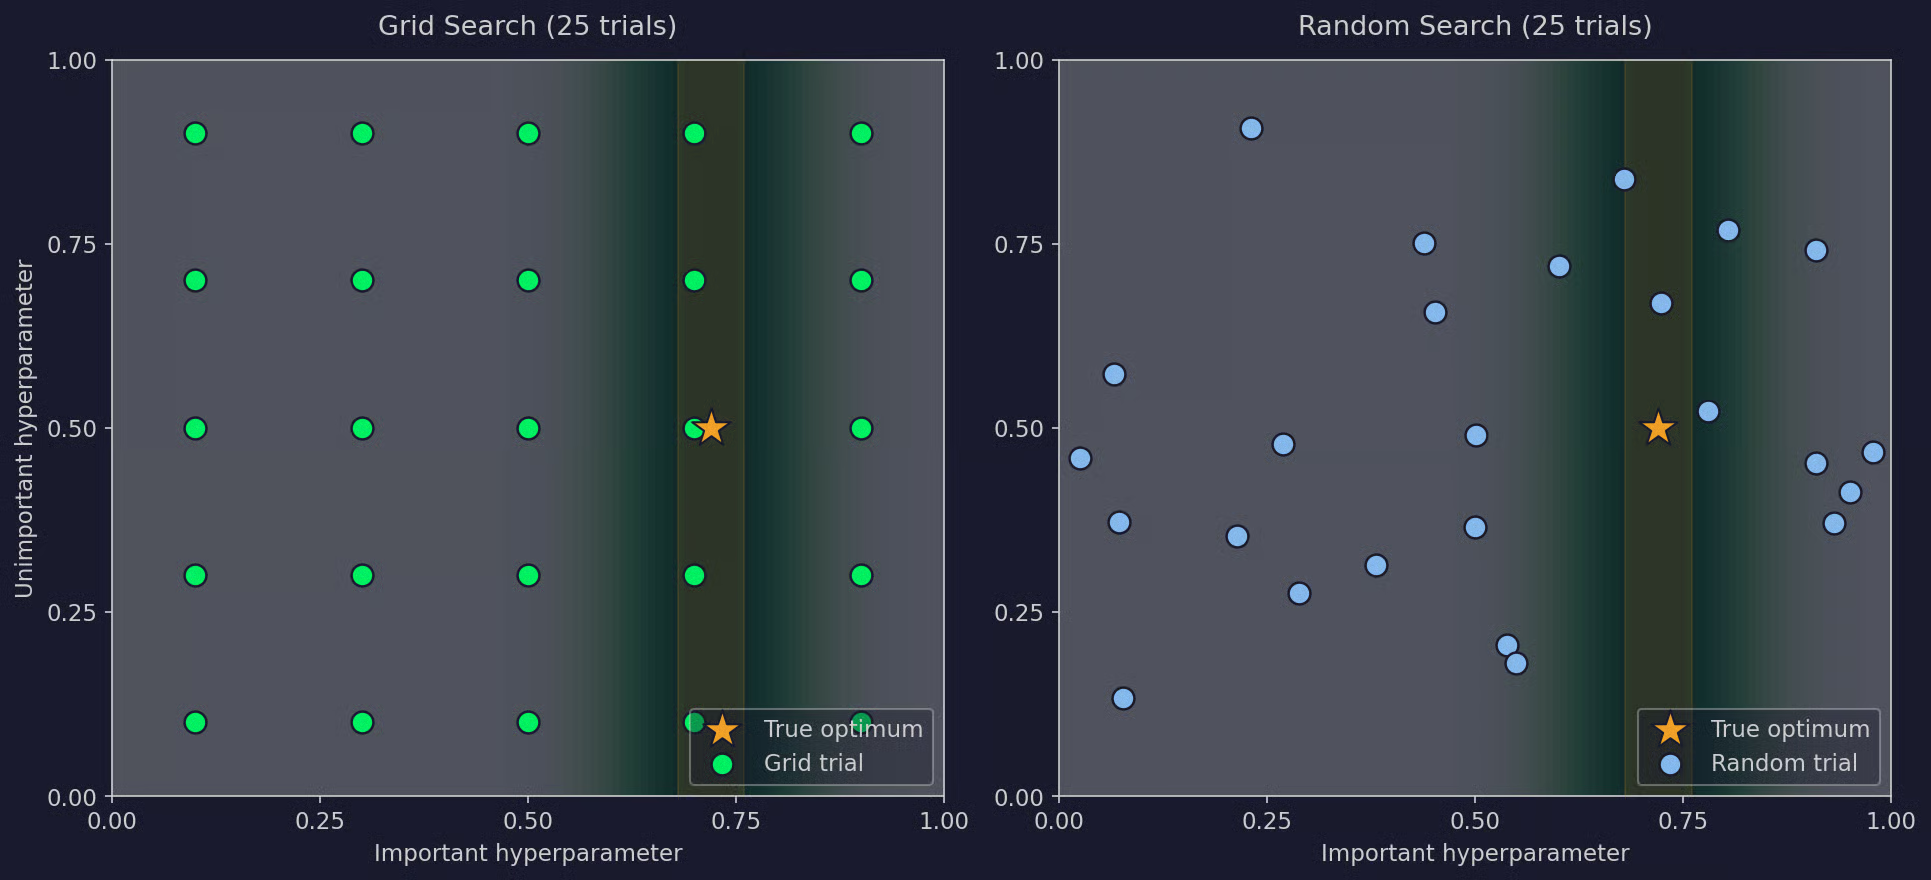
Grid search बनाम random search
दो से अधिक हाइपरपैरामीटर होने पर random search बेहतर डिफॉल्ट है।
Bayesian optimization अगला प्रयास चुनने के लिए पिछले ट्रायल्स के परिणामों का उपयोग करता है।
यह एक प्रायिकात्मक मॉडल बनाता है कि हाइपरपैरामीटर संयोजन प्रदर्शन से कैसे मैप होते हैं, फिर अगला संयोजन चुनता है जिसमें या तो अपेक्षित स्कोर सबसे अधिक हो या अनिश्चितता सबसे अधिक। इसे exploration-exploitation संतुलन कहते हैं — यानी या तो आप नए क्षेत्रों की खोज करते हैं जो अच्छे हो सकते हैं, या पहले से अच्छे दिखे क्षेत्रों का दोहन करते हैं।
Bayesian विधियाँ random या grid search की तुलना में बहुत कम ट्रायल्स में अच्छे हाइपरपैरामीटर खोज लेती हैं। समझौता यह है कि हर ट्रायल थोड़ा लंबा लगता है क्योंकि अगला बिंदु चुनने से पहले एल्गोरिद्म को अपना आंतरिक मॉडल फिट करना होता है। Optuna और Hyperopt जैसी लाइब्रेरी आपके लिए यह काम करती हैं।
जब प्रशिक्षण महँगा हो और आप कम रन वहन कर सकें, तब Bayesian optimization का उपयोग करें।
Successive halving और Hyperband खराब रन को जल्दी रोककर compute समय घटाते हैं।
Successive halving कई हाइपरपैरामीटर संयोजनों को छोटे प्रशिक्षण बजट से शुरू करता है, सबसे खराब आधे को हटा देता है, बचे हुए के लिए बजट दोगुना करता है, और इसे दोहराता है।
Hyperband successive halving का एक wrapper है जो अलग-अलग बजट विभाजनों के साथ इसे कई बार चलाता है, ताकि आपको सही शुरुआती कॉन्फ़िगरेशन का अनुमान न लगाना पड़े।
दोनों विधियाँ तब उपयोगी हैं जब प्रशिक्षण धीमा हो और खोज-स्पेस बड़ा हो। ये तब सबसे अच्छा काम करती हैं जब शुरुआती प्रदर्शन अंतिम प्रदर्शन के लिए अच्छा संकेत देता हो, जो आमतौर पर न्यूरल नेटवर्क और ग्रेडिएंट बूस्टिंग के लिए सही है।
विधियों की तुलना इस प्रकार है:
| Compute लागत | खोज दक्षता | उपयुक्त परिदृश्य | |
|---|---|---|---|
| मैनुअल सर्च | कम | कम | छोटे मॉडल, पूर्व अनुभव |
| Grid search | उच्च | कम | 2–3 हाइपरपैरामीटर, छोटी रेंज |
| Random search | मध्यम | मध्यम | 4+ हाइपरपैरामीटर, अज्ञात महत्व |
| Bayesian optimization | मध्यम | उच्च | महँगा प्रशिक्षण, छोटा बजट |
| Successive halving / Hyperband | कम से मध्यम | उच्च | बड़े खोज-स्पेस, धीमा प्रशिक्षण |
यदि आप मानों की उचित रेंज नहीं चुनते, तो ट्यूनिंग आपको दूर तक नहीं ले जाएगी।
यदि आपका मूल्यांकन गलत है, तो आप गलत हाइपरपैरामीटर चुन लेंगे। चार चीज़ें सही करनी होती हैं — डेटा कैसे बाँटते हैं, प्रदर्शन कैसे मापते हैं, कौन-सा मीट्रिक ऑप्टिमाइज़ करते हैं, और टेस्ट सेट को कैसे साफ़ रखते हैं।
ट्यूनिंग से पहले अपने डेटा को तीन भागों में बाँटें।
ट्रेनिंग सेट वह है जिससे मॉडल सीखता है। वैलिडेशन सेट वह है जिससे आप ट्यूनिंग के दौरान हर हाइपरपैरामीटर संयोजन को स्कोर करते हैं। टेस्ट सेट वह है जिसे आप अंत में, केवल एक बार, अनदेखे डेटा पर अंतिम मॉडल के प्रदर्शन को मापने के लिए उपयोग करते हैं।
यदि आप टेस्ट सेट के विरुद्ध ट्यूनिंग करते हैं, तो आपको सटीकता का एक बढ़िया-सा आंकड़ा मिलेगा और प्रोडक्शन में कम-प्रदर्शन करने वाला मॉडल। टेस्ट सेट के विरुद्ध लिया गया हर ट्यूनिंग निर्णय उसकी जानकारी को आपके मॉडल में लीकेज के रूप में पहुँचा देता है।
मध्यम आकार के डेटासेट के लिए सामान्य स्प्लिट 60/20/20 है या बड़े डेटासेट के लिए 80/10/10।
जब आपका वैलिडेशन सेट छोटा हो, तो क्रॉस-वैलिडेशन हाइपरपैरामीटर स्कोर करने का बेहतर तरीका है।
आप ट्रेनिंग डेटा को k भागों (folds) में बाँटते हैं — आमतौर पर 5 या 10। हर हाइपरपैरामीटर संयोजन के लिए, आप k-1 फोल्ड्स पर ट्रेन करते हैं और बचे हुए एक पर वैलिडेट, फिर घुमाते हैं। अंतिम स्कोर सभी फोल्ड्स का औसत होता है।
क्रॉस-वैलिडेशन आपको इस बात का अधिक स्थिर अनुमान देता है कि कोई संयोजन कितना अच्छी तरह सामान्यीकृत करता है, क्योंकि आप एक ही भाग्यशाली या दुर्भाग्यपूर्ण वैलिडेशन स्प्लिट पर निर्भर नहीं रहते। इसकी कीमत यह है कि हर संयोजन पर एक के बजाय k मॉडल ट्रेन होते हैं।
क्रॉस-वैलिडेशन तब उपयोग करें जब आपका डेटासेट इतना छोटा हो कि एक ही वैलिडेशन स्प्लिट विश्वसनीय न हो, और जब आप अतिरिक्त प्रशिक्षण लागत वहन कर सकें।
जिस मीट्रिक को आप ऑप्टिमाइज़ करते हैं, वह उसी से मेल खाना चाहिए जिसकी आपको सच में परवाह है।
संतुलित वर्गीकरण के लिए accuracy ठीक है, लेकिन असंतुलित समस्याओं के लिए उचित नहीं। उदाहरण के लिए, यदि एक fraud detection मॉडल हर चीज़ को "धोखाधड़ी नहीं" भविष्यवाणी करे, तो उसे 99% accuracy मिल सकती है लेकिन वह हर वास्तविक केस चूक जाएगा। असंतुलित वर्गीकरण के लिए precision, recall, F1, या ROC-AUC का उपयोग करें। रिग्रेशन के लिए, outliers महत्त्वपूर्ण हैं या नहीं, इसके आधार पर RMSE, MAE, या R squared का उपयोग करें।
ट्यूनिंग शुरू करने से पहले बस एक प्राथमिक मीट्रिक चुनें और उसी पर टिके रहें।
डेटा लीकेज तब होता है जब आपकी वैलिडेशन या टेस्ट सेट की जानकारी ट्रेनिंग में पहुँच जाती है।
यह सामान्यतः इन तरीकों से होता है:
सभी प्रीप्रोसेसिंग चरण केवल ट्रेनिंग सेट पर फिट करें, फिर उन्हें वैलिडेशन और टेस्ट पर लागू करें। scikit-learn में यही काम Pipeline करता है — यह प्रीप्रोसेसिंग और मॉडलिंग को एक ऑब्जेक्ट में लपेट देता है जो आपके स्प्लिट का सम्मान करता है।
अधिकांश ML लाइब्रेरीज़ में खोज और क्रॉस-वैलिडेशन के टूल बने होते हैं, इसलिए आपको सब कुछ शुरू से लागू करने की ज़रूरत नहीं।
Scikit-learn में दो ट्यूनिंग क्लास हैं जो अधिकांश उपयोग मामलों को कवर करती हैं — GridSearchCV grid search के लिए और RandomizedSearchCV random search के लिए। दोनों किसी भी scikit-learn estimator के चारों ओर लिपटती हैं, हर संयोजन के लिए क्रॉस-वैलिडेशन चलाती हैं, और अंत में आपको सर्वश्रेष्ठ मॉडल देती हैं।
GridSearchCV एक estimator, हाइपरपैरामीटर मानों की डिक्शनरी, और क्रॉस-वैलिडेशन फोल्ड्स की संख्या लेती है। यह हर संयोजन के लिए मॉडल ट्रेन करती है और सबसे अच्छे स्कोर वाले को रखती है।
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, random_state=42)

param_grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [5, 10, 20],
    "min_samples_leaf": [1, 5, 10],
}

grid = GridSearchCV(RandomForestClassifier(random_state=42), param_grid, cv=5)
grid.fit(X, y)

print(grid.best_params_)
print(grid.best_score_)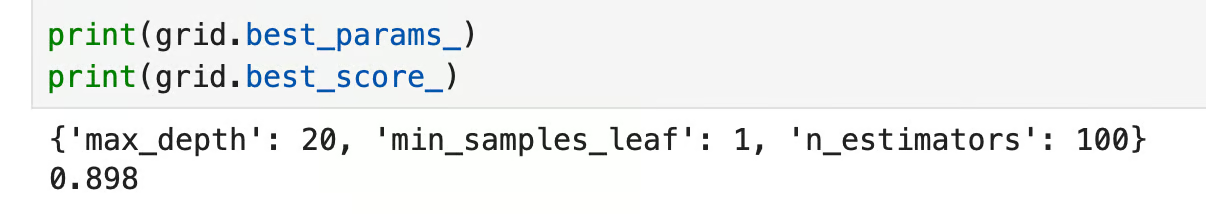
Python में GridSearchCV के परिणाम
RandomizedSearchCV का इंटरफ़ेस वही है, लेकिन यह स्थिर सूची से गुजरने के बजाय वितरणों से सैम्पल करता है। इससे आप सीमित ट्रायल्स में अधिक व्यापक रेंज कवर कर सकते हैं।
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

param_dist = {
    "n_estimators": randint(100, 500),
    "max_depth": randint(3, 20),
    "min_samples_leaf": randint(1, 10),
}

random_search = RandomizedSearchCV(
    RandomForestClassifier(random_state=42),
    param_dist,
    n_iter=30,
    cv=5,
    random_state=42,
)
random_search.fit(X, y)

print(random_search.best_params_)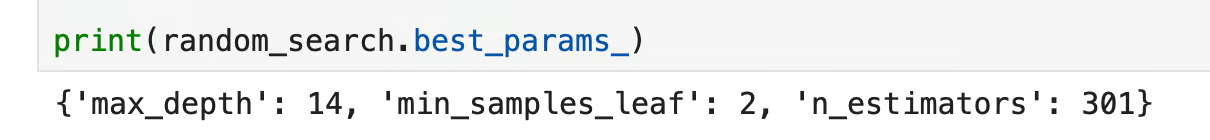
Python में RandomizedSearchCV के परिणाम
Bayesian optimization के लिए Optuna मानक विकल्प है। यह पिछले परिणामों के आधार पर अगला संयोजन चुनता है, इसलिए जब प्रशिक्षण महँगा हो, तो यह random search की तुलना में तेज़ी से कन्वर्ज करता है।
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 100, 500),
        "max_depth": trial.suggest_int("max_depth", 3, 20),
        "min_samples_leaf": trial.suggest_int("min_samples_leaf", 1, 10),
    }
    model = RandomForestClassifier(**params, random_state=42)
    return cross_val_score(model, X, y, cv=5).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)

print(study.best_params)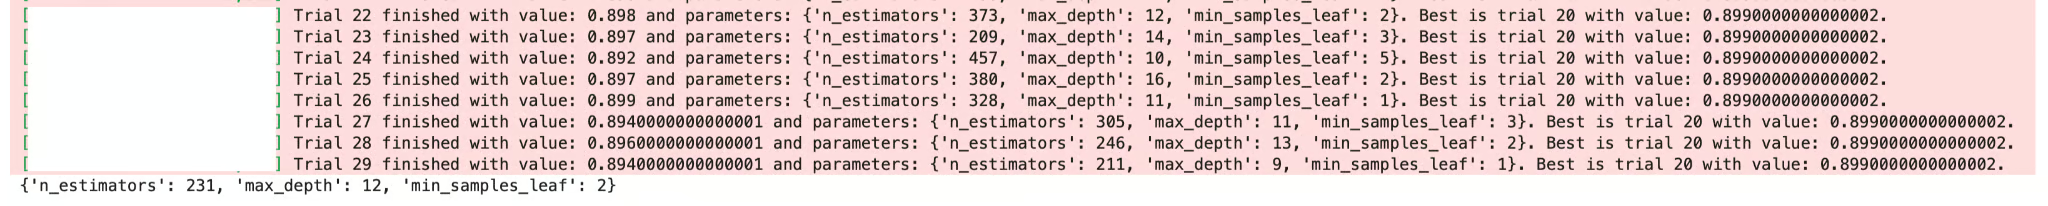
Python में Optuna के परिणाम
trial.suggest_* मेथड्स सर्च स्पेस को परिभाषित करते हैं, और Optuna अब तक देखे गए स्कोर के आधार पर अगला कौन-सा संयोजन आज़माना है, यह तय करता है।
R में दो बेहतरीन विकल्प हैं — caret और tidymodels। दोनों का काम एक-सा है — ग्रिड परिभाषित करना, क्रॉस-वैलिडेशन चलाना, सर्वश्रेष्ठ मॉडल लौटाना — लेकिन tidymodels आधुनिक डिफ़ॉल्ट है।
caret के साथ, आप train() फ़ंक्शन को एक ट्यूनिंग ग्रिड पास करते हैं और रीसैंपलिंग पद्धति निर्दिष्ट करते हैं।
library(caret)

data <- iris
ctrl <- trainControl(method = "cv", number = 5)

grid <- expand.grid(
  mtry = c(2, 3, 4)
)

model <- train(
  Species ~ .,
  data = data,
  method = "rf",
  trControl = ctrl,
  tuneGrid = grid
)

print(model$bestTune)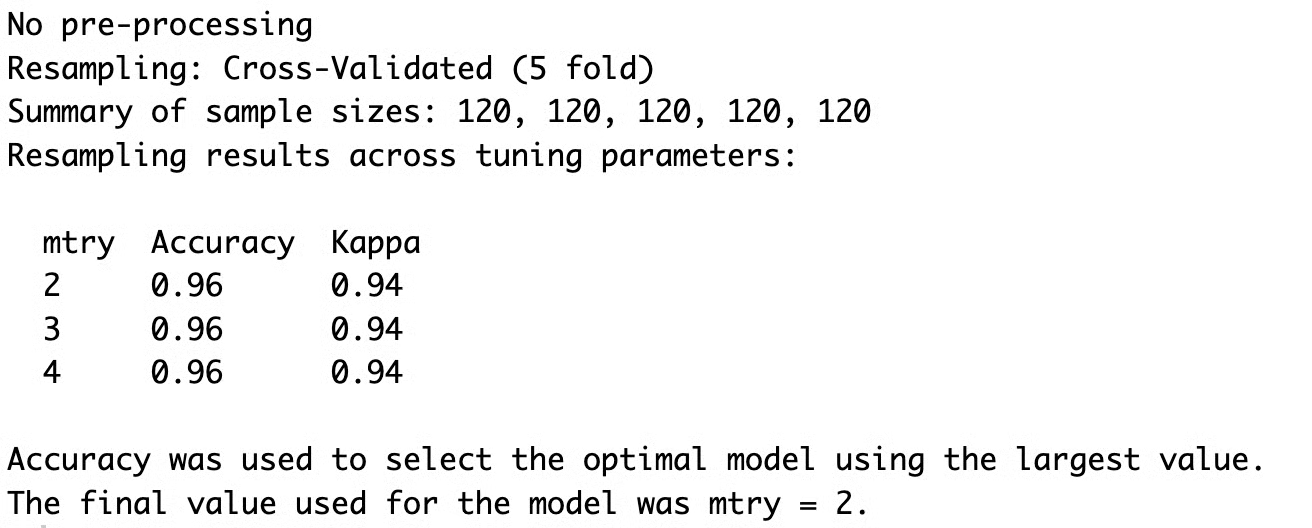
R में Caret के परिणाम
tidymodels वर्कफ़्लो को स्पष्ट चरणों में विभाजित करता है — एक मॉडल स्पेक, प्रीप्रोसेसिंग के लिए रेसिपी, और ट्यूनिंग ग्रिड। यह अधिक विस्तारपूर्ण है, लेकिन व्यवहार में अधिक स्केलेबल है।
library(tidymodels)

data <- iris
split <- initial_split(data, prop = 0.8)
train_data <- training(split)

rf_spec <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")

grid <- grid_regular(
  mtry(range = c(2, 4)),
  trees(range = c(100, 500)),
  min_n(range = c(1, 10)),
  levels = 3
)

folds <- vfold_cv(train_data, v = 5)

results <- tune_grid(
  rf_spec,
  Species ~ .,
  resamples = folds,
  grid = grid
)

show_best(results, metric = "accuracy")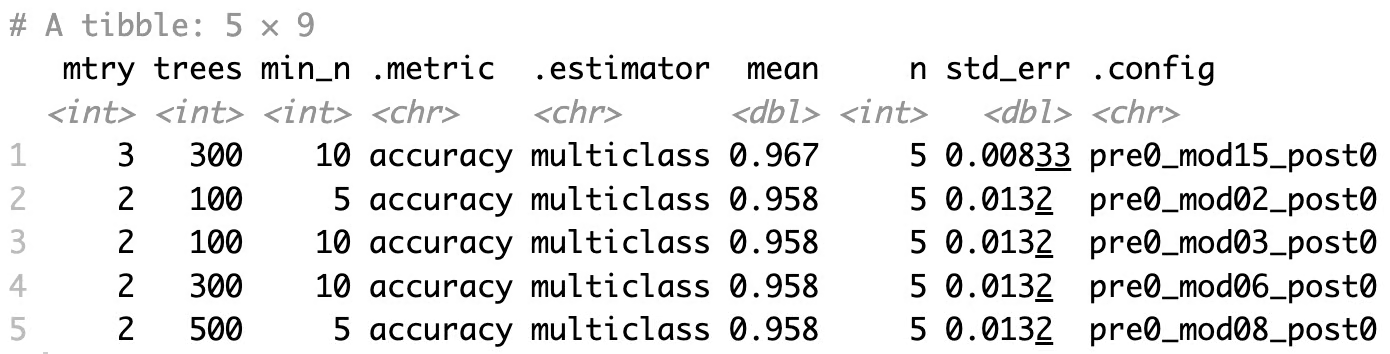
R में Tidymodels के परिणाम
वर्कफ़्लो बिल्कुल Python जैसा ही है — आप तय करते हैं कि किन मानों पर खोज करनी है, उसे कैसे स्कोर करना है, और लाइब्रेरी को लूप चलाने देते हैं।
हर हाइपरपैरामीटर ट्यून करने लायक नहीं होता, क्योंकि आमतौर पर कुछ ही प्रदर्शन का अधिकांश हिस्सा नियंत्रित करते हैं। यहां मॉडल परिवार के अनुसार वे दिए गए हैं जो आम तौर पर पहले मायने रखते हैं।
इन तीनों को हमेशा ट्यून करें:
ग्रेडिएंट बूस्टिंग (XGBoost, LightGBM, CatBoost) हाइपरपैरामीटर के प्रति रैंडम फॉरेस्ट से अधिक संवेदनशील होता है। इन पर ध्यान दें:
SVMs में हाइपरपैरामीटर का चुनाव बहुत मायने रखता है, शायद अन्य मॉडलों से भी अधिक:
rbf और उच्च-आयामी स्पैर्स डेटा के लिए linear से शुरू करें।न्यूरल नेटवर्क का सर्च स्पेस किसी भी सामान्य मॉडल परिवार में सबसे बड़ा होता है। पहले इन्हें ट्यून करें:
1e-4, 1e-3, 1e-2।ट्यूनिंग महंगी होती है, खासकर जब आप प्रति पैरामीटर अनेक मान जांचना चाहते हैं और ट्यून करने को कई पैरामीटर हों। यहां कुछ आम चुनौतियां दी गई हैं।
कंप्यूट लागत सबसे बड़ा प्रतिबंध है। आप जो भी संयोजन आज़माते हैं, उसके लिए एक पूरा मॉडल ट्रेन करना पड़ता है, और क्रॉस-वैलिडेशन इसे फोल्ड्स की संख्या से गुणा कर देता है। 100 संयोजनों के ग्रिड के साथ 5-फोल्ड CV यानी 500 मॉडल फिट। अगर हर फिट में 10 मिनट लगते हैं, तो यह तीन दिनों से भी अधिक है।
बड़े सर्च स्पेस गुणात्मक रूप से बढ़ते हैं। पांच हाइपरपैरामीटर, हर एक के पांच मान — 3,125 संयोजन। यहां ग्रिड सर्च विकल्प नहीं रहता और उसकी जगह रैंडम सर्च या बेयेशियन विधियां लेती हैं।
घटते लाभ अपेक्षा से पहले ही दिख जाते हैं। शुरुआती कुछ ट्यूनिंग रन प्रायः सबसे बड़े लाभ देते हैं। अगले 50 से शायद एक और प्रतिशत सटीकता निकले। एक बिंदु पर अतिरिक्त कंप्यूट डेटा बढ़ाने या फीचर्स सुधारने में बेहतर लगता है।
सटीकता-समय का संतुलन विकास की तुलना में प्रोडक्शन में अधिक मायने रखता है। यदि आप रोज़ रीट्रेन करते हैं, तो 0.5% अधिक स्कोर करने वाला लेकिन दोगुना समय लेने वाला मॉडल शायद काबिल-ए-कबूल न हो। आपको पहले से तय करना चाहिए कि कितनी सटीकता किस मात्रा के कंप्यूट के लायक है।
मशीन लर्निंग मॉडल के हाइपरपैरामीटर ट्यून करते समय अपनाने योग्य कुछ अच्छी आदतें:
[0.001, 100] है, तो आप उन मानों पर समय बर्बाद करेंगे जो कभी काम नहीं करते। अपने एल्गोरिद्म के लिए यथार्थवादी मानी जाने वाली रेंज से शुरू करें, फिर देखे गए परिणामों के आधार पर उन्हें संकीर्ण करें।अधिकांश ट्यूनिंग विफलताएं आसानी से टाली जा सकने वाली गलतियों के कारण होती हैं। यहां कुछ उदाहरण हैं:
दोनों आपके मॉडल को बेहतर बनाते हैं, लेकिन समस्या के अलग हिस्सों पर काम करते हैं।
फीचर इंजीनियरिंग इनपुट डेटा में सुधार करती है। आप मौजूदा फीचर्स से नए फीचर बनाते हैं, श्रेणीबद्ध चरों को एन्कोड करते हैं, गायब मानों को संभालते हैं, और शोर हटाते हैं। बेहतर फीचर्स मॉडल को सीखने के लिए अधिक उपयोगी संकेत देते हैं।
हाइपरपैरामीटर ट्यूनिंग इस बात में सुधार करती है कि मॉडल दिए गए फीचर्स से कैसे सीखता है। यह डेटा को बदलने के बजाय एल्गोरिद्म के व्यवहार को बदलती है।
दोनों पूरक हैं। किसी प्रोजेक्ट के शुरुआती चरण में, जब डेटा अभी कच्चा होता है और मॉडल स्पष्ट संकेतों से वंचित होता है, फीचर इंजीनियरिंग आमतौर पर सबसे बड़े लाभ देती है। जब आपके फीचर्स पर्याप्त अच्छे हो जाते हैं, तो हाइपरपैरामीटर ट्यूनिंग छोटे लेकिन निरंतर लाभ देती है।
यदि आपका मॉडल अटका हुआ है और आप सुनिश्चित नहीं हैं कि पहले किसे आज़माएं, तो अपनी त्रुटियों को देखें। यदि मॉडल डेटा से स्पष्ट दिखने वाले पैटर्न छोड़ रहा है, तो यह फीचर की समस्या है। यदि यह ओवरफिटिंग या अंडरफिटिंग कर रहा है, तो यह ट्यूनिंग की समस्या है।
ट्यूनिंग किसी भी ML वर्कफ़्लो में एक मानक चरण है।
यह अक्सर एल्गोरिद्म बदलने से बड़े लाभ देती है। उदाहरण के लिए, अच्छी तरह ट्यून किया गया रैंडम फॉरेस्ट अक्सर उसी डेटा पर खराब-ट्यून किए गए ग्रेडिएंट बूस्टिंग मॉडल को हरा देगा, भले ही ग्रेडिएंट बूस्टिंग अधिक परिष्कृत एल्गोरिद्म हो।
ट्यूनिंग सामान्यीकरण में भी मदद करती है। मैक्स डेप्थ और ड्रॉपआउट रेट जैसे हाइपरपैरामीटर सीधे नियंत्रित करते हैं कि मॉडल कितना ओवरफिट कर सकता है। इन्हें सही करना ही वह अंतर पैदा करता है जो ट्रेनिंग सेट को याद करने वाले मॉडल और नए डेटा पर अच्छा प्रदर्शन करने वाले मॉडल के बीच होता है।
प्रोडक्शन में, ट्यूनिंग एक प्रूफ-ऑफ-कॉन्सेप्ट को एक भरोसेमंद सिस्टम में बदल देती है।
डिफ़ॉल्ट सेटिंग्स आपको शुरुआत करवाती हैं, लेकिन ये वे सेटिंग्स नहीं हैं जो मॉडल को रीट्रेनिंग और व्यावसायिक आवश्यकताओं के मुकाबले प्रतिस्पर्धी बनाए रखें। हर गंभीर ML टीम ट्यूनिंग को प्रक्रिया का हिस्सा मानती है।
हाइपरपैरामीटर ट्यूनिंग खोज, मूल्यांकन, और आपके विशिष्ट डेटा पर काम करने वाली चीज़ों को संकीर्ण करने का एक आवर्तक लूप है।
सबसे अच्छे नतीजे तीन चीज़ों के मेल से आते हैं — आपकी कंप्यूट क्षमता के अनुरूप सर्च विधि, ऐसा वैलिडेशन जो प्रासंगिक स्कोर देता हो, और ऐसा प्रयोग-ट्रैकिंग जो आपको पीछे जाकर देख पाने दे कि आपने क्या-क्या आज़माया।
रैंडम सर्च या ग्रिड सर्च से शुरू करें। जब प्रशिक्षण इतना महंगा हो जाए कि ट्रायल की संख्या सच में मायने रखे, तो बेयेशियन ऑप्टिमाइज़ेशन पर जाएं। किसी भी तरह, अपने मॉडल के लिए प्रासंगिक हाइपरपैरामीटर ट्यून करें, टेस्ट सेट को साफ़ रखें, और हर रन लॉग करें।
यदि आप मशीन लर्निंग में करियर पर विचार कर रहे हैं, तो हमारे Machine Learning Engineer ट्रैक में नामांकन करें और 2026 तक नौकरी-तैयार बनें।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}