
Last chance! 50% off DataCamp Premium
Sale ends in
L'accuratezza del tuo modello non è scarsa perché hai scelto l'algoritmo sbagliato, ma perché non l'hai mai ottimizzato.
La maggior parte delle persone allena un modello con le impostazioni predefinite, vede l'accuratezza stabilizzarsi intorno all'80% e conclude che l'algoritmo non è adatto al compito. Ma l'algoritmo non è il problema. Ogni modello di ML ha parametri che controllano come apprende, e questi parametri sono impostati prima ancora che l'addestramento inizi. Se li scegli bene, puoi ottenere un 10-20% di accuratezza in più dallo stesso modello sugli stessi dati.
Questi parametri sono chiamati iperparametri, e sceglierli bene fa la differenza tra un modello discreto e uno che sembra azzeccarci sempre. L'ottimizzazione degli iperparametri è il processo di ricerca della combinazione che ti dà le migliori prestazioni.
In questo articolo ti spiego cos'è l'ottimizzazione degli iperparametri, le strategie di ricerca più efficaci, come valutare i risultati senza autoingannarti e come fare tutto in Python e R.
Se sei alle prime armi con data science e machine learning, dai un'occhiata al corso Machine Learning Fundamentals in Python prima di passare ad argomenti più avanzati.
L'ottimizzazione degli iperparametri è il processo di individuare le impostazioni che fanno apprendere meglio un modello.
Ogni modello di ML ha due tipi di numeri. Alcuni sono appresi dai dati durante l'addestramento, come i pesi in una rete neurale o i punti di split in un albero decisionale. Altri sono impostati prima che l'addestramento inizi, e sono gli iperparametri. Controllano come il modello apprende: quanto velocemente, quanto in profondità, quanto dovrebbe generalizzare o memorizzare.
Gli iperparametri predefiniti esistono per farti avere un modello che gira. Non sono pensati per darti il miglior modello per il tuo dataset specifico. È logico che un tasso di apprendimento predefinito che funziona per la classificazione di immagini non renda bene su dati tabellari. Una profondità dell'albero adatta a un dataset pulito porterà a overfitting su uno rumoroso. Hai capito l'idea.
Il processo di tuning esplora diverse combinazioni di valori degli iperparametri, allena un modello per ciascuna e tiene quella che rende meglio sui dati di validazione.
Quello che puoi ottenere così è spesso migliore che passare a un algoritmo più potente ma non ottimizzato.
La differenza sta in chi li imposta e quando.
I parametri del modello sono appresi dall'algoritmo durante l'addestramento. Non li imposti mai tu. Il processo di training li regola guardando i dati e minimizzando una funzione di perdita. Per esempio:
Gli iperparametri li scegli tu prima che l'addestramento inizi. Controllano come funziona il processo di apprendimento, ma l'algoritmo non li modificherà in alcun modo. Se non li imposti, la libreria usa i valori di default. Per esempio:
Ecco un confronto affiancato:
| Parametri del modello | Iperparametri | |
|---|---|---|
| Impostati da | L'algoritmo di training | Tu |
| Quando | Durante l'addestramento | Prima dell'addestramento |
| Appresi dai dati | Sì | No |
| Esempi | Pesi, coefficienti, punti di split | Tasso di apprendimento, profondità dell'albero, forza di regolarizzazione |
| Cambia tra le esecuzioni | Ogni volta che rialleni | Solo se li modifichi |
I parametri del modello rispondono a cosa ha appreso il modello. Gli iperparametri rispondono a come ha appreso.
Il tuning è un ciclo.
Inizi scegliendo gli iperparametri su cui cercare e definendo un intervallo di valori per ciascuno. Poi alleni un modello con una combinazione, ne misuri le prestazioni sui dati di validazione e usi quel risultato per decidere cosa provare dopo.
Il ciclo è questo:
La modalità con cui aggiorni tra un'iterazione e l'altra distingue un metodo di ricerca da un altro. Il tuning manuale aggiorna per intuizione. La grid search aggiorna scorrendo una lista predefinita. I metodi bayesiani aggiornano costruendo un modello di quali combinazioni è probabile che funzionino.
Vediamo questi metodi nel dettaglio.
Il metodo di ricerca che scegli determina quante risorse di calcolo consumerai e quanto è probabile che tu trovi buoni iperparametri.
La ricerca manuale è il metodo più semplice. Scegli una combinazione di iperparametri, alleni il modello, guardi il risultato e regoli in base a ciò che hai visto.
Funziona quando hai un modello piccolo, pochi iperparametri ed esperienza pregressa con l'algoritmo. Se sai già che XGBoost di solito preferisce un learning rate intorno a 0,05 e una profondità dell'albero pari a 6, puoi iniziare da lì e adattare in base a ciò che osservi.
La ricerca manuale non funziona quando lo spazio di ricerca cresce. Tre iperparametri con cinque valori ragionevoli ciascuno ti danno già 125 combinazioni, e nessuno ottimizza 125 modelli a mano.
La grid search verifica ogni combinazione in una lista di valori predefinita.
Definisci una griglia - per esempio, learning rate [0.01, 0.05, 0.1] e profondità degli alberi [3, 5, 7] - e la grid search allena un modello per ciascuna delle nove combinazioni. È esaustiva e riproducibile.
Il problema è il costo computazionale.
Aggiungere un iperparametro con cinque valori moltiplica per cinque le tue esecuzioni. La grid search spreca anche sforzi su valori che non contano: se la profondità dell'albero influisce appena sul punteggio, la grid search allena comunque un modello per ogni profondità elencata.
La grid search è una buona scelta di default per spazi di ricerca piccoli con due o tre iperparametri.
La random search campiona combinazioni casuali da un intervallo invece di scorrere una griglia fissa.
Definisci una distribuzione per ciascun iperparametro e la random search estrae combinazioni da queste distribuzioni. È più efficiente della grid search perché non spreca esecuzioni su valori che non contano: se solo uno su tre iperparametri incide sulle prestazioni, la random search esplora comunque quello importante su molti valori diversi.
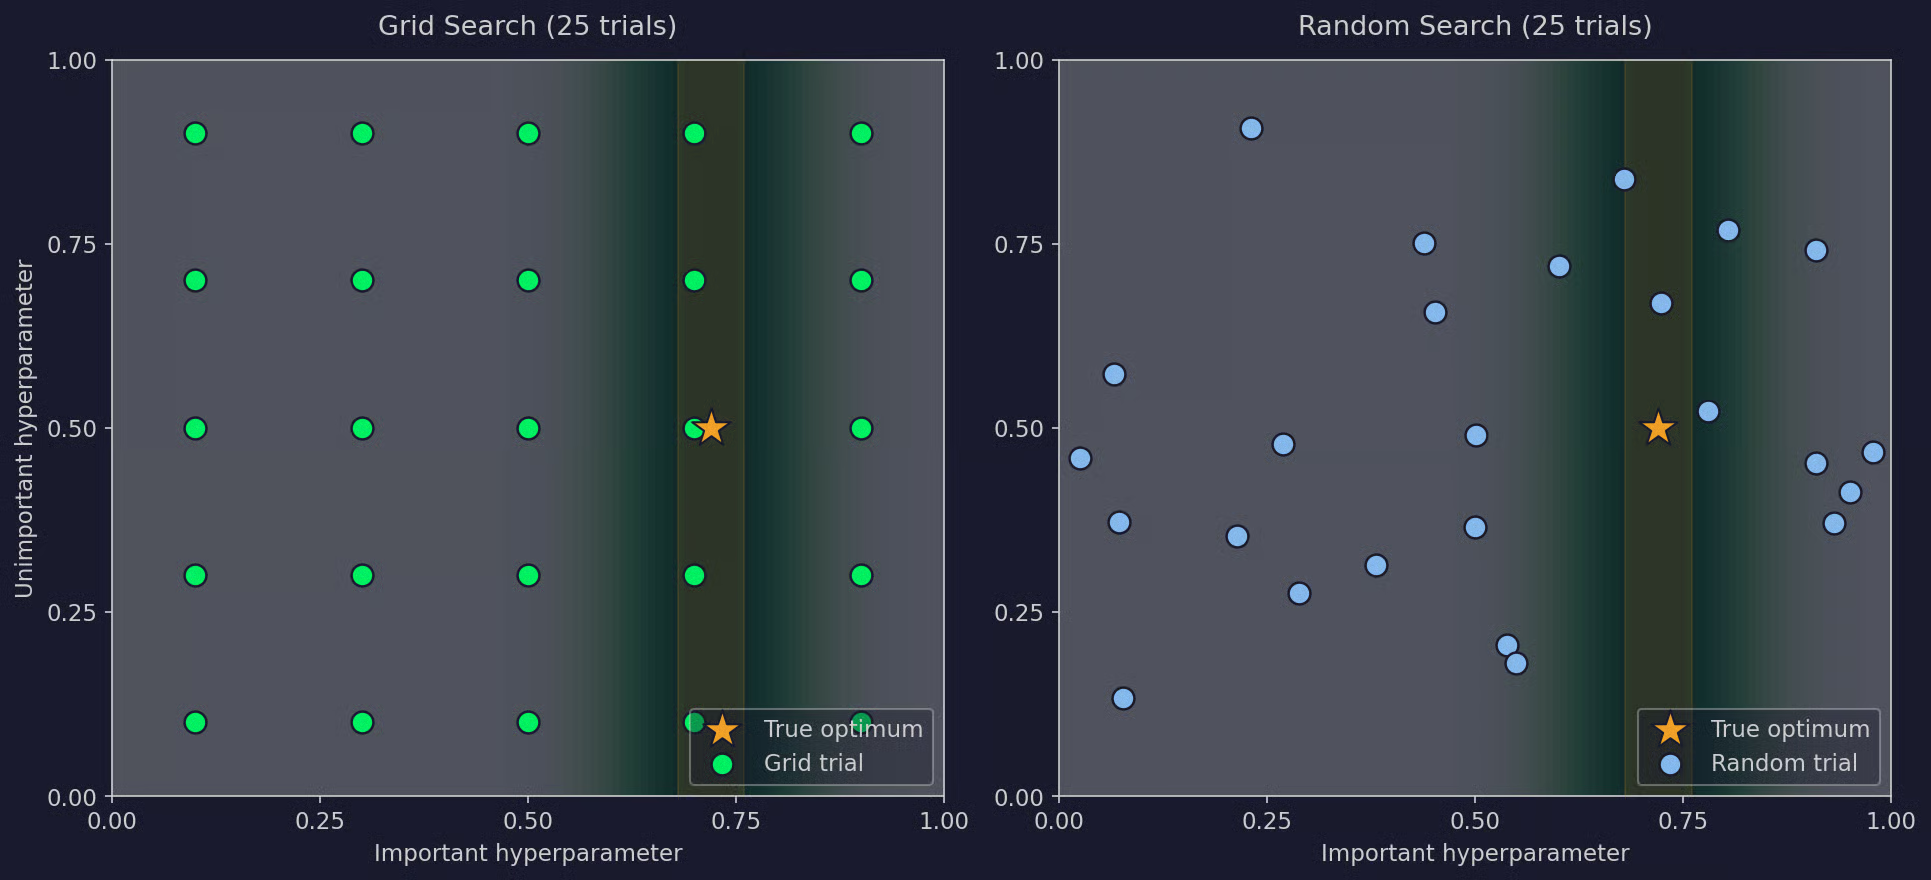
Grid search contro random search
La random search è la scelta migliore di default per tutto ciò che ha più di due iperparametri.
L'ottimizzazione bayesiana usa i risultati dei tentativi precedenti per decidere cosa provare dopo.
Costruisce un modello probabilistico di come le combinazioni di iperparametri si mappano sulle prestazioni, quindi sceglie la prossima combinazione che ha o il punteggio atteso più alto o la maggiore incertezza. È il trade-off esplorazione-sfruttamento: o esplori nuove regioni che potrebbero essere buone, o sfrutti regioni che sai già essere buone.
I metodi bayesiani trovano buoni iperparametri con molti meno tentativi rispetto a random o grid search. Il rovescio della medaglia è che ogni tentativo richiede un po' più tempo perché l'algoritmo deve adattare il suo modello interno prima di scegliere il punto successivo. Librerie come Optuna e Hyperopt fanno tutto loro.
Usa l'ottimizzazione bayesiana quando l'addestramento è costoso e puoi permetterti solo un numero ridotto di esecuzioni.
Successive halving e Hyperband riducono il tempo di calcolo interrompendo in anticipo le esecuzioni peggiori.
Successive halving avvia molte combinazioni di iperparametri con un piccolo budget di training, elimina la metà peggiore, raddoppia il budget per le sopravvissute e ripete.
Hyperband è un wrapper attorno a successive halving che lo esegue più volte con diverse partizioni di budget, così non devi indovinare la configurazione iniziale giusta.
Entrambi i metodi sono utili quando l'addestramento è lento e lo spazio di ricerca è ampio. Funzionano meglio quando le prestazioni iniziali sono un buon segnale di quelle finali, cosa di solito vera per reti neurali e gradient boosting.
Ecco un confronto tra i metodi:
| Costo computazionale | Efficienza di ricerca | Ideale per | |
|---|---|---|---|
| Ricerca manuale | Basso | Bassa | Modelli piccoli, esperienza pregressa |
| Grid search | Alta | Bassa | 2-3 iperparametri, intervalli piccoli |
| Random search | Media | Media | 4+ iperparametri, importanza sconosciuta |
| Ottimizzazione bayesiana | Media | Alta | Training costoso, budget ridotto |
| Successive halving / Hyperband | Basso-medio | Alta | Spazi di ricerca ampi, training lento |
Il tuning servirà a poco se non scegli un intervallo di valori corretto.
Se la tua valutazione è sbagliata, sceglierai gli iperparametri errati. Ci sono quattro aspetti da azzeccare: come dividi i dati, come misuri le prestazioni, quale metrica ottimizzi e come tieni pulito il test set.
Dividi i dati in tre parti prima del tuning.
Il training set serve al modello per apprendere. Il validation set lo usi per valutare ogni combinazione di iperparametri durante il tuning. Il test set lo usi una sola volta, alla fine, per misurare come il modello finale rende su dati mai visti.
Se ottimizzi contro il test set, otterrai un numero di accuratezza che sembra ottimo e un modello che rende meno in produzione. Ogni decisione di tuning presa sul test set fa filtrare informazioni su di esso nel tuo modello.
Una suddivisione comune è 60/20/20 per dataset di medie dimensioni o 80/10/10 per quelli più grandi.
La cross-validation è un modo migliore per valutare gli iperparametri quando il set di validazione è piccolo.
Dividi i dati di training in k fold, di solito 5 o 10. Per ogni combinazione di iperparametri, alleni su k-1 fold e validi su quello rimanente, poi ruoti. Il punteggio finale è la media su tutti i fold.
La cross-validation ti dà una stima più stabile di quanto una combinazione generalizzi, perché non ti affidi a un unico split di validazione fortunato o sfortunato. Il costo è che alleni k modelli per combinazione invece di uno.
Usa la cross-validation quando il dataset è abbastanza piccolo da non rendere affidabile un unico split di validazione e quando puoi permetterti il costo extra di training.
La metrica che ottimizzi deve riflettere ciò che ti interessa davvero.
L'accuratezza va bene per classificazioni bilanciate ma non ha senso per problemi sbilanciati. Per esempio, un modello di rilevamento frodi che predice "non frode" per tutto può ottenere il 99% di accuratezza pur mancando ogni caso. Per classificazioni sbilanciate usa precision, recall, F1 o ROC-AUC. Per la regressione usa RMSE, MAE o R quadrato a seconda che gli outlier contino.
Scegli semplicemente una metrica primaria prima di iniziare il tuning e mantienila.
La data leakage si verifica quando informazioni dal set di validazione o test entrano nel training.
Ecco alcuni modi comuni in cui accade:
Adatta tutti i passaggi di preprocessing solo sul training set, poi applicali a validazione e test. In scikit-learn, questo è il compito di Pipeline: incapsula preprocessing e modellazione in un unico oggetto che rispetta gli split.
La maggior parte delle librerie di ML include strumenti che gestiscono la ricerca e la cross-validation, così non devi implementare nulla da zero.
Scikit-learn include due classi di tuning che coprono la maggior parte dei casi d'uso: GridSearchCV per la grid search e RandomizedSearchCV per la random search. Entrambe avvolgono qualsiasi stimatore scikit-learn, eseguono la cross-validation per ogni combinazione e alla fine ti restituiscono il modello migliore.
GridSearchCV accetta uno stimatore, un dizionario di valori di iperparametri e il numero di fold di cross-validation. Allena un modello per ogni combinazione e tiene quello con il punteggio migliore.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, random_state=42)

param_grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [5, 10, 20],
    "min_samples_leaf": [1, 5, 10],
}

grid = GridSearchCV(RandomForestClassifier(random_state=42), param_grid, cv=5)
grid.fit(X, y)

print(grid.best_params_)
print(grid.best_score_)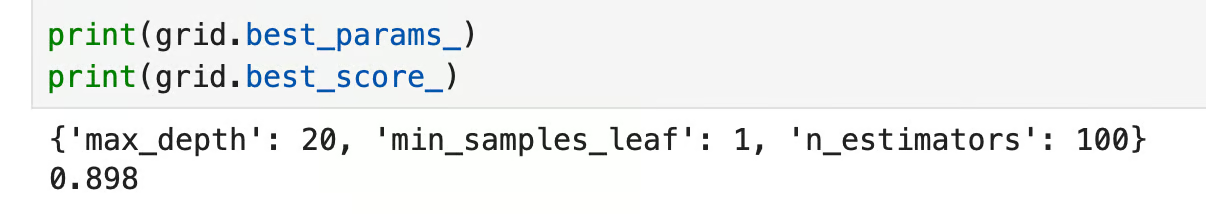
Risultati di GridSearchCV in Python
RandomizedSearchCV usa la stessa interfaccia ma campiona da distribuzioni invece di scorrere una lista fissa. Questo ti permette di coprire un intervallo più ampio con un numero fisso di tentativi.
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

param_dist = {
    "n_estimators": randint(100, 500),
    "max_depth": randint(3, 20),
    "min_samples_leaf": randint(1, 10),
}

random_search = RandomizedSearchCV(
    RandomForestClassifier(random_state=42),
    param_dist,
    n_iter=30,
    cv=5,
    random_state=42,
)
random_search.fit(X, y)

print(random_search.best_params_)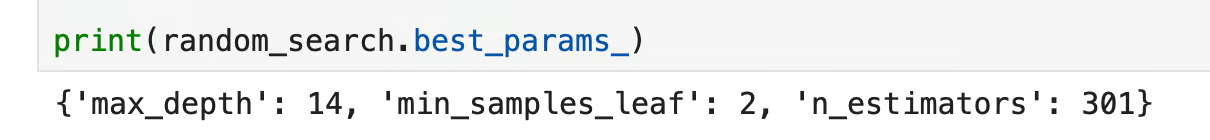
Risultati di RandomizedSearchCV in Python
Per l'ottimizzazione bayesiana, Optuna è la scelta standard. Sceglie la prossima combinazione in base ai risultati precedenti, quindi converge più velocemente della random search quando l'addestramento è costoso.
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 100, 500),
        "max_depth": trial.suggest_int("max_depth", 3, 20),
        "min_samples_leaf": trial.suggest_int("min_samples_leaf", 1, 10),
    }
    model = RandomForestClassifier(**params, random_state=42)
    return cross_val_score(model, X, y, cv=5).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)

print(study.best_params)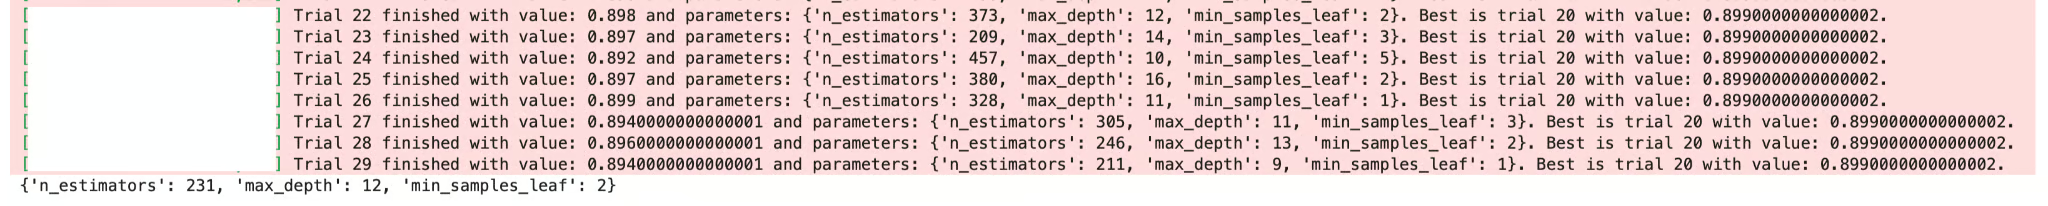
Risultati di Optuna in Python
I metodi trial.suggest_* definiscono lo spazio di ricerca e Optuna decide quale combinazione provare dopo in base ai punteggi visti finora.
R ha due ottime opzioni: caret e tidymodels. Entrambe fanno la stessa cosa — definire una griglia, eseguire la cross-validation, restituire il modello migliore — ma tidymodels è lo standard moderno.
Con caret, passi una griglia di tuning alla funzione train() e specifichi il metodo di campionamento.
library(caret)

data <- iris
ctrl <- trainControl(method = "cv", number = 5)

grid <- expand.grid(
  mtry = c(2, 3, 4)
)

model <- train(
  Species ~ .,
  data = data,
  method = "rf",
  trControl = ctrl,
  tuneGrid = grid
)

print(model$bestTune)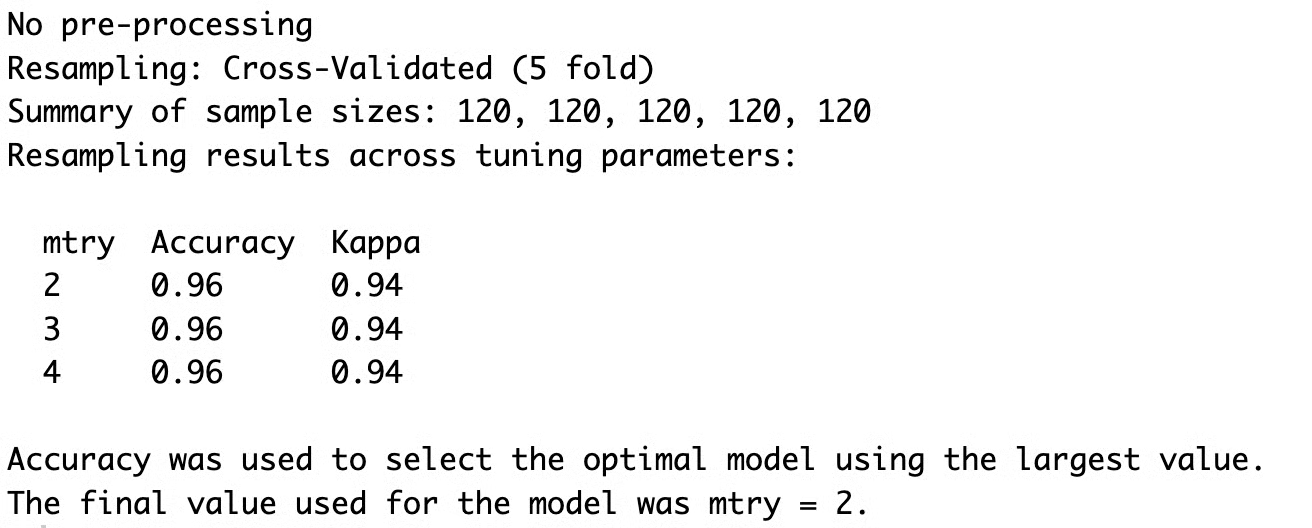
Risultati di Caret in R
tidymodels suddivide il workflow in passaggi chiari: una specifica del modello, una recipe per il preprocessing e una griglia di tuning. È più verboso ma in pratica più scalabile.
library(tidymodels)

data <- iris
split <- initial_split(data, prop = 0.8)
train_data <- training(split)

rf_spec <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")

grid <- grid_regular(
  mtry(range = c(2, 4)),
  trees(range = c(100, 500)),
  min_n(range = c(1, 10)),
  levels = 3
)

folds <- vfold_cv(train_data, v = 5)

results <- tune_grid(
  rf_spec,
  Species ~ .,
  resamples = folds,
  grid = grid
)

show_best(results, metric = "accuracy")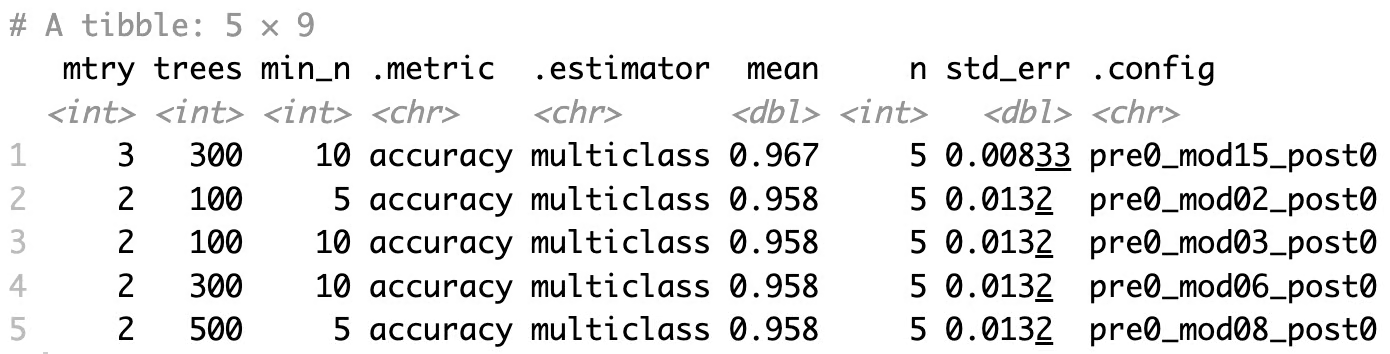
Risultati di Tidymodels in R
Il workflow è esattamente lo stesso che in Python: definisci cosa cercare, come valutarlo e lasci che la libreria esegua il ciclo.
Non tutti gli iperparametri meritano di essere ottimizzati, perché di solito solo pochi controllano la maggior parte delle prestazioni. Ecco quelli che in genere contano di più, per famiglia di modelli.
Dovresti sempre ottimizzare questi tre:
Il gradient boosting (XGBoost, LightGBM, CatBoost) è più sensibile agli iperparametri rispetto alle random forest. Fai attenzione a questi:
Con le SVM, la scelta degli iperparametri conta molto, forse più che con altri modelli:
rbf per problemi non lineari e linear per dati sparsi ad alta dimensionalità.Le reti neurali hanno lo spazio di ricerca più ampio tra le famiglie di modelli comuni. Ottimizza prima questi:
1e-4, 1e-3, 1e-2.Il tuning è costoso, soprattutto quando vuoi testare più valori per parametro e hai molti parametri da ottimizzare. Ecco alcune sfide comuni da conoscere.
Costo computazionale è il vincolo principale. Ogni combinazione che provi significa addestrare un modello completo, e la cross-validation moltiplica per il numero di fold. Una griglia da 100 combinazioni con CV a 5 fold è 500 fit di modello. Se ogni fit dura 10 minuti, sono più di tre giorni.
Spazi di ricerca ampi crescono in modo moltiplicativo. Cinque iperparametri con cinque valori ciascuno fanno 3.125 combinazioni. Qui la grid search non è più un'opzione e va sostituita con random search o metodi bayesiani.
Rendimenti decrescenti arrivano prima di quanto molti pensino. Le prime esecuzioni di tuning di solito danno i guadagni maggiori. Le successive 50 potrebbero ricavare un altro punto percentuale di accuratezza. A un certo punto, le risorse extra rendono di più se investite nell'acquisire più dati o nel migliorare le feature.
Trade-off accuratezza-tempo conta più in produzione che in sviluppo. Un modello che segna lo 0,5% in più ma impiega il doppio del tempo per allenarsi potrebbe non valere la pena se lo rialleni ogni giorno. Dovresti decidere in anticipo quanta accuratezza vale quanta computazione.
Ecco alcune buone abitudini da seguire quando ottimizzi gli iperparametri di un modello di machine learning:
[0.001, 100], perderai tempo su valori che non funzionano mai. Parti da range noti come ragionevoli per il tuo algoritmo, poi restringili in base a ciò che osservi.La maggior parte dei fallimenti nel tuning dipende da errori facili da evitare. Eccone alcuni:
Entrambe migliorano il tuo modello, ma agiscono su parti diverse del problema.
Il feature engineering migliora i dati in ingresso. Crei nuove feature a partire da quelle esistenti, codifichi le variabili categoriche, gestisci i valori mancanti e rimuovi il rumore. Feature migliori danno al modello segnali più utili da cui apprendere.
L'ottimizzazione degli iperparametri migliora come il modello apprende dalle feature che gli fornisci. Cambia il comportamento dell'algoritmo sui dati invece di cambiare i dati.
Le due cose sono complementari. Il feature engineering di solito dà i guadagni maggiori all'inizio di un progetto, quando i dati sono ancora grezzi e al modello mancano segnali evidenti. L'ottimizzazione degli iperparametri dà guadagni più piccoli ma costanti una volta che le feature sono abbastanza buone.
Se il tuo modello è bloccato e non sai cosa provare per primo, guarda i tuoi errori. Se il modello manca pattern che sembrano ovvi dai dati, hai un problema di feature. Se fa overfitting o underfitting, hai un problema di tuning.
Il tuning è uno step standard in qualsiasi workflow di ML.
Spesso dà guadagni maggiori che cambiare algoritmo. Per esempio, una random forest ben ottimizzata spesso batte un modello di gradient boosting poco ottimizzato sugli stessi dati, anche se il gradient boosting è l'algoritmo più sofisticato.
Il tuning aiuta anche nella generalizzazione. Iperparametri come la profondità massima e il tasso di dropout controllano direttamente quanto il modello può fare overfitting. Mettere a punto questi valori fa la differenza tra un modello che memorizza il training set e uno che rende bene su nuovi dati.
In produzione, il tuning trasforma una proof-of-concept in un sistema affidabile.
Le impostazioni predefinite ti fanno partire, ma non sono quelle che manterranno il modello competitivo tra riallenamenti e requisiti di business. Ogni team di ML serio considera il tuning parte del processo.
L'ottimizzazione degli iperparametri è un ciclo iterativo di ricerca, valutazione e affinamento di ciò che funziona per i tuoi dati specifici.
I risultati migliori arrivano combinando tre cose: un metodo di ricerca che rispetta il tuo budget computazionale, una validazione che ti dà un punteggio rilevante e un tracciamento degli esperimenti che ti permette di tornare indietro a vedere cosa hai provato.
Parti con random search o grid search. Passa all'ottimizzazione bayesiana quando l'addestramento diventa così costoso che il numero di tentativi conta davvero. In ogni caso, ottimizza gli iperparametri rilevanti per il tuo modello, mantieni pulito il test set e registra ogni esecuzione.
Se stai pensando a una carriera nel machine learning, iscriviti al percorso Machine Learning Engineer per essere pronto al lavoro nel 2026.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min




