
Cursus
Hyperparameter Tuning in Python
4 uur
25.4K
De nauwkeurigheid van je model is niet slecht omdat je het verkeerde algoritme koos – maar omdat je het nooit hebt getuned.
De meeste mensen trainen een model met standaardinstellingen, zien de nauwkeurigheid rond de 80 procent uitkomen en concluderen dat het algoritme niet geschikt is voor hun taak. Maar het algoritme is niet het probleem. Elk ML‑model heeft parameters die bepalen hoe het leert, en die parameters worden ingesteld voordat de training überhaupt begint. Als je ze goed kiest, kun je 10–20% extra nauwkeurigheid halen uit hetzelfde model op dezelfde data.
Deze parameters heten hyperparameters, en een goede keuze maakt het verschil tussen een model dat oké is en een model dat het bijna altijd goed heeft. Hyperparametertuning is het proces van zoeken naar de combinatie die je de beste prestaties geeft.
In dit artikel laat ik je zien wat hyperparametertuning is, welke zoekstrategieën het beste werken, hoe je resultaten evalueert zonder jezelf voor de gek te houden, en hoe je alles draait in Python en R.
Ben je nieuw in data science en machine learning? Bekijk dan eerst de Machine Learning Fundamentals in Python-cursus voordat je met meer geavanceerde onderwerpen aan de slag gaat.
Hyperparametertuning is het proces van het vinden van de instellingen waarmee een model het best leert.
Elk ML‑model heeft twee soorten getallen. Sommige worden tijdens de training uit de data geleerd, zoals de gewichten in een neuraal netwerk of de splitsingspunten in een beslisboom. Andere worden ingesteld voordat de training begint – dat zijn de hyperparameters. Ze bepalen hoe het model leert: hoe snel, hoe diep, hoeveel het moet generaliseren of juist onthouden.
Standaardhyperparameters bestaan om je een model te geven dat draait. Ze zijn niet bedoeld om je het beste model voor jouw specifieke dataset te geven. Een standaard learning rate die werkt voor beeldclassificatie zal logischerwijs niet goed presteren op tabeldata. Een standaard boomdiepte die prima is voor een schone dataset zal overfitten op een noisy dataset. Je snapt het idee.
Het tuningproces doorzoekt verschillende combinaties van hyperparameterwaarden, traint voor elke combinatie een model en bewaart de combinatie die het best presteert op je validatiedata.
Wat je hiermee bereikt, is vaak beter dan overstappen op een zogenaamd beter maar ongetuned algoritme.
Het verschil komt neer op wie ze instelt en wanneer.
Modelparameters worden door het algoritme tijdens de training geleerd. Je stelt ze nooit zelf in. Het trainingsproces past ze aan op basis van de data en het minimaliseren van een verliesfunctie. Bijvoorbeeld:
Hyperparameters kies jij voordat de training start. Ze sturen hoe het leerproces werkt, maar het algoritme past ze zelf niet aan. Als je ze niet instelt, gebruikt de library de defaults. Bijvoorbeeld:
Hier is een vergelijking naast elkaar:
| Modelparameters | Hyperparameters | |
|---|---|---|
| Ingesteld door | Het trainingsalgoritme | Jij |
| Wanneer | Tijdens training | Voor de training |
| Geleerd uit data | Ja | Nee |
| Voorbeelden | Gewichten, coëfficiënten, splitsingspunten | Learning rate, boomdiepte, regularisatiesterkte |
| Verandert tussen runs | Elke keer dat je hertraint | Alleen als jij ze wijzigt |
Modelparameters beantwoorden wat het model heeft geleerd. Hyperparameters beantwoorden hoe het heeft geleerd.
Tuning is een lus.
Je begint met het kiezen van de hyperparameters waar je over wilt zoeken en definieert een bereik aan waarden voor elk. Vervolgens train je een model met één combinatie, meet je de prestaties op validatiedata, en gebruik je dat resultaat om te bepalen wat je hierna probeert.
De lus ziet er zo uit:
De keuze hoe je tussen iteraties bijwerkt, onderscheidt de ene zoekmethode van de andere. Handmatig tunen werkt op intuïtie. Grid search loopt een vooraf bepaalde lijst af. Bayesiaanse methoden bouwen een model van welke combinaties waarschijnlijk werken.
Ik ga hierna dieper in op deze methoden.
De zoekmethode die je kiest, bepaalt hoeveel compute je verbruikt en hoe waarschijnlijk het is dat je goede hyperparameters vindt.
Handmatig zoeken is de eenvoudigste methode. Je kiest een combinatie hyperparameters, traint het model, bekijkt het resultaat en past aan op basis van wat je zag.
Het werkt wanneer je een klein model hebt, een paar hyperparameters en ervaring met het algoritme. Als je al weet dat XGBoost meestal een learning rate rond 0,05 en een boomdiepte van 6 prettig vindt, kun je daar beginnen en bijstellen op basis van wat je observeert.
Handmatig zoeken werkt niet meer wanneer de zoekruimte groeit. Drie hyperparameters met elk vijf redelijke waarden leveren al 125 combinaties op, en niemand tunet 125 modellen met de hand.
Grid search controleert elke combinatie in een vooraf gedefinieerde lijst met waarden.
Je definieert een rooster – bijvoorbeeld learning rates van [0.01, 0.05, 0.1] en boomdieptes van [3, 5, 7] – en grid search traint een model voor elk van de negen combinaties. Het is uitputtend en reproduceerbaar.
Het probleem is de compute‑kosten.
Eén extra hyperparameter met vijf waarden vermenigvuldigt je trainingsruns met vijf. Grid search verspilt ook moeite aan waarden die weinig uitmaken – als boomdiepte je score nauwelijks beïnvloedt, traint grid search alsnog een model voor elke diepte die je opsomt.
Grid search is een goede default voor kleine zoekruimtes met twee of drie hyperparameters.
Random search neemt willekeurige combinaties uit een bereik in plaats van een vast rooster af te lopen.
Je definieert een verdeling voor elke hyperparameter en random search trekt combinaties uit die verdelingen. Het is efficiënter dan grid search omdat het geen runs verspilt aan waarden die weinig uitmaken – als slechts één van de drie hyperparameters de prestaties beïnvloedt, verkent random search die belangrijke hyperparameter alsnog over veel verschillende waarden.
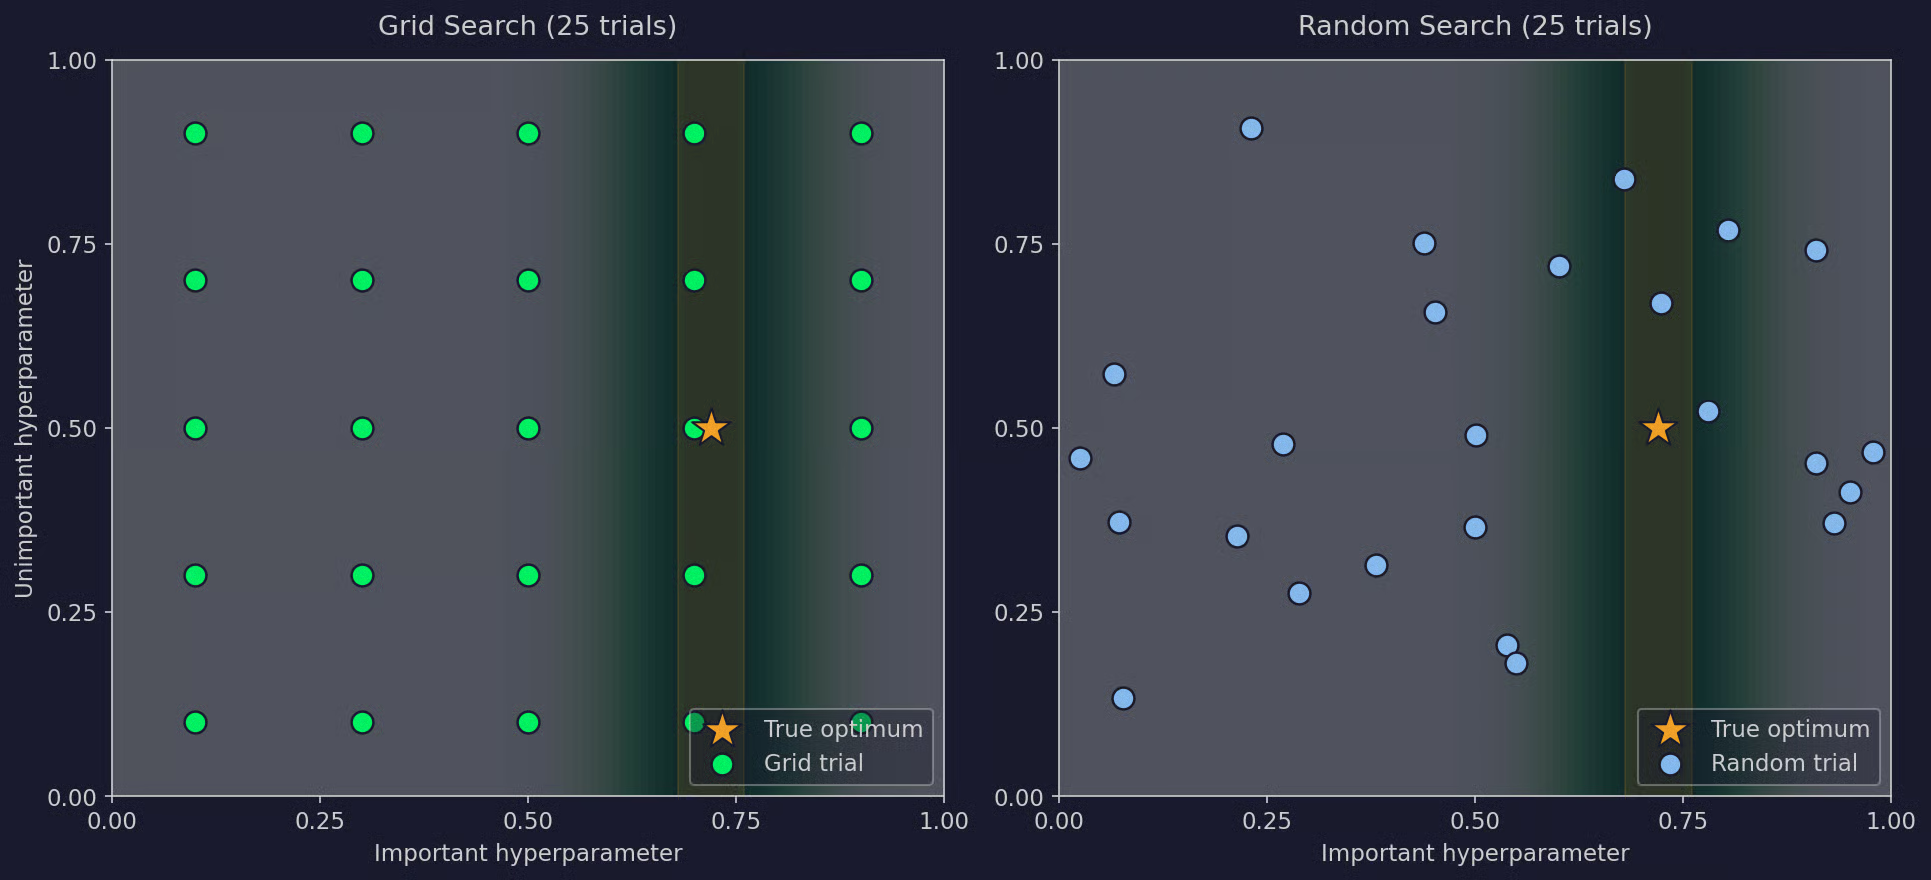
Grid search versus random search
Random search is de betere default voor alles met meer dan twee hyperparameters.
Bayesiaanse optimalisatie gebruikt de resultaten van eerdere pogingen om te bepalen wat je hierna probeert.
Het bouwt een probabilistisch model van hoe hyperparametercombinaties zich vertalen naar prestaties, en kiest vervolgens de volgende combinatie met ofwel de hoogste verwachte score of de hoogste onzekerheid. Dit is de explore‑exploit‑afweging: of je verkent nieuwe regio’s die goed zouden kunnen zijn, of je benut regio’s waarvan je al weet dat ze goed zijn.
Bayesiaanse methoden vinden in veel minder pogingen goede hyperparameters dan random of grid search. De keerzijde is dat elke poging iets langer duurt omdat het algoritme eerst zijn interne model moet fitten voordat het het volgende punt kiest. Libraries zoals Optuna en Hyperopt doen dit voor je.
Gebruik Bayesiaanse optimalisatie wanneer trainen duur is en je je slechts een klein aantal runs kunt veroorloven.
Successive halving en Hyperband verkorten de rekentijd door slechte runs vroegtijdig te stoppen.
Successive halving start veel hyperparametercombinaties met een klein trainingsbudget, gooit de slechtste helft weg, verdubbelt het budget voor de overlevers en herhaalt dat.
Hyperband is een wrapper om successive halving heen die het meerdere keren draait met verschillende budgetverdelingen, zodat jij niet de juiste startconfiguratie hoeft te raden.
Beide methoden zijn nuttig wanneer trainen traag is en je een grote zoekruimte hebt. Ze werken het best wanneer vroege prestaties een redelijke indicatie zijn voor de uiteindelijke prestaties, wat meestal geldt voor neurale netwerken en gradient boosting.
Zo verhouden de methoden zich:
| Rekenkosten | Zoekefficiëntie | Beste voor | |
|---|---|---|---|
| Handmatige zoektocht | Laag | Laag | Kleine modellen, ervaring vooraf |
| Grid search | Hoog | Laag | 2–3 hyperparameters, kleine bereiken |
| Random search | Middel | Middel | 4+ hyperparameters, onbekende belangrijkheid |
| Bayesiaanse optimalisatie | Middel | Hoog | Dure training, klein budget |
| Successive halving / Hyperband | Laag tot middel | Hoog | Grote zoekruimtes, trage training |
Tunen brengt je niet ver als je geen correct waardenbereik kiest.
Als je evaluatie niet klopt, kies je de verkeerde hyperparameters. Er zijn vier dingen die je goed moet doen: hoe je de data splitst, hoe je prestaties meet, welke metriek je optimaliseert en hoe je de testset schoon houdt.
Splits je data in drie delen voordat je gaat tunen.
De trainingsset is waar het model van leert. De validatieset gebruik je om elke hyperparametercombinatie tijdens het tunen te scoren. De testset gebruik je één keer, helemaal aan het einde, om te meten hoe het uiteindelijke model presteert op ongeziene data.
Als je tegen de testset tuned, krijg je een nauwkeurigheidsgetal dat er geweldig uitziet en een model dat in productie ondermaats presteert. Elke tuningbeslissing op basis van de testset laat informatie over die set in je model lekken.
Een veelvoorkomende verdeling is 60/20/20 voor middelgrote datasets of 80/10/10 voor grotere.
Cross‑validatie is een betere manier om hyperparameters te scoren wanneer je validatieset klein is.
Je splitst de trainingsdata in k folds – meestal 5 of 10. Voor elke hyperparametercombinatie train je op k‑1 folds en valideer je op de overblijvende fold, en roteer je. De uiteindelijke score is het gemiddelde over alle folds.
Cross‑validatie geeft je een stabielere schatting van hoe goed een hyperparametercombinatie generaliseert, omdat je niet vertrouwt op één gelukkige of ongelukkige validatiesplit. De prijs is dat je per combinatie k modellen traint in plaats van één.
Gebruik cross‑validatie wanneer je dataset zo klein is dat een enkele validatiesplit niet betrouwbaar is, en wanneer je de extra trainingskosten kunt dragen.
De metriek die je optimaliseert, moet aansluiten bij wat je echt belangrijk vindt.
Accuracy is prima voor gebalanceerde classificatie, maar heeft weinig zin bij ongebalanceerde problemen. Een fraudedetectiemodel dat alles als “geen fraude” voorspelt, kan 99% nauwkeurigheid halen en toch elk geval missen. Voor ongebalanceerde classificatie gebruik je precision, recall, F1 of ROC‑AUC. Voor regressie gebruik je RMSE, MAE of R‑kwadraat, afhankelijk van of uitschieters belangrijk zijn.
Kies gewoon één primaire metriek voordat je begint met tunen en houd je daaraan.
Dataleakage ontstaat wanneer informatie uit je validatie- of testset in de training terechtkomt.
Hier zijn veelvoorkomende manieren waarop dat gebeurt:
Fit alle preprocessingstappen alleen op de trainingsset en pas ze daarna toe op validatie en test. In scikit‑learn is dit waar Pipeline voor is – het verpakt preprocessing en modellering in één object dat je splits respecteert.
De meeste ML‑libraries bevatten tools die de zoektocht en cross‑validatie doen, zodat je niets vanaf nul hoeft te implementeren.
Scikit‑learn wordt geleverd met twee tuningklassen die de meeste use‑cases dekken: GridSearchCV voor grid search en RandomizedSearchCV voor random search. Beide wikkelen elke scikit‑learn estimator in, draaien cross‑validatie voor elke combinatie en geven je aan het einde het beste model.
GridSearchCV neemt een estimator, een dictionary met hyperparametervalidaties en het aantal cross‑validatiefolds. Het traint een model voor elke combinatie en bewaart degene met de beste score.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import make_classification

X, y = make_classification(n_samples=1000, random_state=42)

param_grid = {
    "n_estimators": [100, 200, 500],
    "max_depth": [5, 10, 20],
    "min_samples_leaf": [1, 5, 10],
}

grid = GridSearchCV(RandomForestClassifier(random_state=42), param_grid, cv=5)
grid.fit(X, y)

print(grid.best_params_)
print(grid.best_score_)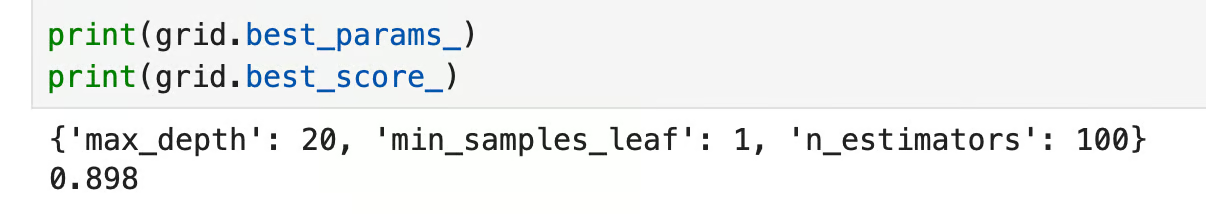
GridSearchCV‑resultaten in Python
RandomizedSearchCV gebruikt dezelfde interface maar sampelt uit verdelingen in plaats van een vaste lijst af te lopen. Zo kun je met een vast aantal pogingen een groter bereik afdekken.
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint

param_dist = {
    "n_estimators": randint(100, 500),
    "max_depth": randint(3, 20),
    "min_samples_leaf": randint(1, 10),
}

random_search = RandomizedSearchCV(
    RandomForestClassifier(random_state=42),
    param_dist,
    n_iter=30,
    cv=5,
    random_state=42,
)
random_search.fit(X, y)

print(random_search.best_params_)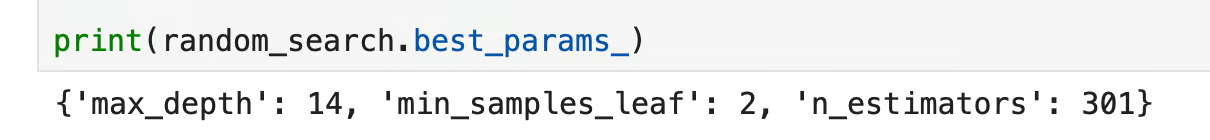
RandomizedSearchCV‑resultaten in Python
Voor Bayesiaanse optimalisatie is Optuna de standaardkeuze. Het kiest de volgende combinatie op basis van eerdere resultaten, dus het convergeert sneller dan random search wanneer trainen duur is.
import optuna
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def objective(trial):
    params = {
        "n_estimators": trial.suggest_int("n_estimators", 100, 500),
        "max_depth": trial.suggest_int("max_depth", 3, 20),
        "min_samples_leaf": trial.suggest_int("min_samples_leaf", 1, 10),
    }
    model = RandomForestClassifier(**params, random_state=42)
    return cross_val_score(model, X, y, cv=5).mean()

study = optuna.create_study(direction="maximize")
study.optimize(objective, n_trials=30)

print(study.best_params)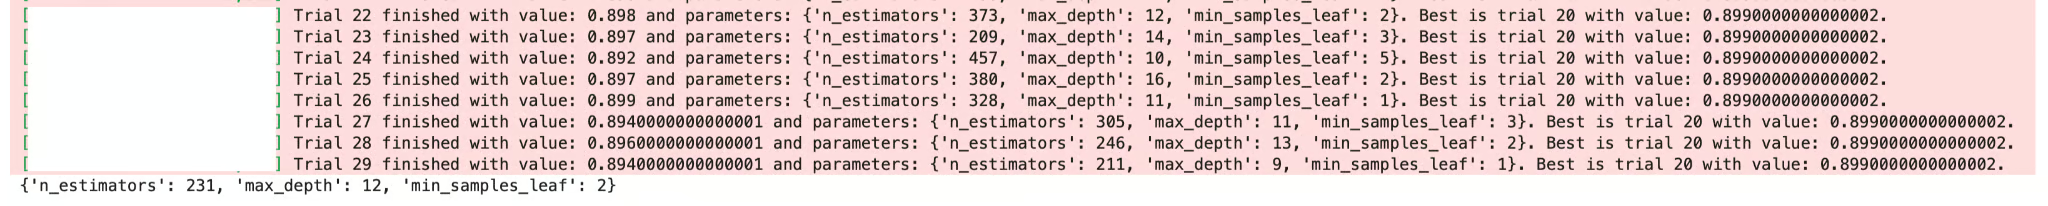
Optuna‑resultaten in Python
De methoden trial.suggest_* definiëren de zoekruimte, en Optuna beslist welke combinatie hierna wordt geprobeerd op basis van de scores die het tot nu toe heeft gezien.
R heeft twee sterke opties: caret en tidymodels. Beide doen hetzelfde – een grid definiëren, cross‑validatie draaien, het beste model teruggeven – maar tidymodels is de moderne default.
Met caret geef je een tuninggrid door aan de functie train() en specificeer je de resamplingmethode.
library(caret)

data <- iris
ctrl <- trainControl(method = "cv", number = 5)

grid <- expand.grid(
  mtry = c(2, 3, 4)
)

model <- train(
  Species ~ .,
  data = data,
  method = "rf",
  trControl = ctrl,
  tuneGrid = grid
)

print(model$bestTune)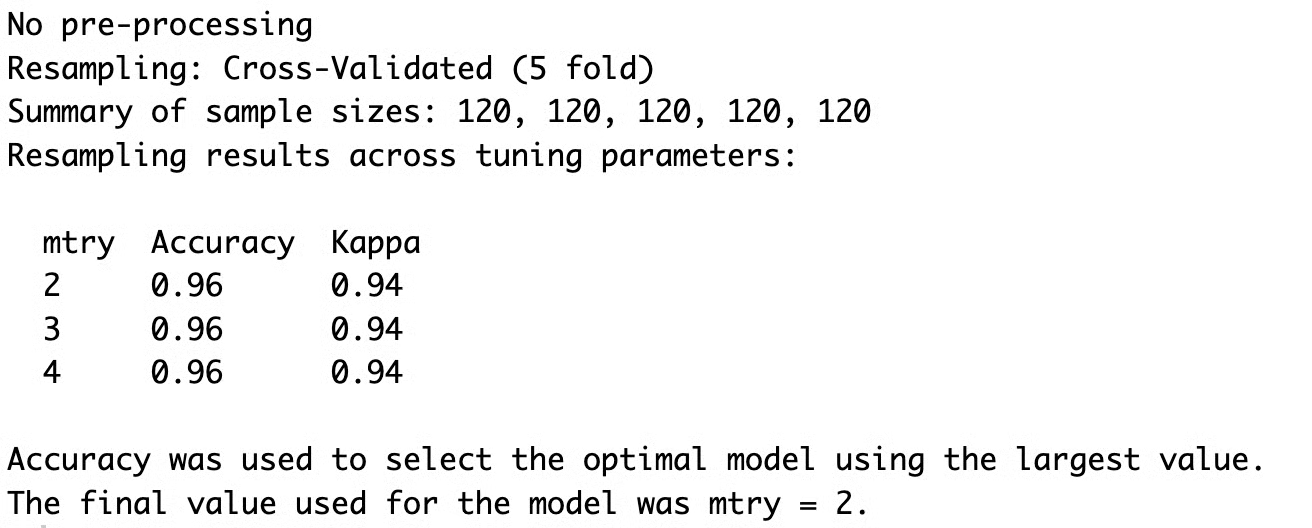
Caret‑resultaten in R
tidymodels splitst de workflow op in duidelijke stappen: een modelspecificatie, een recipe voor preprocessing en een tuninggrid. Het is omslachtiger, maar in de praktijk beter schaalbaar.
library(tidymodels)

data <- iris
split <- initial_split(data, prop = 0.8)
train_data <- training(split)

rf_spec <- rand_forest(
  mtry = tune(),
  trees = tune(),
  min_n = tune()
) |>
  set_engine("ranger") |>
  set_mode("classification")

grid <- grid_regular(
  mtry(range = c(2, 4)),
  trees(range = c(100, 500)),
  min_n(range = c(1, 10)),
  levels = 3
)

folds <- vfold_cv(train_data, v = 5)

results <- tune_grid(
  rf_spec,
  Species ~ .,
  resamples = folds,
  grid = grid
)

show_best(results, metric = "accuracy")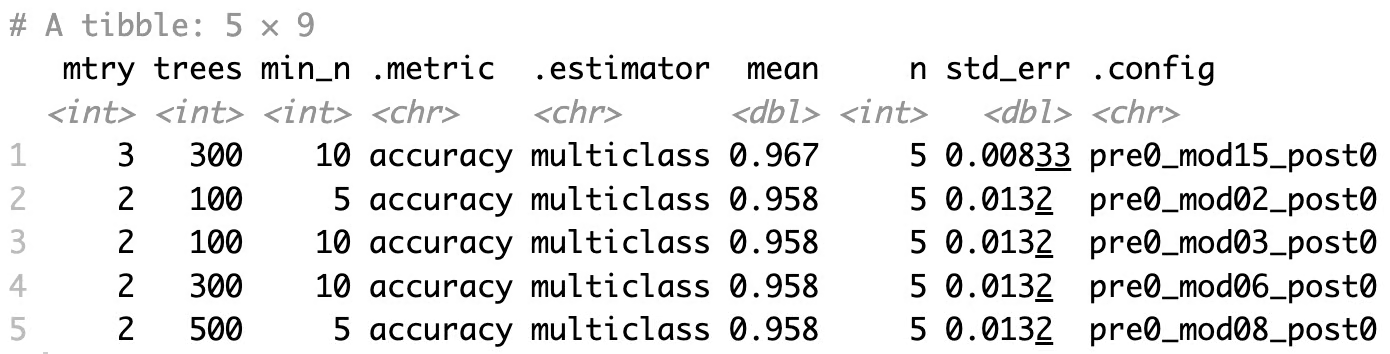
Tidymodels‑resultaten in R
De workflow is precies hetzelfde als in Python: je definieert waarover je zoekt, hoe je het scoort, en laat de library de lus draaien.
Niet elke hyperparameter is de moeite waard, omdat meestal maar een paar het grootste deel van de prestaties bepalen. Dit zijn de hyperparameters die doorgaans het eerst tellen, per modelfamilie.
Deze drie moet je altijd tunen:
Gradient boosting (XGBoost, LightGBM, CatBoost) is gevoeliger voor hyperparameters dan random forests. Let op deze:
Bij SVM’s is de keuze van hyperparameters erg belangrijk, misschien nog wel meer dan bij andere modellen:
rbf voor niet‑lineaire problemen en linear voor hoog-dimensionale, sparse data.Neurale netwerken hebben de grootste zoekruimte van alle gangbare modelfamilies. Tune deze eerst:
1e-4, 1e-3, 1e-2.Tunen is kostbaar, zeker als je meerdere waarden per parameter wilt testen en veel parameters hebt om te tunen. Dit zijn veelvoorkomende uitdagingen om te kennen.
Rekenkosten zijn de grootste beperking. Elke combinatie die je probeert, betekent een volledig model trainen, en cross‑validatie vermenigvuldigt dat met het aantal folds. Een grid van 100 combinaties met 5‑voudige CV is 500 model‑fits. Als elke fit 10 minuten duurt, is dat meer dan drie dagen.
Grote zoekruimtes groeien multiplicatief. Vijf hyperparameters met elk vijf waarden zijn 3.125 combinaties. Hier is grid search geen optie meer en maak je plaats voor random search of Bayesiaanse methoden.
Afnemende meeropbrengst treedt eerder op dan de meeste mensen verwachten. De eerste paar tuningruns geven meestal de grootste winst. De volgende 50 leveren misschien nog een procentje nauwkeurigheid op. Op een gegeven moment kun je de extra compute beter besteden aan meer data verzamelen of je features verbeteren.
De afweging tussen nauwkeurigheid en tijd is in productie belangrijker dan in ontwikkeling. Een model dat 0,5% hoger scoort maar twee keer zo lang traint, is het misschien niet waard als je dagelijks hertraint. Bepaal vooraf hoeveel nauwkeurigheid hoeveel compute waard is.
Dit zijn goede gewoonten om te volgen bij het tunen van hyperparameters van een machinelearningmodel:
[0.001, 100] is, verspil je tijd aan waarden die nooit werken. Begin met bereiken waarvan bekend is dat ze redelijk zijn voor je algoritme en verfijn ze op basis van wat je ziet.De meeste tuningfouten komen door missers die makkelijk te vermijden zijn. Enkele voorbeelden:
Beide verbeteren je model, maar ze pakken verschillende delen van het probleem aan.
Feature engineering verbetert de inputdata. Je creëert nieuwe features uit bestaande, codeert categorische variabelen, behandelt missende waarden en verwijdert ruis. Betere features geven het model nuttigere signalen om van te leren.
Hyperparametertuning verbetert hoe het model leert van de features die je aanlevert. Het verandert het gedrag van het algoritme op de data in plaats van de data zelf te veranderen.
De twee vullen elkaar aan. Feature engineering geeft je meestal de grootste winst vroeg in een project, wanneer de data nog rauw is en het model duidelijke signalen mist. Hyperparametertuning geeft kleinere maar consistente verbeteringen zodra je features goed genoeg zijn.
Als je model vastzit en je niet weet waarmee je moet beginnen, kijk dan naar je fouten. Als het model patronen mist die vanuit de data duidelijk lijken, heb je een feature‑probleem. Als het overfit of underfit, heb je een tuningprobleem.
Tunen is een standaardstap in elke ML‑workflow.
Het levert vaak meer winst op dan van algoritme wisselen. Een goed getunede random forest verslaat vaak een slecht getunede gradient boosting op dezelfde data, ook al is gradient boosting het meer geavanceerde algoritme.
Tunen helpt ook met generalisatie. Hyperparameters zoals maximale diepte en dropoutrate bepalen direct hoeveel het model kan overfitten. Deze goed krijgen is het verschil tussen een model dat de trainingsset uit het hoofd leert en een model dat goed presteert op nieuwe data.
In productie maakt tunen van een proof‑of‑concept een systeem dat betrouwbaar is.
De standaardinstellingen helpen je op weg, maar het zijn niet de instellingen die het model competitief houden bij hertraining en veranderende businessvereisten. Elk serieus ML‑team ziet tunen als onderdeel van het proces.
Hyperparametertuning is een iteratieve lus van zoeken, evalueren en inzoomen op wat werkt voor jouw specifieke data.
De beste resultaten komen uit een combinatie van drie dingen: een zoekmethode die past bij je computebudget, validatie die je een relevante score geeft, en experimenttracking waarmee je kunt terugzien wat je hebt geprobeerd.
Begin met random search of grid search. Ga over op Bayesiaanse optimalisatie wanneer trainen zo duur wordt dat het aantal pogingen echt telt. Hoe dan ook: tune de hyperparameters die relevant zijn voor je model, houd je testset schoon en log elke run.
Overweeg je een carrière in machine learning? Schrijf je dan in voor ons Machine Learning Engineer-traject om in 2026 job‑ready te zijn.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

