

动机
设想您是一家零售公司的数据科学家。您的上司希望您根据客户的消费行为,将客户细分为以下群组:低、一般、中等或铂金客户,以便开展定向营销和产品推荐。
已知这些客户并没有相应的历史标签,那么如何对他们进行分类?
这正是聚类可以发挥作用的地方。它是一种无监督机器学习技术,用于将无标签数据归入相似的类别。
本教程将重点介绍分层聚类方法,这是无监督学习中的众多技术之一。我们将先概述什么是分层聚类,然后与一些现有技术进行比较。
接着,我们将使用流行的 Scipy 库,带您在 Python 中一步步实现。
分层聚类的定义
分层聚类方法基于先前已定义簇的基础上,逐步确定后续簇。该技术更侧重于将数据分组为称为树状图(dendrogram)的簇树,通过图形方式表示底层簇之间的层级关系。
分层聚类与其他聚类技术的比较
分层聚类是一种功能强大的算法,但并非唯一选择,每种聚类类型都有各自的优缺点。
下面我们来了解它与其他聚类类型(如 K-means 和基于模型的聚类)的对比。还有许多其他技术,但这两种方法与分层聚类一样被广泛使用,也有助于为理解其他方法提供框架。
您可以在我们的另一篇文章中进一步了解机器学习中的聚类,其中涵盖了五种必备的聚类算法。
分层聚类 vs K-means 聚类
与分层聚类不同,K-means 聚类旨在将原始数据点划分为用户预先指定数量“K”的组或簇。
其总体思想是寻找在所有属性(变量或特征)上,使各点到各自中心的平方欧氏距离之和最小的簇,并以迭代方式合并这些个体。
我们的使用 Scikit-learn 进行 Python K-means 聚类教程,将通过一个有趣的案例研究帮助您理解 K-means 聚类的内部机制。
优点
- 与分层聚类相比,计算效率更高,可用于分析大型数据集。
- K-means 更易于理解和实现。
缺点
- 相比分层聚类,它的灵活性较差,因为要求用户事先指定簇的数量,这在某些情况下并不直观。
- 结果不稳定,同一数据集在不同迭代间可能发生变化。
- 对离群值更敏感,因为数据中的离群值会影响簇的均值。
- K-means 和分层聚类都无法直接处理分类数据,对于非连续或方差很大的数据可能表现不佳。
尽管存在局限性,K-means 聚类仍因易用和高效而广受欢迎。它常被用作与其他聚类技术性能比较的参考点。
基于模型的聚类
K-means 和分层聚类都使用距离矩阵来表示数据集中各点之间的距离。另一方面,基于模型的聚类运用统计技术来识别数据中的簇。一般流程如下:
- 确定要使用的统计模型并选择簇的数量。
- 在数据上拟合模型。
- 根据模型参数识别簇。
优点
- 基于模型的聚类比分层聚类更灵活,因为它允许使用不同模型来识别不同类型的簇。
- 在具有复杂形状或结构的数据上表现更好。
缺点
- 计算成本高于分层聚类,尤其是在大数据情况下。
- 需要对统计建模技术有更深入的理解,因为模型的选择会影响最终结果。
- 与 K-means 聚类类似,需要事先指定簇的数量。
分层聚类的应用
分层聚类在我们的日常生活中应用广泛,包括但不限于生物学、图像处理、营销、经济学和社交网络分析等领域。
生物学
DNA 序列的聚类是生物信息学中最大的挑战之一。
生物学家可以利用分层聚类研究生物体之间的遗传关系,将其分类为系统分类学中的群体。这有助于对底层关系进行快速分析与可视化。
图像处理
在图像处理中可以执行分层聚类,按颜色、强度或其他特征将图像中相似的区域或像素分组。这对图像分割、图像分类和目标识别等后续任务很有帮助。
营销
营销专家可以使用分层聚类,根据客户的购买习惯来构建不同类型客户之间的层级,以制定更优的营销策略和产品推荐。例如,在零售中可根据客户是低、中、高消费人群来推荐不同的产品。
社交网络分析
如果高效利用,社交网络是宝贵信息的来源。分层聚类可用于识别群体或社区,并理解它们之间的相互关系以及整个网络的结构。
分层聚类算法
本节我们将关注三个核心概念:分层算法的步骤、两种分层聚类类型(自底向上的凝聚式和自顶向下的分裂式)的要点,最后是选择合适距离度量的一些技巧。
分层聚类算法所涉及的步骤
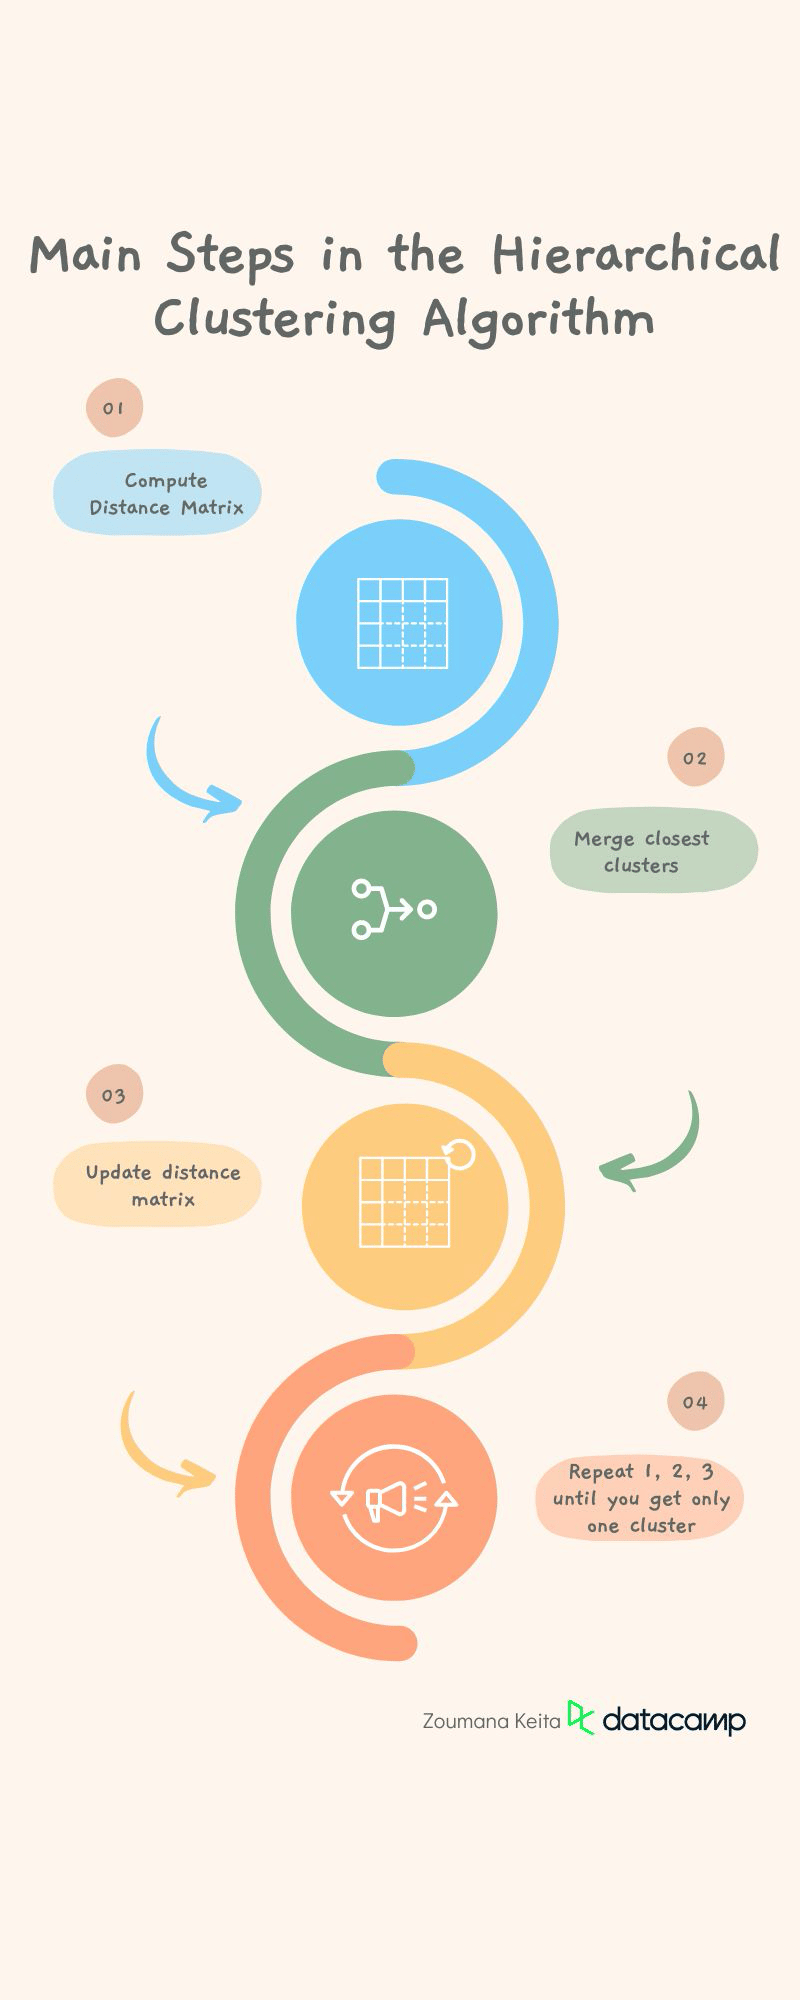
分层聚类算法使用距离度量来生成簇。该生成过程包括以下主要步骤:
预处理数据,去除缺失数据,并执行任何其他使数据尽可能干净的操作。此步骤在大多数机器学习任务中都较为通用。
1. 使用特定距离度量(如欧氏距离、曼哈顿距离或余弦相似度)计算距离矩阵,包含每对数据点之间的距离。默认距离度量为欧氏距离。
2. 合并距离最近的两个簇。
3. 根据新簇更新距离矩阵。
4. 重复步骤 1、2 和 3,直到所有簇合并为一个单一簇。
分层聚类示例
我们可以将凝聚式和分裂式聚类看作彼此的镜像。下面看看每种方法如何运作,并配以分层聚类示例和图示可视化。
凝聚式分层聚类
第一种情形对应上文所述方法。它从将每个观测视为单元素簇(仅包含一个数据点的簇)开始,然后迭代地合并簇,直到只剩一个簇。此过程也称为自底向上方法。
如下图所示:
- 我们先将每种动物视为其各自独立的簇。
- 随后根据相似性,将这些独立动物生成三个不同的簇:
- 鸟类:鹰和孔雀
- 哺乳动物:狮子和熊
- 多于三条腿的动物:蜘蛛和蝎子。
- 我们继续合并过程,通过合并最相似的两个簇——鸟类和哺乳动物——来创建脊椎动物簇。
- 在此之后,剩余的两个簇,脊椎动物与多于三条腿,合并为一个动物总簇。
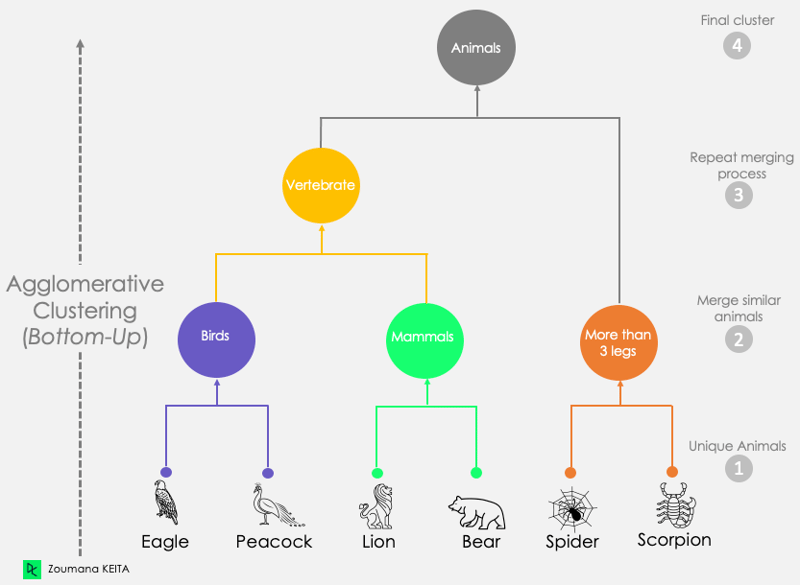
凝聚式聚类方法的树状图
分裂式聚类
相反,分裂式聚类是自顶向下的方法,因为它从将所有数据点视为一个唯一簇开始,然后逐步拆分,直到每个数据点都是独立的。
从下方的分裂式方法图示可见:
- 我们注意到整个动物数据集最初被视为单一整体。
- 接着,将该整体分为两个簇:脊椎动物与多于 3 条腿。
- 对先前创建的簇迭代地应用拆分过程,直到得到独立的各个动物。
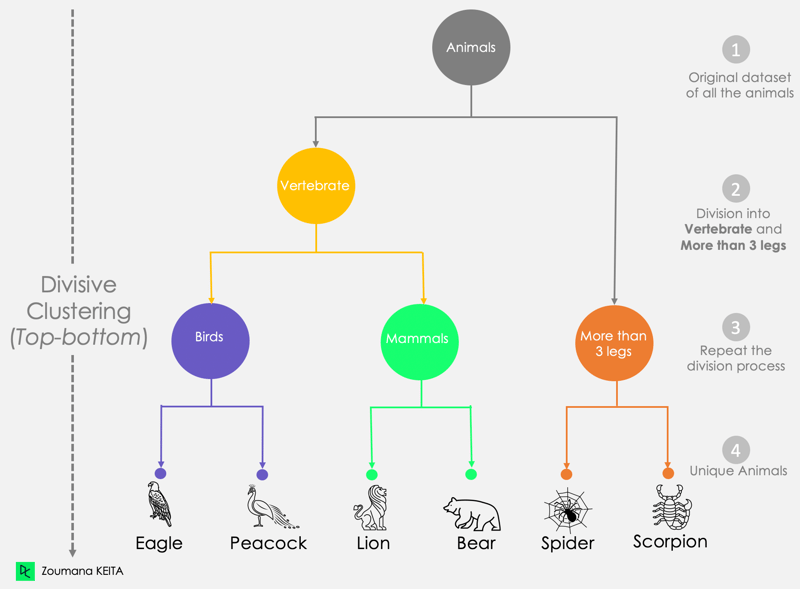
分裂式聚类方法的树状图
选择合适的距离度量
选择距离度量是聚类中的关键步骤,取决于您要解决的问题。以如下场景为例,我们可以基于多种方式对学生进行聚类,例如他们的:
- 原籍国家
- 性别(男性或女性)
- 既往学术背景。
这些都是有效的聚类方式,但其含义各不相同。
尽管欧氏距离是大多数聚类软件中最常用的距离度量,但也存在其他度量,如曼哈顿距离、Canberra 距离、皮尔逊或斯皮尔曼相关、闵可夫斯基距离等。
合并前如何度量簇间距离
前文提到的距离是针对项目(样本)之间的。本节将介绍三种在合并簇之前度量最近簇对的常用方法(非穷尽):(1) 最短距离(Single linkage),(2) 最长距离(Complete linkage),(3) 平均距离(Average linkage)。
最短距离(Single linkage)
在两个簇 C1 与 C2 的所有成对项目距离中,最短距离法将簇间距离取为最小的那一个。
Distance (C1, C2) = Min { d(i, j), 其中 i 属于 C1,j 属于 C2 }
在来自两个簇的所有项目对中,绿色高亮的是距离最小的那一对。
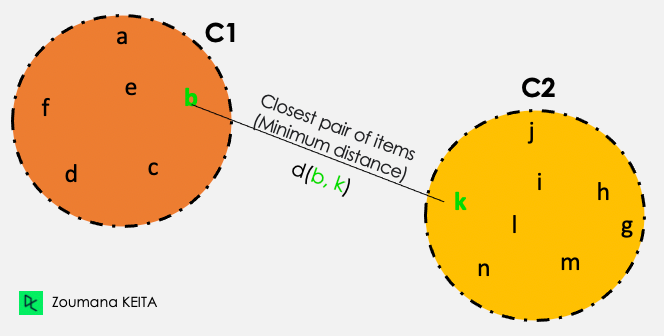
最短距离示意图
最长距离(Complete linkage)
在两个簇 C1 与 C2 的所有成对项目距离中,最长距离法将簇间距离取为最大的那一个。
Distance (C1, C2) = Max { d(i, j), 其中 i 属于 C1,j 属于 C2 }
在来自两个簇的所有项目对中,绿色高亮的是距离最大的那一对。
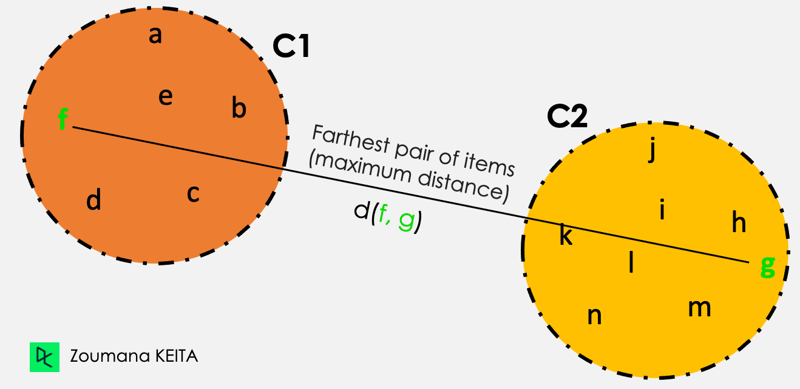
最长距离示意图
平均距离(Average linkage)
在平均距离聚类中,给定两个簇 C1 与 C2 的簇间距离对应为这两个簇中所有项目对距离的平均值。
Distance (C1, C2) = Sum{ d(i, j) } / 距离总数
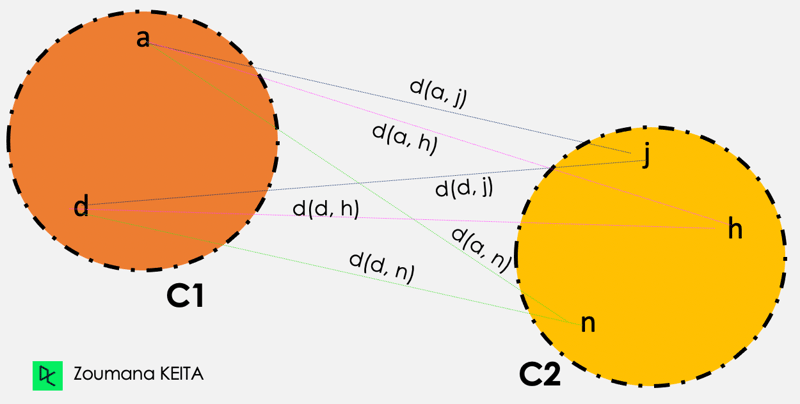
平均距离示意图
随后按如下方式进行平均距离聚类
d(a,j) + d(a,h) + d(a,n) + d(d,j) + d(d,h) + d(d,n)
—-----------------------------------------------------------,其中 距离总数 = 6
距离总数
在 Python 中实现分层聚类
现在您已经了解了分层聚类的工作原理。本节我们将聚焦于使用 Python 的技术实现。
如果您更感兴趣于使用 R 语言实现,请参阅我们的R 分层聚类教程。
环境准备
首先,您需要在计算机上安装Python,并安装以下库:
- Pandas:用于加载数据框。
- Scikit-learn:用于执行数据归一化。
- Seaborn 和 matplotlib:用于可视化。
- Scipy:用于执行聚类。
您可以使用 Python 包管理器 pip 按如下方式安装这些库:
pip install scikit-learn
pip install pandas
pip install matplotlib seaborn
pip install scipy接下来,让我们导入必要的模块并加载数据集。我们将使用 scikit-learn 内置的 iris 数据集,该数据集包含关于不同种类鸢尾花的信息。
为了更好地说明用例,我们将使用 DataLab 上提供的贷款数据(Loan Data)。本教程中的所有代码均可在此 DataLab 工作簿中获取;您可以轻松创建自己的副本,在浏览器中运行代码,而无需在计算机上安装任何软件。
理解数据
该数据集包含 9,500 笔贷款,包含关于贷款结构、借款人以及贷款是否全额偿还的信息。我们将移除目标列 not.fully.paid,以满足无监督的要求。
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()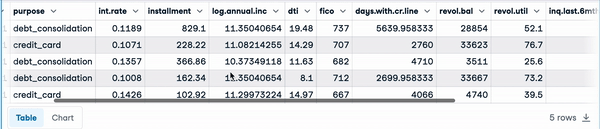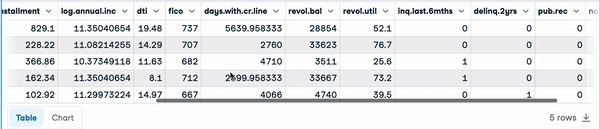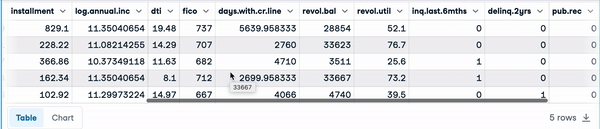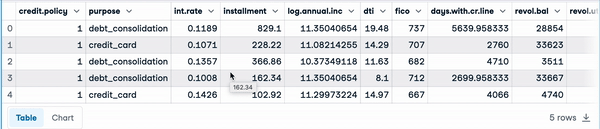 数据前五行
下面的指令显示数据有 9,578 行和 14 列,除 purpose 外均为数值类型;purpose 为对象类型,给出贷款用途的文本描述。
loan_data.info()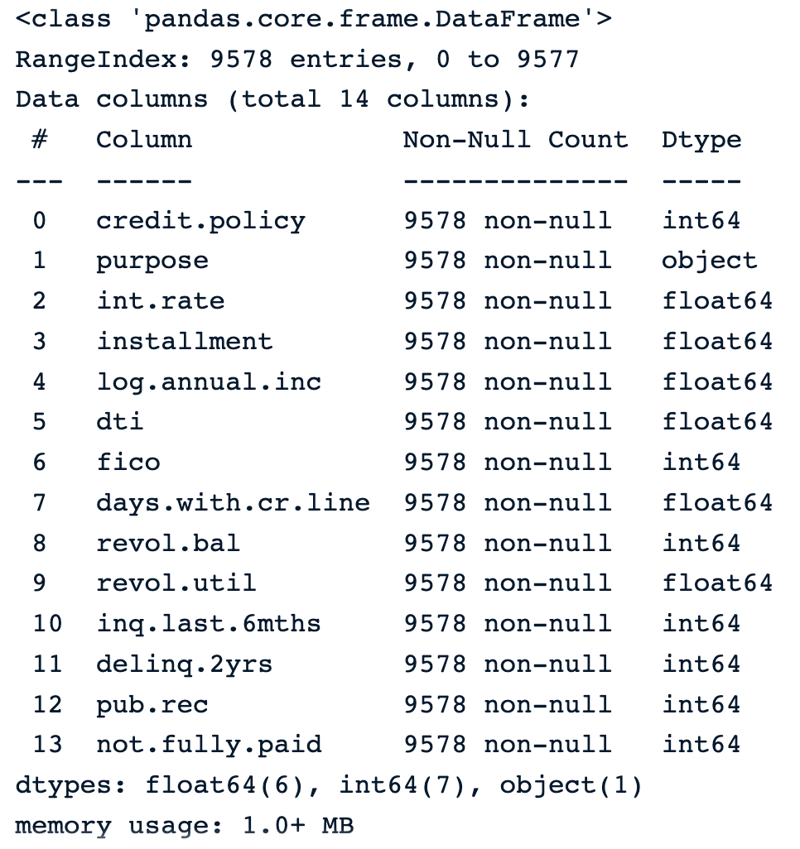 数据概览信息
数据预处理
在应用聚类前,需要对数据进行预处理,以处理缺失信息、标准化列值并删除不相关列。
处理缺失值
从下方输出可见,数据中不存在缺失值。
percent_missing =round(100*(loan_data.isnull().sum())/len(loan_data),2)
percent_missing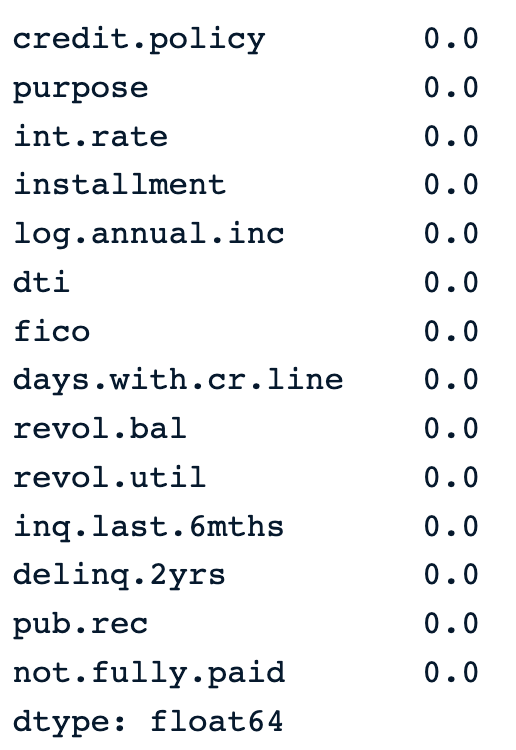 各列缺失值百分比
删除不需要的列
我们将使用除以下列之外的所有列来分析贷款数据:
- purpose
- not.fully.paid(标签,表示借款人是否全额偿还)。
cleaned_data 为删除上述列后的数据。
cleaned_data = loan_data.drop(['purpose', 'not.fully.paid'], axis=1)
cleaned_data.info()下图展示了新数据的信息。
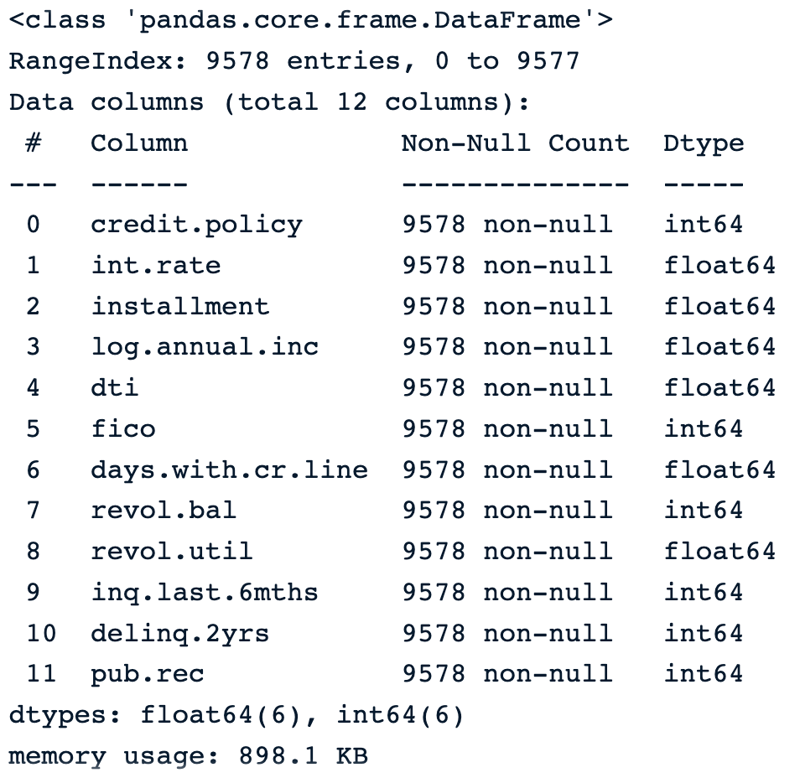
删除不需要列后的新数据
离群值分析
分层聚类的弱点之一是对离群值敏感。各变量的分布可通过箱线图给出。
def show_boxplot(df):
plt.rcParams['figure.figsize'] = [14,6]
sns.boxplot(data = df, orient="v")
plt.title("Outliers Distribution", fontsize = 16)
plt.ylabel("Range", fontweight = 'bold')
plt.xlabel("Attributes", fontweight = 'bold')
show_boxplot(cleaned_data)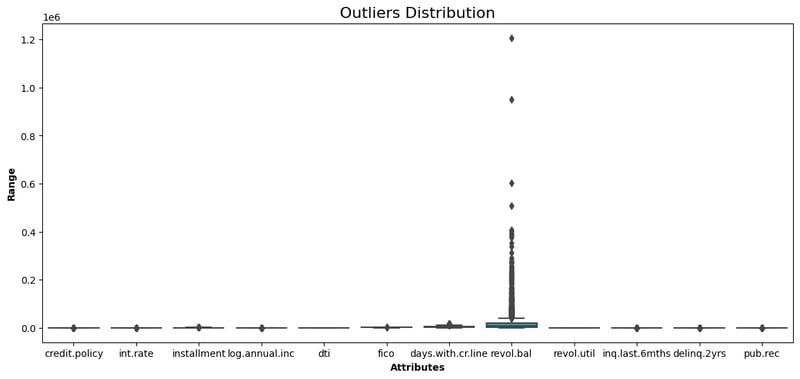
数据中各变量的箱线图
借款人的循环余额(revol_bal)是唯一一个有远离其余数据点的属性。
使用四分位间距(IQR)方法,我们可以移除所有位于四分位数 +/-1.5 × IQR 范围之外的点,其中 IQR 为四分位距。
通过以下辅助函数实现。
def remove_outliers(data):
df = data.copy()
for col in list(df.columns):
Q1 = df[str(col)].quantile(0.05)
Q3 = df[str(col)].quantile(0.95)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5*IQR
upper_bound = Q3 + 1.5*IQR
df = df[(df[str(col)] >= lower_bound) &
(df[str(col)] <= upper_bound)]
return df
然后,我们将该函数应用于数据集。
without_outliers = remove_outliers(cleaned_data)现在我们可以查看新的箱线图,并与移除离群值之前进行比较。
show_boxplot(without_outliers)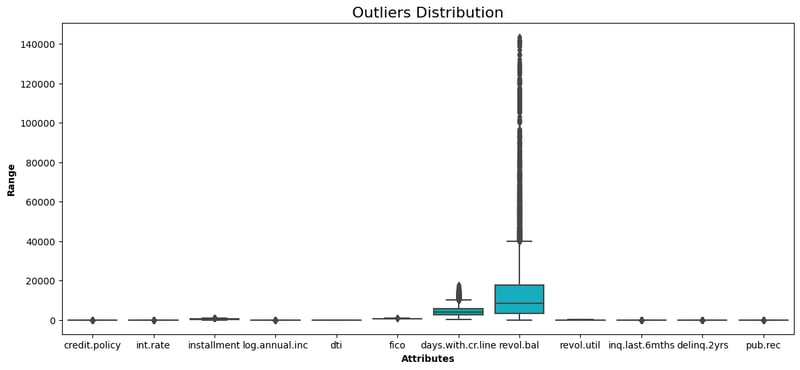
不再有数据点落在四分位距之外。
without_outliers.shape数据的形状现在为 9,319 行、12 列。这意味着共有 259 条观测为离群值,已被删除。
重缩放数据
由于分层聚类使用欧氏距离,而欧氏距离对不同量纲的变量非常敏感,因此在计算距离之前,对所有变量进行重缩放是明智的。
这里使用 sklearn 的 StandardScaler 类来完成。
from sklearn.preprocessing import StandardScaler
data_scaler = StandardScaler()
scaled_data = data_scaler.fit_transform(without_outliers)
scaled_data.shape数据的形状仍为(9,319 行,12 列),因为标准化不会改变数据的形状。
应用分层聚类算法
所需条件已具备,下面深入实现聚类算法。
此时,我们可以在 linkage() 方法的 method 参数中决定采用哪种连接方式进行聚类。本节将使用欧氏距离介绍三种连接方式。
在导入相关库后,使用以下代码实现。
from scipy.cluster.hierarchy import linkage, dendrogram
complete_clustering = linkage(scaled_data, method="complete", metric="euclidean")
average_clustering = linkage(scaled_data, method="average", metric="euclidean")
single_clustering = linkage(scaled_data, method="single", metric="euclidean")计算出三种聚类后,其对应的树状图如下所示,先从最长距离聚类开始:
dendrogram(complete_clustering)
plt.show()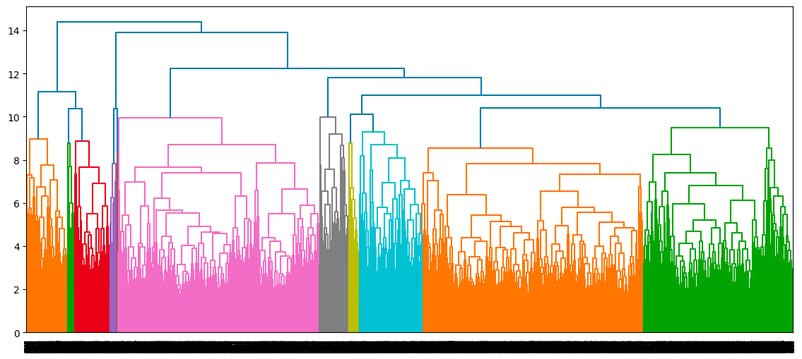
最长距离聚类方法的树状图
dendrogram(average_clustering)
plt.show()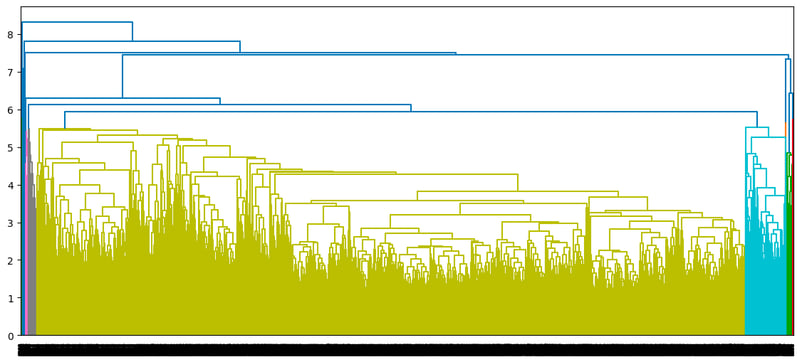
平均距离聚类方法的树状图
dendrogram(single_clustering)
plt.show()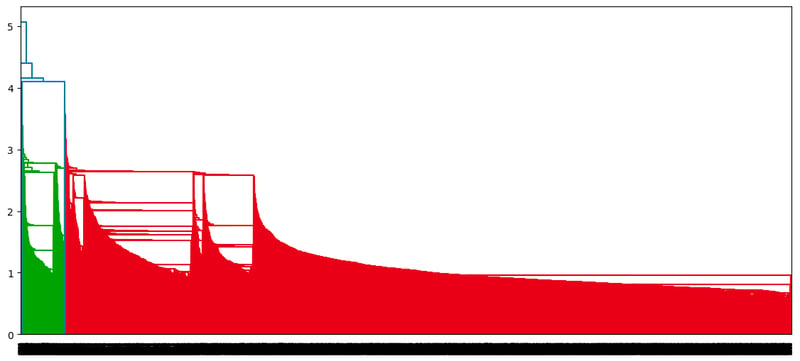
最短距离聚类方法的树状图
结果解读(可视化树状图,确定簇的数量)
对于每种连接方式,树状图的构建展示了每个数据点最终如何归入单一簇。
- 树状图的 x 轴表示数据中的样本。
- y 轴表示这些样本之间的距离。连线越高,样本/簇之间越不相似。
- 通过在最高的垂直线处画一条水平线,交点的数量即为合适的簇的数量。
最佳簇数可通过识别最高的、且不与任何其他簇(水平线)相交的垂直线来获得。如下图所示的红色圆圈与绿色对勾所标示位置。
- 对于最长距离连接,是右侧的蓝色线,得到三个簇。
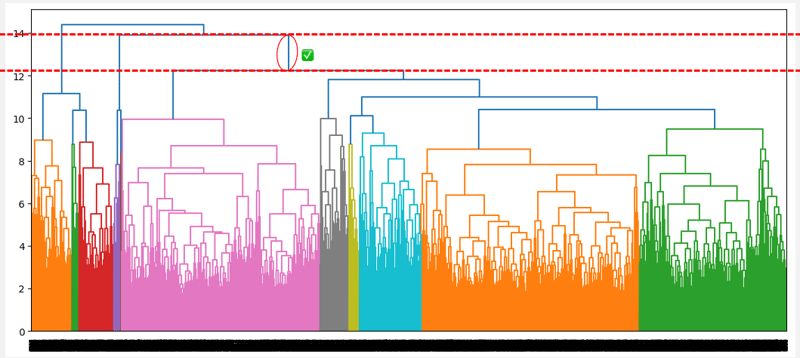
基于最高且无交叉的距离得到的最佳簇数(最长距离)
- 对于平均距离连接,是第一条蓝色垂直线,得到两个簇。
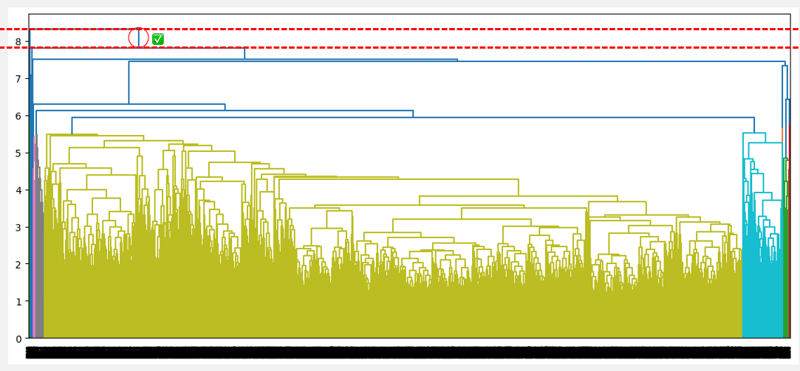
基于最高且无交叉的距离得到的最佳簇数(平均距离)
- 对于最短距离连接,是第一条垂直线,只得到一个簇。
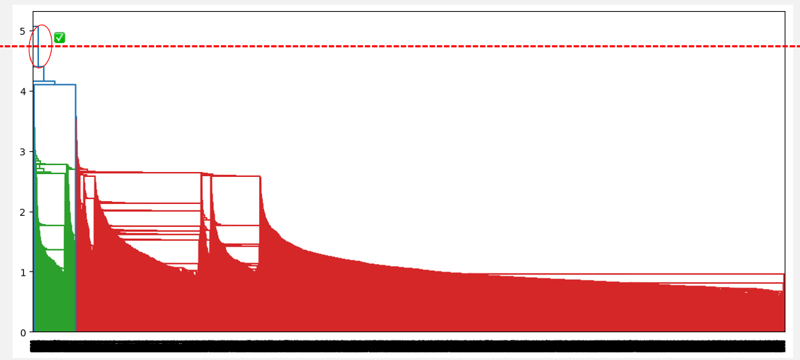
基于最高且无交叉的距离得到的最佳簇数(最短距离)
基于上述观察,平均距离连接似乎提供了最佳聚类;相较之下,最短与最长距离连接分别建议考虑一个簇和三个簇。此外,两个簇的最佳数量也与我们对数据集的先验认识相符,即借款人有两种类型。
现在我们已找到最佳簇数,接下来基于借款人的信用评分来看看这些簇意味着什么。
cluster_labels = cut_tree(average_clustering, n_clusters=2).reshape(-1, )
without_outliers["Cluster"] = cluster_labels
sns.boxplot(x='Cluster', y='fico', data=without_outliers)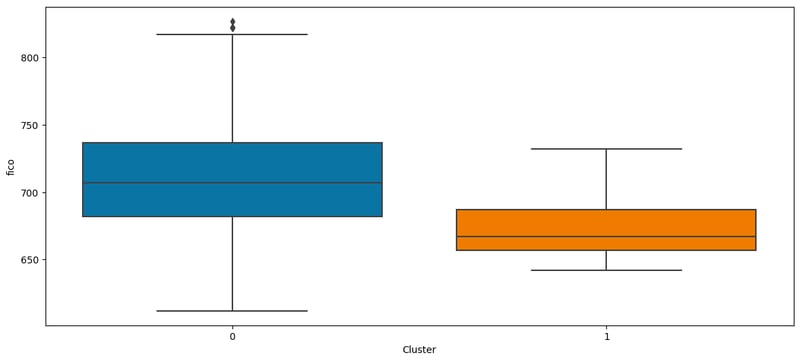
从上方箱线图可观察到:
- 簇 0 中的借款人拥有更高的信用评分。
- 而簇 1 中的借款人信用评分较低。
Python 聚类分析课程可以作为下一步,借助 Scipy 库深入学习 K-means 与分层聚类。
结语
本文介绍了什么是分层聚类、其优缺点,以及它与 K-means 和基于模型的聚类的比较。
我们希望本文能为您提供相关技能,高效地对无标签数据进行聚类,从而支持可执行的决策制定。
分层聚类常见问答
如何选择合适的簇数?
在分层聚类中,可通过树状图确定合适的簇数:识别最高的、且不与其他簇相交的垂直线。
在分层聚类中如何处理分类数据?
分层聚类默认不支持分类数据。应对方法之一是在应用算法前,将其转换为合适的数值格式,例如独热编码和序数编码。
如何处理大型数据集?
数据越大,聚类时间越长。使用凝聚式方法通常比分裂式更快。
什么是凝聚式信息瓶颈(AIB)?
这是一种聚类算法,旨在最大化每个簇中数据与给定类别集合之间的互信息。
什么是加权分层聚类?
这是一种分层聚类的变体,为每个数据点分配权重,以反映其在聚类过程中的重要性或相关性。