

Động lực
Hãy tưởng tượng bạn là một Nhà khoa học Dữ liệu làm việc cho một công ty bán lẻ. Sếp của bạn yêu cầu bạn phân khúc khách hàng thành các nhóm sau: khách hàng thấp, trung bình, khá, hoặc bạch kim dựa trên hành vi chi tiêu để phục vụ mục tiêu tiếp thị và gợi ý sản phẩm.
Biết rằng không có nhãn lịch sử nào gắn với những khách hàng đó, làm sao có thể phân loại họ?
Đây là lúc phân cụm phát huy tác dụng. Đây là một kỹ thuật học máy không giám sát được sử dụng để nhóm dữ liệu không có nhãn vào các hạng mục tương đồng.
Hướng dẫn này sẽ tập trung nhiều hơn vào phương pháp phân cụm phân cấp, một trong nhiều kỹ thuật trong học máy không giám sát. Trước hết sẽ cung cấp tổng quan về phân cụm phân cấp là gì, sau đó so sánh với một số kỹ thuật hiện có.
Tiếp theo, hướng dẫn sẽ đưa bạn qua phần triển khai từng bước trong Python sử dụng thư viện Scipy phổ biến.
Định nghĩa Phân cụm Phân cấp
Cách tiếp cận phân cụm phân cấp dựa trên việc xác định các cụm kế tiếp dựa trên các cụm đã được xác định trước đó. Đây là một kỹ thuật hướng tới việc nhóm dữ liệu thành một cây các cụm gọi là dendrogram, biểu diễn đồ họa mối quan hệ phân cấp giữa các cụm nền tảng.
So sánh Phân cụm Phân cấp với các Kỹ thuật Phân cụm Khác
Phân cụm phân cấp là một thuật toán mạnh mẽ, nhưng không phải là duy nhất, và mỗi loại phân cụm đều có ưu điểm và hạn chế riêng.
Hãy tìm hiểu cách nó so với các loại phân cụm khác như K-means và phân cụm dựa trên mô hình. Còn nhiều kỹ thuật khác nữa, nhưng hai kỹ thuật này, cùng với phân cụm phân cấp, được sử dụng rộng rãi và cung cấp khuôn khổ giúp hiểu rõ hơn các kỹ thuật còn lại.
Bạn có thể tìm hiểu thêm về phân cụm trong học máy trong bài viết riêng của chúng tôi, đề cập đến năm thuật toán phân cụm thiết yếu.
Phân cụm phân cấp so với phân cụm K-means
Không giống phân cụm phân cấp, phân cụm K-means tìm cách phân hoạch các điểm dữ liệu gốc thành “K” nhóm hay cụm, trong đó người dùng chỉ định trước “K”.
Ý tưởng chung là tìm các cụm sao cho tối thiểu hóa tổng bình phương khoảng cách Euclid của tất cả các điểm đến các tâm trên tất cả thuộc tính (biến hay đặc trưng) và gộp những đối tượng đó một cách lặp.
Hướng dẫn K-means Clustering in Python with Scikit-learn của chúng tôi sẽ giúp bạn hiểu cơ chế bên trong của K-means qua một nghiên cứu tình huống thú vị.
Lợi ích
- Hiệu quả tính toán hơn so với phân cụm phân cấp và có thể dùng để phân tích các bộ dữ liệu lớn.
- K-means dễ hiểu và dễ triển khai.
Hạn chế
- Kém linh hoạt hơn phân cụm phân cấp vì buộc người dùng phải chỉ định trước số cụm, điều này có thể không rõ ràng trong một số tình huống.
- Kết quả không ổn định và thay đổi qua mỗi lần lặp trên cùng một bộ dữ liệu.
- Nhạy cảm hơn với ngoại lệ vì sự hiện diện của ngoại lệ ảnh hưởng đến giá trị trung bình của cụm.
- Cả k-means và phân cụm phân cấp đều không thể xử lý trực tiếp dữ liệu phân loại và có thể không hoạt động tốt với dữ liệu không liên tục hoặc có phương sai rất lớn.
Bất chấp các hạn chế, K-means vẫn là phương pháp phổ biến nhờ dễ sử dụng và hiệu quả tính toán. Nó thường được dùng làm mốc tham chiếu để so sánh hiệu năng của các kỹ thuật phân cụm khác.
Phân cụm dựa trên mô hình
Cả K-means và phân cụm phân cấp đều sử dụng ma trận khoảng cách để biểu diễn khoảng cách giữa mọi điểm trong tập dữ liệu. Ngược lại, phân cụm dựa trên mô hình áp dụng các kỹ thuật thống kê để xác định cụm trong dữ liệu. Quy trình chung như sau:
- Quyết định mô hình thống kê sẽ dùng và chọn số lượng cụm.
- Khớp mô hình với dữ liệu.
- Xác định các cụm dựa trên các tham số của mô hình.
Lợi ích
- Linh hoạt hơn phân cụm phân cấp vì cho phép sử dụng các mô hình khác nhau để nhận diện các loại cụm khác nhau.
- Hoạt động tốt hơn với dữ liệu có hình dạng hoặc cấu trúc phức tạp.
Hạn chế
- Tốn kém tính toán hơn phân cụm phân cấp, đặc biệt với dữ liệu lớn.
- Đòi hỏi hiểu biết tốt hơn về kỹ thuật mô hình hóa thống kê vì lựa chọn mô hình có thể ảnh hưởng đến kết quả cuối.
- Tương tự K-means, yêu cầu chỉ định trước số cụm.
Ứng dụng của Phân cụm Phân cấp
Phân cụm phân cấp có nhiều ứng dụng trong đời sống hàng ngày, bao gồm (nhưng không giới hạn ở) sinh học, xử lý ảnh, tiếp thị, kinh tế học và phân tích mạng xã hội.
Sinh học
Phân cụm các chuỗi DNA là một trong những thách thức lớn nhất trong tin sinh học.
Các nhà sinh học có thể tận dụng phân cụm phân cấp để nghiên cứu mối quan hệ di truyền giữa các sinh vật nhằm phân loại chúng vào các nhóm phân loại. Điều này hữu ích cho việc phân tích nhanh và trực quan hóa các mối quan hệ nền tảng.
Xử lý ảnh
Có thể thực hiện phân cụm phân cấp trong xử lý ảnh để nhóm các vùng hoặc điểm ảnh tương tự nhau về màu sắc, cường độ hoặc các đặc trưng khác. Điều này hữu ích cho các tác vụ tiếp theo như phân đoạn ảnh, phân loại ảnh và nhận dạng đối tượng.
Tiếp thị
Các chuyên gia tiếp thị có thể dùng phân cụm phân cấp để thiết lập thứ bậc giữa các kiểu khách hàng khác nhau dựa trên thói quen mua sắm nhằm xây dựng chiến lược tiếp thị và gợi ý sản phẩm tốt hơn. Ví dụ, các sản phẩm khác nhau trong bán lẻ có thể được gợi ý cho khách hàng tùy theo họ chi tiêu thấp, trung bình hay cao.
Phân tích mạng xã hội
Các mạng xã hội là nguồn thông tin giá trị khi được khai thác hiệu quả. Phân cụm phân cấp có thể được dùng để xác định các nhóm hay cộng đồng và hiểu mối quan hệ của họ với nhau cũng như cấu trúc của toàn bộ mạng.
Thuật toán Phân cụm Phân cấp
Trong phần này, chúng ta sẽ xem xét ba khái niệm chính: các bước của thuật toán phân cấp, điểm qua hai loại phân cụm phân cấp (kết tụ và phân chia), và cuối cùng là một số kỹ thuật để chọn thước đo khoảng cách phù hợp.
Các bước trong thuật toán phân cụm phân cấp
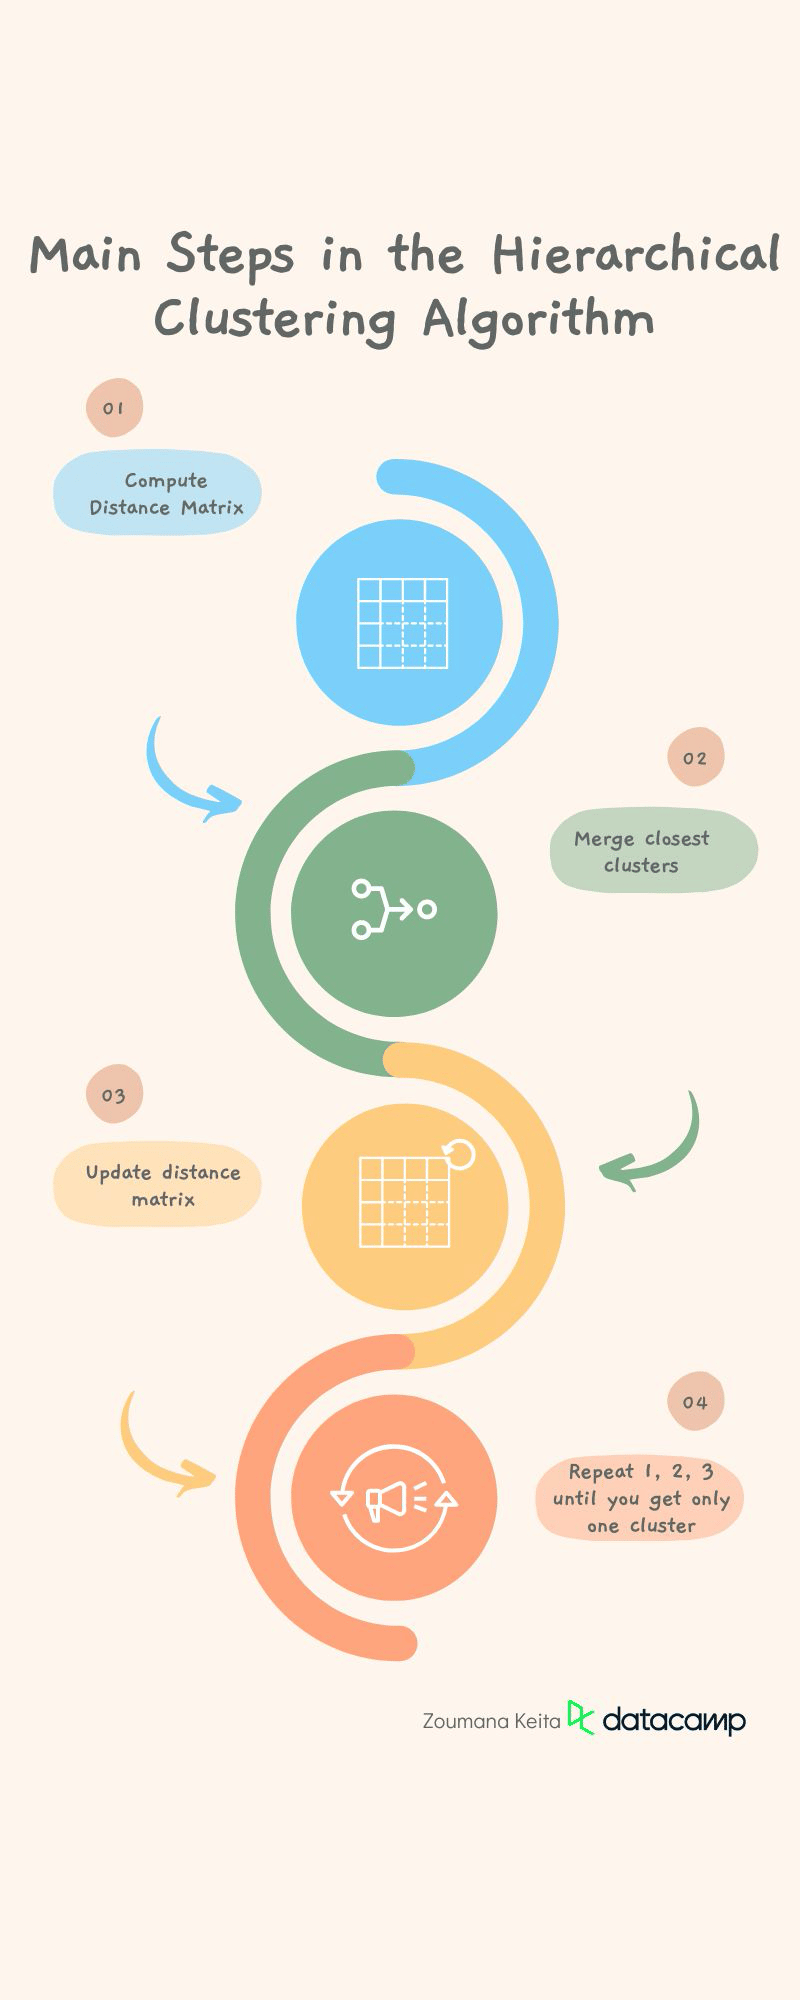
Thuật toán phân cụm phân cấp sử dụng các thước đo khoảng cách để tạo cụm. Quá trình này gồm các bước chính sau:
Tiền xử lý dữ liệu bằng cách loại bỏ dữ liệu thiếu và áp dụng các tác vụ bổ sung để dữ liệu sạch nhất có thể. Bước này mang tính tổng quát cho hầu hết tác vụ học máy.
1. Tính ma trận khoảng cách chứa khoảng cách giữa từng cặp điểm dữ liệu bằng một thước đo cụ thể như khoảng cách Euclid, khoảng cách Manhattan hoặc độ tương tự cosine. Mặc định là khoảng cách Euclid.
2. Gộp hai cụm có khoảng cách gần nhau nhất.
3. Cập nhật ma trận khoảng cách theo các cụm mới.
4. Lặp lại các bước 1, 2 và 3 cho đến khi tất cả các cụm được gộp lại thành một cụm duy nhất.
Ví dụ về phân cụm phân cấp
Chúng ta có thể coi phân cụm kết tụ và phân cụm phân chia như hai ảnh phản chiếu của nhau. Hãy xem kỹ cách mỗi phương pháp hoạt động, cùng ví dụ và minh họa đồ họa.
Phân cụm phân cấp kiểu kết tụ
Kịch bản đầu tiên này tương ứng với cách tiếp cận đã nêu ở trên. Bắt đầu bằng cách coi mỗi quan sát là một cụm đơn (cụm chỉ có một điểm dữ liệu). Sau đó lần lượt gộp cụm cho đến khi chỉ còn một cụm. Quá trình này còn gọi là cách tiếp cận từ dưới lên.
Như minh họa dưới đây:
- Chúng ta bắt đầu bằng cách coi mỗi loài động vật là một cụm riêng.
- Sau đó tạo ba cụm khác nhau từ những động vật riêng lẻ đó dựa trên sự tương đồng:
- Chim: Đại bàng và Công
- Thú: Sư tử và Gấu
- Động vật có hơn ba chân: Nhện và Bọ cạp.
- Chúng ta lặp lại quá trình gộp để tạo cụm Động vật có xương sống bằng cách kết hợp hai cụm giống nhau nhất: Chim và Thú.
- Sau bước này, hai cụm còn lại, Động vật có xương sống và Hơn ba chân, được gộp lại để tạo một cụm Động vật duy nhất.
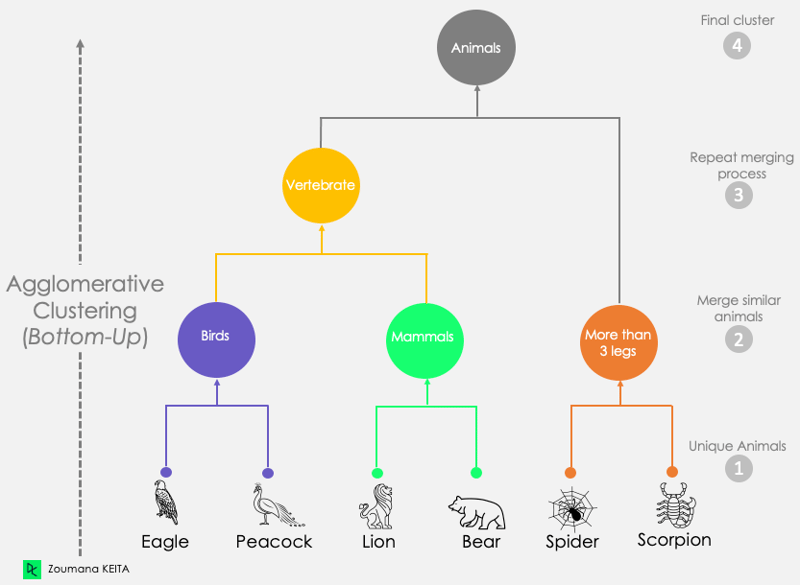
Dendrogram của cách tiếp cận phân cụm kết tụ
Phân cụm phân chia
Ngược lại, phân cụm phân chia là từ trên xuống vì nó bắt đầu bằng cách coi tất cả điểm dữ liệu là một cụm duy nhất. Sau đó tách dần cho đến khi tất cả điểm dữ liệu trở nên đơn lẻ.
Từ đồ họa của cách tiếp cận phân chia:
- Ta thấy toàn bộ tập dữ liệu động vật được coi là một khối duy nhất.
- Sau đó, ta chia khối đó thành hai cụm: Động vật có xương sống và Hơn 3 chân.
- Quá trình chia được áp dụng lặp lại lên các cụm đã tạo cho đến khi ta có các động vật đơn lẻ.
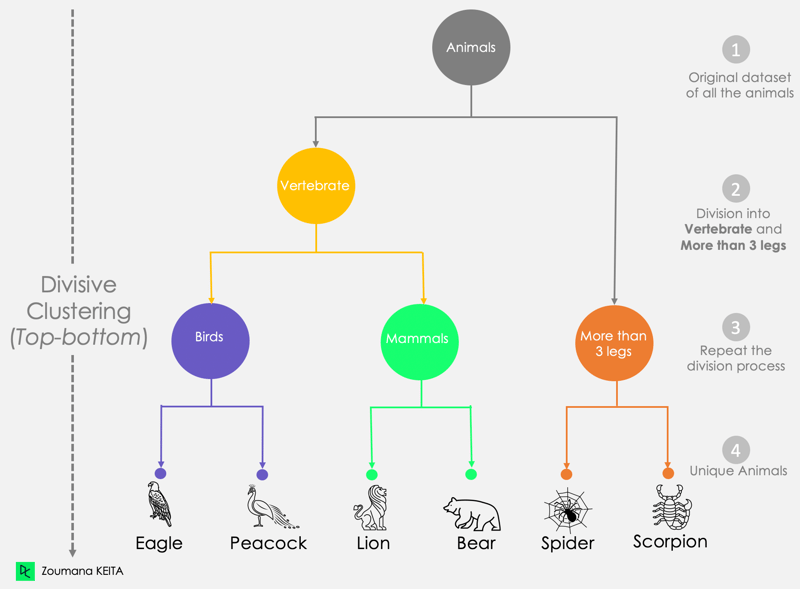
Dendrogram của cách tiếp cận phân cụm phân chia
Chọn thước đo khoảng cách phù hợp
Lựa chọn thước đo khoảng cách là bước then chốt trong phân cụm và phụ thuộc vào bài toán bạn muốn giải. Xét kịch bản sau, chúng ta có thể phân cụm sinh viên dựa trên một số cách tiếp cận như:
- Quốc gia xuất xứ
- Giới tính, nam hoặc nữ
- Nền tảng học thuật trước đó.
Đây đều là các cụm hợp lệ nhưng khác nhau về ý nghĩa.
Dù khoảng cách Euclid là thước đo phổ biến nhất được dùng trong hầu hết phần mềm phân cụm, vẫn có các thước đo khác như khoảng cách Manhattan, khoảng cách Canberra, tương quan Pearson hoặc Spearman, và khoảng cách Minkowski.
Cách đo cụm trước khi gộp
Các khoảng cách đã nêu liên quan đến từng mục. Trong phần này, chúng ta sẽ đề cập ba cách tiêu chuẩn (không đầy đủ) để đo cặp cụm gần nhất trước khi gộp: (1) Liên kết đơn, (2) Liên kết đầy đủ, và (3) Liên kết trung bình.
Liên kết đơn
Từ tất cả khoảng cách cặp giữa các mục trong hai cụm C1 và C2, liên kết đơn lấy khoảng cách giữa các cụm là khoảng cách nhỏ nhất.
Khoảng cách (C1, C2) = Min { d(i, j), với i thuộc C1 và j thuộc C2}
Trong tất cả các cặp mục từ hai cụm, các cặp được tô xanh lá có khoảng cách nhỏ nhất.
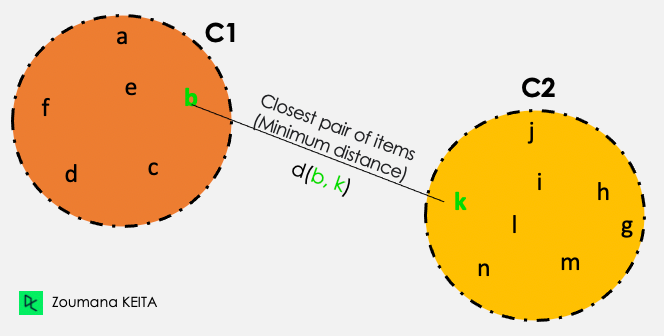
Minh họa liên kết đơn
Liên kết đầy đủ
Từ tất cả khoảng cách cặp giữa các mục trong hai cụm C1 và C2, liên kết đầy đủ lấy khoảng cách giữa các cụm là khoảng cách lớn nhất.
Khoảng cách (C1, C2) = Max { d(i, j), với i thuộc C1 và j thuộc C2}
Trong tất cả các cặp mục từ hai cụm, các cặp được tô xanh lá có khoảng cách lớn nhất.
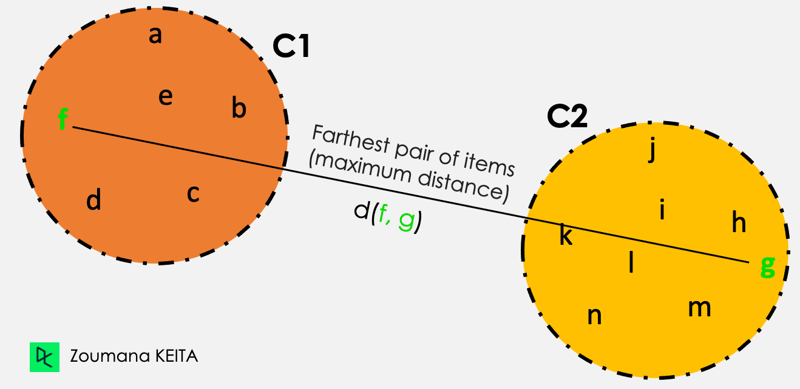
Minh họa liên kết đầy đủ
Liên kết trung bình
Trong phân cụm liên kết trung bình, khoảng cách giữa hai cụm C1 và C2 tương ứng với trung bình các khoảng cách giữa mọi cặp mục thuộc hai cụm.
Khoảng cách (C1, C2) = Tổng{ d(i, j) } / Tổng số khoảng cách
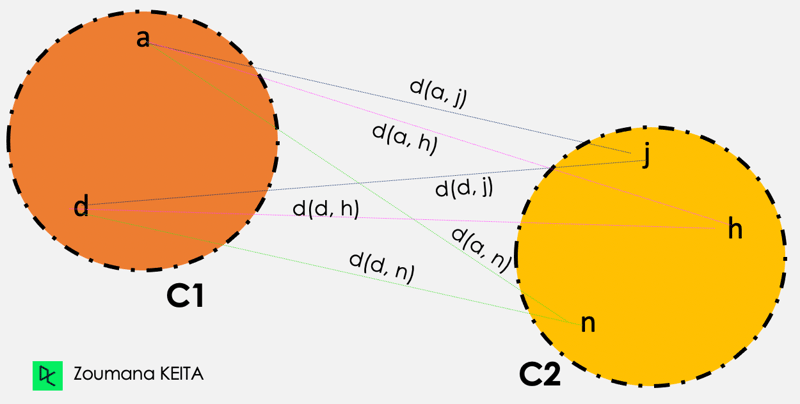
Minh họa liên kết trung bình
Sau đó phân cụm liên kết trung bình được thực hiện như sau
d(a,j) + d(a,h) + d(a,n) + d(d,j) + d(d,h) + d(d,n)
—-----------------------------------------------------------, trong đó Tổng số khoảng cách = 6
Tổng số khoảng cách
Triển khai Phân cụm Phân cấp trong Python
Bây giờ bạn đã hiểu cách phân cụm phân cấp hoạt động. Trong phần này, chúng ta sẽ tập trung vào triển khai kỹ thuật bằng Python.
Nếu bạn quan tâm hơn đến việc triển khai bằng ngôn ngữ R, hãy bắt đầu với hướng dẫn phân cụm phân cấp trong R của chúng tôi.
Thiết lập môi trường
Để bắt đầu, bạn cần cài đặt Python trên máy tính, cùng các thư viện sau:
- Pandas để tải dữ liệu khung dữ liệu.
- Scikit-learn để chuẩn hóa dữ liệu.
- Seaborn và matplotlib cho mục đích trực quan hóa.
- Scipy để áp dụng phân cụm.
Bạn có thể cài đặt các thư viện này bằng pip, trình quản lý gói của Python như sau:
pip install scikit-learn
pip install pandas
pip install matplotlib seaborn
pip install scipyTiếp theo, hãy nhập các mô-đun cần thiết và tải bộ dữ liệu. Chúng ta sẽ dùng bộ dữ liệu iris tích hợp sẵn từ scikit-learn, chứa thông tin về các loài hoa iris khác nhau.
Để minh họa rõ hơn tình huống sử dụng, chúng ta sẽ dùng Loan Data có sẵn trên DataLab. Toàn bộ mã trong hướng dẫn này có trong sổ tay DataLab này; bạn có thể dễ dàng tạo một bản sao của riêng mình để chạy mã trên trình duyệt mà không cần cài phần mềm trên máy.
Hiểu dữ liệu
Tập dữ liệu có 9.500 khoản vay với thông tin về cấu trúc khoản vay, người vay và liệu khoản vay có được trả đủ hay không. Chúng ta sẽ bỏ cột mục tiêu not.fully.paid để đáp ứng tính không giám sát.
import pandas as pd
loan_data = pd.read_csv("loan_data.csv")
loan_data.head()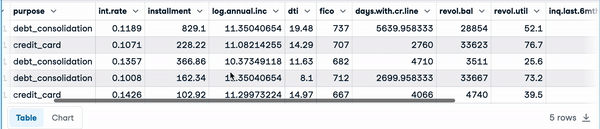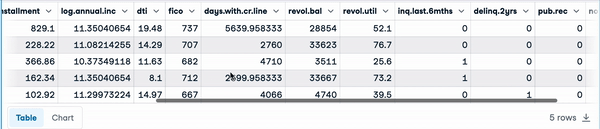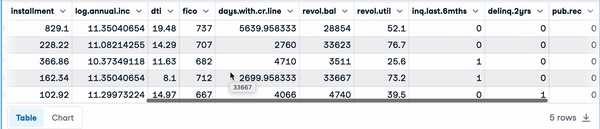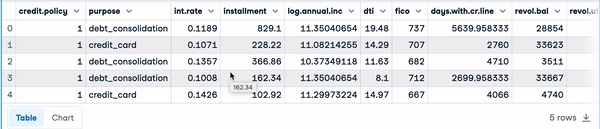 Năm hàng đầu tiên của dữ liệu khoản vay
Câu lệnh sau cho thấy dữ liệu có 9.578 hàng và 14 cột kiểu số ngoại trừ purpose, là kiểu object và cung cấp mô tả văn bản về mục đích khoản vay.
loan_data.info()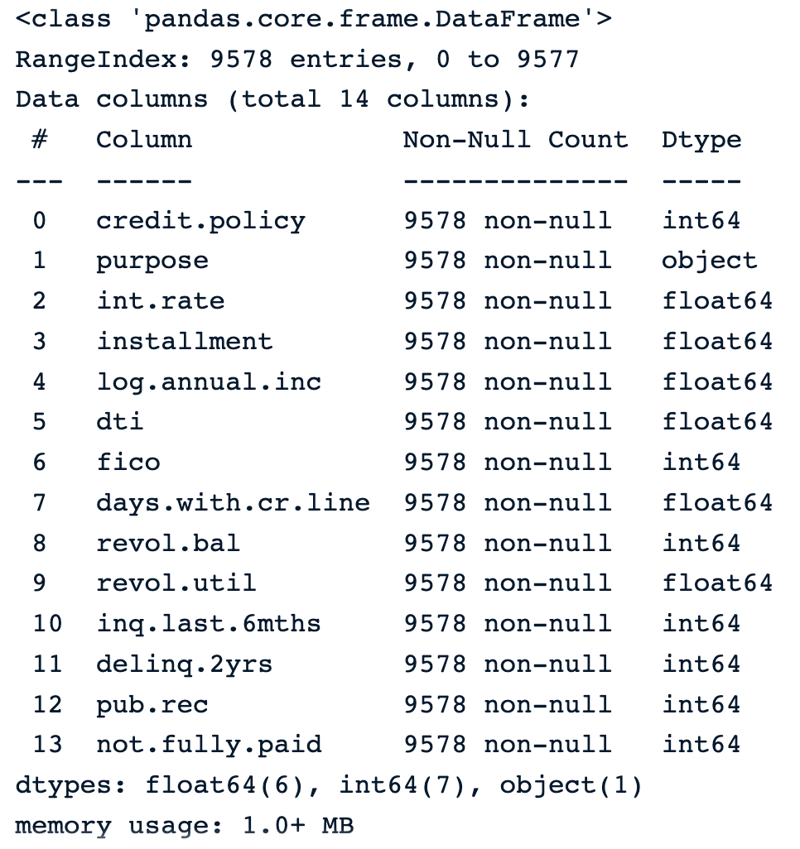 Thông tin về dữ liệu
Tiền xử lý dữ liệu
Trước khi áp dụng phân cụm, dữ liệu cần được tiền xử lý để xử lý thông tin thiếu, chuẩn hóa giá trị cột và loại bỏ các cột không liên quan.
Xử lý giá trị thiếu
Từ kết quả dưới đây, ta thấy không có giá trị thiếu trong dữ liệu.
percent_missing =round(100*(loan_data.isnull().sum())/len(loan_data),2)
percent_missing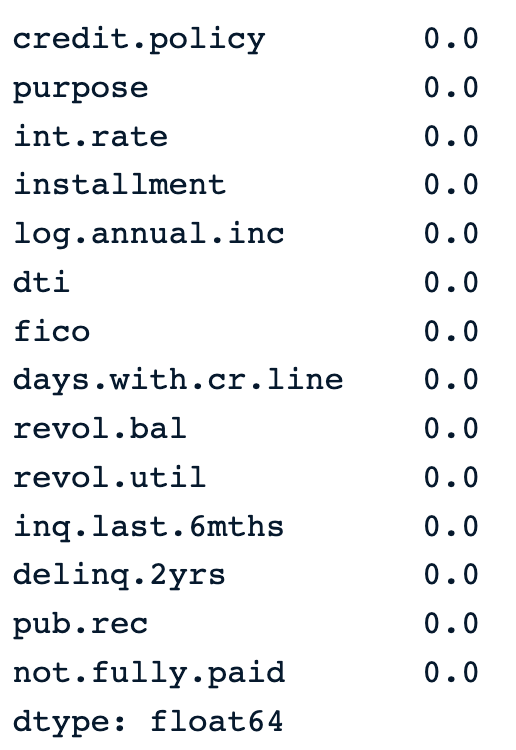 Tỷ lệ giá trị thiếu trong dữ liệu
Loại bỏ các cột không mong muốn
Chúng ta sẽ phân tích dữ liệu khoản vay bằng tất cả các cột ngoại trừ:
- Purpose
- Not.fully.paid, vì đây là nhãn cho biết người vay có trả đủ hay không.
cleaned_data là dữ liệu đã loại bỏ các cột trên.
cleaned_data = loan_data.drop(['purpose', 'not.fully.paid'], axis=1)
cleaned_data.info()Hình dưới cho thấy thông tin của dữ liệu mới.
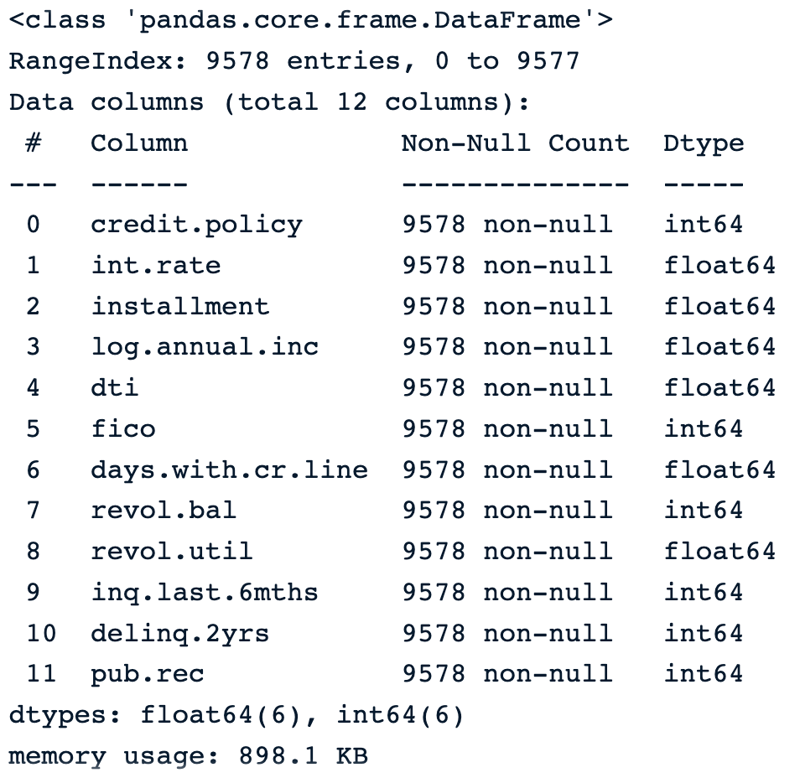
Dữ liệu mới không có các cột không mong muốn
Phân tích ngoại lệ
Một trong những điểm yếu của phân cụm phân cấp là nhạy cảm với ngoại lệ. Phân phối của mỗi biến được thể hiện bằng boxplot.
def show_boxplot(df):
plt.rcParams['figure.figsize'] = [14,6]
sns.boxplot(data = df, orient="v")
plt.title("Outliers Distribution", fontsize = 16)
plt.ylabel("Range", fontweight = 'bold')
plt.xlabel("Attributes", fontweight = 'bold')
show_boxplot(cleaned_data)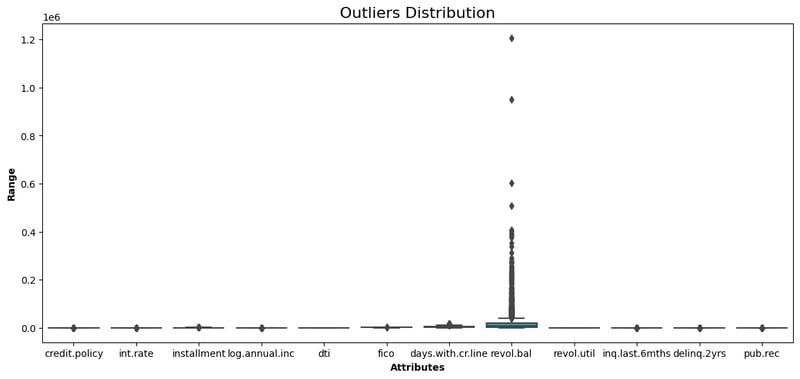
Boxplot của tất cả biến trong dữ liệu
Số dư quay vòng của người vay (revol_bal) là thuộc tính duy nhất có các điểm dữ liệu xa khỏi phần còn lại.
Bằng cách dùng phương pháp khoảng tứ phân vị, chúng ta có thể loại bỏ tất cả các điểm nằm ngoài phạm vi được xác định bởi tứ phân vị +/-1.5 * IQR, trong đó IQR là khoảng tứ phân vị.
Điều này được thực hiện bằng hàm trợ giúp sau.
def remove_outliers(data):
df = data.copy()
for col in list(df.columns):
Q1 = df[str(col)].quantile(0.05)
Q3 = df[str(col)].quantile(0.95)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5*IQR
upper_bound = Q3 + 1.5*IQR
df = df[(df[str(col)] >= lower_bound) &
(df[str(col)] <= upper_bound)]
return df
Sau đó, chúng ta có thể áp dụng hàm cho tập dữ liệu.
without_outliers = remove_outliers(cleaned_data)Bây giờ ta có thể kiểm tra boxplot mới và so sánh với boxplot trước khi loại ngoại lệ.
show_boxplot(without_outliers)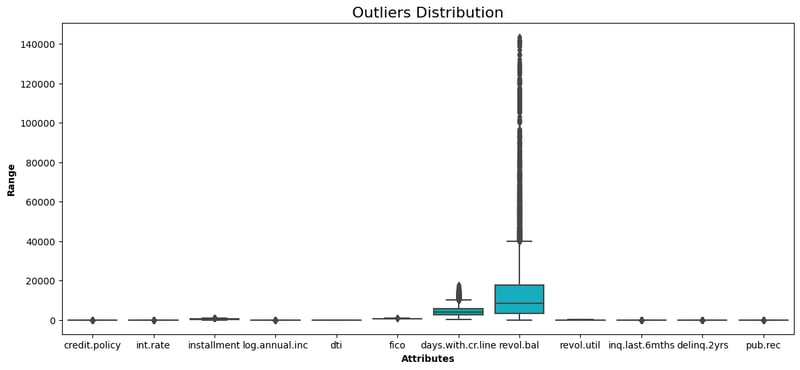
Không còn điểm dữ liệu nào nằm ngoài khoảng tứ phân vị.
without_outliers.shapeHình dạng dữ liệu hiện là 9.319 hàng và 12 cột. Điều này có nghĩa 259 quan sát là ngoại lệ đã bị loại bỏ.
Chuẩn hóa thang đo dữ liệu
Vì phân cụm phân cấp dùng khoảng cách Euclid, rất nhạy khi xử lý các biến có thang đo khác nhau, nên tốt nhất là chuẩn hóa tất cả biến trước khi tính khoảng cách.
Việc này được thực hiện bằng lớp StandardScaler từ sklearn.
from sklearn.preprocessing import StandardScaler
data_scaler = StandardScaler()
scaled_data = data_scaler.fit_transform(without_outliers)
scaled_data.shapeHình dạng dữ liệu vẫn như cũ (9.319 hàng, 12 cột) vì chuẩn hóa không ảnh hưởng đến kích thước dữ liệu.
Áp dụng thuật toán phân cụm phân cấp
Tất cả yêu cầu đã được đáp ứng để đi sâu vào triển khai thuật toán phân cụm.
Lúc này, chúng ta có thể quyết định cách liên kết nào sẽ áp dụng cho phân cụm trong thuộc tính method của phương thức linkage(). Trong phần này, chúng ta sẽ đề cập cả ba kỹ thuật liên kết sử dụng khoảng cách Euclid.
Điều này được thực hiện bằng các đoạn mã dưới đây sau khi nhập các thư viện liên quan.
from scipy.cluster.hierarchy import linkage, dendrogram
complete_clustering = linkage(scaled_data, method="complete", metric="euclidean")
average_clustering = linkage(scaled_data, method="average", metric="euclidean")
single_clustering = linkage(scaled_data, method="single", metric="euclidean")Sau khi đã tính cả ba phân cụm, dendrogram tương ứng được hiển thị như sau, bắt đầu với liên kết đầy đủ
dendrogram(complete_clustering)
plt.show()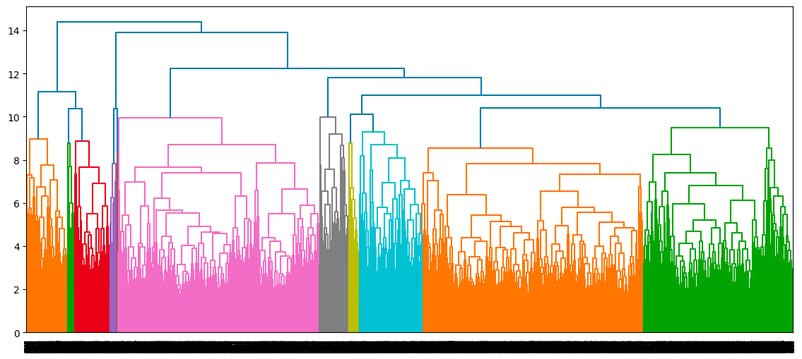
Dendrogram của cách tiếp cận liên kết đầy đủ
dendrogram(average_clustering)
plt.show()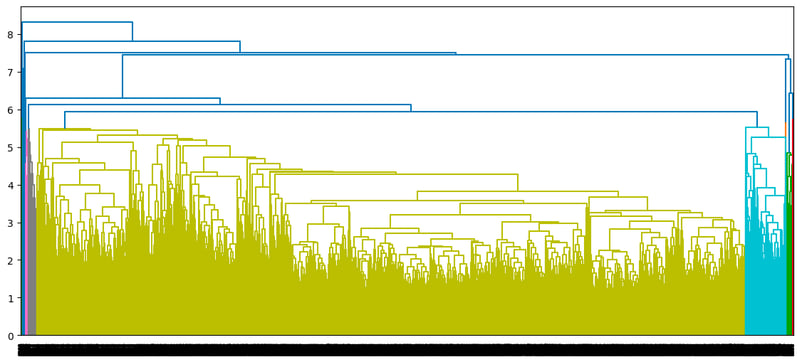
Dendrogram của cách tiếp cận liên kết trung bình
dendrogram(single_clustering)
plt.show()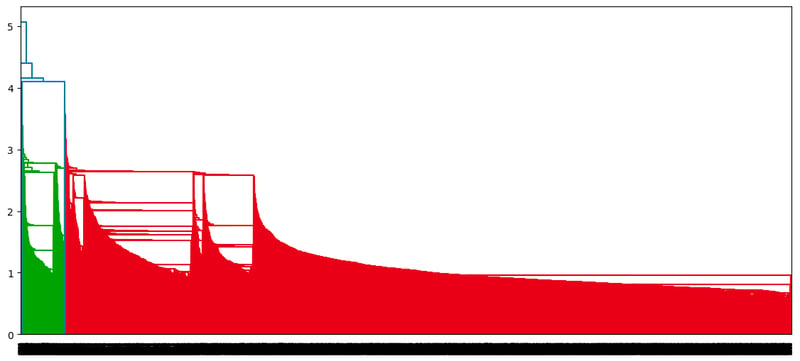
Dendrogram của cách tiếp cận liên kết đơn
Diễn giải kết quả (trực quan hóa dendrogram, xác định số cụm)
Với mỗi cách liên kết, dendrogram được xây dựng như thế nào và mọi điểm dữ liệu cuối cùng nhập vào một cụm duy nhất.
- Trục x của dendrogram biểu diễn các mẫu trong dữ liệu.
- Trục y biểu diễn khoảng cách giữa các mẫu. Đường càng cao, các mẫu/cụm càng khác biệt.
- Ta lấy số cụm phù hợp bằng cách vẽ một đường ngang cắt qua đường thẳng đứng cao nhất, và số giao điểm tương ứng với số cụm.
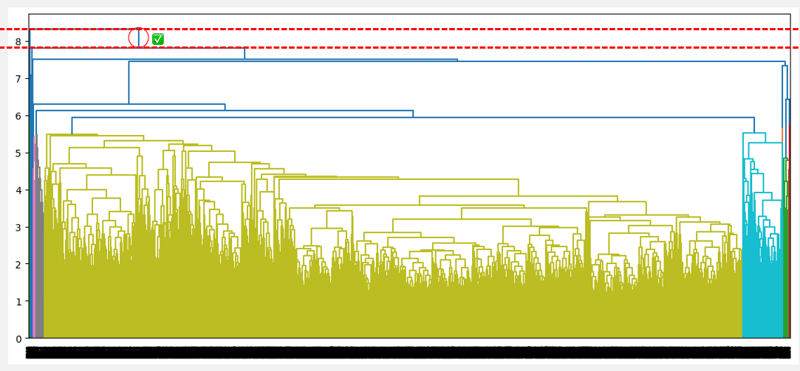
Số cụm tối ưu có thể được xác định bằng cách tìm đường thẳng đứng cao nhất không giao cắt với bất kỳ cụm nào khác (đường ngang). Đường như vậy được khoanh tròn đỏ và đánh dấu xanh lá bên dưới.
- Với liên kết đầy đủ, đó là đường màu xanh bên phải và tạo ra ba cụm.
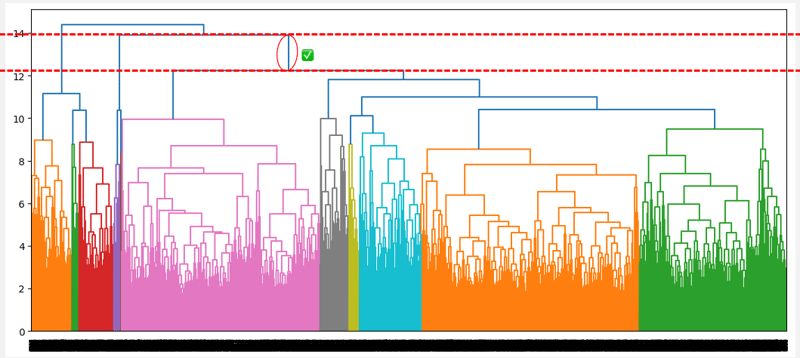
Số cụm tối ưu từ khoảng cách lớn nhất không giao cắt (liên kết đầy đủ)
- Với liên kết trung bình, đó là đường thẳng đứng màu xanh đầu tiên và tạo ra hai cụm.
Số cụm tối ưu từ khoảng cách lớn nhất không giao cắt (liên kết trung bình)
- Với liên kết đơn, đó là đường thẳng đứng đầu tiên và chỉ tạo ra một cụm.
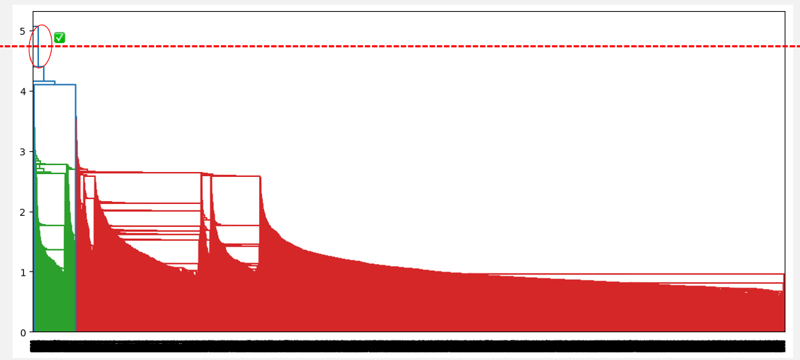
Số cụm tối ưu từ khoảng cách lớn nhất không giao cắt (liên kết đơn)
Từ các quan sát trên, liên kết trung bình có vẻ là phương án cho phân cụm tốt nhất, trái ngược với liên kết đơn và đầy đủ, vốn lần lượt gợi ý xem xét một cụm và ba cụm. Ngoài ra, số cụm tối ưu là hai phù hợp với hiểu biết trước của chúng ta về tập dữ liệu, đó là hai loại người vay.
Bây giờ khi đã tìm được số cụm tối ưu, hãy xem các cụm đó có ý nghĩa gì dựa trên điểm tín dụng của người vay.
cluster_labels = cut_tree(average_clustering, n_clusters=2).reshape(-1, )
without_outliers["Cluster"] = cluster_labels
sns.boxplot(x='Cluster', y='fico', data=without_outliers)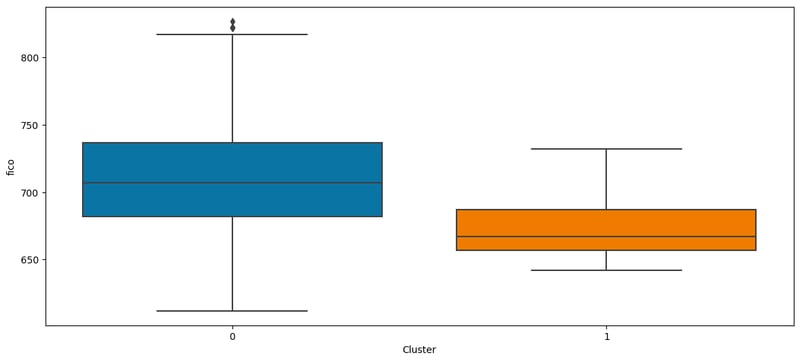
Từ boxplot trên, ta có thể quan sát rằng:
- Người vay thuộc cụm 0 có điểm tín dụng cao hơn.
- Trong khi người vay thuộc cụm 1 có điểm tín dụng thấp hơn.
Cluster Analysis in Python có thể là bước tiếp theo tốt để đào sâu vào K-means và phân cụm phân cấp bằng thư viện Scipy.
Kết luận
Bài viết đã đề cập phân cụm phân cấp là gì, lợi ích và điểm yếu của nó, và cách nó so sánh với K-means và phân cụm dựa trên mô hình.
Chúng tôi hy vọng bài viết cung cấp cho bạn các kỹ năng phù hợp để phân cụm hiệu quả dữ liệu không có nhãn phục vụ ra quyết định.
Câu hỏi thường gặp về Phân cụm Phân cấp
Làm thế nào để chọn số cụm phù hợp?
Trong phân cụm phân cấp, số cụm phù hợp có thể được xác định từ dendrogram bằng cách tìm đường thẳng đứng có khoảng cách lớn nhất mà không giao cắt với các cụm khác.
Xử lý dữ liệu phân loại trong phân cụm phân cấp như thế nào?
Mặc định, phân cụm phân cấp không hoạt động với dữ liệu phân loại. Một cách xử lý là chuyển đổi chúng sang định dạng số thích hợp, như one-hot encoding và ordinal encoding, trước khi áp dụng thuật toán.
Làm thế nào để xử lý các bộ dữ liệu lớn?
Dữ liệu càng lớn, thời gian phân cụm càng cao. Sử dụng cách tiếp cận kết tụ có thể nhanh hơn so với phân chia.
Agglomerative Information Bottleneck (AIB) là gì?
Đó là một thuật toán phân cụm tối đa hóa thông tin tương hỗ trên mỗi cụm giữa dữ liệu và một tập các hạng mục cho trước.
Phân cụm phân cấp có trọng số là gì?
Đó là một biến thể của phân cụm phân cấp gán trọng số cho mỗi điểm dữ liệu để phản ánh tầm quan trọng hoặc mức độ liên quan của nó trong quá trình phân cụm.

