

简介
在本教程中,您将学习 k-means 聚类。我们将涵盖:
- k-means 聚类算法的工作原理
- 如何可视化数据以判断其是否适合聚类
- 使用真实的加州房价数据集训练和调优 k-means 聚类模型的案例研究。
请注意,不要将其与 k 最近邻混淆;如果您想了解该算法,请转到《使用 Python 中的 scikit-learn 实现 k-Nearest Neighbors(KNN)分类》。
了解这一点很有用,因为 k-means 聚类是一种常用的聚类算法,擅长将近似“球形”的数据分成不同的组。当数据行的分组不清晰时,它既可以作为分析工具使用,也可以作为改进监督学习模型的特征工程步骤,具有很高价值。
本教程默认您具备 Python 的基础知识,并能够使用 pandas 的 DataFrame。
K-Means 聚类概览
聚类模型旨在将数据分成不同的“簇”或组。这既可以为分析提供有趣的视角,也可以作为监督学习算法中的一个特征。
设想一个社交场景:房间里不同角落的人们围成小圈交谈。刚看过去,您只会看到一群人。您可以在每个小圈的中心心里放一个点,并将该点命名为一个唯一标识。之后您就可以用这个唯一名称来指代每个小组。k-means 聚类对数据所做的,本质上就是这样。
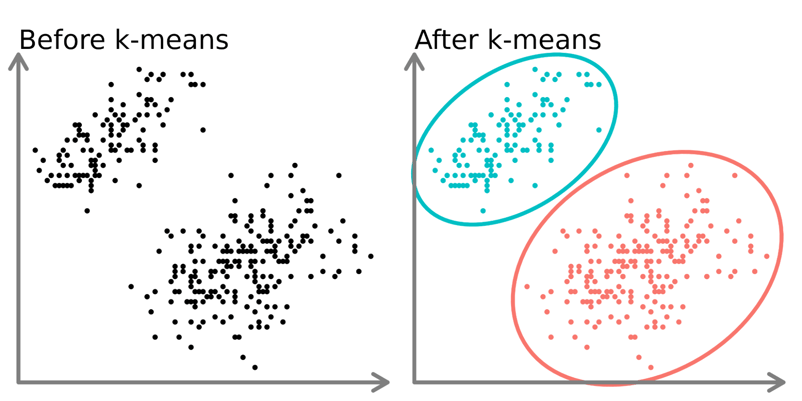
在上图的左侧,我们可以看到两组未标注的点,被着色为相似的数据点。将 k-means 模型拟合到这些数据(右侧)可以揭示 2 个不同的群组(以不同的圆圈和颜色表示)。
在二维情况下,人类很容易分割这些簇,但在更多维度时,您就需要使用模型了。
数据集
在本教程中,我们将使用来自 Kaggle 的加州房价数据(链接)。我们将使用位置信息(纬度和经度)以及房屋中位价。我们将按位置对房屋进行聚类,并观察加州各地的房价波动。我们将数据集保存为工作目录中的名为 ‘housing.csv’ 的 csv 文件,并用 pandas 读取。
import pandas as pd
home_data = pd.read_csv('housing.csv', usecols = ['longitude', 'latitude', 'median_house_value'])
home_data.head()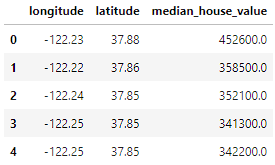
我们使用 usecols 参数选择了 3 个变量:
- longitude:表示房屋位于多偏西的数值。数值越大表示越偏西。
- latitude:表示房屋位于多偏北的数值。数值越大表示越偏北。
- median_house_value:以区块为单位的房屋中位价,单位为美元。
k-Means 聚类工作流
与其他机器学习算法一样,k-Means 聚类也有一套工作流(更深入的机器学习工作流拆解,请参见机器学习工作流新手指南)。
在本教程中,我们将重点放在数据准备阶段的数据收集与拆分,以及建模阶段的超参数调优、模型训练与性能评估。无监督学习中,很多工作都在于超参数调优和性能评估,以便让模型达到最佳效果。
可视化数据
我们先对房屋数据进行可视化。我们基于区块的中位价绘制位置数据的热力散点图。本教程将使用 Seaborn 快速创建图表(如需更好地理解这些图表如何生成,请参见我们的Seaborn 数据可视化入门课程)。
import seaborn as sns
sns.scatterplot(data = home_data, x = 'longitude', y = 'latitude', hue = 'median_house_value')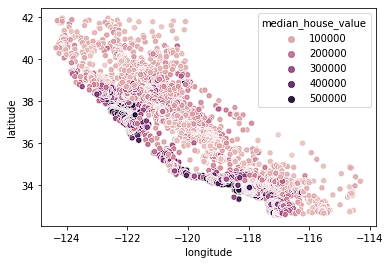
我们看到,大多数高价房位于加州西海岸,同时也有一些中等价位房屋的聚集区域。这也符合预期,因为临水房产通常比非海岸房屋更值钱。
当只使用 2 或 3 个特征时,簇通常很容易识别。但当
数据归一化
在使用基于距离的算法(如 k-Means 聚类)时,我们必须对数据进行归一化。否则,不同量纲的变量会在训练时优化的距离公式中被赋予不同权重。比如,如果在纬度和经度之外将价格也纳入聚类,价格的尺度远大于受边界约束的位置变量,因而会对优化产生不成比例的影响。
我们首先使用 sklearn 的 train_test_split 设置训练集和测试集拆分。
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(home_data[['latitude', 'longitude']], home_data[['median_house_value']], test_size=0.33, random_state=0)接下来,使用 sklearn 的 preprocessing.normalize() 方法对训练集和测试集进行归一化。
from sklearn import preprocessing
X_train_norm = preprocessing.normalize(X_train)
X_test_norm = preprocessing.normalize(X_test)拟合与评估模型
第一次迭代中,我们任意选择聚类数(记作 k)为 3。使用 sklearn 构建并拟合模型非常简单。我们将创建一个 KMeans 实例,通过 n_clusters 指定聚类数,将 n_init(算法使用不同质心初始值运行的次数)设置为“auto”,并将 random_state 设为 0,以便每次运行代码都得到相同结果。然后使用 fit() 方法将模型拟合到归一化后的训练数据。
from sklearn import KMeans
kmeans = KMeans(n_clusters = 3, random_state = 0, n_init='auto')
kmeans.fit(X_train_norm)数据拟合完成后,我们可以从 labels_ 属性中获取标签。下面,我们对刚拟合的数据进行可视化。
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = kmeans.labels_)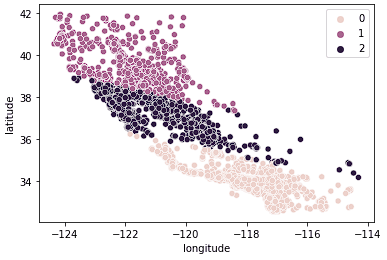
可以看到,数据现在被清晰地分成了 3 个不同的群组(加州北部、中部和南部)。我们还可以使用箱线图查看这 3 个群组中房屋中位价的分布。
sns.boxplot(x = kmeans.labels_, y = y_train['median_house_value'])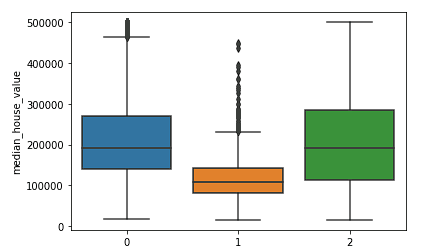
我们清楚地看到,北部和南部簇(簇 0 和簇 2)的房屋中位价分布相似,且高于中部簇(簇 1)。
我们可以使用 sklearn.metrics 中的轮廓系数(Silhouette score)来评估聚类算法的表现,其中分数越低表示拟合越好。
from sklearn.metrics import silhouette_score
silhouette_score(X_train_norm, kmeans.labels_, metric='euclidean')由于我们还没有考察不同聚类数的强弱,因此并不知道 k = 3 的模型拟合得有多好。在下一节中,我们将尝试不同的聚类数并比较性能,从而为模型选择最佳的超参数值。
如何选择最佳聚类数
k-means 聚类的弱点在于,仅靠运行模型并不能知道需要多少个簇。我们需要测试不同范围的取值,并决定最佳的 k。通常我们通过“肘部法”来确定最优聚类数,在不过拟合(簇太多)与欠拟合(簇太少)之间取得平衡。
我们编写如下循环来测试并存储不同模型的结果,以便据此决定最佳的聚类数。
K = range(2, 8)
fits = []
score = []
for k in K:
# train the model for current value of k on training data
model = KMeans(n_clusters = k, random_state = 0, n_init='auto').fit(X_train_norm)
# append the model to fits
fits.append(model)
# Append the silhouette score to scores
score.append(silhouette_score(X_train_norm, model.labels_, metric='euclidean'))接着,我们先直观查看几个不同的 k 取值。
先看 k = 2。
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[0].labels_)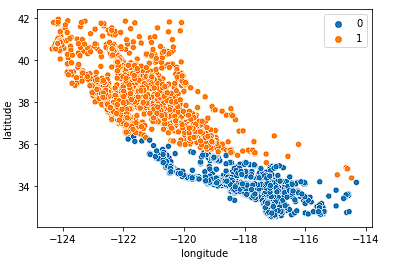
该模型尚可地将加州大致一分为二,但可能不足以捕捉加州房市的细微差别。
接着看 k = 4。
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[2].labels_)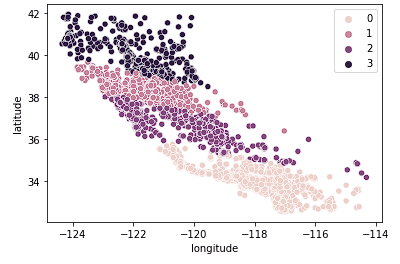
可以看到,该图根据房屋位于州内的南北位置,更合理地将加州分成了若干簇。随着在州内位置的变化,这个模型更可能捕捉到房市的细微差异。
最后看 k = 7。
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[2].labels_)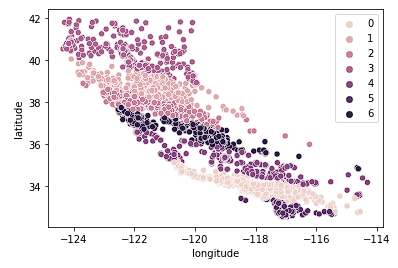
上图的簇显然过多。我们为了“更精细”的地理聚类结果,牺牲了簇的可解释性。
通常,随着 K 值的增加,我们会看到聚类和其表达的含义在某个点之前不断改善;超过该点则出现收益递减,甚至变差。我们可以用肘部图将其可视化,以辅助选择 k 值,其中 y 轴是拟合优度度量,x 轴是 k 的取值。
sns.lineplot(x = K, y = score)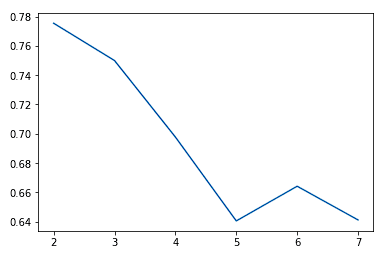
我们通常选择性能改善开始趋于平缓或变差的点。可以看到 k = 5 可能是在不过拟合的前提下我们能做到的最佳选择。
我们也可以看到,这些簇相对合理地将加州划分为不同区域,并且这些簇与不同的价格区间也较为匹配,如下所示。
sns.scatterplot(data = X_train, x = 'longitude', y = 'latitude', hue = fits[3].labels_)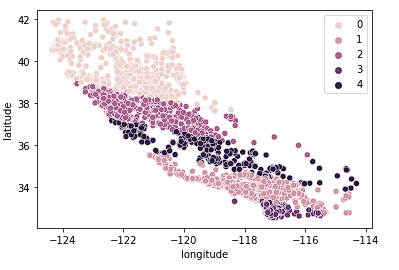
sns.boxplot(x = fits[3].labels_, y = y_train['median_house_value'])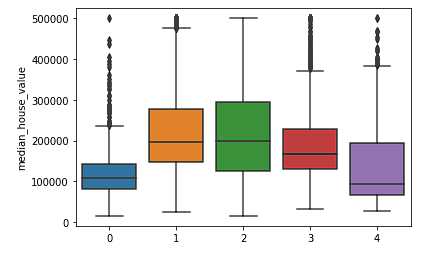
什么时候 k-means 聚类会失效?
k-means 聚类在“球形”数据上表现最佳。所谓球形数据,是指在空间中彼此邻近聚集的数据。在二维或三维空间中更易可视化。对于非球形或本不应是球形的数据,k-means 聚类效果不佳。比如,k-means 在下面的数据上就表现不佳:尽管肉眼可见是两个应被分别标注的圆和弧,但我们难以找到可将它们区分开的明确质心。
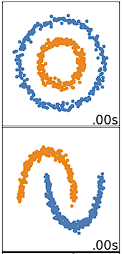
还有许多其他聚类算法更擅长处理非球形数据,详见《机器学习中的聚类:5 种必备聚类算法》。
是否需要将数据拆分为训练集和测试集?
是否拆分数据取决于您进行聚类的目标。如果聚类就是分析的终点,则没有必要。如果您要将聚类结果作为监督学习模型中的特征或用于预测(就像我们在《Scikit-Learn 教程:棒球分析(上)》中所做的那样),那么在聚类前需要先拆分数据,以确保遵循监督学习工作流的最佳实践。
更进一步
现在我们已经介绍了在 Python 中进行 k-means 聚类的基础,您可以查看这门《Python 无监督学习》课程,了解 k-means 及其他无监督学习算法的良好入门内容。我们的进阶课程《Python 聚类分析》将更深入地讲解聚类算法,以及如何在 Python 中构建与调优它们。最后,您还可以查看教程《Python 分层聚类入门》,该方法使用另一类算法从数据中构建层级结构。