

什么是数据仓库?
在深入了解 Snowflake 的架构之前,我们先回顾一下数据仓库,确保大家对基础概念达成一致。
数据仓库是一个集中式存储库,用于为公司存放来自各类来源的大量结构化、组织化数据。组织中的不同角色(员工)使用其中的数据来获取不同洞见。
例如,数据分析师可以与市场团队协作,使用销售表为一项新的营销活动进行 A/B 测试。人力资源专家可以查询员工信息以跟踪绩效。
这些都是全球各家公司借助数据仓库推动增长的典型方式。但如果没有像 Snowflake 这样的工具进行妥善实施与管理,数据仓库就只是纸上谈兵的概念。
您可以通过我们的 Data Warehousing 课程进一步学习该主题。
Snowflake 架构
Snowflake 为更快的分析型查询而设计,其独特架构源自对存储层与计算层的分离。这一区别也造就了我们前文提到的诸多优势。
存储层
在 Snowflake 中,存储层是关键组件,负责以高效且可扩展的方式存放数据。该层的要点如下:
- 云原生:Snowflake 可与 AWS、GCP 与 Microsoft Azure 等主流云服务商无缝集成。
- 列式存储:Snowflake 以列式格式存储数据,针对分析型查询进行了优化。与 Postgres 等工具采用的传统行式格式不同,列式格式更适合数据聚合。在列式存储中,查询只会访问所需的特定列,因此更高效;而行式格式即便是计算均值这样的简单操作,也需要在内存中访问所有行。
- 微分区:Snowflake 采用名为微分区(micro-partitioning)的技术,将表以小块形式存放在内存中。每个小块通常是不可变的,且仅有数兆字节大小,这使得查询优化与执行更为迅速。
- 零拷贝克隆:Snowflake 具备独特功能,可创建数据的虚拟克隆。克隆操作瞬时完成,且在对新副本进行更改之前不会占用额外内存。
- 规模与弹性:存储层支持横向扩展,这意味着可通过增加服务器分摊负载来应对数据量增长。此外,该扩展独立于计算资源,当您希望存放海量数据但仅分析很小一部分时,这尤其理想。
接下来,我们看看计算层。
计算层
顾名思义,计算层是执行查询的引擎。它与存储层协同工作,对数据进行处理并完成各类计算任务。以下是该层的更多细节:
- 虚拟仓库:您可以将虚拟仓库看作处理查询的计算机团队(计算节点)。团队中的每个成员负责查询的不同部分,从而实现令人惊叹的快速并行执行。Snowflake 提供不同大小、相应价格的虚拟仓库(包括 XS、S、M、L、XL)。
- 多集群、多节点架构:计算层采用多集群与多节点以实现高并发,允许多位用户同时访问与查询数据。
- 自动查询优化:Snowflake 系统会分析所有查询并利用历史数据识别优化模式。常见优化包括裁剪无关数据、利用元数据以及选择最高效的执行路径。
- 结果缓存:计算层包含缓存,用于存放高频执行查询的结果。当再次运行相同查询时,几乎可以即时返回结果。
这些计算层的设计原则共同造就了 Snowflake 在云端处理各类繁重工作负载的能力。
云服务层
最后一层是云服务。由于该层融入了 Snowflake 架构的每个组件,其运行机制涉及诸多细节。除与其他层相关的特性外,它还承担以下额外职责:
- 安全与访问控制:该层实施安全措施,包括身份验证、授权与加密。管理员使用基于角色的访问控制(RBAC)来定义与管理用户角色和权限。
- 数据共享:该层在不同账户甚至第三方组织之间实现安全的数据共享协议。数据消费者无需搬移数据即可访问,从而促进协作与数据变现。
- 半结构化数据支持:Snowflake 的另一独特优势在于,尽管它是一个数据仓库管理平台,却能处理诸如 JSON、Parquet 等半结构化数据。它可以轻松查询半结构化数据,并将结果与现有表集成。这种灵活性在其他关系型数据库管理系统中并不常见。
现在我们已经对 Snowflake 的架构有了宏观认识,接下来就在平台上写点 SQL 吧。
设置 Snowflake SQL
Snowflake 拥有自己的 SQL 方言,称为 Snowflake SQL。它与其他 SQL 方言的差异,就像英语不同口音之间的差别。
在 PostgreSQL 等方言中,许多分析型查询写法并不会改变,但在 DDL(数据定义语言)命令上会存在一些差异。
现在,让我们来看看如何运行一些查询!
Snowsight:Web 界面
要开始使用 Snowsight,请前往 Snowflake 120 天免费试用 页面并创建账户。填写个人信息并选择任一列出的云服务商。这样您将获得 120 天免费试用,而不是其他地方更常见的 30 天试用。试用还包含价值 400 美元的额度。
注册试用时,建议用户选择 AWS 和美国俄勒冈西部区域。除其他原因外,俄勒冈是 AWS 基础设施成本较低的区域之一,因此试用额度能用得更久。
验证邮箱后,您将被重定向至 Worksheets 页面。Worksheet 是交互式的实时编程环境,您可以在此编写、执行并查看 SQL 查询结果。
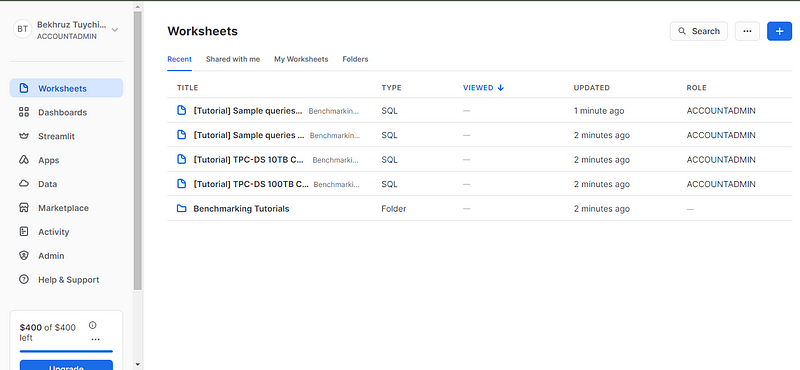
要运行一些查询,我们需要一个数据库和一张表(我们不会使用 Snowsight 中的示例数据)。开始时,建议您尝试创建一个新数据库(可命名为 test_db 之类)以及一张使用本地 CSV 文件创建的表。您可以在终端中运行 这个 GitHub gist 中的代码来下载该 CSV 文件。
随后,您会进入一个新的 worksheet,在那里可以运行任意 SQL 查询。我觉得这个界面相当直观且功能强大。请花几分钟熟悉各个面板、按钮及其位置。
结语与进阶学习
呼!我们从一些简单概念起步,但在最后深入到了更“硬核”的细节。嗯,这就是我心目中像样的教程。
您或许已经猜到,Snowflake 的内容远不止本文所及。事实上,Snowflake 文档中的快速入门指南,实际时长就有 128 分钟!但在您挑战那些内容之前,我建议先通过其他资源动手实践一下。比如这些:
- Introduction to Snowflake 课程
- 关于使用 Snowflake 现代化销售分析的网络研讨会
- 在 Snowflake 中使用 Python 进行数据分析 的跟练
- 官方 Snowflake 用户指南
- Snowflake Northstar,了解 Snowflake 的长期愿景。
感谢您的阅读!

我是一名数据科学内容创作者,拥有超过 2 年的经验,并在 Medium 上拥有较大的读者群。我喜欢用略带讽刺的笔调撰写有关 AI 和机器学习的深度文章——毕竟总得想点办法让这些内容不那么枯燥。我已发表 130 多篇文章,并制作了一门 DataCamp 课程,另有一门正在筹备中。我的内容已被超过 500 万人次阅读,其中有 2 万人在 Medium 和 LinkedIn 上成为关注者。
什么是 Snowflake?
如果要我用尽可能少的词来形容 Snowflake,我会选择这些:
如果需要我稍作展开,我会这样把这些词串起来:
Snowflake 是一款极受欢迎的 AI 数据云平台。它之所以在竞争中脱颖而出,源于其能够更快、更高效地处理大规模数据与工作负载。其卓越性能来自独特的架构设计——将存储与计算分离,从而实现极高的灵活性与可扩展性。此外,它还能与多家云服务商原生集成。尽管具备这些先进特性,它仍然易于学习和落地。
如果他们还想要更多细节,那么我就会写下这篇教程。若您完全是新手,我们的 Introduction to Snowflake 课程是极佳的起点。
为什么使用 Snowflake?
Snowflake 服务于全球超过 8,900 家客户,每天处理 39 亿条查询。这样的使用数据绝非偶然。
以下是 Snowflake 最具吸引力的一些优势:
1. 云端架构
Snowflake 运行于云端,让企业能够按需伸缩资源,无需操心物理基础设施(硬件)。平台还会处理例行的维护任务,如软件更新、硬件管理和性能调优。这减轻了维护负担,使组织得以专注于真正重要的事情:从数据中创造价值。
2. 弹性与可扩展性
Snowflake 将存储与计算层解耦,用户可以独立于存储需求来伸缩计算资源。这种弹性使其能够高效处理多样化工作负载,在获得最佳性能的同时避免不必要的成本。
3. 并发与性能
Snowflake 轻松应对高并发:多位用户可同时访问并查询数据而不会出现性能下降。
4. 数据共享
Snowflake 的安全机制支持跨组织、内部部门、外部合作伙伴、客户或其他相关方的数据共享。无需进行复杂的数据传输。
5. 时光回溯
Snowflake 用一个别致的术语 “Time Travel”(时光回溯)来指代数据版本控制。每当对数据库进行更改,Snowflake 都会拍下一个快照。这样,用户就能在不同时间点访问历史数据。
6. 成本效益
得益于其动态伸缩资源的能力,Snowflake 提供按使用量计费的模式。您只需为实际使用付费。
上述优势叠加,使 Snowflake 成为极具吸引力的 AI 数据云平台。
现在,让我们看看支撑这些特性的 Snowflake 底层架构。