

如果您想进一步了解该领域的最新发布,建议查看我们关于其他顶级视频生成模型的指南。
什么是 Kling AI?
Kling AI 是一个生成式 AI 平台,可根据文本提示、图像或二者结合来创建视频。由中国科技公司 快手 开发,它很快就成为角色一致性表现最佳的 AI 模型之一。其生成的视频自带原生音频,成片更显精致,开箱即用。
Kling AI 的定价与访问
与许多 AI 视频模型一样,Kling AI 的定价基于点数(credits)。我们按月订阅,可获得固定数量的月度点数。不同订阅层级还会锁定一些小功能,但主要区别仍在于可用的生成点数。
为撰写本文,我使用了他们的 Pro 方案(每月 32.56 美元),包含 3,000 点数。关于定价方案的更多详情,请查看 Kling AI 官方定价页面。
生成一个视频需要多少点数?
点数消耗主要由三个因素决定:
- 视频时长(3 到 15 秒)
- 分辨率(720p 或 1080p)
- 是否生成音频
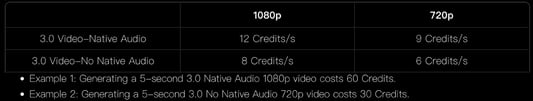
假设我们生成带原生音频的视频,在 Pro 订阅下,每月大约可生成约 6 分钟的 720p 视频或 4 分钟的 1080p 视频。
Kling 3.0 的关键功能
本节示例来自 Kling 3.0 模型官方用户指南。
隐式多镜头场景
多数 AI 视频模型在提示仅描述一个镜头或一个动作时效果最佳。Kling 3.0 能理解一个提示中描述的多个镜头。
下面的示例提示描述了视频的环境以及四个镜头,但没有显式逐条列出:
Outdoor terrace of a European villa, by a dining table with a blue and white checkered tablecloth, a young white woman in a blue and white striped short-sleeve shirt and khaki shorts, with a brown belt, sits barefoot, opposite a young white man in a white T-shirt.
The camera zooms in, the woman swirls the juice in a glass, her eyes looking at the distant woods, and says, "These trees will turn yellow in a month, won't they?"
Close-up of the man, he lowers his head and says, "But they'll be green again next summer."
Then the woman turns her head, smiles at the man opposite, and says, "Are you always this optimistic? Or just about summer?"
Then the man lifts his head, looks at the woman, and says, "Only about summers with you."该提示与一张图像配对,模型将其用作视频的第一帧。
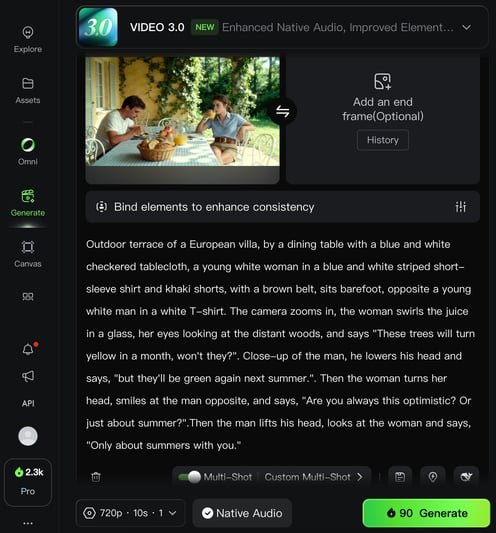
以下是生成结果:
这段视频给我留下了深刻印象。提示契合度很高,画面在我看来也相当真实。
显式多镜头场景
尽管模型能够从文本提示中理解一个镜头结束和下一个镜头开始的位置,但并不完美,可能会与我们的意图有所偏差。我们可以在提示中显式列出各镜头,来强制场景结构。
Shot 1: Profile shot of a Black man driving a truck, cinematic handheld.
Shot 2: Frontal macro shot of the Black man driving, cinematic handheld.
Shot 3: Macro shot of his hands on the steering wheel, cinematic handheld.
Shot 4: Macro shot of a weathered photograph of a young Black child lying on the passenger seat, cinematic handheld.要分别指定每个镜头,我们点击提示输入框底部的自定义多镜头(Custom Multi-Shot)按钮。在那里,我们可以为每个镜头提供提示并设置时长。每个视频最多可包含 6 个镜头。
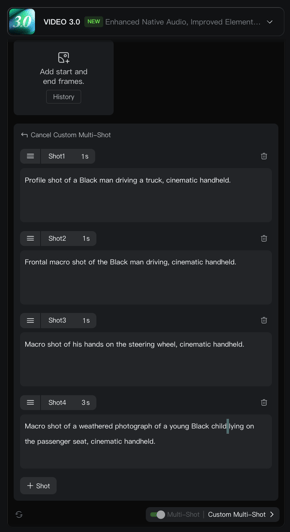
以下是该多镜头提示的生成结果:
音频与语气控制
如前所示,Kling 3.0 支持生成带原生音频的视频。但它还能更进一步。我们可以在提示中指定所需内容来引导生成的音频。例如:
Home setting with a faint hum of the living room air conditioner in the background for a realistic daily vibe.
Mom (softly, in a surprised tone): Wow, I didn't expect this plot at all.
Dad (in a low voice, agreeing, in a calm tone): Yeah, it's totally unexpected. Never thought that would happen.
Boy (in an excited tone): It's the best twist ever!
Girl (nodding along, in an enthusiastic tone): I can't believe they did that!在此示例中,提示给出了背景声以及视频中的人物应如何说话。对于对话,常见的结构是:
<who is speaking> (<how things are said>) <what they say>以下是根据上面提示生成的视频:
该示例由首帧图像生成。这有助于模型将角色与提示对应起来。令人印象深刻的是,模型仅凭图像就能识别出谁是父亲、母亲、男孩和女孩。
多语种语音能力
该模型支持以下语言的语音生成:
- 中文
- 英语
- 日语
- 韩语
- 西班牙语
我们可以与语气描述一起指定所说语言:
<who is speaking> (<how things are said>, <language>) <what they say>示例如下:
On the rooftop of a Korean high school, distant city lights glimmer in the background with a soft wind rustling, and stars twinkle in the night sky. The girl leans against the railing, lost in thought. The boy walks over with two cans of cola, hands one to her, and she takes it and pops the tab open.
Boy (casual tone, Korean): "숙제 다 했어? 왜 여기 있어?"
Girl (sighing, Korean): "시험이 너무 무 서워"".
Boy (gentle tone, Korean): "4정 마, 넌 잘할 거야."主体绑定
主体绑定是一项功能,可让特定角色或视觉元素在生成视频中保持一致。锁定主体的外观与特征有助于在发生变焦、平移或俯仰等镜头运动时,仍能保持主要对象的稳定与可辨识。
上传图像作为初始帧后,我们可选择绑定元素以增强一致性(Bind elements to enhance Consistency)来启用该功能。系统会据此创建参考,用于在视频生成过程中维持视觉稳定,防止主体出现不必要的变化。
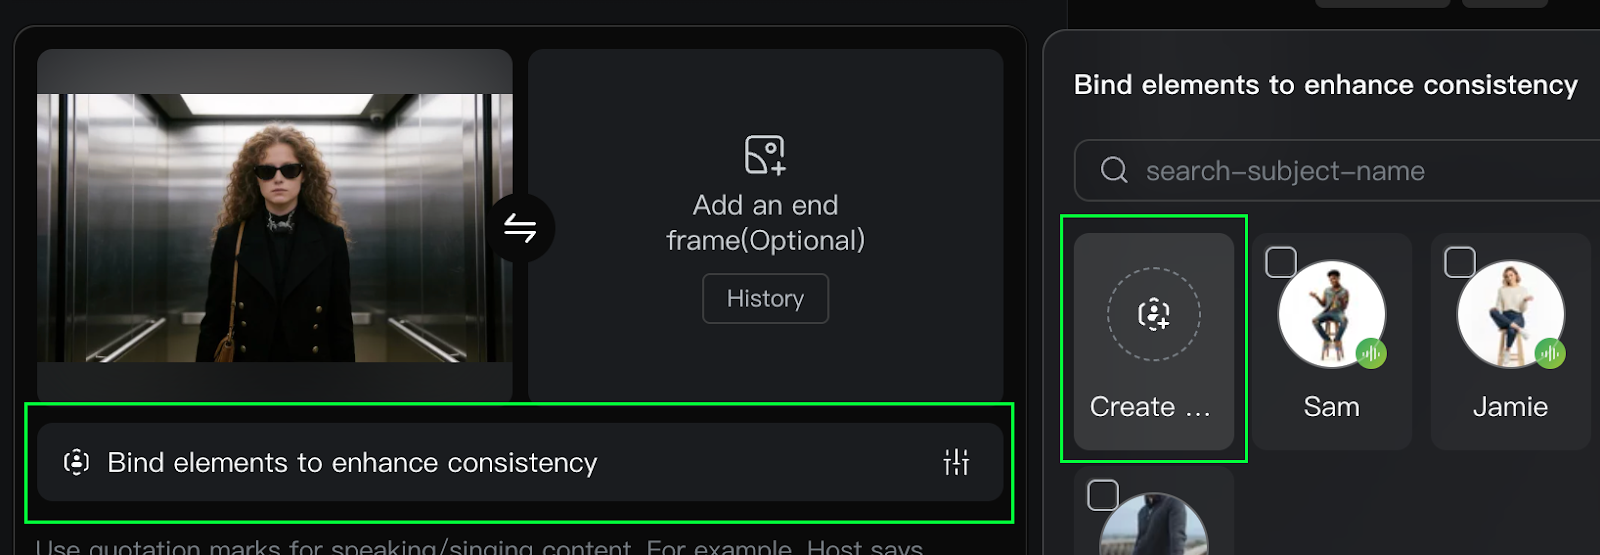
如果不进行主体绑定,模型将不得不猜测初始图像中不可见的主体特征。比如在上图中,主体戴着太阳镜,因此提供一张主体正脸的图像会很有用。若希望模型不要“凭空想象”人物长相,提供其他姿态(如向左看、向右看)也很有帮助。
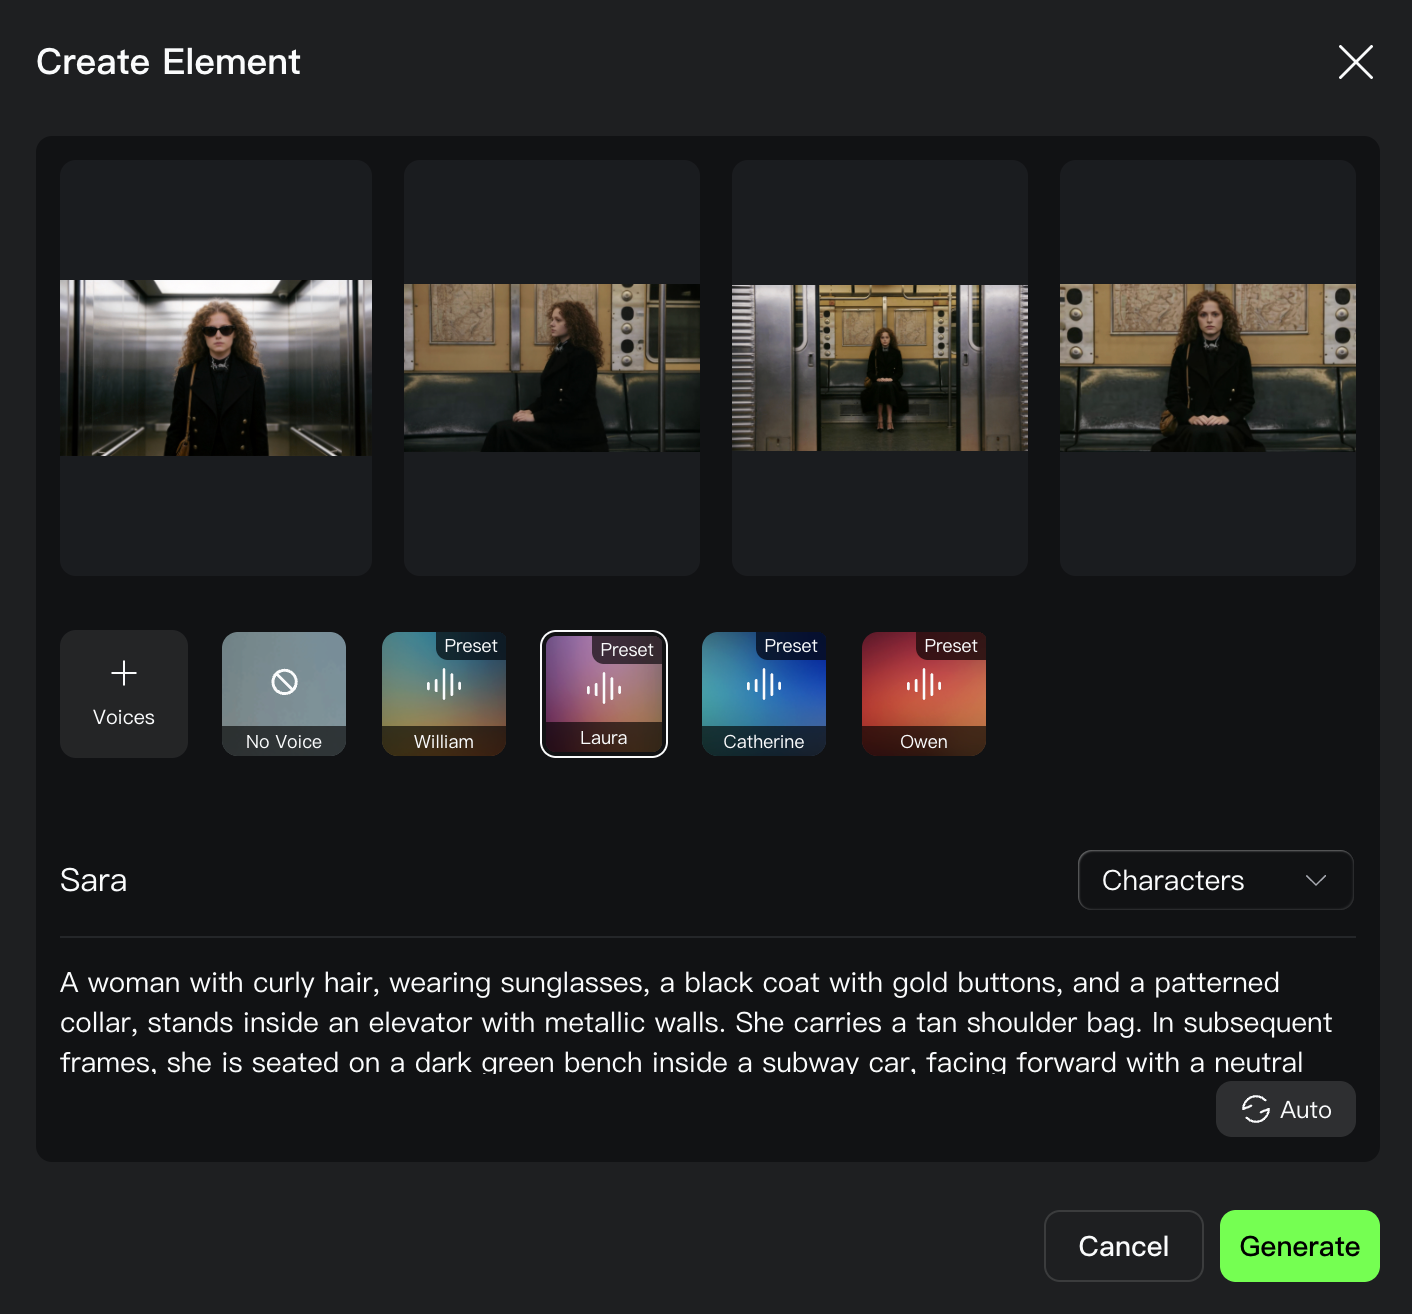
创建元素时,我们最多可提供三张图像。同时还可为角色选择声音与名称。
以下是生成结果:
对我个人而言,这些功能堪称改变游戏规则,因为在 AI 视频生成中,角色一致性一直是最让我感到挫败的部分。过去往往需要极为详尽的文本提示,并反复迭代才能做好。
Omni 模式
Kling AI 的 Omni 模式将所有功能整合到一个模型中。可以把它看作“强化版”的主体绑定,它允许我们创建元素(角色、场景、物品等),然后在单个提示中把它们组合起来。这样就可以以较高的准确度生成非常复杂的场景。
例如,我们可以通过提供参考图像来创建一个角色元素,再创建一个场景元素,并轻松将该角色放入该场景。又如,我们可以创建多个角色,并在提示中引用这些角色来展开你来我往的对话。
使用 Omni 模式时,我们可以用 @ 引用先前创建的元素。输入后会弹出一个窗口,供我们选择要引用的元素。
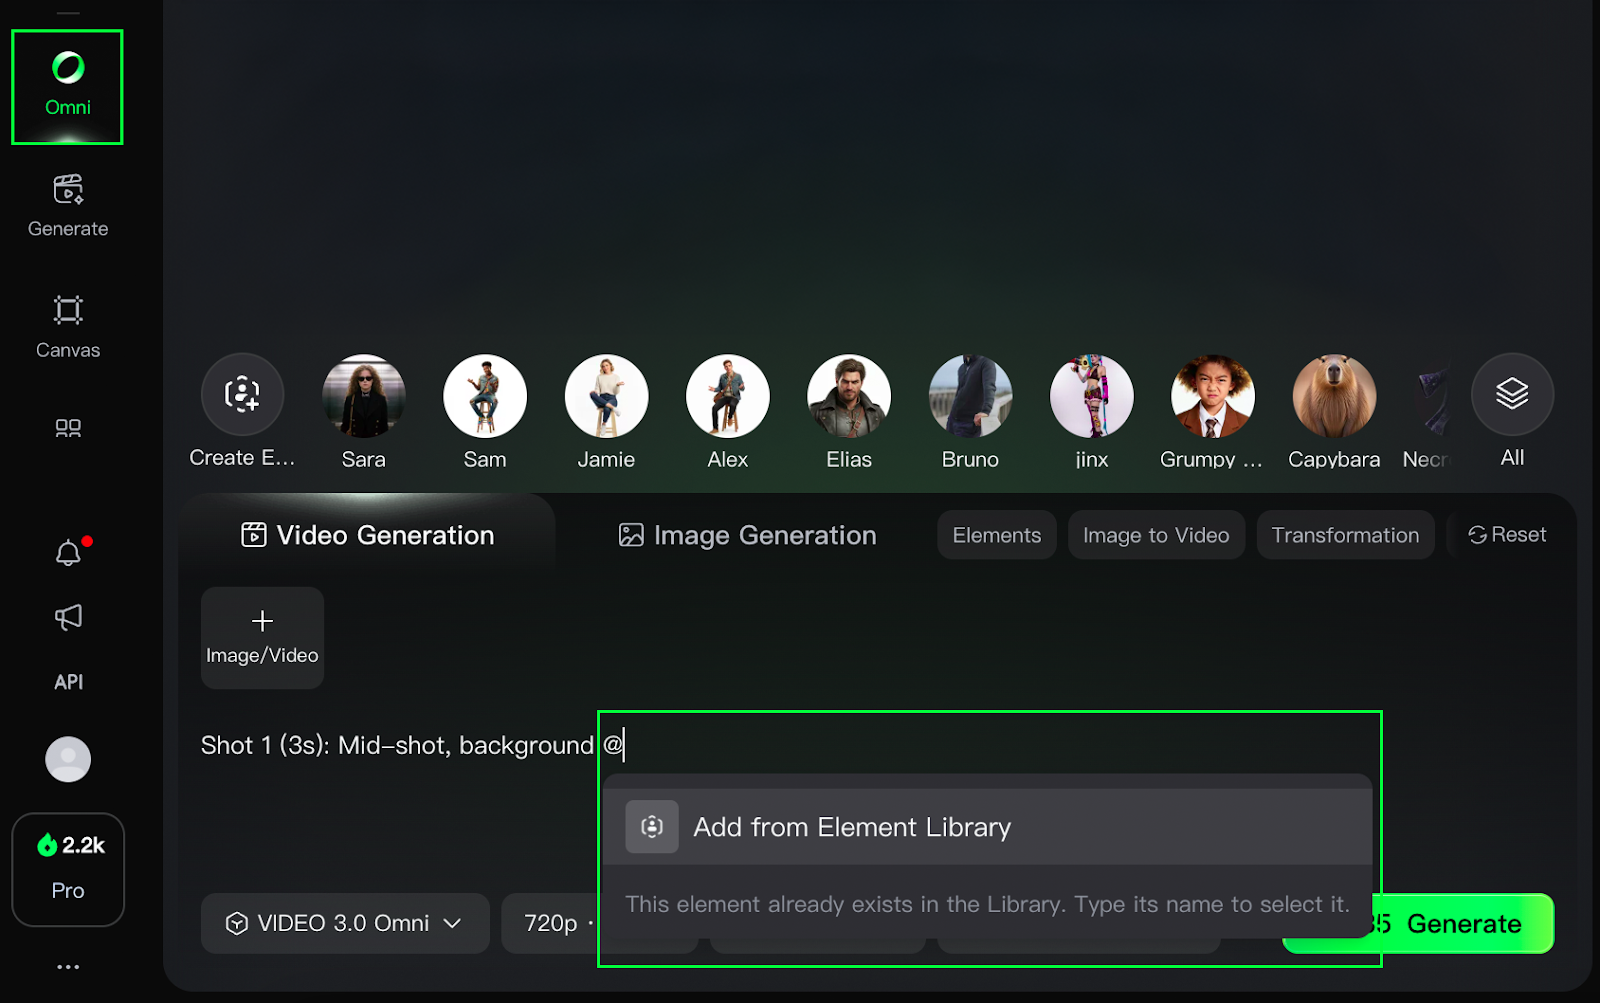
下面是一个三镜头示例,展示 Omni 的强大与灵活:
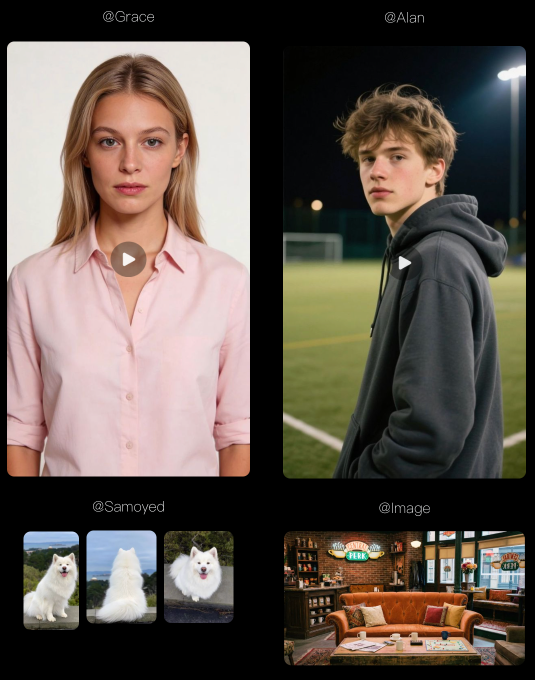
Shot 1 (3s): Mid-shot, background @Image. @Grace sits on the sofa eating cookies as @Alan walks in holding @Samoyed.@Samoyed lunges for the cookie in @Grace's hand. @Grace says, "Hey! Watch your dog!"
Shot 2 (2s): @Alan sits beside her, pulling the leash and lifting @Samoyed. Close-up, @Alan says, "He just likes cookies more than me."
Shot 3 (3s): Close-up, @Grace smiles and says, "Well, he has good taste at least."在此示例中,@Image、@Grace、@Alan 和 @Samoyed 是分别创建的元素,然后在一个提示中一起使用。
测试 Kling 3.0
上一节我们了解了 Kling 3.0 的核心能力,并展示了来自其官网的一些示例。我认为这些结果非常出色,但对厂商给出的示例我们仍应持保留态度,因为这些通常是精心挑选出来的最佳案例。
本节我们将亲自上手,用新的示例进行测试,看看该模型是否名副其实。
示例 1:生成一个角色
我用 AI 生成了一个奇幻角色。我先生成了一张全身图,然后生成了几个不同的姿态,比如向左看、向右看以及愤怒表情。
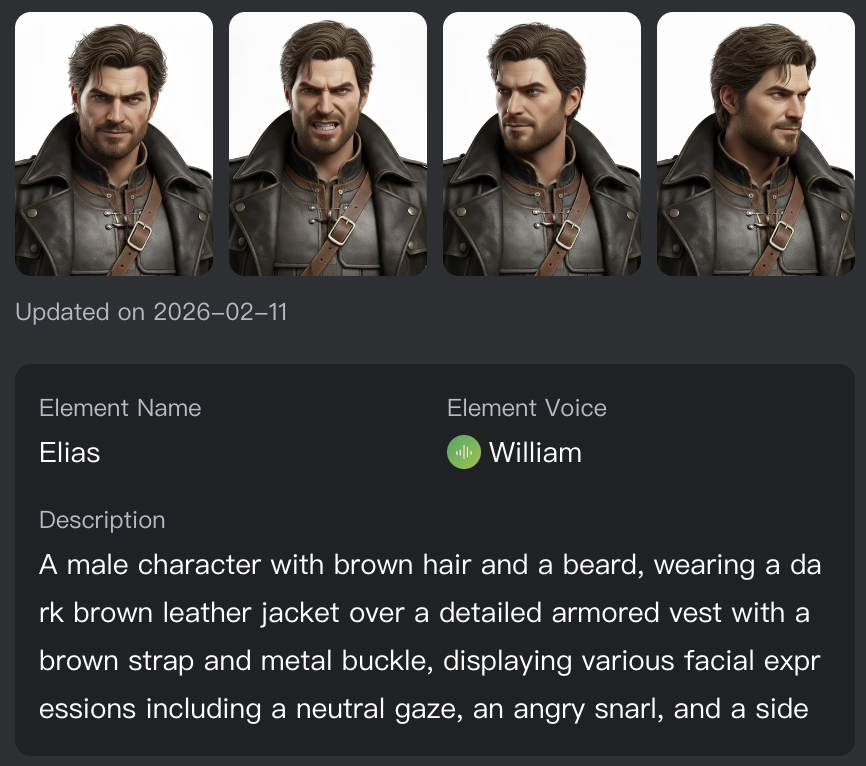
我把这些元素组合起来,创建了一个名为 Elias 的角色。随后我生成了一张视频首帧图像,并使用主体绑定将二者绑定。
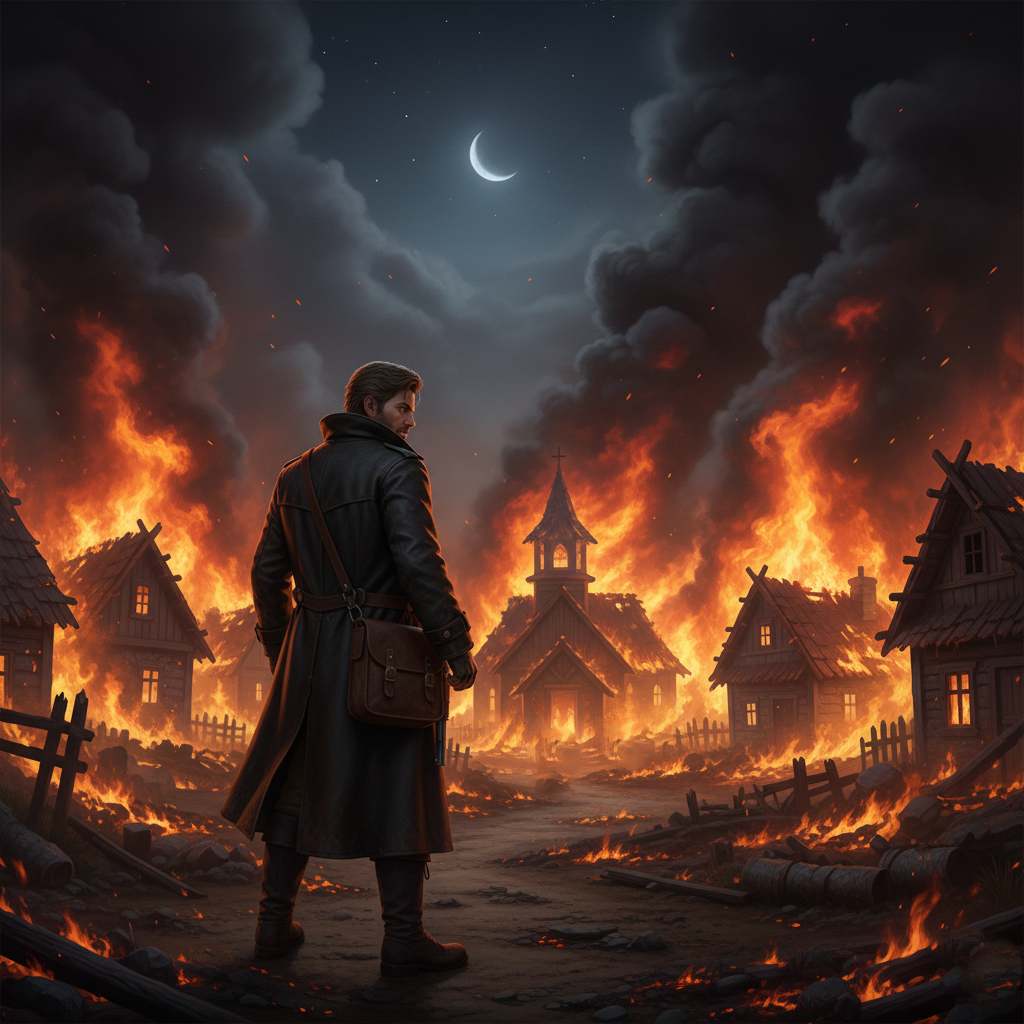
以下是我使用的提示:
Elias stands alone in front of the burning village. Elias is breathing heavily, his hands clenched into tight fists at his sides.
Elias looks at something just off-camera, something we cannot see. Elias says, in a low and dangerous voice, "I told you what would happen if you crossed that line."
Elias pauses for a second.
The camera zooms in close to his face. His face burns with anger, and he says, "I gave you my word, and I gave you a choice." 请注意这里没有使用 @ 引用,因为这个视频我没有用 Omni 模式,只使用了主体绑定。以下是生成结果
示例 2:用 Omni 生成一段喜剧短片
这里我尝试创作一段朋友间的情景喜剧。我用 AI 创建了三个角色:Alex、Jamie 和 Sam。与之前一样,我为每位角色生成了几个不同的姿态。
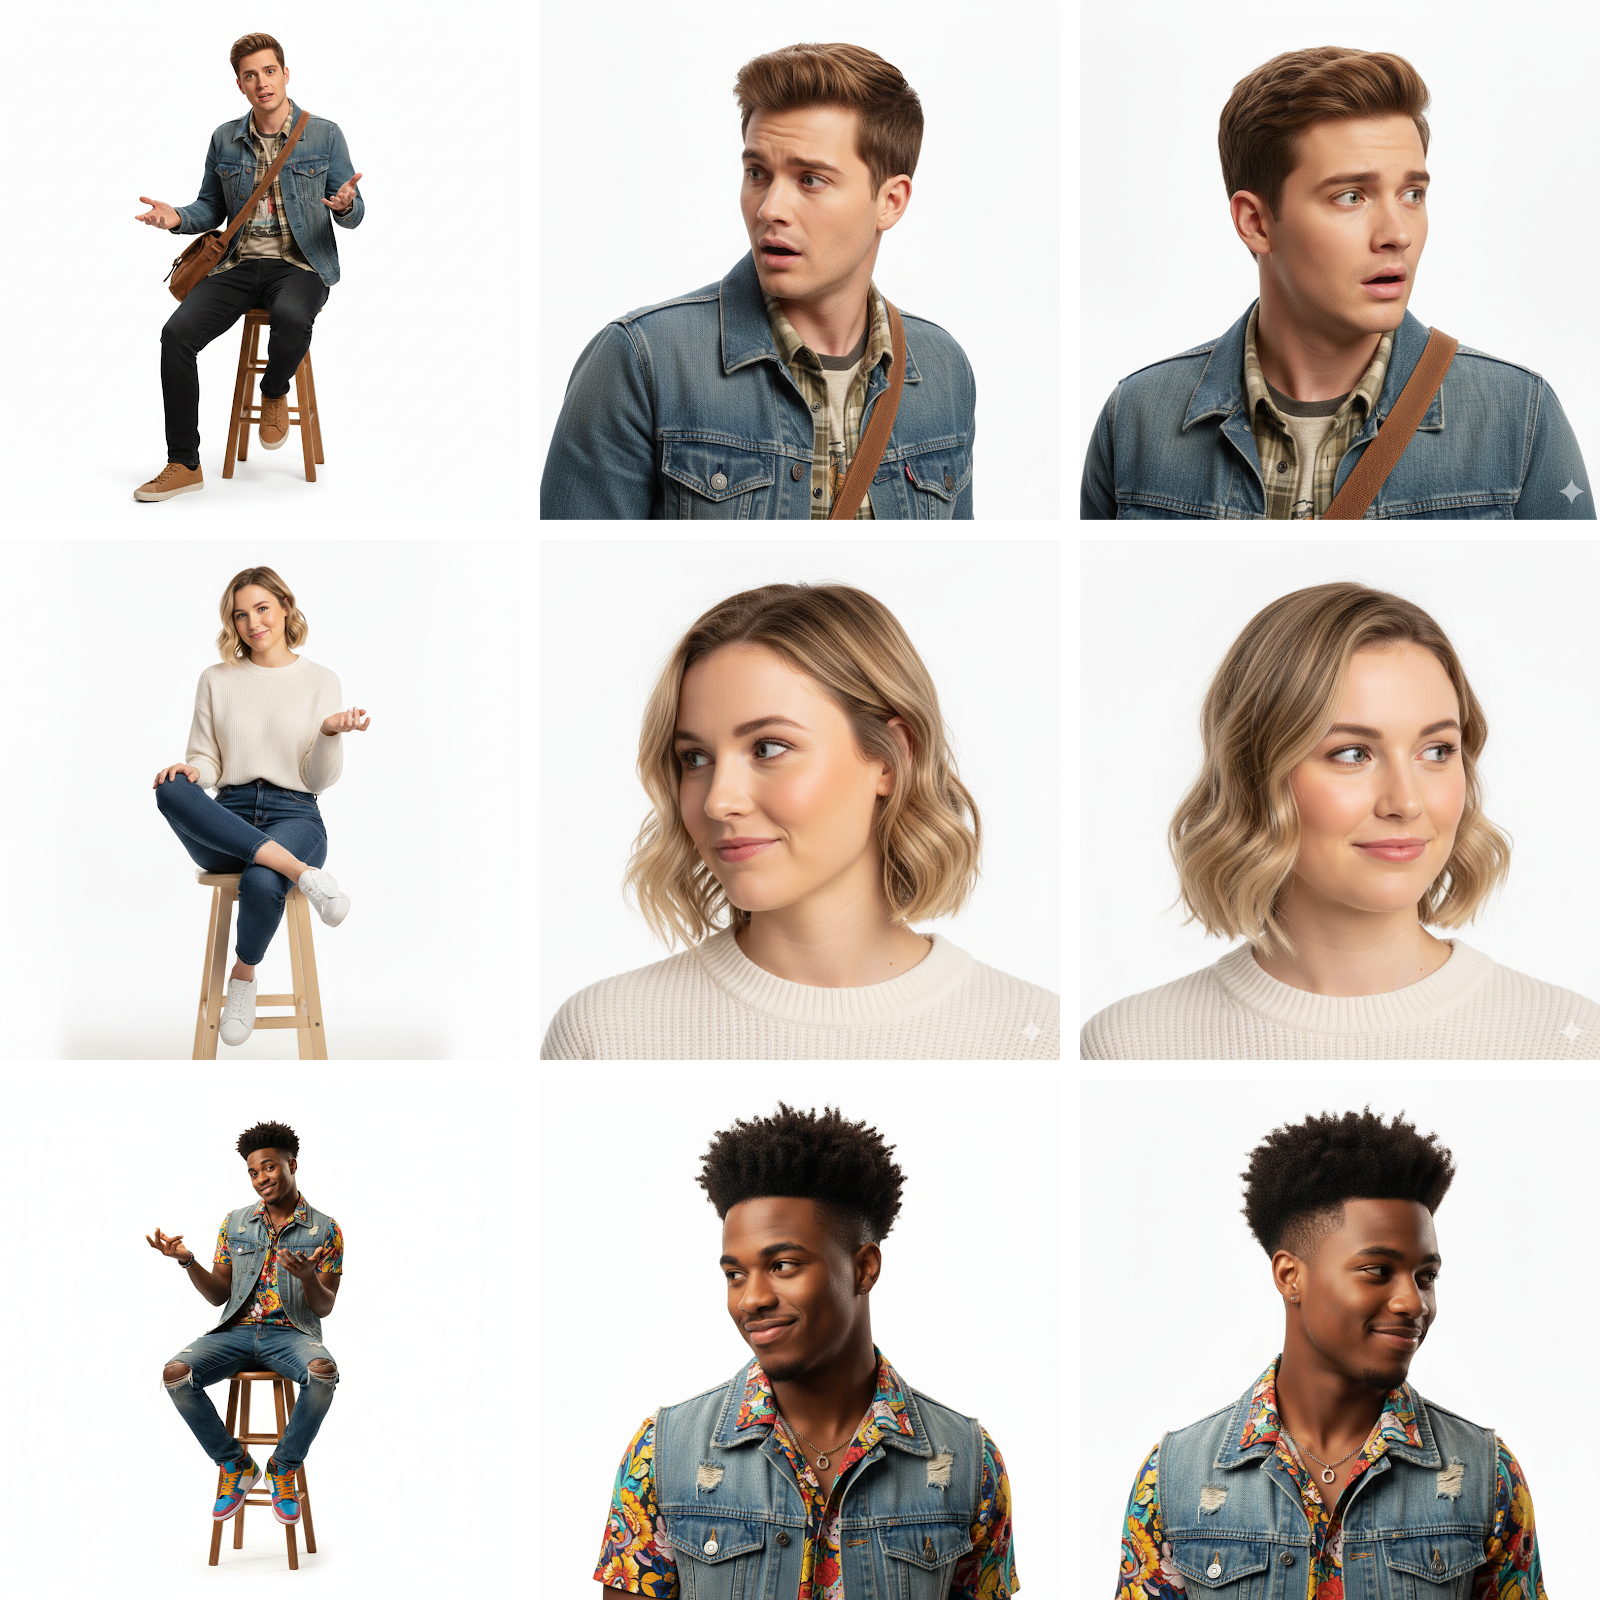
我还为场景位置生成了一张图,并据此创建了一个场景元素。
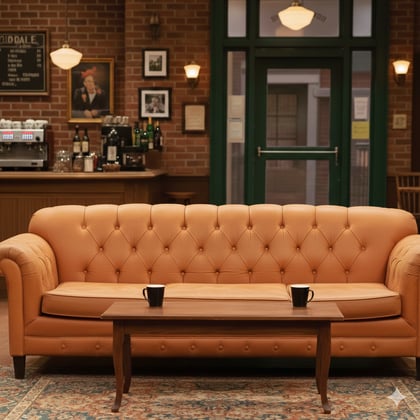
以下是我最终使用的提示。我用文本提示来描述镜头,而没有使用其多镜头功能,因为该功能会将场景限制为六个镜头。事实证明,Kling 3.0 也完全能处理这种方式。
Shot 1: Mid-shot, background @Image.
Shot 2: @Jamie and @Sam sit on the couch as @Alex rushes into the coffee shop and says, "I just liked my ex’s photo from 2016."
Shot 3: @Jamie turns to @Alex and says, "How bad?"
Shot 4: @Alex replies, "She’s with the guy she left me for."
Shot 5: Camera focuses on @Sam, and he replies, "Delete it, dude!"
Shot 6: @Alex replies, "I did, but what if she saw?"
Shot 7: @Sam says, "Then act confident, like her wedding photo."
Shot 8: @Jamie laughs, and @Alex says, "I need new friends..."以下是生成结果:
我们可以在视频中看到几个问题:
- 开头有一帧空沙发。这可能是我的问题,因为我没有在第 1 镜头中明确说明角色应坐在沙发上。不过即使我重试,开头仍然是空的。只有当我提供坐在沙发上的首帧画面时,才得到预期结果。但那种情况下,想让 Alex 从咖啡店门外进入又变得困难。
- 沙发上多出了一个额外角色。
不过,尽管如此,我仍然觉得结果非常出色。角色鲜活且真实,整体场景流畅自然。
示例 3:在多场景视频中复用角色
在最后一个示例中,我尝试在不同语境中复用已创建的角色。想法是感受他们在不同视频间的一致性,以判断用相同角色创作多场景内容是否可行。因为如果角色在外观与气质上都能保持一致,我确实认为 Kling 3.0 可以用来生成更长篇幅的内容。
这次我使用了多镜头功能来描述每个镜头。以下是场景配置:
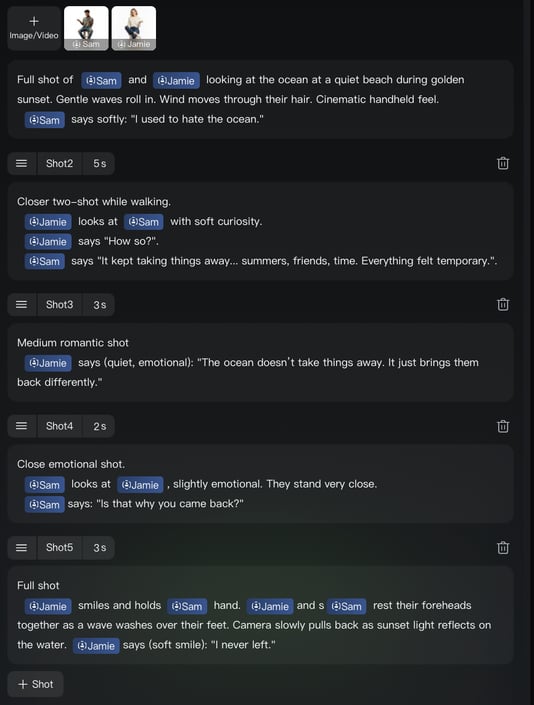
以下是生成的视频:
同样,我认为结果非常接近我的预期。除了为增加情绪而出现的一些停顿,以及最后一镜头没有看到角色开口之外,其余部分都相当到位。
Kling 3.0 与 Runway Gen-4.5 对比
在我看来,此前我用过的最佳 AI 视频模型是 Runway Gen-4.5。我想通过与 Kling 3.0 的对比来结束本文,使用我在这篇关于 Runway 的文章里用过的几个提示。
物理理解
该示例旨在测试模型对物理的理解:让大象和老鼠玩跷跷板。第一种情况,老鼠先坐在跷跷板上,大象应从空中落下;第二种则相反。
两种模型似乎都理解老鼠比大象更轻。Kling 3.0 对提示的遵循度稍高一些,因为在两种情况下,大象和老鼠都应从空中落下。
角色情绪
第二个示例测试模型传达角色情绪的能力。提示要求生成一个收到非常悲伤短信的人的视频。
在这个例子中,Kling 3.0 显然更胜一筹。其情绪表现真实,而 Runway 4.5 的视频出现了奇怪的泪水,甚至还有从角色嘴里流出的水。
复杂奇幻场景
在最后一个示例中,我们让两个模型生成一个复杂的奇幻场景:主角拥有一支能画出并赋予事物生命的魔法画笔。主角被坏人追赶,在死胡同中用画笔逃脱。
两种模型都无法完全生成这个场景,但 Runway 的结果更为准确。不过,这两者都是用一条很长的提示生成的。我认为如果使用 Kling 的 Omni 功能,这个场景是可以实现的。
结语
Kling 3.0 是第一个真正让我觉得可以把脑海中的画面“完整落地”的视频 AI,而不只是“差不多”。
只要有足够的点数与锁定的剧本,我有信心它可以支撑完整且一致的剧集,甚至是一部电影,同时在各场景之间保持角色身份、基调与连贯性。虽然仍需要迭代与质量把控,但终于感觉更像正常的制作流程,而不是与模型“搏斗”。
在我的实验中,它并非每次都一击即中;偶尔会把两个角色弄混,或在镜头间交换左右位置,少数情况下还会把台词分配错位。但总体而言,每个场景的首次尝试通常就已非常接近目标输出。
话虽如此,我仍觉得 Kling 有点贵,尤其对我这样的业余爱好者。很想尝试更长的内容,但以目前定价来看,点数的“算账”让实验与重拍的合理性变得不太足。
好消息是趋势非常明确:质量在快速提升,效率在不断改进,竞争也在加剧。我相信成本会下降、使用门槛会降低,不久后 AI 视频创作就能既便宜又足够精准,适用于周末项目和独立制作。
如果您希望精进 AI 技能,为 AI 成为就业市场核心技能的未来做好准备,欢迎查看我们的 AI 基础课程。
Kling 3.0 常见问题
Kling 3.0 能生成带对白和音效的视频吗?
可以。Kling 3.0 能直接根据提示生成同步对白、背景音以及语气变化。用户可以指定对白的表达方式,包括情绪、语调和背景音提示。
Kling 3.0 支持哪些语言?
该模型支持以下语言的语音生成:中文、英语、日语、韩语和西班牙语。
使用 Kling 3.0 需要图像吗?
不需要。仅凭文本提示也能用 Kling 生成视频。不过,提供参考图像能显著提升角色一致性和视觉准确度,尤其是在使用主体绑定或 Omni 模式时。
Kling 3.0 适合长篇叙事吗?
Kling 3.0 在长篇内容方面展现出强大潜力,因为它支持角色复用、多场景一致性以及复杂叙事。不过,生成更长的作品可能需要大量点数以及多轮打磨。
Kling 3.0 的主要局限是什么?
尽管非常强大,Kling 3.0 偶尔仍会出现小的不一致,比如角色互换、时序停顿或漏说台词。此外,基于点数的定价也可能限制休闲或业余用户的探索空间。

Kling AI 刚刚发布了其 AI 视频模型的 3.0 版本。与 Seedance 2.0 的发布类似,它是对以美国模型为主导的 AI 版图的一次中国回应,而且很可能是当下最好的 AI 视频模型之一。
在本文中,您将学习如何通过 Kling 3.0 的网页界面充分上手,构建角色并制作角色在不同镜头间保持一致的视频。