Curso
Conceitos de IA Generativa
2 h
119K
Se quiser conhecer mais sobre os lançamentos mais recentes nessa área, recomendo conferir nosso guia com outros principais modelos de geração de vídeo.
O Kling AI é uma plataforma de IA generativa desenvolvida para criar vídeos a partir de prompts de texto, imagens ou a combinação dos dois. Criado pela empresa chinesa de tecnologia Kuaishou, ele rapidamente se tornou um dos melhores modelos de IA em consistência de personagens. Os vídeos gerados já vêm com som nativo, o que dá um acabamento mais profissional e pronto para uso.
Como acontece com muitos modelos de vídeo por IA, a cobrança do Kling AI é baseada em créditos. Você paga uma assinatura mensal que dá acesso a um número fixo de créditos por mês. Há também recursos adicionais atrelados a cada plano, mas o principal diferencial continua sendo a quantidade de créditos de geração incluída.
Para escrever este artigo, usei o plano Pro (US$ 32,56 por mês), que oferece 3.000 créditos. Para mais detalhes sobre os planos, consulte a página oficial de preços do Kling AI.
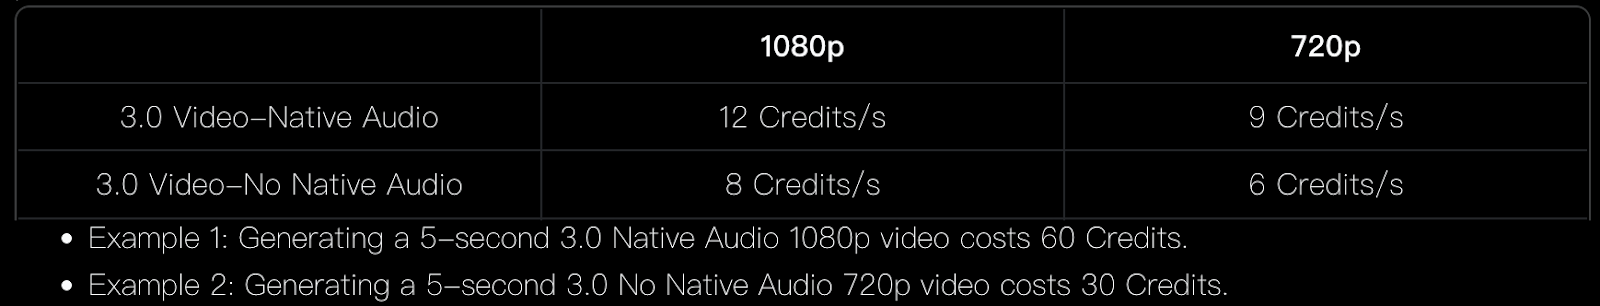
O consumo de créditos depende basicamente de três fatores:
Considerando vídeos com áudio nativo, com a assinatura Pro dá para gerar cerca de 6 minutos de vídeo em 720p ou 4 minutos em 1080p por mês.
Os exemplos desta seção foram retirados do guia oficial do modelo Kling 3.0.
A maioria dos modelos de vídeo por IA funciona melhor quando o prompt descreve um único plano ou ação. O Kling 3.0 consegue entender um prompt que descreve vários planos em um único texto.
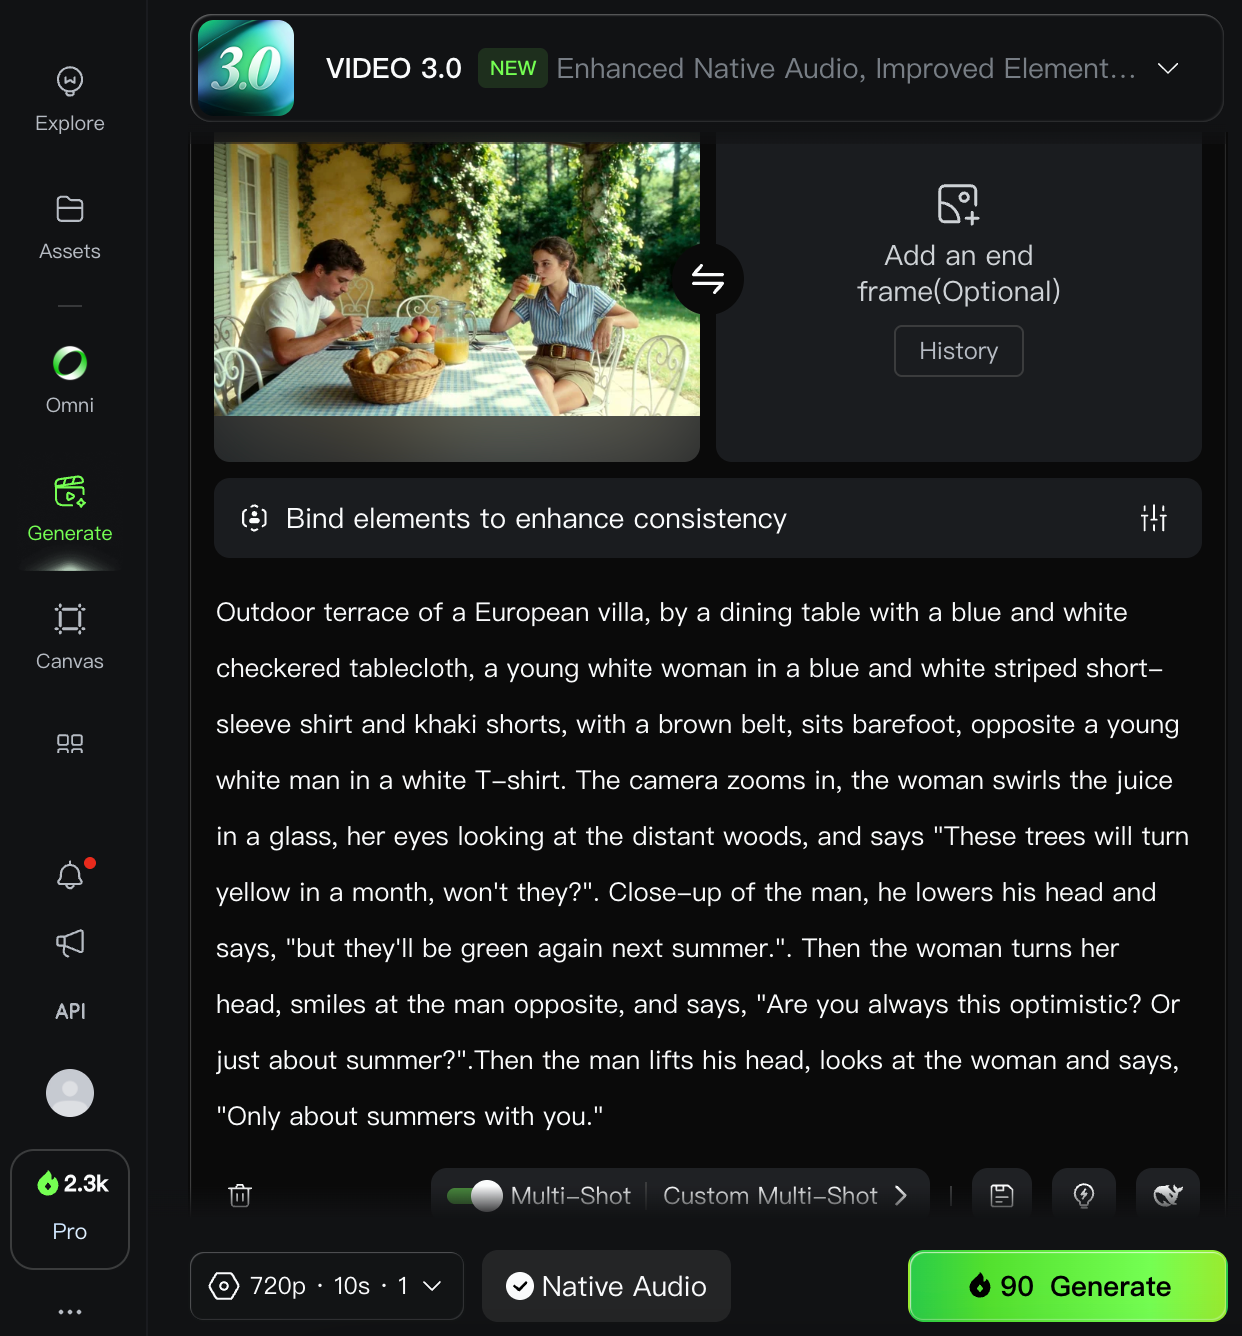
O prompt a seguir descreve o cenário e quatro planos sem listá-los explicitamente:
Outdoor terrace of a European villa, by a dining table with a blue and white checkered tablecloth, a young white woman in a blue and white striped short-sleeve shirt and khaki shorts, with a brown belt, sits barefoot, opposite a young white man in a white T-shirt.
The camera zooms in, the woman swirls the juice in a glass, her eyes looking at the distant woods, and says, "These trees will turn yellow in a month, won't they?"
Close-up of the man, he lowers his head and says, "But they'll be green again next summer."
Then the woman turns her head, smiles at the man opposite, and says, "Are you always this optimistic? Or just about summer?"
Then the man lifts his head, looks at the woman, and says, "Only about summers with you."
O prompt foi combinado com uma imagem, que o modelo usou como primeiro quadro do vídeo.
Veja o resultado:
Fiquei bem impressionado com este vídeo. A aderência ao prompt é ótima e o resultado me pareceu bastante realista.
Embora o modelo consiga entender onde um plano termina e o próximo começa a partir do texto, isso não é perfeito e ele pode interpretar de forma diferente do que imaginamos. Podemos forçar a estrutura da cena mencionando explicitamente os planos no prompt.
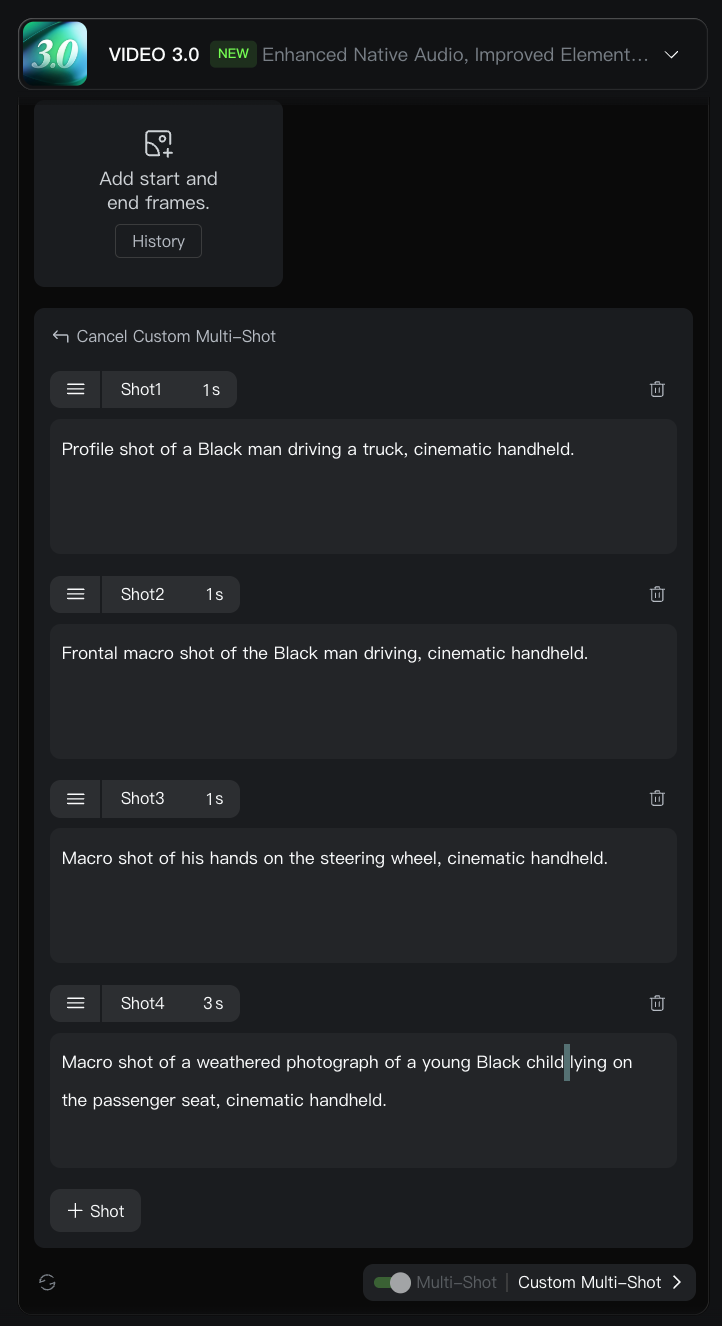
Shot 1: Profile shot of a Black man driving a truck, cinematic handheld.
Shot 2: Frontal macro shot of the Black man driving, cinematic handheld.
Shot 3: Macro shot of his hands on the steering wheel, cinematic handheld.
Shot 4: Macro shot of a weathered photograph of a young Black child lying on the passenger seat, cinematic handheld.
Para detalhar cada plano, clique no botão Custom Multi-Shot na parte inferior do campo de prompt. Ali, dá para escrever um prompt para cada plano e também definir a duração. O modelo permite até 6 planos por vídeo.
Abaixo está o resultado desse prompt multi-shots:
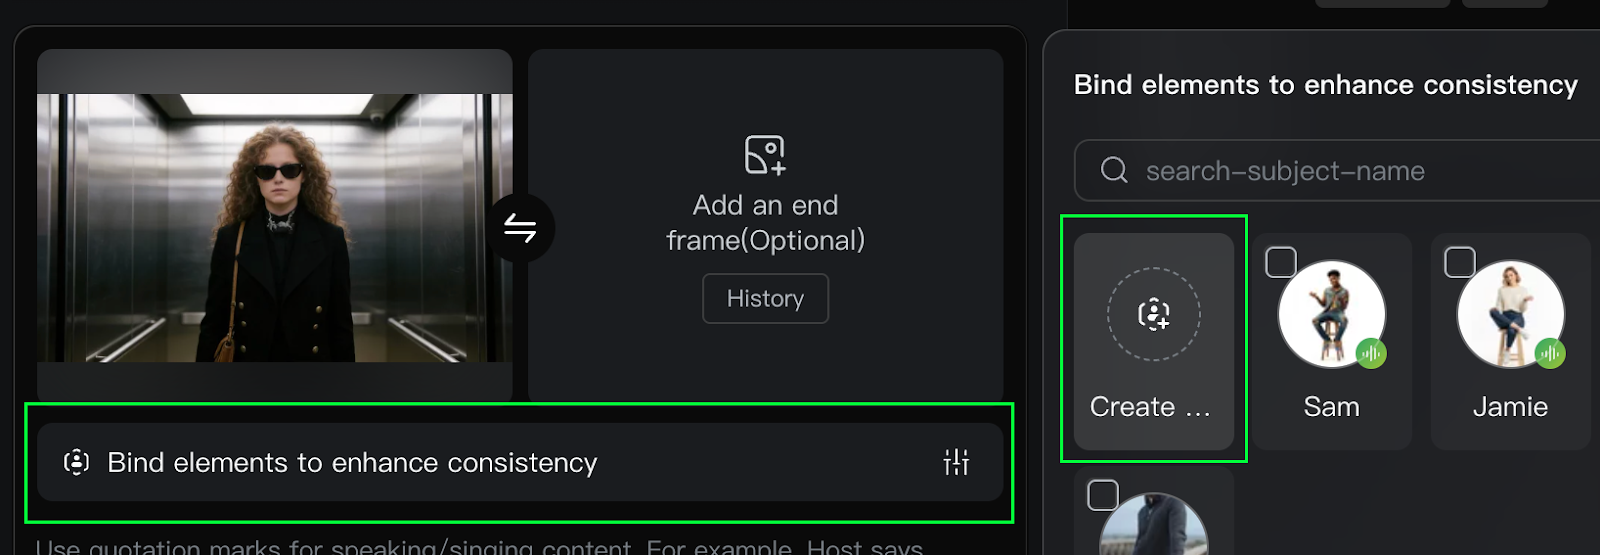
A vinculação de sujeito é um recurso que mantém personagens ou elementos visuais específicos consistentes ao longo de todo o vídeo gerado. Fixar a aparência e as características de um sujeito ajuda a garantir que o foco principal permaneça estável e reconhecível, mesmo com movimentos de câmera como zoom, pan e tilt.
Depois de enviar uma imagem como quadro inicial, dá para ativar esse recurso selecionando a opção Bind elements to enhance Consistency. Ela cria uma referência que o sistema usa para manter a estabilidade visual e evitar mudanças indesejadas no sujeito durante a geração.
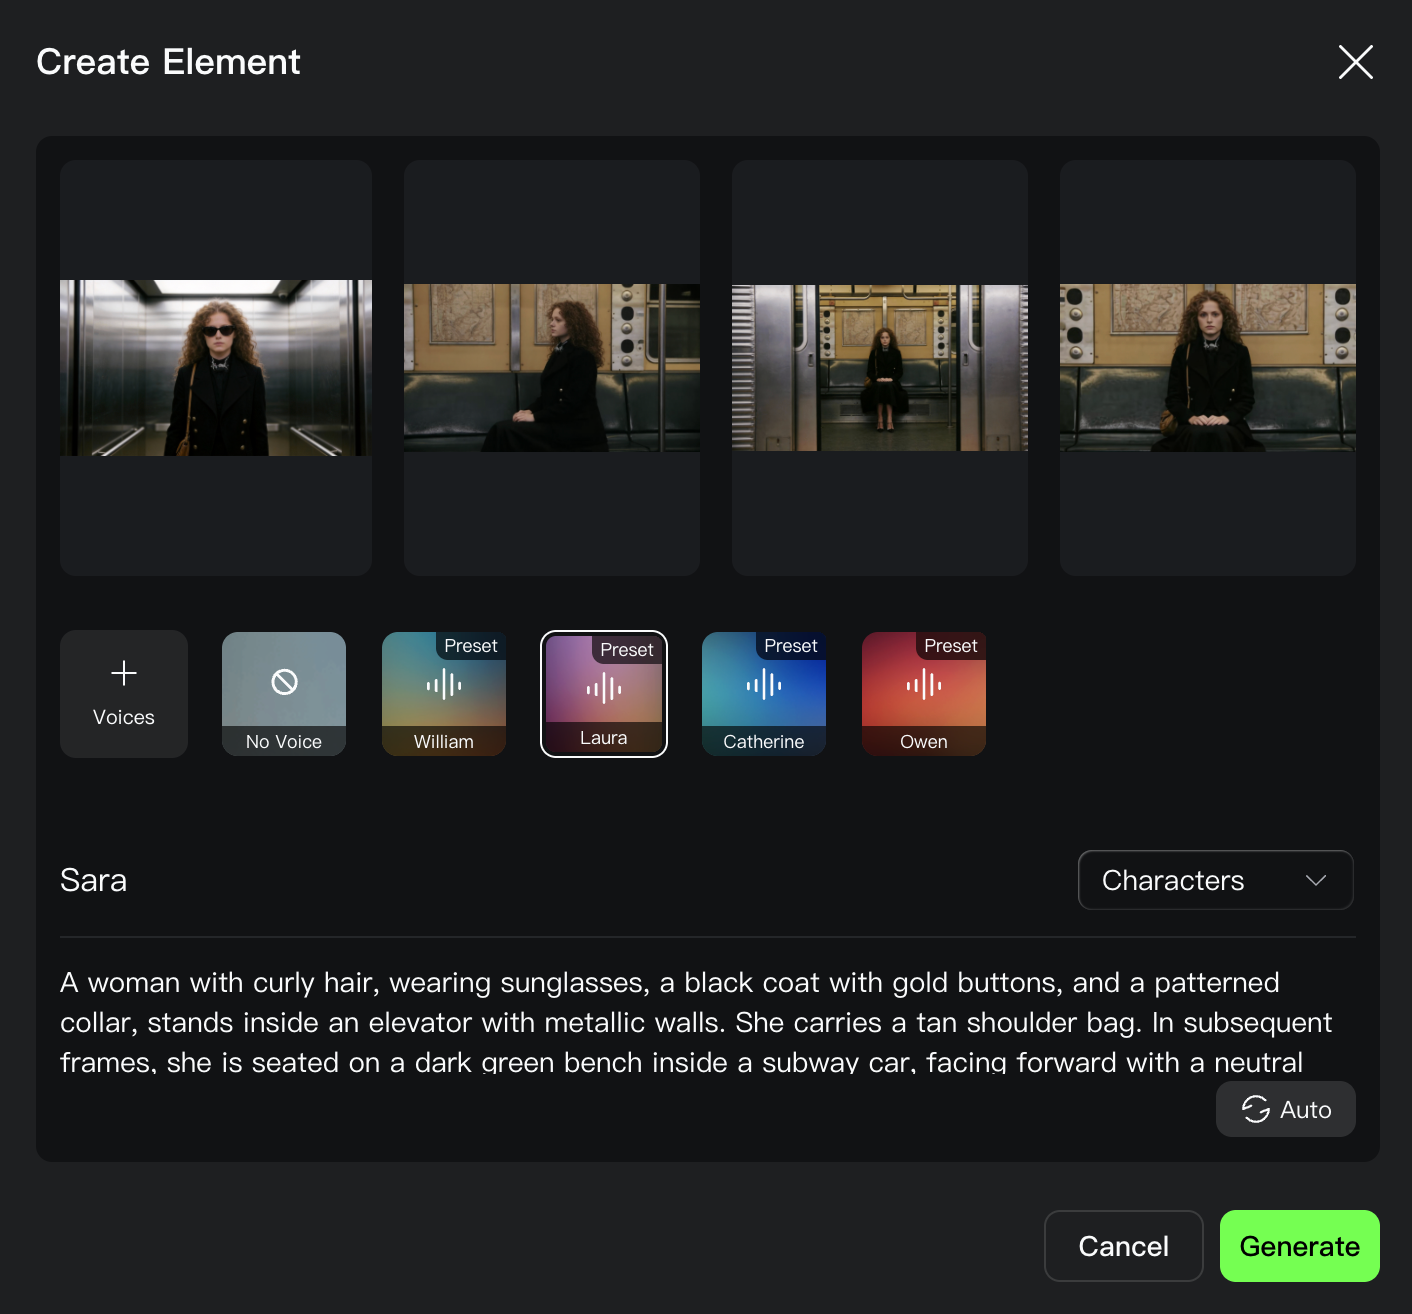
Sem a vinculação de sujeito, o modelo precisa adivinhar traços que não aparecem na imagem inicial. No exemplo acima, a personagem usa óculos escuros. Por isso, seria útil fornecer uma imagem do rosto. Outras poses, como olhando para a esquerda e para a direita, também ajudam se quisermos que o modelo "não invente" a aparência da pessoa.
Ao criar um elemento, é possível enviar até três imagens. Também dá para escolher uma voz e um nome para o personagem.
Veja o resultado:
Pessoalmente, considero esses recursos um divisor de águas, porque a consistência de personagens era um dos aspectos mais frustrantes da geração de vídeos por IA. Muitas vezes exigia prompts de texto superdetalhados e várias iterações até acertar.
O modo Omni do Kling AI reúne todos os recursos em um único modelo. Pense nele como uma versão turbinada da vinculação de sujeito: você cria elementos (personagens, cenários, itens etc.) e depois junta tudo em um único prompt. Isso permite gerar cenas bem complexas com alto nível de fidelidade.
Por exemplo, você pode criar um elemento de personagem fornecendo imagens de referência e depois um elemento de cena, posicionando facilmente o personagem nesse cenário. Também dá para criar vários personagens e desenvolver diálogos entre eles referenciando esses elementos no prompt.
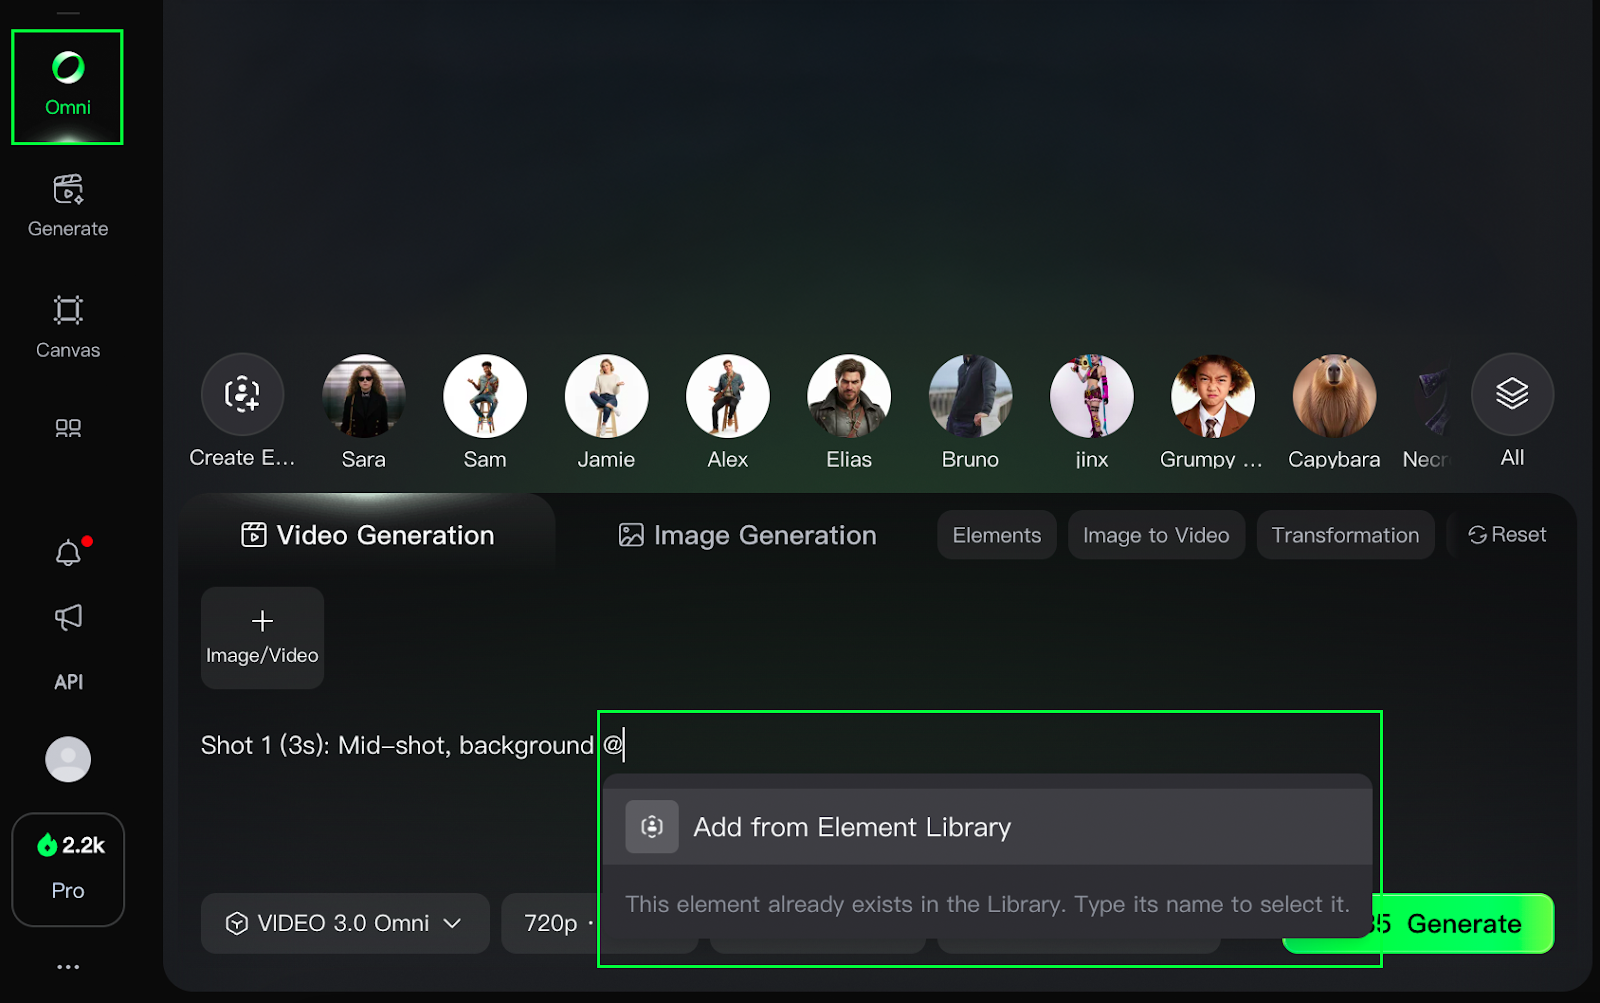
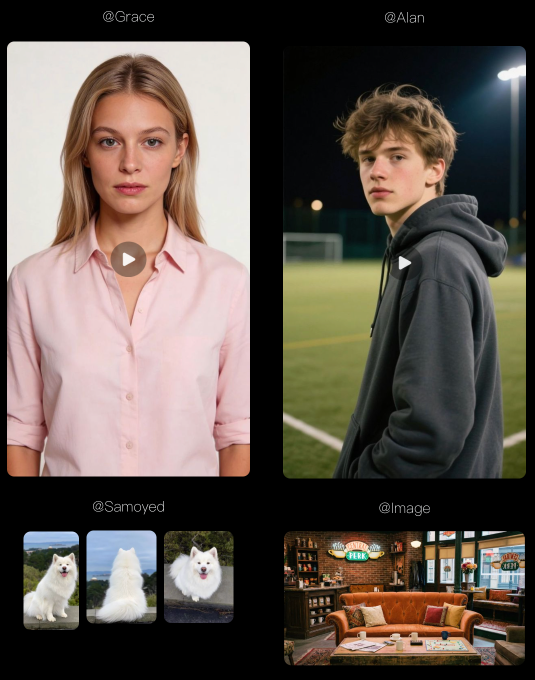
No modo Omni, é possível referenciar elementos já criados usando @. Isso abre um pop-up para selecionar o elemento desejado.
Aqui vai um exemplo de três planos mostrando a força e a versatilidade do Omni:
Shot 1 (3s): Mid-shot, background @Image. @Grace sits on the sofa eating cookies as @Alan walks in holding @Samoyed.@Samoyed lunges for the cookie in @Grace's hand. @Grace says, "Hey! Watch your dog!"
Shot 2 (2s): @Alan sits beside her, pulling the leash and lifting @Samoyed. Close-up, @Alan says, "He just likes cookies more than me."
Shot 3 (3s): Close-up, @Grace smiles and says, "Well, he has good taste at least."
Neste exemplo, @Image, @Grace, @Alan e @Samoyed são elementos criados separadamente e usados juntos em um único prompt.
Na seção anterior, conhecemos os recursos principais do Kling 3.0 e vimos alguns exemplos do site oficial. Os resultados são muito impressionantes, mas é bom manter um pé atrás com exemplos fornecidos pelas empresas, já que costumam ser curados, destacando só os melhores casos.
Agora, vamos colocar a mão na massa e testá-lo com novos exemplos para ver se o modelo realmente entrega o que promete.
Usei IA para criar um personagem de fantasia. Gerei uma imagem de corpo inteiro e depois algumas poses diferentes, como olhando para a esquerda, para a direita e com expressão de raiva.
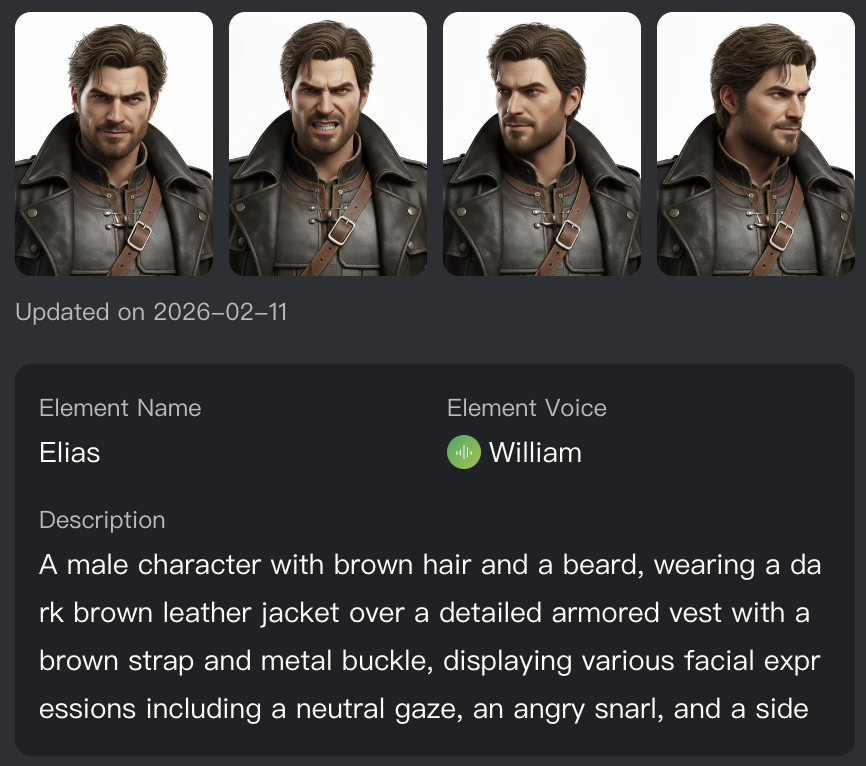
Combinei esses elementos para criar um personagem chamado Elias. Depois gerei uma imagem para o primeiro quadro do vídeo e usei a vinculação de sujeito para conectá-los.
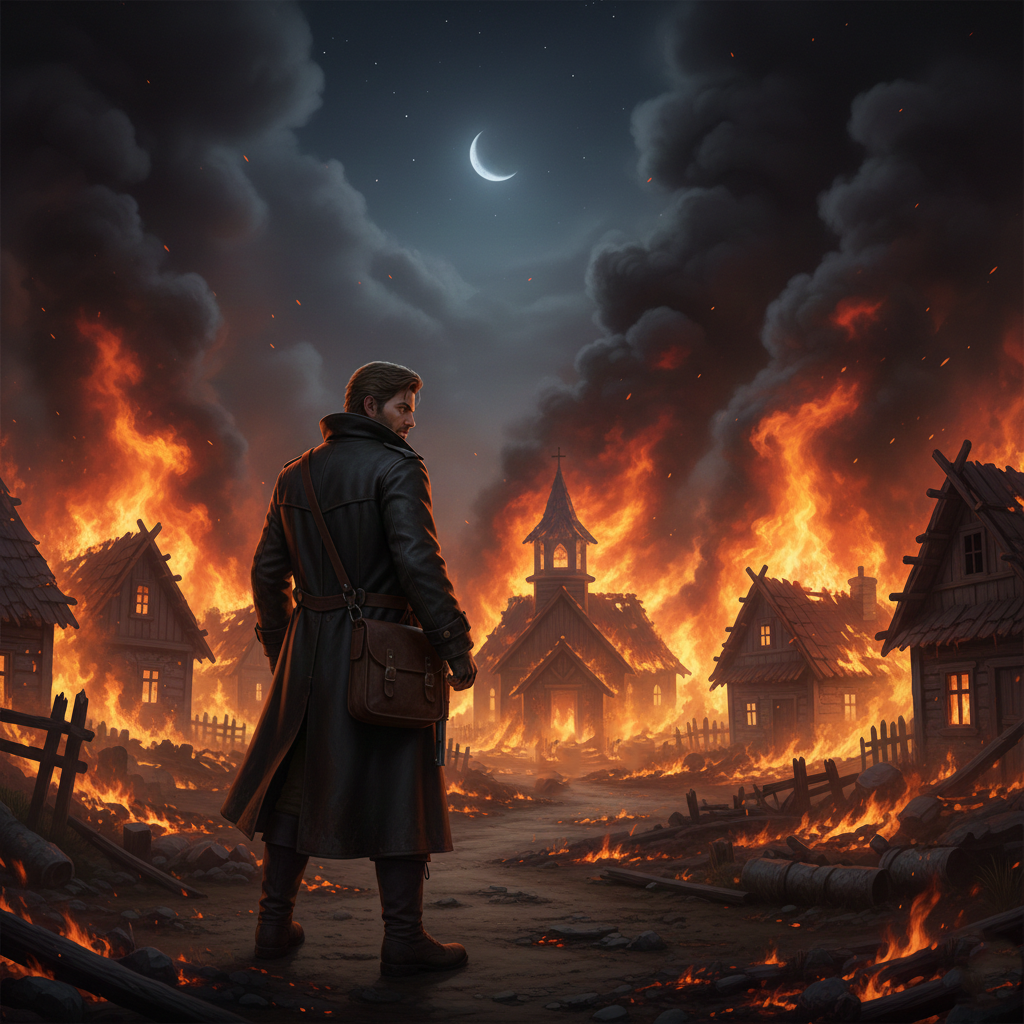
Este foi o prompt que usei:
Elias stands alone in front of the burning village. Elias is breathing heavily, his hands clenched into tight fists at his sides.
Elias looks at something just off-camera, something we cannot see. Elias says, in a low and dangerous voice, "I told you what would happen if you crossed that line."
Elias pauses for a second.
The camera zooms in close to his face. His face burns with anger, and he says, "I gave you my word, and I gave you a choice."
Perceba que não usei referências com @ porque não utilizei o modo Omni neste vídeo, apenas a vinculação de sujeito. Aqui está o resultado
Aqui, tentei criar uma cena de sitcom entre amigos. Criei três personagens — Alex, Jamie e Sam — usando IA. Como antes, gerei algumas poses diferentes para cada um.
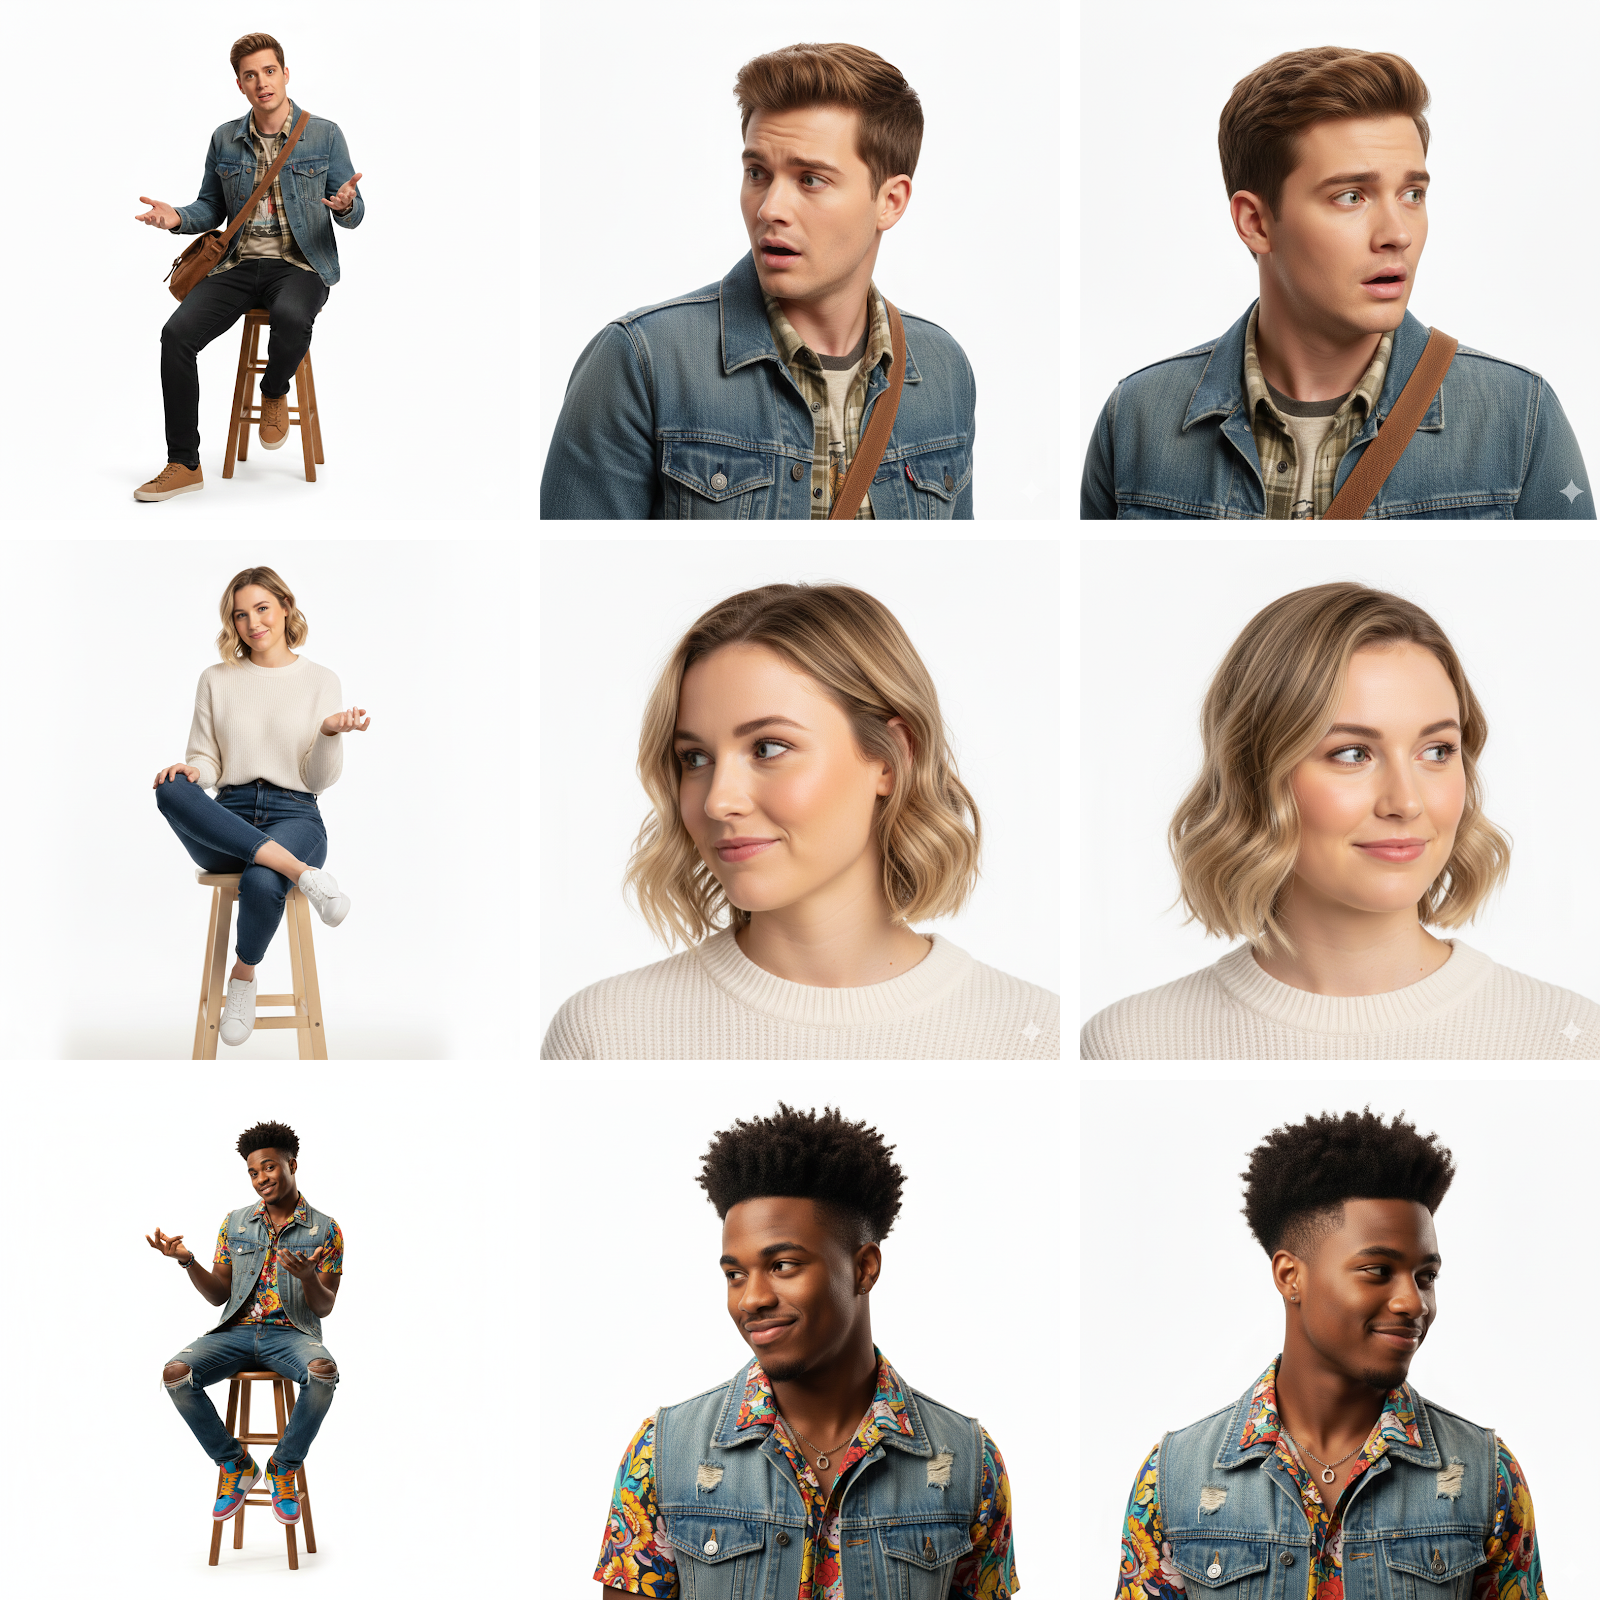
Também gerei uma imagem do local e criei um elemento de cena com ela.
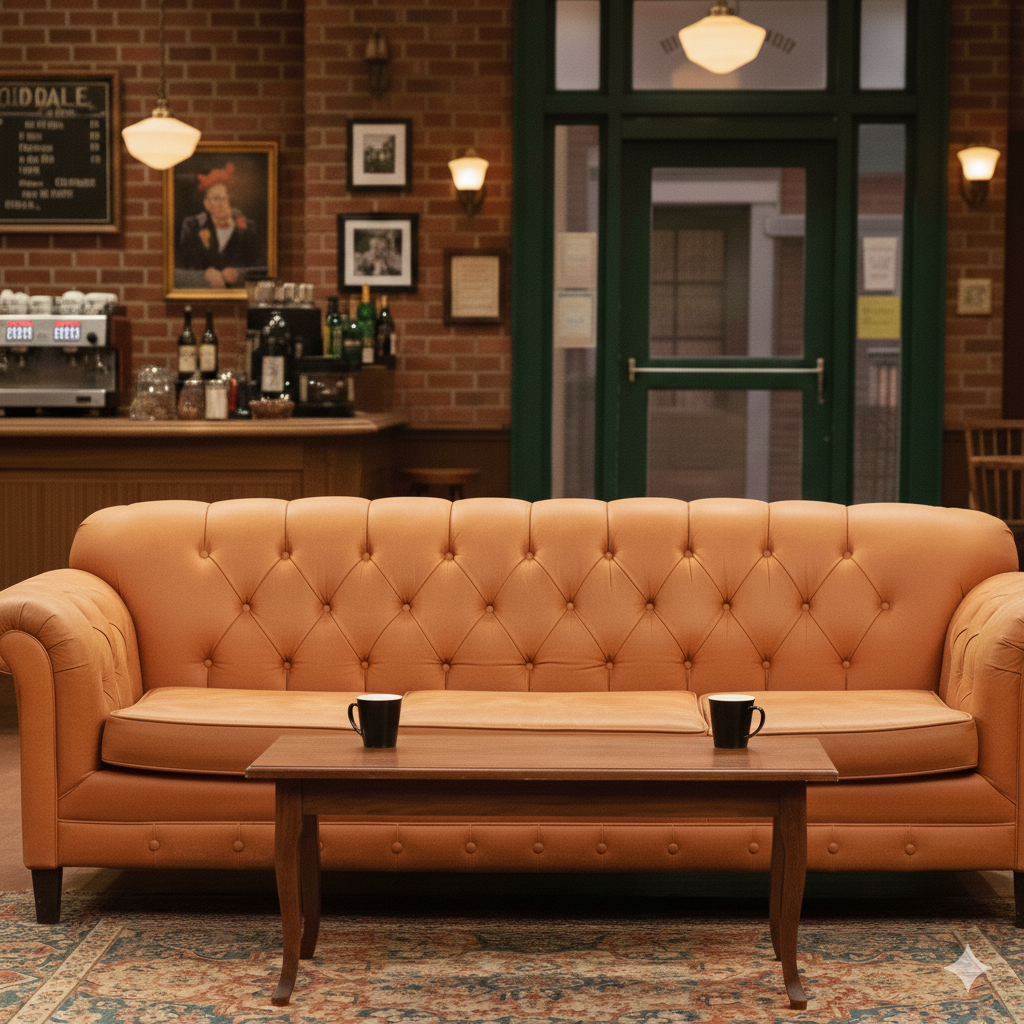
Este foi o prompt final que usei. Optei por descrever os planos em um único prompt de texto em vez da funcionalidade multi-shots, pois ela limita a seis planos. E o Kling 3.0 deu conta muito bem desse formato.
Shot 1: Mid-shot, background @Image.
Shot 2: @Jamie and @Sam sit on the couch as @Alex rushes into the coffee shop and says, "I just liked my ex’s photo from 2016."
Shot 3: @Jamie turns to @Alex and says, "How bad?"
Shot 4: @Alex replies, "She’s with the guy she left me for."
Shot 5: Camera focuses on @Sam, and he replies, "Delete it, dude!"
Shot 6: @Alex replies, "I did, but what if she saw?"
Shot 7: @Sam says, "Then act confident, like her wedding photo."
Shot 8: @Jamie laughs, and @Alex says, "I need new friends..."
E este foi o resultado:
Dá para notar alguns deslizes no vídeo:
Apesar disso, achei o resultado muito bom. Os personagens parecem vivos e autênticos, e a cena flui bem no geral.
Neste último exemplo, tentei reutilizar os personagens criados em outro contexto. A ideia era entender o quão consistentes eles permanecem entre vídeos para ver se é viável criar várias cenas com os mesmos personagens. Se a aparência e a essência se mantiverem, acredito que o Kling 3.0 pode ser usado para conteúdos de maior duração.
Aqui, usei a funcionalidade multi-shots para descrever cada plano. Veja a configuração da cena:
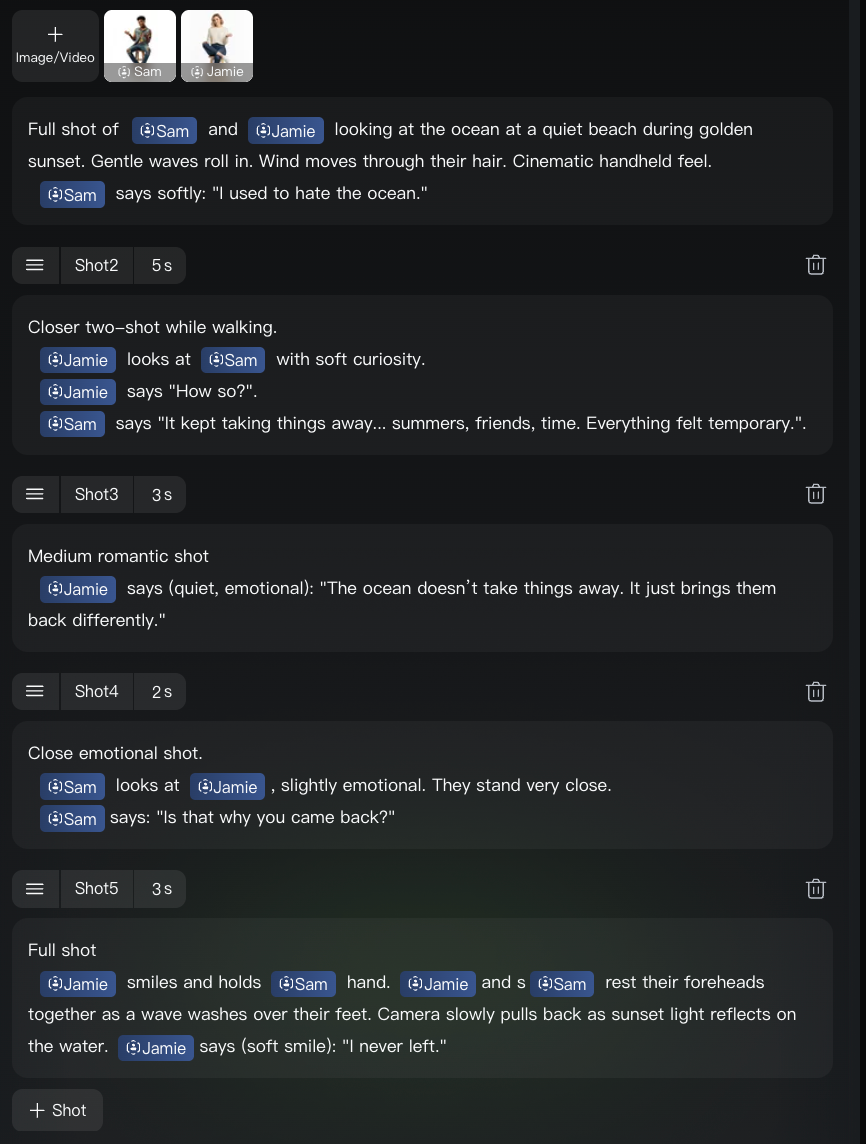
Este foi o vídeo gerado:
Cursos de IA generativa
Curso
Curso
Curso
blog
Dr Ana Rojo-Echeburúa
9 min
blog
Adel Nehme
15 min
blog
Richie Cotton
Tutorial
Kurtis Pykes
12 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Moez Ali
11 min