Last chance! 50% off DataCamp Premium
Sale ends in
Jika Anda ingin mempelajari lebih lanjut tentang rilis terbaru di ranah ini, saya sarankan membaca panduan kami tentang model generasi video terbaik lainnya.
Kling AI adalah platform AI generatif yang dirancang untuk membuat video dari prompt teks, gambar, atau gabungan keduanya. Dikembangkan oleh perusahaan teknologi Tiongkok Kuaishou, platform ini dengan cepat menjadi salah satu model AI terbaik untuk konsistensi karakter. Video yang dihasilkannya hadir dengan suara native, sehingga terasa rapi dan siap pakai.
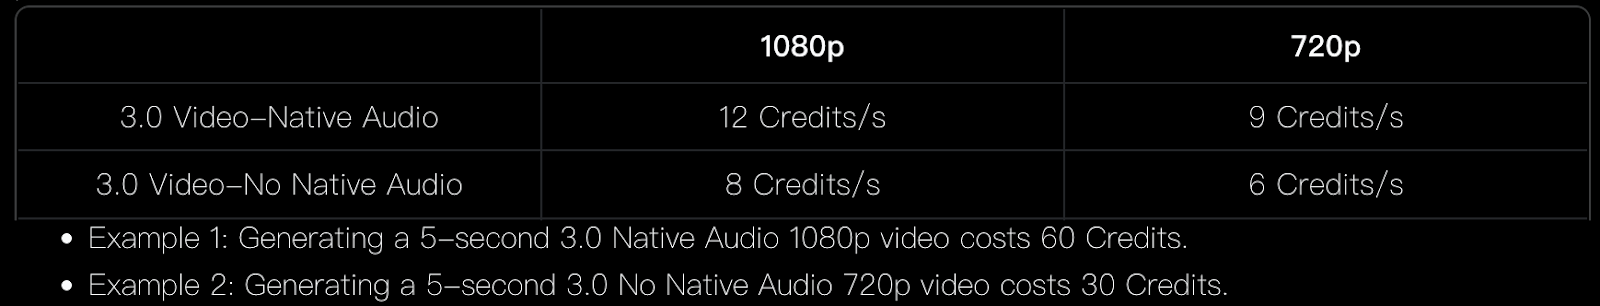
Seperti banyak model video AI lainnya, harga Kling AI berbasis kredit. Kami membayar langganan bulanan yang memberi akses ke jumlah kredit bulanan tetap. Ada juga fitur kecil lain yang terkunci di tiap tingkat langganan, tetapi pembedanya yang utama tetap jumlah kredit generasi yang diberikan.
Untuk menulis artikel ini, saya menggunakan paket Pro mereka (US$32,56 per bulan) yang mencakup 3.000 kredit. Untuk more detail tentang paket harga mereka, lihat halaman harga resmi Kling AI.
Penggunaan kredit terutama ditentukan oleh tiga faktor:
Dengan asumsi kita membuat video dengan audio native, dengan langganan Pro, kita bisa mengharapkan sekitar 6 menit video 720p atau 4 menit video 1080p per bulan.
Contoh dalam bagian ini diambil dari panduan pengguna resmi model Kling 3.0.
Sebagian besar model video AI bekerja paling baik saat prompt menggambarkan satu shot atau aksi. Kling 3.0 mampu memahami prompt yang menjabarkan beberapa shot dalam satu prompt.
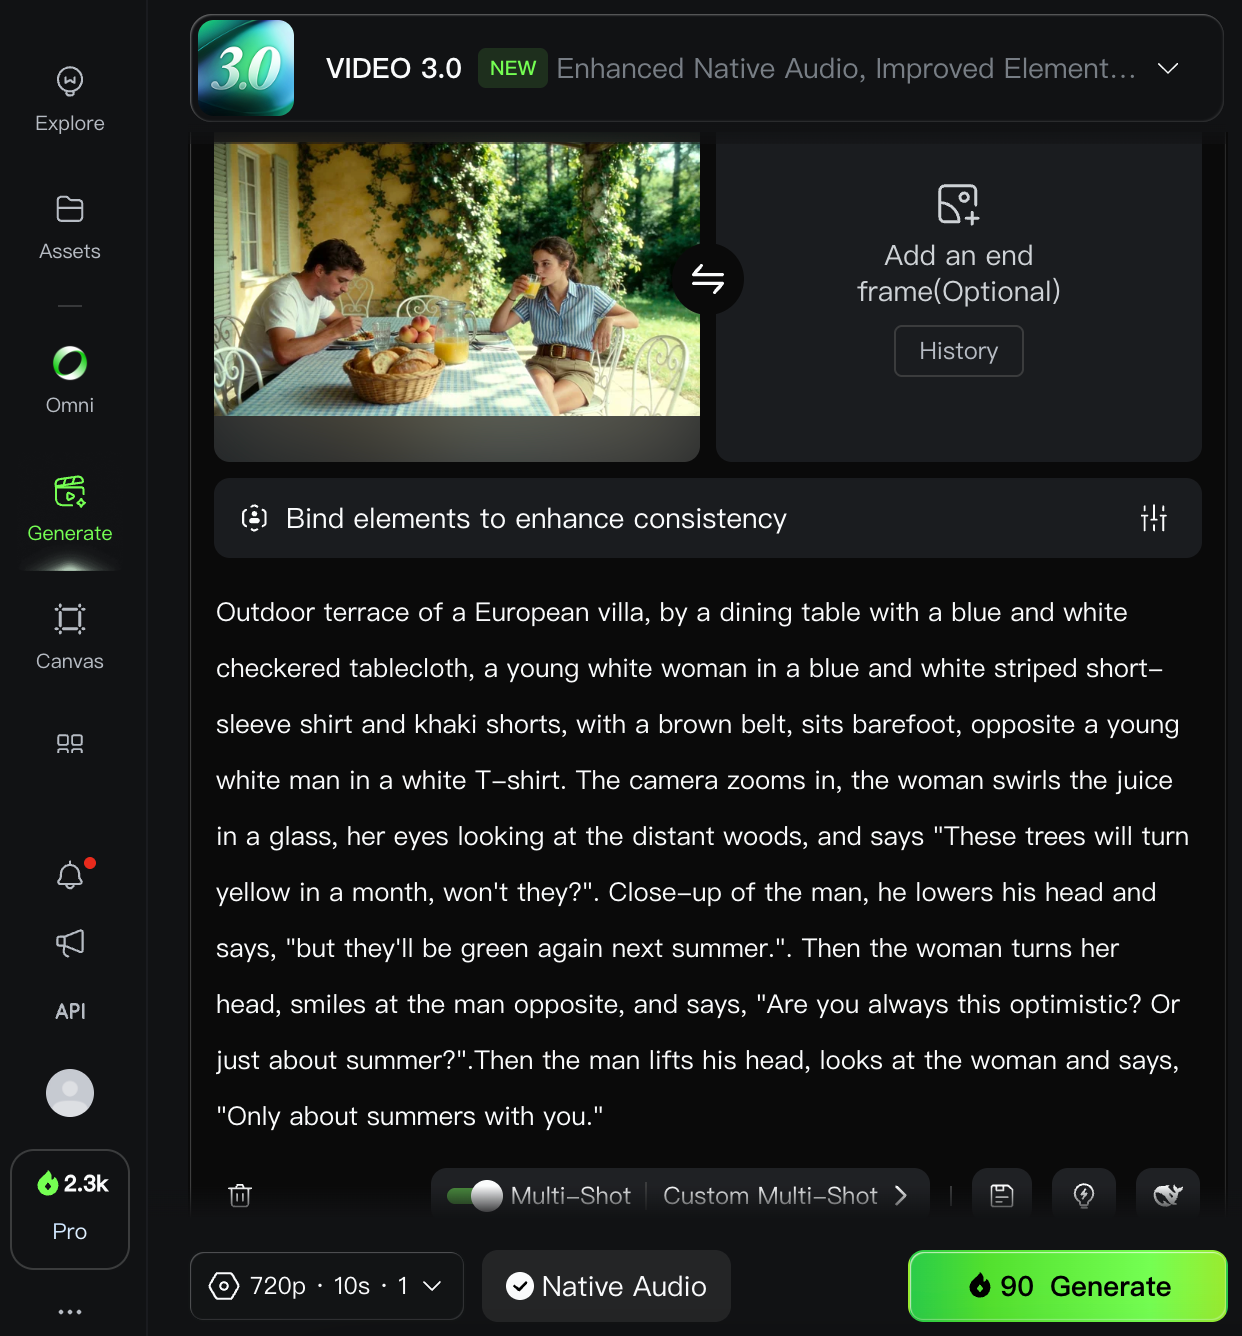
Contoh prompt berikut menggambarkan latar video dan empat shot tanpa menyebutkannya secara eksplisit:
Outdoor terrace of a European villa, by a dining table with a blue and white checkered tablecloth, a young white woman in a blue and white striped short-sleeve shirt and khaki shorts, with a brown belt, sits barefoot, opposite a young white man in a white T-shirt.
The camera zooms in, the woman swirls the juice in a glass, her eyes looking at the distant woods, and says, "These trees will turn yellow in a month, won't they?"
Close-up of the man, he lowers his head and says, "But they'll be green again next summer."
Then the woman turns her head, smiles at the man opposite, and says, "Are you always this optimistic? Or just about summer?"
Then the man lifts his head, looks at the woman, and says, "Only about summers with you."
Prompt dipasangkan dengan sebuah gambar, yang digunakan model sebagai frame pertama video.
Berikut hasilnya:
Saya sangat terkesan dengan video ini. Kepatuhan terhadap prompt kuat, dan videonya terlihat cukup realistis bagi saya.
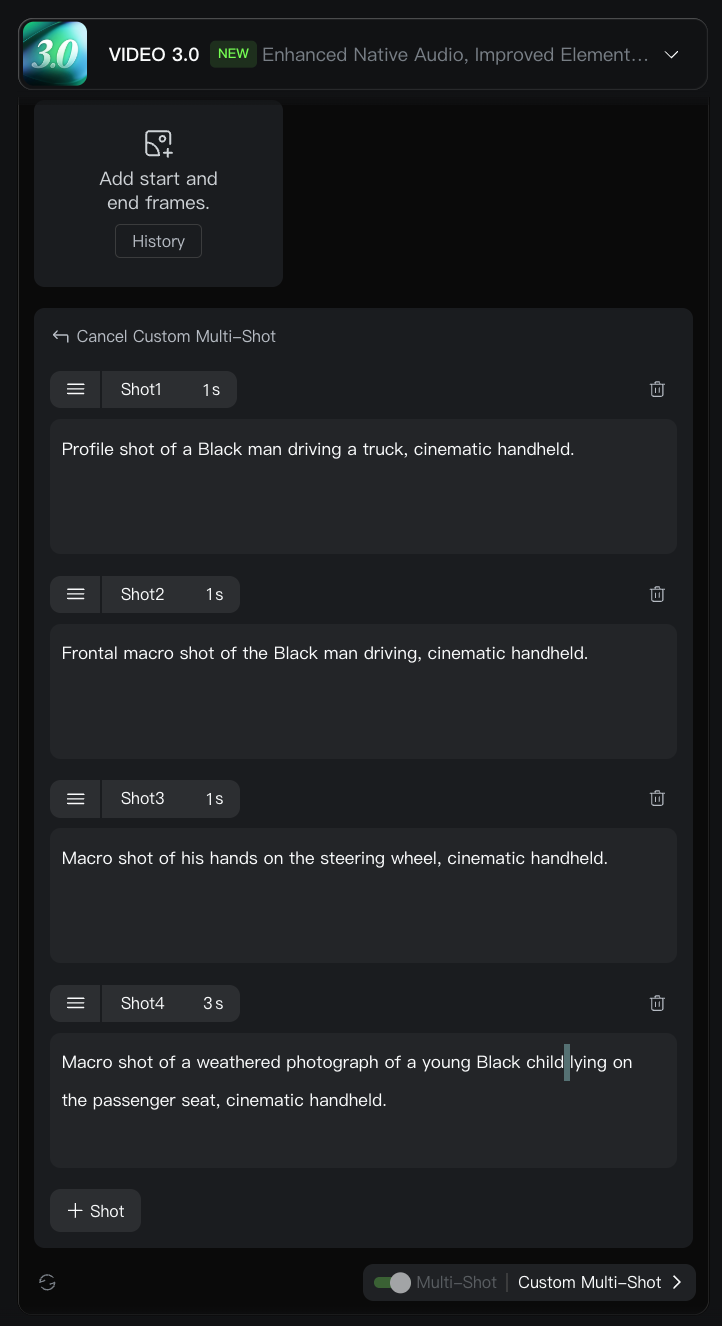
Meskipun model mampu memahami di mana satu shot berakhir dan shot berikutnya dimulai dari prompt teks, ini tidak sempurna dan bisa menafsirkan prompt berbeda dari yang kita maksud. Kita bisa memaksa struktur adegan dengan menyebutkan shot secara eksplisit di prompt.
Shot 1: Profile shot of a Black man driving a truck, cinematic handheld.
Shot 2: Frontal macro shot of the Black man driving, cinematic handheld.
Shot 3: Macro shot of his hands on the steering wheel, cinematic handheld.
Shot 4: Macro shot of a weathered photograph of a young Black child lying on the passenger seat, cinematic handheld.
Untuk menentukan tiap shot, kita klik tombol Custom Multi-Shot di bagian bawah input prompt. Di sana, kita bisa memberikan prompt untuk tiap shot dan juga mengatur durasinya. Model mengizinkan hingga 6 shot per video.
Berikut ini hasil dari prompt multi-shot tersebut:
Subject binding adalah fitur yang memungkinkan karakter atau elemen visual tertentu tetap konsisten sepanjang video yang dihasilkan. Mengunci tampilan dan karakteristik subjek membantu memastikan fokus utama tetap stabil dan mudah dikenali, bahkan saat terjadi pergerakan kamera seperti zoom, panning, atau tilting.
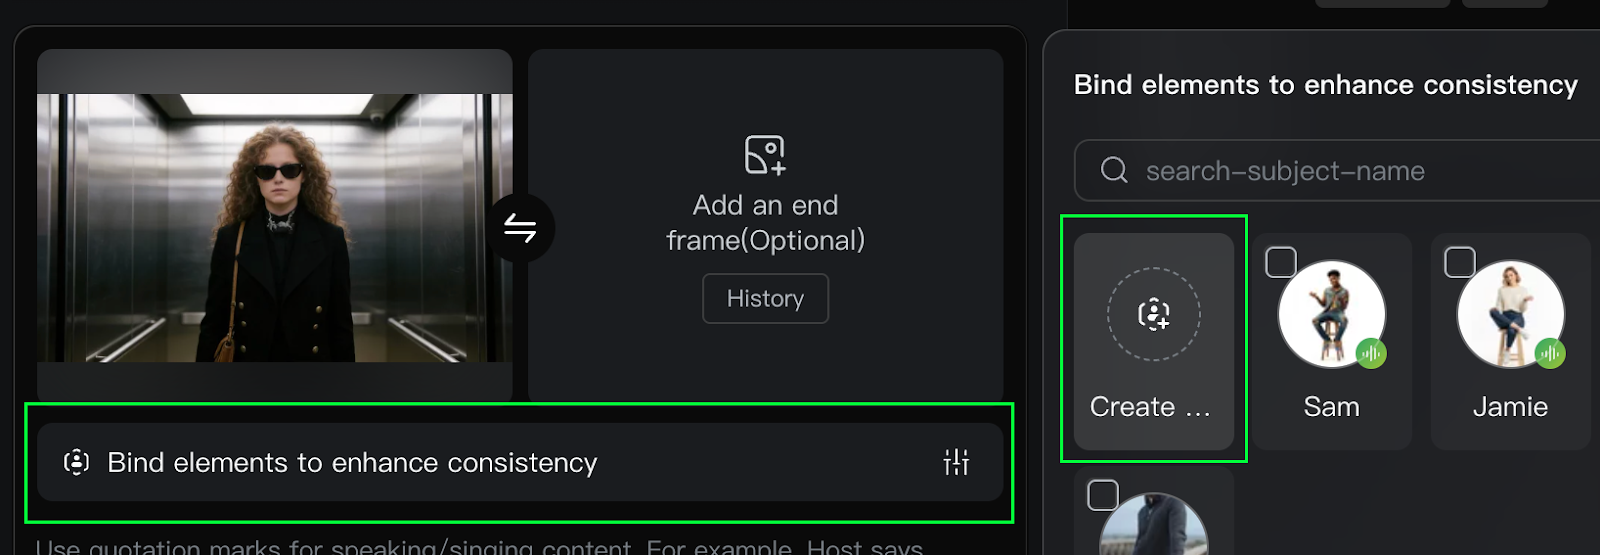
Setelah mengunggah gambar sebagai frame awal, kita dapat mengaktifkan fitur ini dengan memilih opsi Bind elements to enhance Consistency. Ini membuat referensi yang digunakan sistem untuk menjaga stabilitas visual dan mencegah perubahan yang tidak diinginkan pada subjek selama pembuatan video.
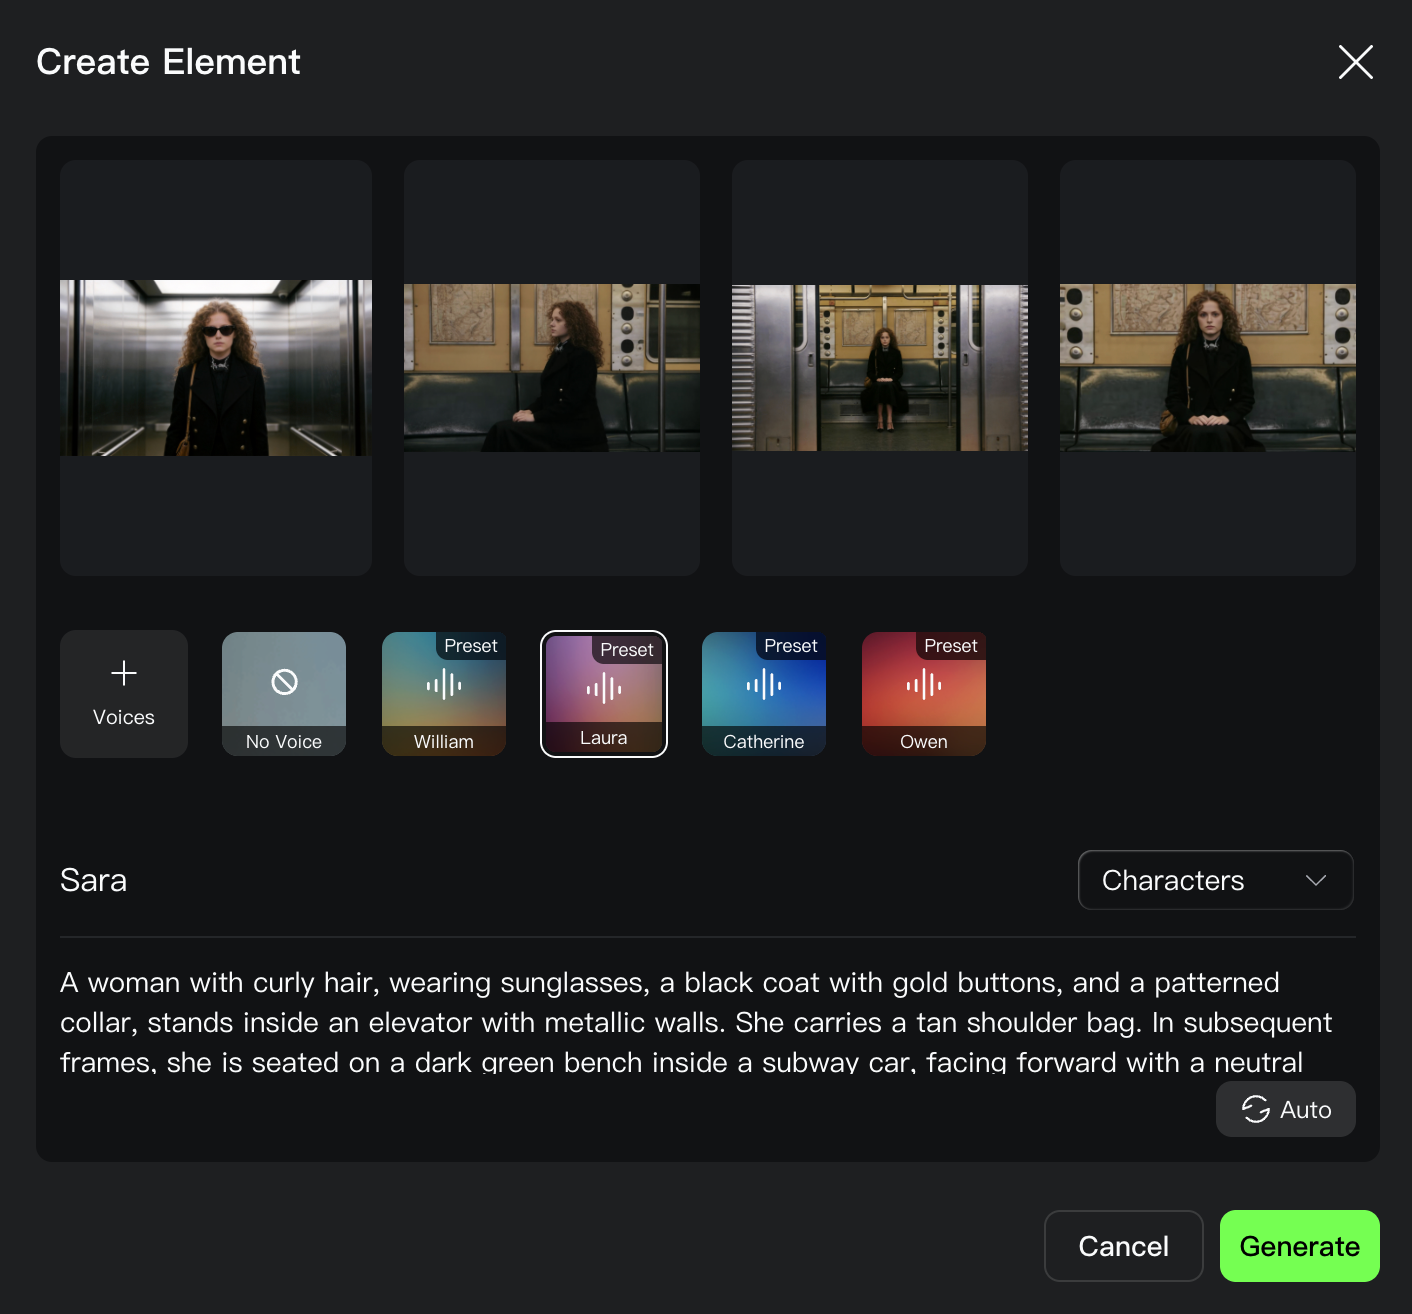
Tanpa subject binding, model harus menebak fitur subjek yang tidak terlihat pada gambar awal. Misalnya, pada gambar di atas, subjek memakai kacamata hitam. Jadi, akan berguna untuk menyediakan gambar wajah subjek. Memberikan pose lain, seperti subjek menoleh ke kiri dan ke kanan, juga berguna jika kita ingin model "tidak mengarang" seperti apa orang tersebut.
Saat membuat sebuah elemen, kita bisa memberikan hingga tiga gambar. Kita juga diberi opsi memilih suara dan nama untuk karakter.
Berikut hasilnya:
Secara pribadi, saya merasa fitur-fitur ini adalah pengubah permainan karena konsistensi karakter adalah salah satu aspek pembuatan video AI yang paling membuat saya frustrasi. Seringkali membutuhkan prompt teks yang sangat rinci dan iterasi berulang agar berhasil.
Mode Omni dari Kling AI menyatukan semua fitur dalam satu model. Kita dapat menganggapnya sebagai subject binding yang ditingkatkan, karena memungkinkan kita membuat elemen (karakter, adegan, item, dll.) lalu menggabungkannya ke dalam satu prompt. Ini memungkinkan pembuatan adegan yang sangat kompleks dengan tingkat akurasi tinggi.
Sebagai contoh, kita bisa membuat elemen karakter dengan menyediakan gambar referensi lalu elemen adegan, dan dengan mudah menempatkan karakter tersebut dalam adegan itu. Contoh lain, kita bisa membuat beberapa karakter dan mengembangkan dialog bolak-balik di antara mereka dengan merujuk karakter-karakter ini di prompt.
Saat menggunakan mode Omni, kita dapat merujuk elemen yang sebelumnya dibuat menggunakan @. Ini akan membuka pop-up tempat kita dapat memilih elemen yang ingin dirujuk.
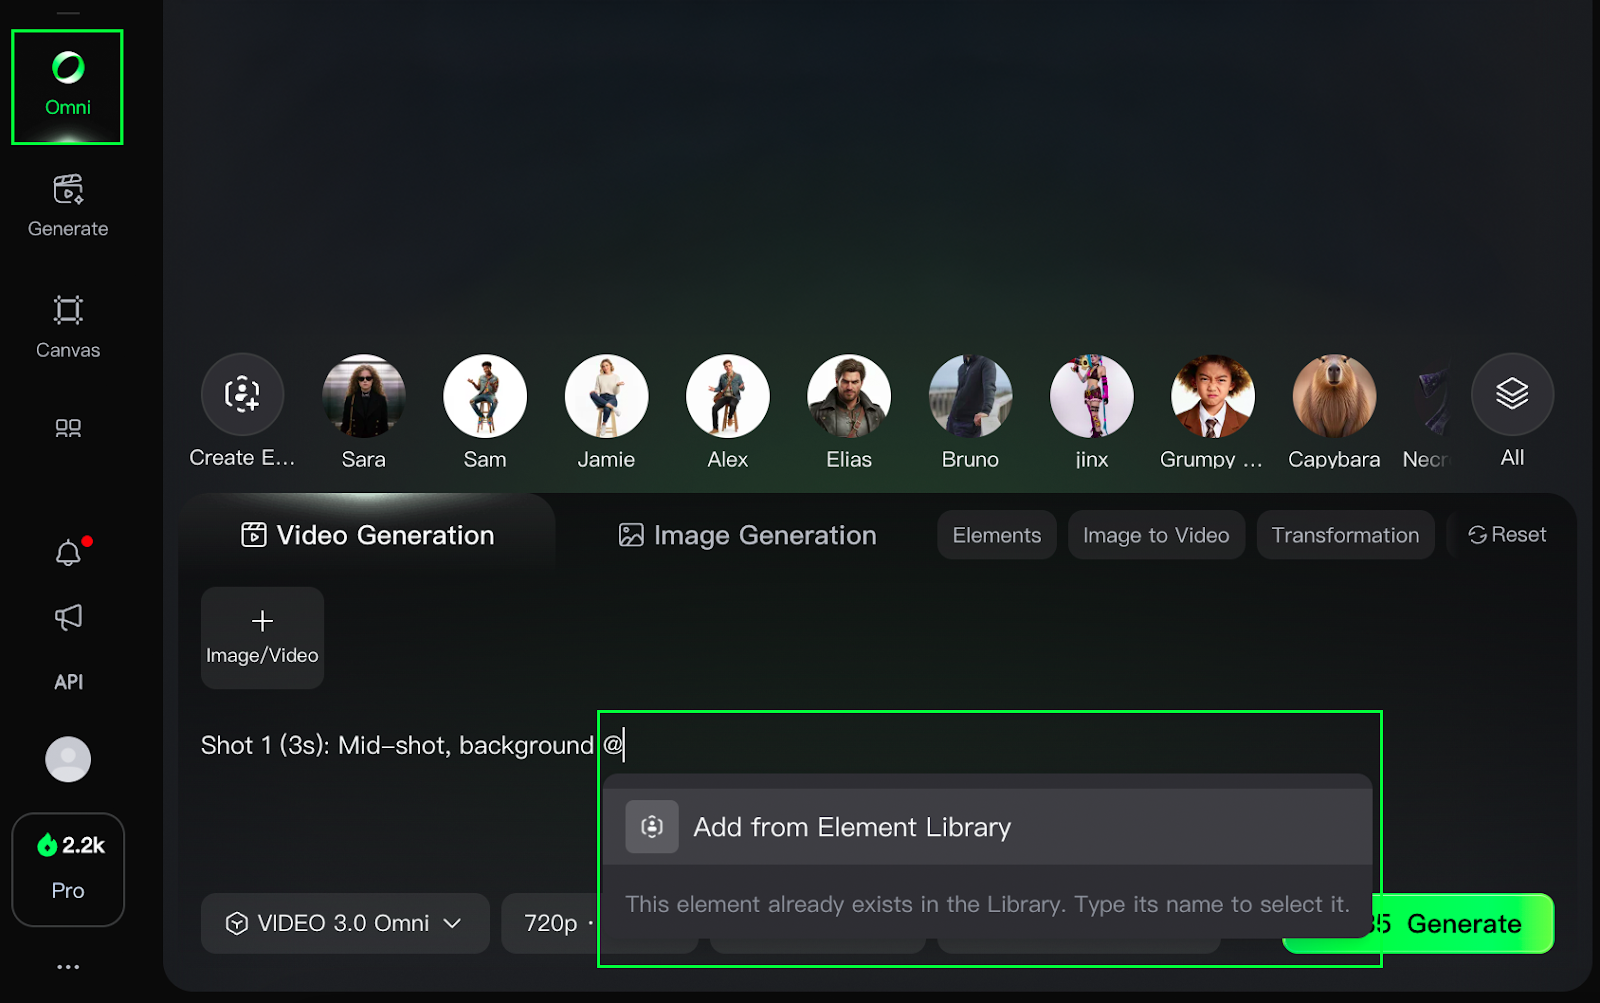
Berikut contoh tiga shot yang menunjukkan kekuatan dan fleksibilitas Omni:
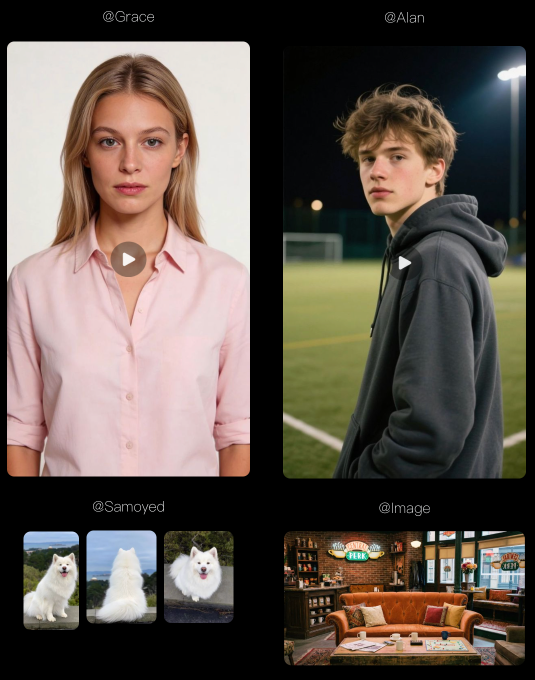
Shot 1 (3s): Mid-shot, background @Image. @Grace sits on the sofa eating cookies as @Alan walks in holding @Samoyed.@Samoyed lunges for the cookie in @Grace's hand. @Grace says, "Hey! Watch your dog!"
Shot 2 (2s): @Alan sits beside her, pulling the leash and lifting @Samoyed. Close-up, @Alan says, "He just likes cookies more than me."
Shot 3 (3s): Close-up, @Grace smiles and says, "Well, he has good taste at least."
Dalam contoh ini, @Image, @Grace, @Alan, dan @Samoyed adalah elemen yang dibuat terpisah dan digunakan bersama dalam satu prompt.
Pada bagian sebelumnya, kita mempelajari kemampuan inti Kling 3.0 dan menampilkan beberapa contoh yang diambil dari situs resmi mereka. Saya pikir hasilnya sangat mengesankan, tetapi kita tetap harus skeptis terhadap contoh yang disediakan perusahaan, karena biasanya kurasi, hanya memilih contoh terbaik.
Di bagian ini, kita mencobanya langsung dan mengujinya pada contoh baru untuk melihat apakah model benar-benar memenuhi ekspektasi.
Saya menggunakan AI untuk membuat karakter fantasi. Saya membuat gambar seluruh badan lalu beberapa pose berbeda, seperti menoleh ke kiri, menoleh ke kanan, dan dengan ekspresi marah.
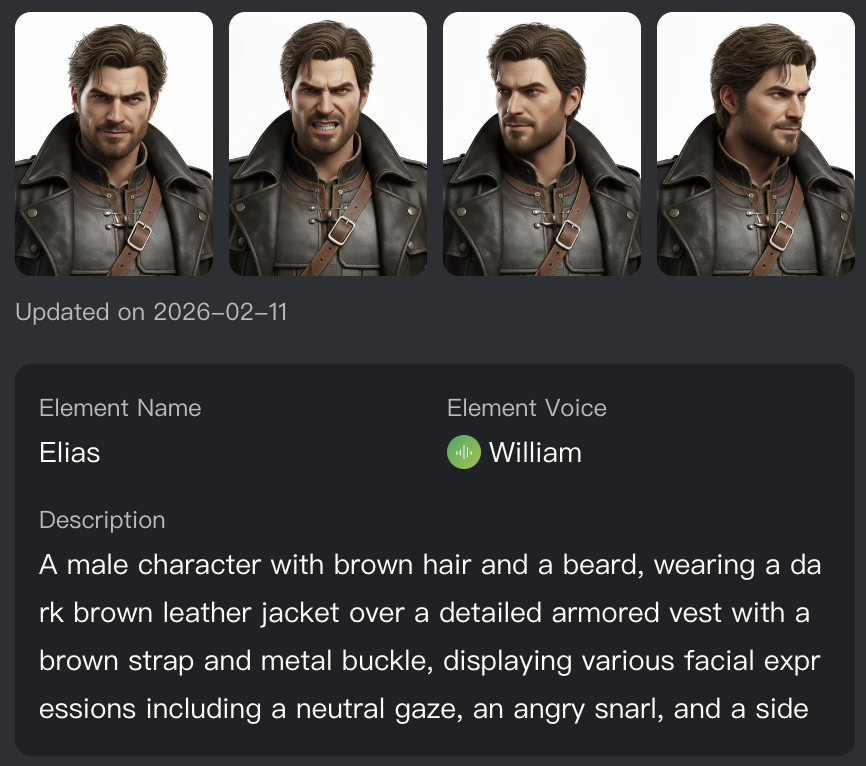
Saya menggabungkan elemen-elemen itu untuk membuat karakter bernama Elias. Lalu saya membuat gambar untuk frame pertama video dan menggunakan subject binding untuk mengaitkan keduanya.
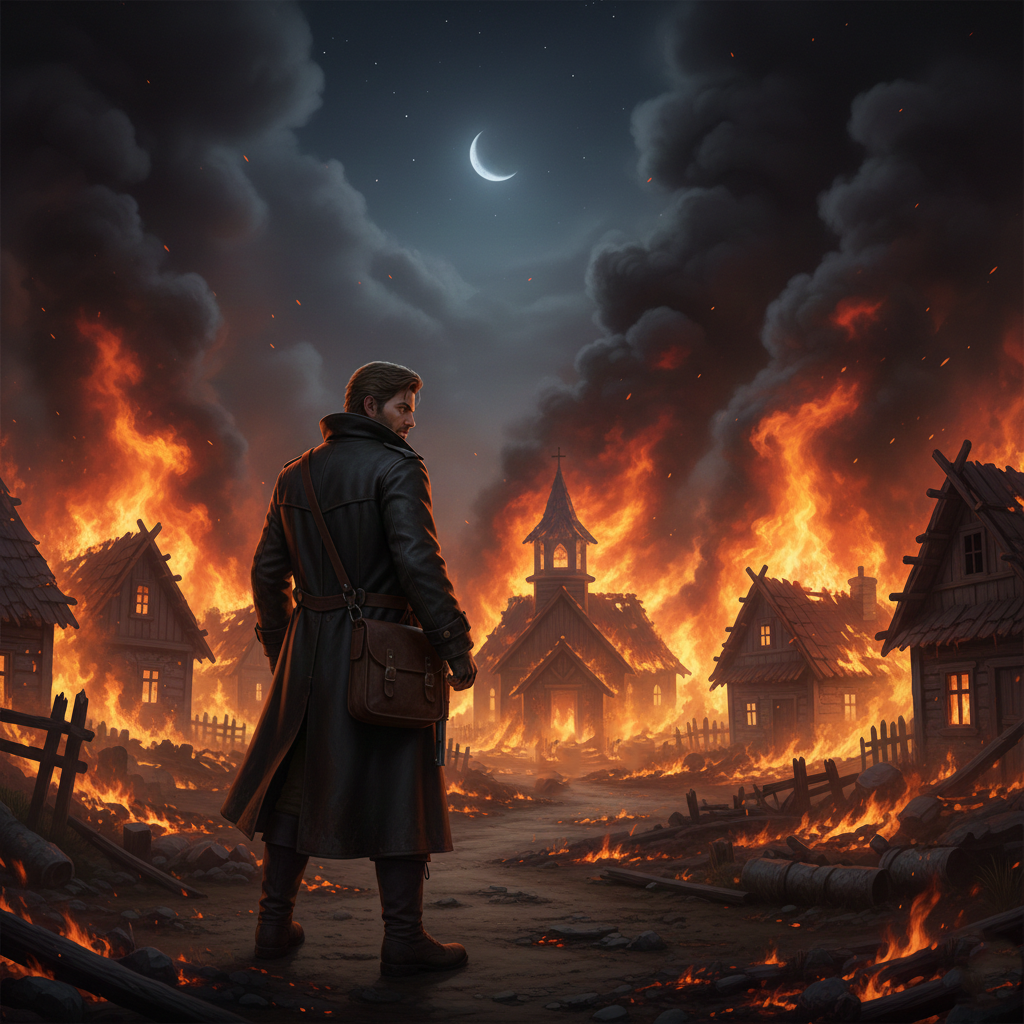
Ini prompt yang saya gunakan:
Elias stands alone in front of the burning village. Elias is breathing heavily, his hands clenched into tight fists at his sides.
Elias looks at something just off-camera, something we cannot see. Elias says, in a low and dangerous voice, "I told you what would happen if you crossed that line."
Elias pauses for a second.
The camera zooms in close to his face. His face burns with anger, and he says, "I gave you my word, and I gave you a choice."
Perhatikan bahwa ini tidak menggunakan referensi @ karena saya tidak memakai mode Omni untuk video ini, hanya subject binding. Berikut hasilnya
Di sini, saya mencoba membuat adegan sitkom antar teman. Saya membuat tiga karakter, Alex, Jamie, dan Sam, menggunakan AI. Seperti sebelumnya, saya membuat beberapa pose berbeda untuk masing-masing.
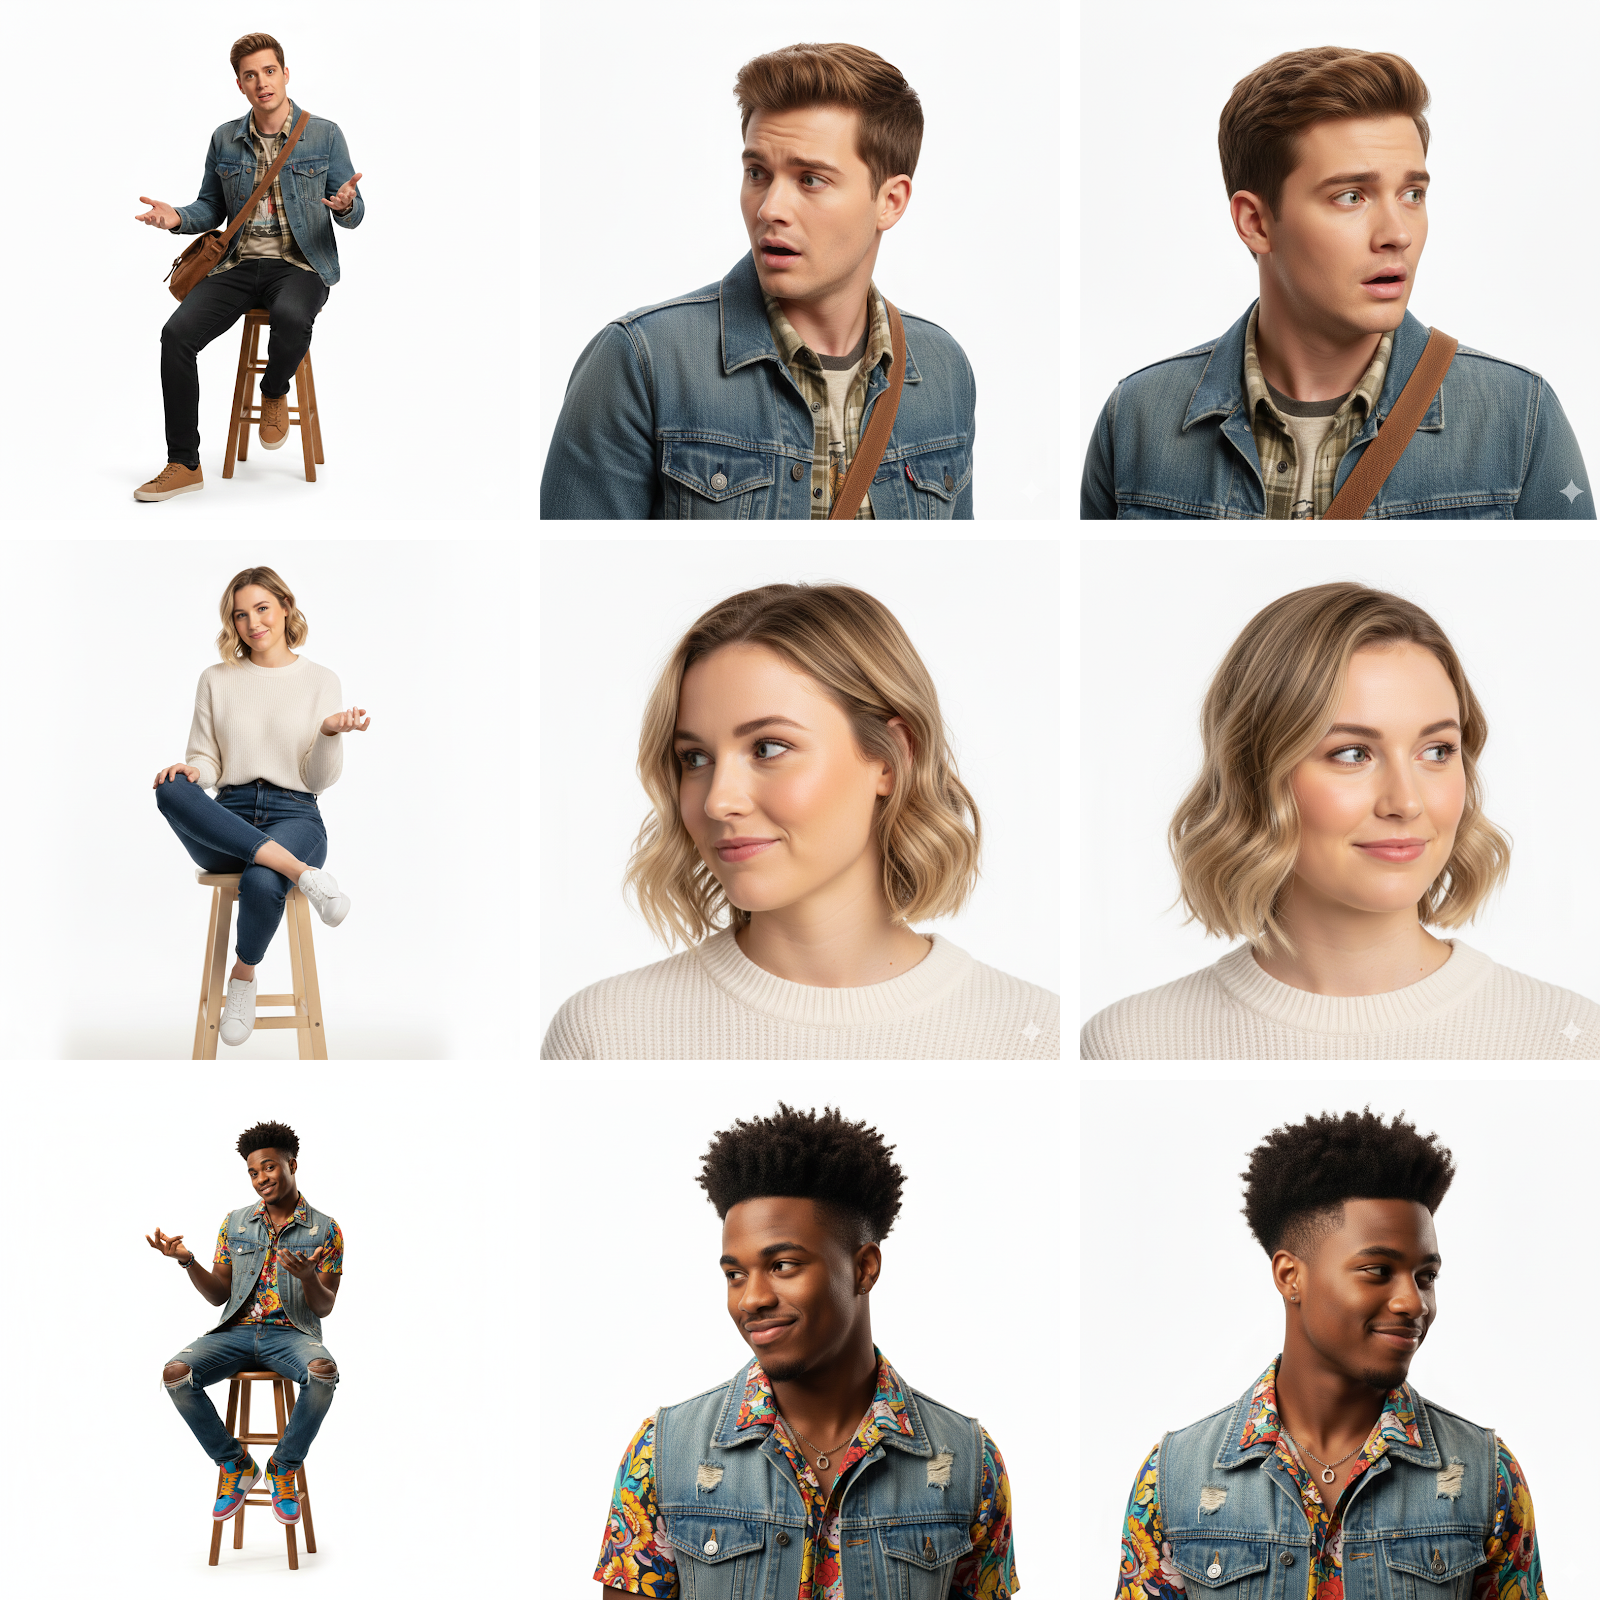
Saya juga membuat gambar untuk lokasi dan membuat elemen adegan dengannya.
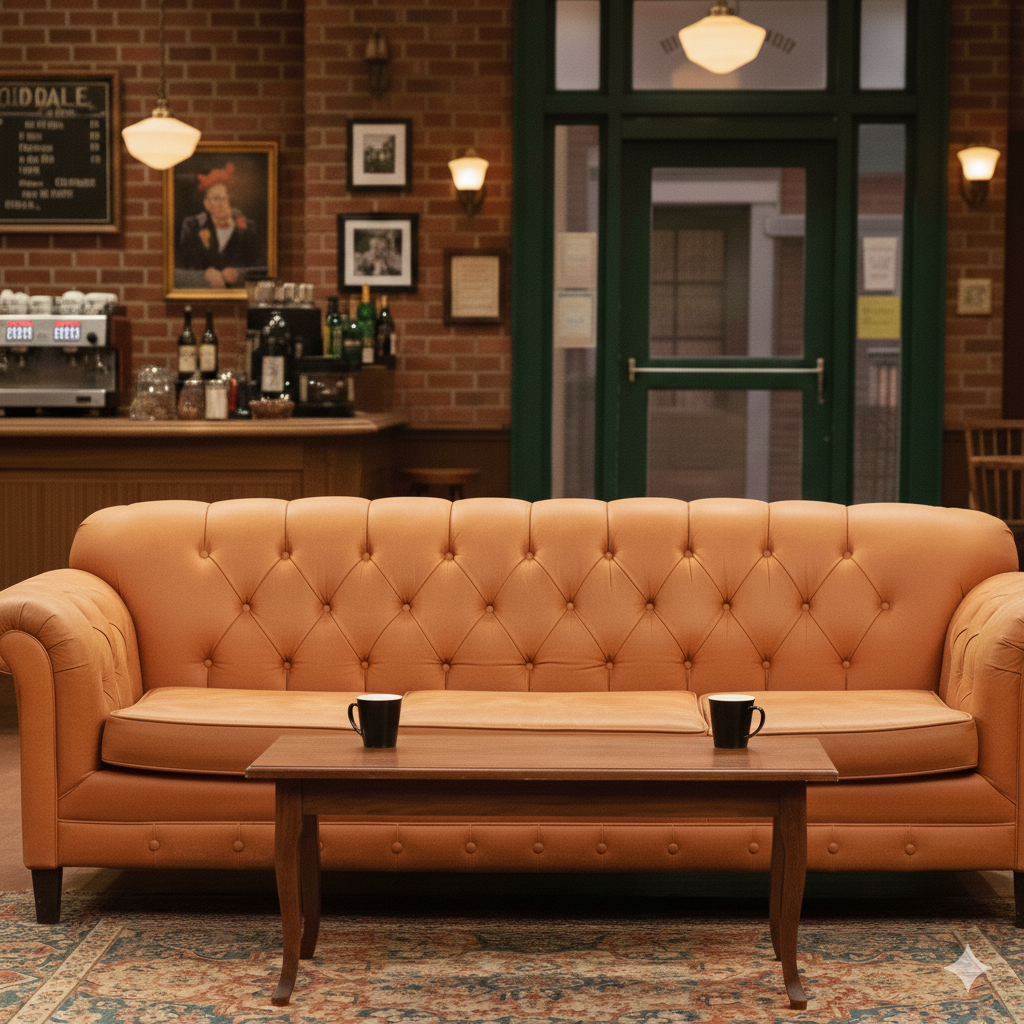
Ini prompt final yang saya gunakan. Saya memakai prompt teks untuk mendeskripsikan shot alih-alih fitur multi-shot mereka karena itu membatasi adegan hingga enam shot. Ternyata Kling 3.0 sepenuhnya mampu menangani ini juga.
Shot 1: Mid-shot, background @Image.
Shot 2: @Jamie and @Sam sit on the couch as @Alex rushes into the coffee shop and says, "I just liked my ex’s photo from 2016."
Shot 3: @Jamie turns to @Alex and says, "How bad?"
Shot 4: @Alex replies, "She’s with the guy she left me for."
Shot 5: Camera focuses on @Sam, and he replies, "Delete it, dude!"
Shot 6: @Alex replies, "I did, but what if she saw?"
Shot 7: @Sam says, "Then act confident, like her wedding photo."
Shot 8: @Jamie laughs, and @Alex says, "I need new friends..."
Dan ini hasilnya:
Kita dapat melihat beberapa kesalahan pada video:
Namun, terlepas dari itu, saya menilai hasilnya sangat mengesankan. Karakter terasa hidup dan autentik, dan secara keseluruhan, alur adegan cukup baik.
Pada contoh terakhir ini, saya mencoba menggunakan ulang karakter yang telah saya buat dalam konteks berbeda. Idenya adalah untuk merasakan seberapa konsisten mereka antar video guna melihat apakah gagasan membuat beberapa adegan dengan karakter yang sama layak dilakukan. Sebab jika karakter tetap terlihat dan terasa sama, maka saya benar-benar percaya Kling 3.0 bisa digunakan untuk menghasilkan konten berdurasi lebih panjang.
Dalam kasus ini, saya menggunakan fungsionalitas multi-shot untuk mendeskripsikan setiap shot. Berikut konfigurasi adegannya:
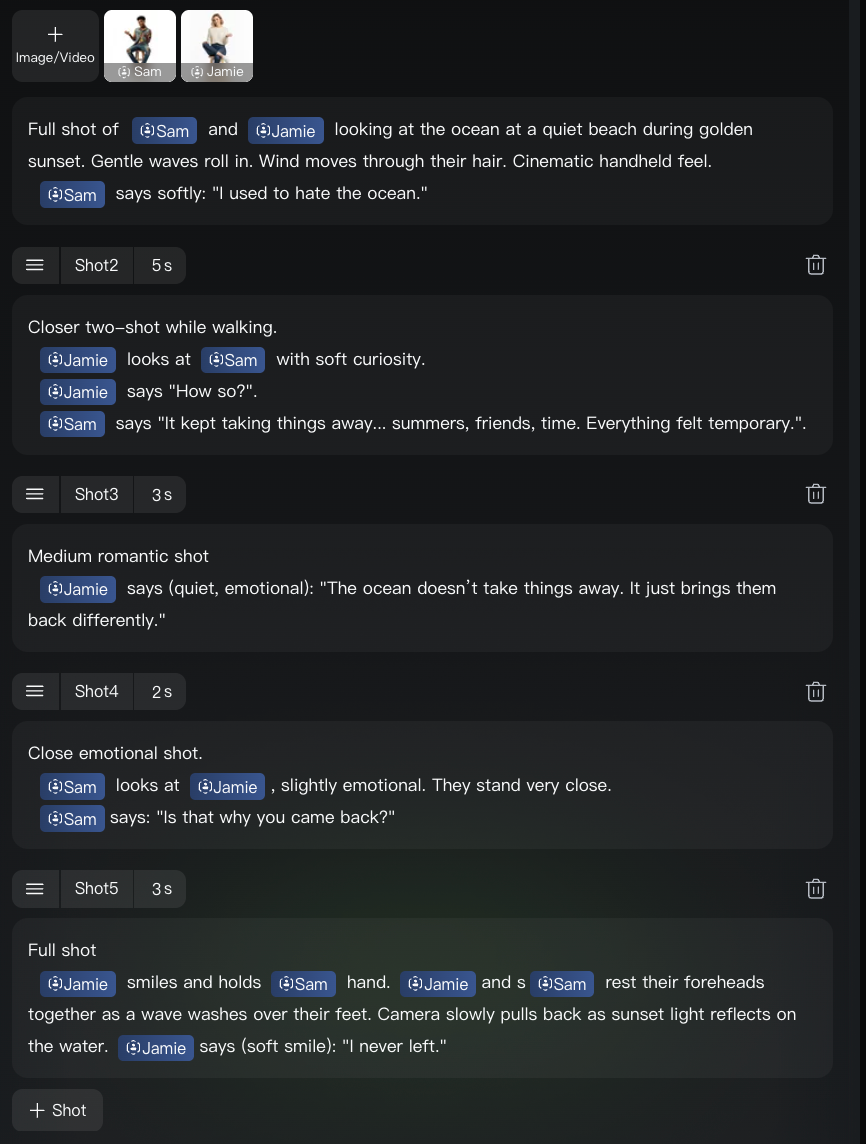
Ini video yang dihasilkan:
Kursus AI Generatif
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt