

简介
在构建机器学习模型时,您可能会忽略在生产环境中训练和服务模型所需的基础设施。对于端到端的机器学习工作流,管理所有应用、平台和资源方面的考量可能颇具挑战。
与传统的 Web 部署相比,机器学习应用有着不同的资源特征。例如,训练阶段资源密集,而推理阶段则轻量且快速。您还需要相应的工具和框架来运行这些环节。一个非常流行的开源框架,可用于制定端到端机器学习应用交付标准的便是Kubeflow。
什么是 Kubeflow?
Kubeflow 是一个开源项目,提供一套精心遴选的工具与框架。Kubeflow 的首要目标是让您轻松开发、部署与管理可移植、可扩展的机器学习工作流。
Kubeflow 构建于 Kubernetes 之上,Kubernetes 是一个用于运行与编排容器的开源平台。Kubernetes 可在不同环境中一致运行,这正是 Kubeflow 运作的关键。Kubeflow 的设计旨在让 Kubernetes 发挥所长,从而使您将精力专注于定义与运行 ML 工作流,包括管理数据、运行笔记本、训练模型与提供服务。
Kubeflow 源自 Google 的内部项目 TensorFlow Extended。它最初只是更简便地在 Kubernetes 上运行 TensorFlow 任务的方式,但随后扩展为一个支持多架构、多云的端到端机器学习工作流框架。
Kubeflow 与机器学习工作流
Kubeflow 为数据科学家和机器学习工程师提供了一个兼具两者优势的平台。数据科学家可以使用 Kubeflow 进行模型试验,并以最高效的方式在 Kubernetes 上编排实验。
机器学习工程师可以使用 Kubeflow 将 ML 系统部署到开发、测试与生产等各种环境中。
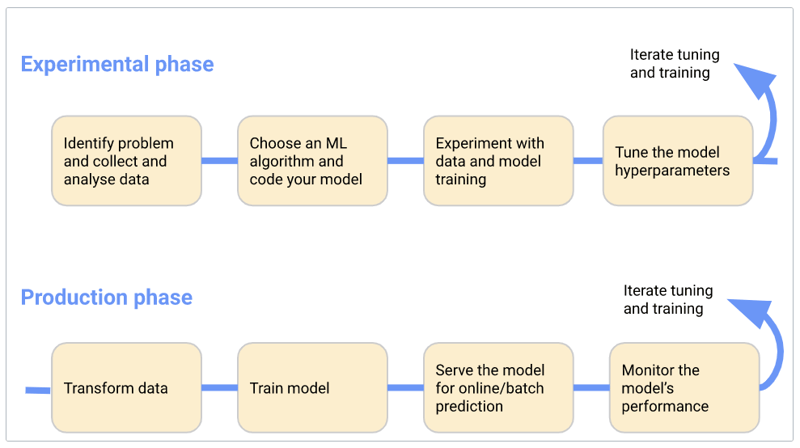
下图展示了机器学习项目中的两个不同阶段:(i)实验阶段 和(ii)生产阶段。
Kubeflow 拥有众多组件,几乎覆盖下述流水线的所有步骤。例如,对于模型超参数调优,Kubeflow 提供名为“Katib”的组件。我们将在本教程后文讨论 Kubeflow 的关键组件。
安装 Kubeflow
有两种方式可以开始使用 Kubeflow:
- 通过打包发行版安装(简单直观)。
- 通过清单(manifests)安装(进阶)。
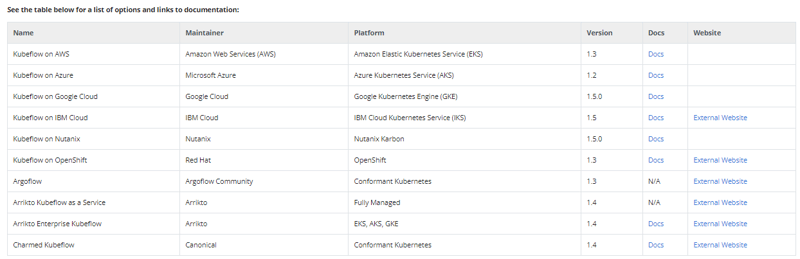
打包发行版由相应维护者开发与支持。例如,Azure 上的 Kubeflow 由微软维护。完整发行版列表见下表:
Kubeflow 的三大原则
可组合性
可组合性是一种处理组件相互关系的系统设计原则。Kubeflow 具有很高的可组合性,因此如有需要,您可以在流水线的不同部分轻松使用不同版本的 TensorFlow。
可移植性
可移植性意味着只要运行 Kubeflow,您就可以在任何地方运行整个机器学习项目。它与平台无关,并为用户抽象掉所有复杂性。您只需编写一次代码,Kubeflow 会处理抽象,让您既可在笔记本电脑上运行,也可在云端集群上运行。
可扩展性
可扩展性意味着您的项目在需要时可获取更多资源,在不需要时释放资源。不同环境可能配备不同的计算资源,如 CPU、GPU 和 TPU。
Kubeflow 组件
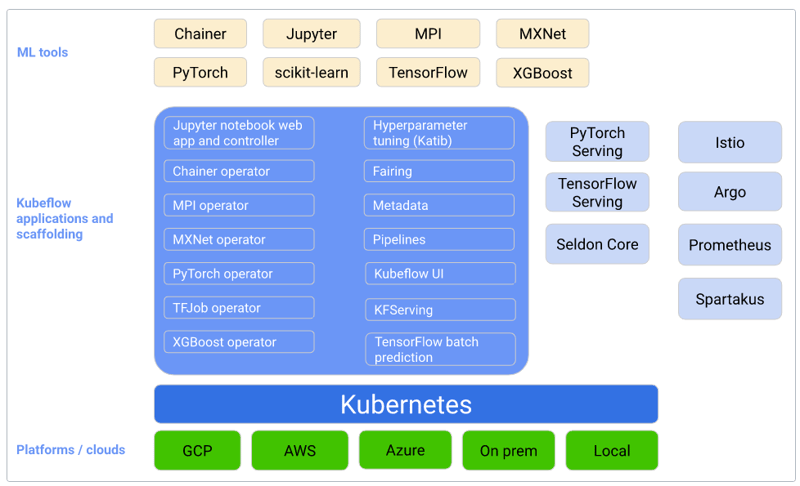
Kubeflow 组件是共同构成 Kubeflow 的逻辑模块。通常,在一个机器学习项目中您会用到一个或多个组件。
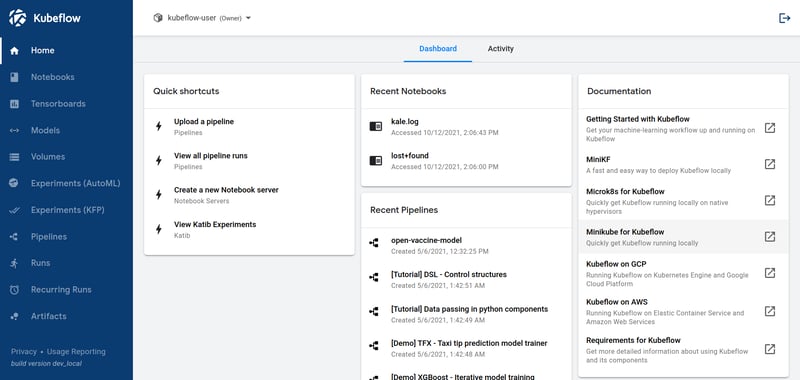
Dashboard
首先,中央仪表板可快速访问其他 Kubeflow 组件。一些实用组件包括:
Notebooks
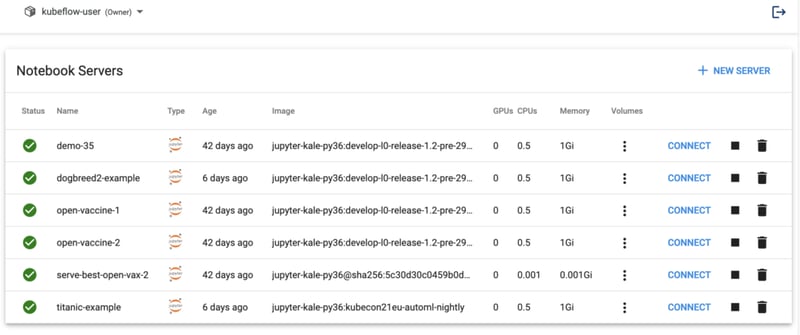
Kubeflow 集成了 Jupyter 笔记本环境。笔记本适用于快速测试、开发模型,甚至编写 ML 应用。
ML 工程师和数据科学家在本地运行笔记本并受限于资源的情况并不罕见。将笔记本运行在集群中,便于在资源可动态扩缩的环境里执行任务。
Pipelines
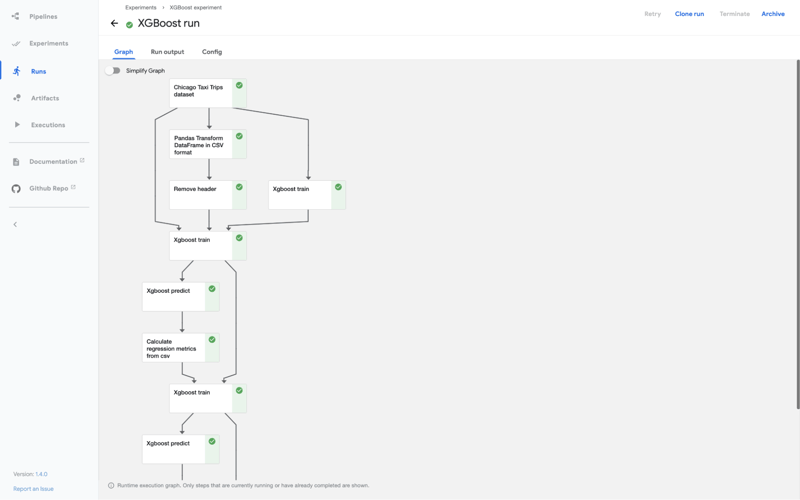
Kubeflow Pipelines 是一个强大的组件,用于基于 Docker 容器构建端到端、可移植且可扩展的机器学习流水线。
机器学习流水线由一系列步骤组成,能够处理从数据采集到模型服务的全过程。流水线中的每个步骤都是一个 Docker 容器,因此具备可移植性与可扩展性。每个步骤相互独立,便于您复用流水线组件。
在本教程中,我们将详细讲解 Kubeflow Pipelines 组件,并通过代码示例演示如何使用 Kubeflow 构建与执行机器学习流水线。
Katib
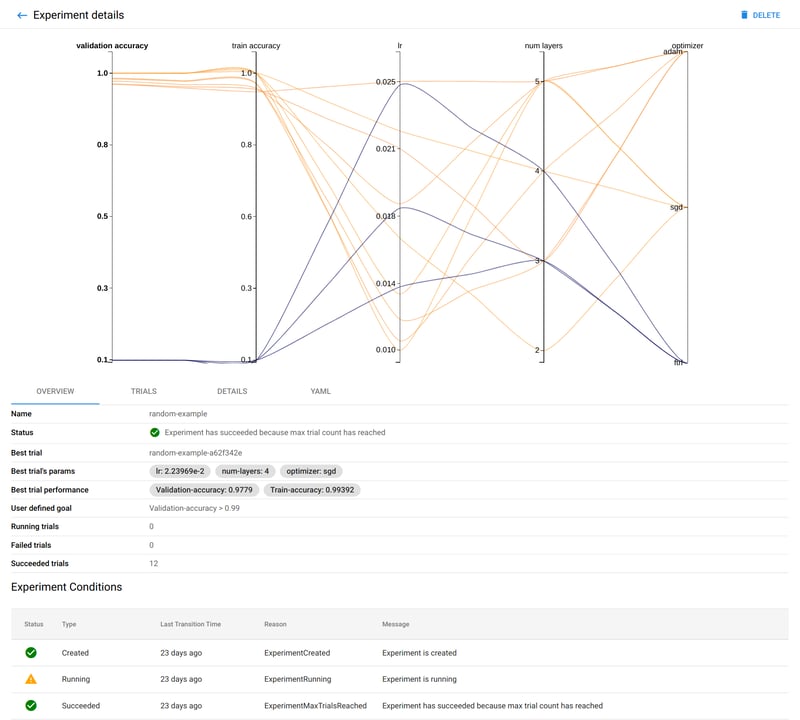
Katib 是 Kubeflow 的组件,旨在进行大规模自动化超参数调优。超参数调优在开发高质量模型中至关重要,手动搜索超参数空间往往耗时费力。
Katib 可围绕某个定义的指标(如 AUC 或 RMSE)优化超参数取值。它有助于找到并可视化最优配置,为模型上生产做准备。
Kubeflow 流水线
机器学习工作流可能包含许多步骤,从数据准备到模型训练与评估等。以临时方式跟踪这些步骤十分困难。
缺少合适工具时,实验记录和模型版本跟踪也是数据科学家需要克服的挑战。Kubeflow Pipelines 让数据科学家使用可组合、可共享、可复现的标准来开发机器学习工作流。
Kubeflow 是 Kubernetes 原生解决方案,帮助数据科学家在开发与云端扩展机器学习代码时采用纪律化的流水线思维。Kubeflow Pipelines 的最终目标是:
- 简化大规模机器学习流水线的编排
- 通过多租户实现更快的实验、可复现性与协作。Kubeflow 界面可用于创建群组并添加用户,进行访问控制。
- 可复用并对不同 ML 组件(流水线步骤)提供标准化。
使用 Kubeflow,您可以像搭积木一样构建端到端机器学习解决方案,而无需每次重建。Kubeflow 还支持执行监控、工作流调度、元数据记录与版本管理等功能。
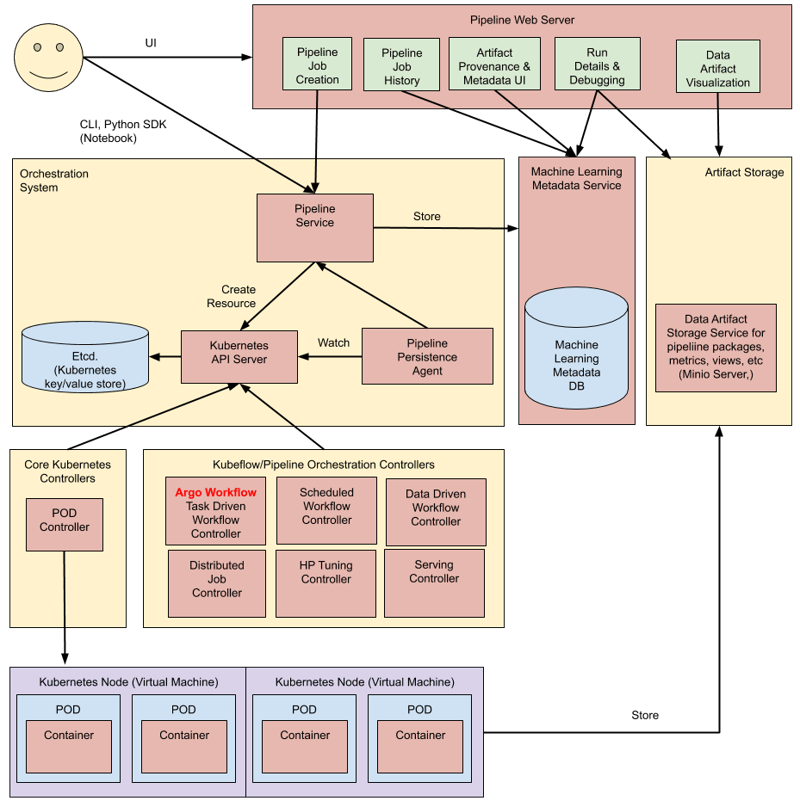
Kubeflow 流水线中的重要概念
Pipeline(流水线)
流水线是机器学习(ML)工作流中一系列定义清晰的步骤。流水线必须定义运行所需的输入(参数),以及各组件的输入与输出。流水线中的每个组件接收输入、进行处理,并将输出提供给下一个组件。
一个非常重要的概念是:Kubeflow 流水线中的每个步骤(组件)本质上都是一个 Docker 容器。执行流水线时,Kubeflow 会针对流水线中的组件启动一个或多个 Kubernetes Pod。Pod 随后启动 Docker 容器,进而执行您在组件中编写的代码。
Component(组件)
流水线组件是自包含的代码,执行机器学习工作流中的某一步骤,例如缺失值填补、数据缩放或模型拟合。
Kubeflow 流水线中的组件类似于函数。因此,每个组件都有名称、输入参数与输出。
流水线中的每个组件都必须打包为 Docker 镜像,以确保各步骤彼此独立,并使您能够在工作流不同部分混合搭配不同框架与工具。
Experiment(实验)
实验允许您以不同配置运行同一条流水线,并对结果进行比较与分析。在机器学习中,通常需要尝试不同参数以找出最佳方案。Kubeflow 流水线实验正是为此而设计。
Graph(图)
图是在 Kubeflow 界面中的可视化呈现。它展示某次流水线运行已执行或正在执行的步骤,并用箭头指示各步骤所代表的流水线组件之间的父子关系。
在 Kubeflow 中构建流水线的三种方式
现在您应已了解什么是 Kubeflow 流水线,以及为何使用该框架来在生产中设计与部署机器学习工作流。下面快速回顾使用 Kubeflow 构建与部署流水线的三种方式。
用户界面(UI)
您可以使用 Kubeflow 的界面来运行流水线、上传他人与您共享的流水线、查看运行的产物与输出,并安排自动化运行。以下是流水线界面的外观:
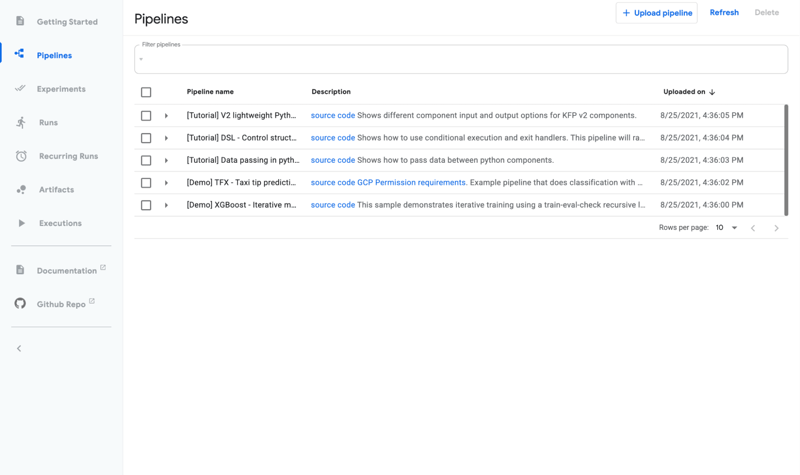
官方 Python SDK
Kubeflow 提供一组 Python 库,您可以以编程方式开发与执行 ML 流水线。这是使用 Kubeflow 流水线最常见的方式。
REST API
Kubeflow 还为持续集成/部署系统提供 REST API。设想一种场景:您希望将 Kubeflow 流水线的某些功能集成到企业的下游系统或流程中。
Kubeflow 流水线教程
开始使用 Kubeflow 的最简单方式是采用打包发行版,本质上类似云上的托管服务。这里,我们使用 GCP 上的 Kubeflow 服务。您可以参考这份官方指南,了解如何在 GCP 上部署该服务。
部署成功后,您可以通过 GCP 的端点访问该仪表板。
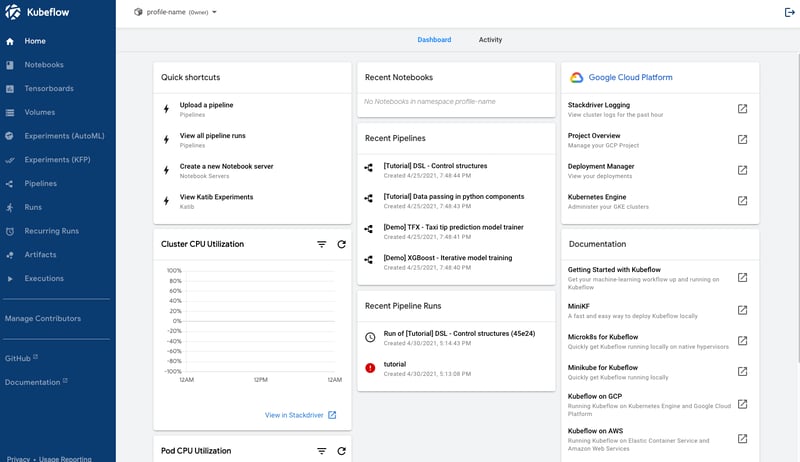
Kubeflow 仪表板 - 部署于 GCP
Kubeflow Pipelines 自带一些示例流水线。我们来试试一个用 Python 编写的基础数据预处理流水线。点击左侧工具栏中的流水线。
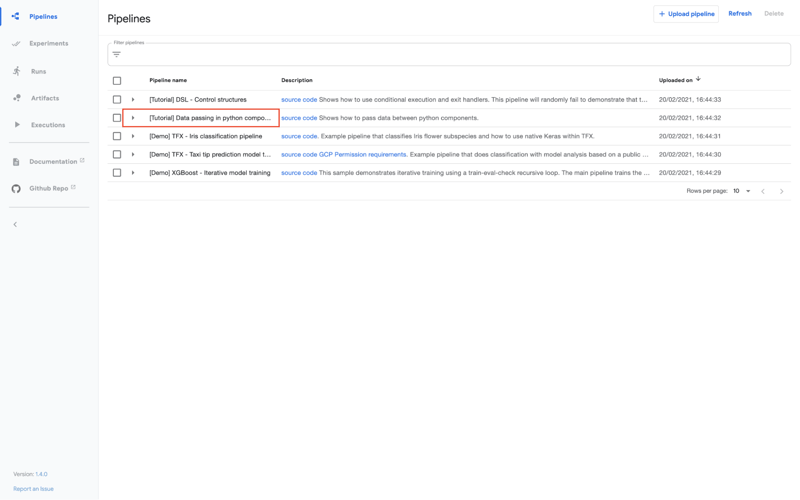
Kubeflow 流水线 - 部署于 GCP
点击“创建实验”:
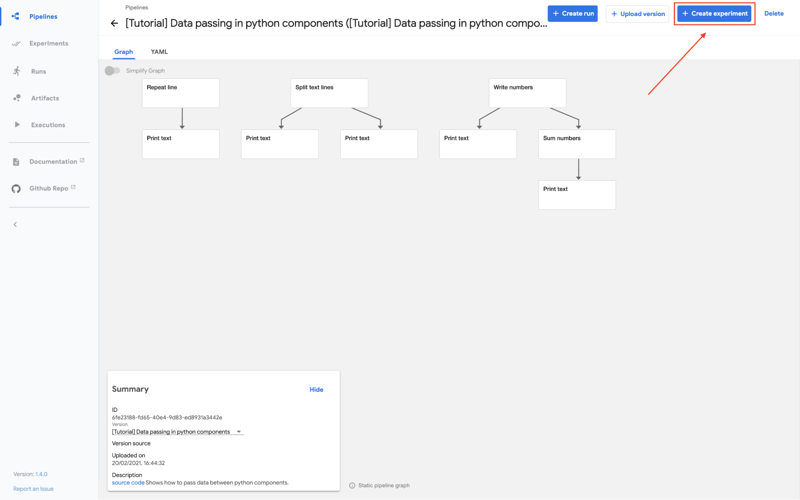
Kubeflow 流水线 - 部署于 GCP
按照提示操作,然后在运行页面点击开始按钮以运行流水线。
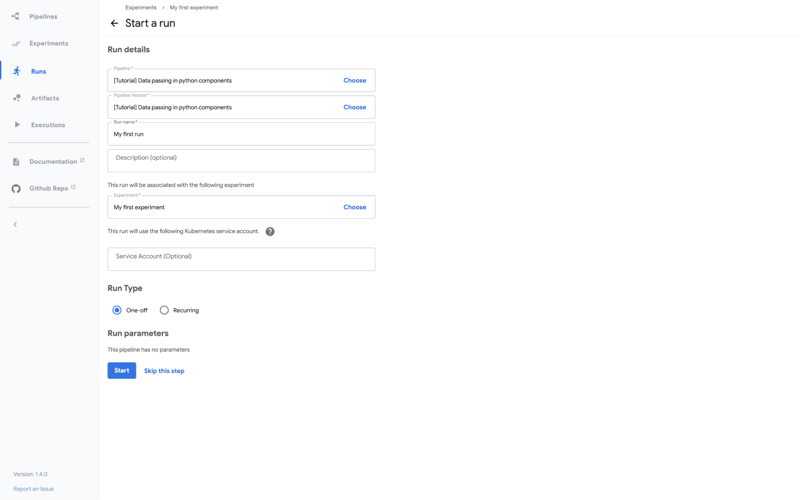
Kubeflow 流水线 - 部署于 GCP
实验会显示在仪表板中:
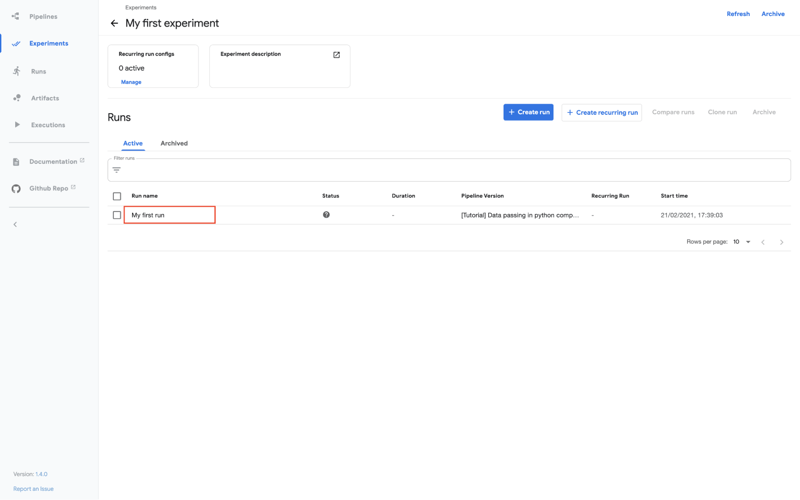
Kubeflow 流水线 - 部署于 GCP
运行完成后,点击该实验查看输出:
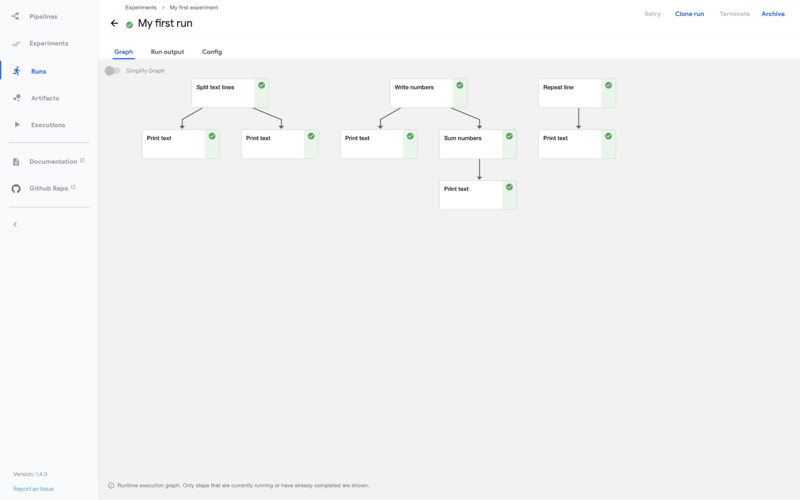
Kubeflow 流水线 - 部署于 GCP
现在您已经了解如何通过 Kubeflow 界面执行流水线。上述流水线中的每个组件都是一个简单、相互隔离的 Python 脚本。在上例中,步骤很简单,如“打印文本”或“求和”。
我们来看一个更复杂的示例,展示如何在 Python 中编写并编译这些组件。
通过 Python SDK 构建 Kubeflow 流水线
在本示例中,我们将创建一个包含两个组件的 Kubeflow 流水线:
- 根据作为输入传入的 URL 下载压缩的 tar 文件,
- 提取所有 csv 文件,并使用 `pd.concat` 函数创建单个 pandas 数据帧。
从理论上讲,我们也可以不将流水线拆分为两个步骤,而是创建一个函数,接收 URL,下载压缩文件,然后将所有 csv 合并为一个文件。
不过,将其拆分为两步的好处在于:您可以创建一个专门下载压缩文件的步骤,并在其他项目中复用它。
在 Kubeflow 中,您可以将组件定义为 yaml 文件,并使用 `kfp.components.load_component_from_url` 函数直接从 URL 加载组件。
第一步,我们从这个开源URL加载组件。
```
web_downloader_op = kfp.components.load_component_from_url(
'https://raw.githubusercontent.com/kubeflow/pipelines/master/components/web/Download/component-sdk-v2.yaml')
```第二步,我们定义一个 Python 函数:
```
@component(
packages_to_install=['pandas==1.1.4'],
output_component_file='component.yaml'
)
def merge_csv(tar_data: Input[Artifact], output_csv: Output[Dataset]):
import glob
import pandas as pd
import tarfile
tarfile.open(name=tar_data.path, mode="r|gz").extractall('data')
df = pd.concat(
[pd.read_csv(csv_file, header=None)
for csv_file in glob.glob('data/*.csv')])
df.to_csv(output_csv.path, index=False, header=False)
```如您所见,该函数使用了 `kfp.dsl.component` 装饰器。我们可以通过该装饰器定义容器镜像、任何包依赖(本例为 pandas[1.1.4]),以及保存组件规范的位置(component.yaml)。
现在,您可以使用 `pipeline` 运算符将这两个组件在流水线中串联起来。
定义一条流水线并从组件创建任务:
@dsl.pipeline(
name='my-pipeline',
# You can optionally specify your own pipeline_root
# pipeline_root='gs://my-pipeline-root/example-pipeline',
)
def my_pipeline(url: str):
web_downloader_task = web_downloader_op(url=url)
merge_csv_task = merge_csv(tar_data=web_downloader_task.outputs['data'])
# The outputs of the merge_csv_task can be referenced using the
# merge_csv_task.outputs dictionary: merge_csv_task.outputs['output_csv']
```定义好流水线后,我们可以对其进行编译。有两种编译方式。第一种是通过 Kubeflow 界面。
```
kfp.compiler.Compiler(mode=kfp.dsl.PipelineExecutionMode.V2_COMPATIBLE).compile(
pipeline_func=my_pipeline,
package_path='pipeline.yaml')
```现在我们可以使用 Kubeflow 流水线的用户界面上传并运行这个 `pipeline.yaml` 文件。或者,也可以通过 Kubeflow 流水线的 SDK 客户端运行该流水线。
```
client = kfp.Client()
client.create_run_from_pipeline_func(
my_pipeline,
mode=kfp.dsl.PipelineExecutionMode.V2_COMPATIBLE,
# You can optionally override your pipeline_root when submitting the run too:
# pipeline_root='gs://my-pipeline-root/example-pipeline',
arguments={
'url': 'https://storage.googleapis.com/ml-pipeline-playground/iris-csv-files.tar.gz'
})
```如果我们需要将该流水线扩展为包含机器学习模型,我们将创建一个接收 `Input[Dataset]` 的 Python 函数,并使用任意所需的框架(例如 sklearn、TensorFlow 或 PyTorch)来拟合模型。
函数创建完成后,我们需要编辑 `my_pipeline` 函数以加入第三个任务,然后使用 `kfp.Client` 或界面重新编译流水线。
教程改编自Kubeflow 官方文档。
结论
在 Jupyter Notebook 中对几百万行数据进行试验是一回事;在云端远程对数十亿行数据训练模型则是另一回事。当涉及在可扩展、分布式环境中训练大模型时,机器学习的难度会显著提升。
Kubernetes 是最流行、应用最广泛的机器学习任务编排框架之一;而 Kubeflow 则是在 Kubernetes 之上构建的框架,为用户抽象掉大量复杂细节。不过需要注意的是,它并非唯一选择。与其他领域一样,也存在替代方案。
此类平台的一个例子是Databricks。它拥有自己的专有编排引擎(不同于 Kubernetes),并配备美观的界面,支持笔记本、实验记录、模型注册、作业调度与监控。
Amazon Sagemaker 也是 Kubernetes / Kubeflow 的另一种替代方案。Amazon SageMaker 是一项全托管的机器学习服务,数据科学家和开发者可以用它快速、轻松地构建与训练机器学习模型,并将其直接部署到生产就绪的托管环境中。它提供集成的 Jupyter Notebook 环境,用于探索与分析。
是否被不断演进的工程概念所淹没?别担心,Datacamp 提供Understanding Data Engineering 课程。在本课程中,您将了解数据工程师的核心职责、他们与数据科学家的不同之处,以及他们如何促进数据在组织内的流动。此外,您还将学习数据工程师如何为数据科学家铺设道路,使数据科学成为可能。无需编码!
Kubeflow 常见问答
Kubeflow 与 Kubernetes 有何区别?
Kubernetes 是一个开源的容器编排系统,用于自动化软件的部署、扩缩与管理。另一方面,Kubeflow 是一个开源项目,包含一套精选的工具与框架,旨在让您能够在 Kubernetes 上轻松开发、部署与管理可移植、可扩展的机器学习工作流。Kubeflow 构建于 Kubernetes 之上。
Kubeflow 是 Kubernetes 的一部分吗?
不,Kubeflow 是一个独立的库。您可以像安装其他 Python 库一样,通过 pip install 进行安装。
Kubeflow 是开源框架吗?
是的,Kubeflow 完全开源,并以 Apache-2.0 许可协议提供。
Airflow 与 Kubeflow 有何区别?
Apache Airflow 是通用的任务编排平台,而 Kubeflow 专注于机器学习任务。两者都允许使用 Python 定义任务,但 Kubeflow 主要在 Kubernetes 上运行任务。
Kubeflow 与 MLFlow 有何不同?
它们是两个截然不同的开源框架。Kubeflow 是一个容器编排系统,使您能够在 Kubernetes 上轻松开发、部署与管理可移植、可扩展的机器学习工作流;而 MLFlow 是用于实验跟踪与模型版本管理的库。