Curso
Introducción a Python
4 h
7M

Al crear un modelo de machine learning, es fácil olvidarse de la infraestructura necesaria para entrenar y servir el modelo en producción. En los flujos de trabajo de machine learning de extremo a extremo, puede resultar complejo gestionar todos los aspectos de aplicación, plataforma y recursos.
En comparación con los despliegues web convencionales, las aplicaciones de machine learning tienen otras necesidades. Por ejemplo, la fase de entrenamiento consume muchos recursos, mientras que la de inferencia es ligera y rápida. También necesitarás herramientas y frameworks para ejecutar todas estas piezas. Un framework open source muy popular que permite estandarizar la entrega de aplicaciones de machine learning de extremo a extremo es Kubeflow.
Kubeflow es un proyecto open source que reúne un conjunto seleccionado de herramientas y frameworks. Su objetivo principal es facilitar el desarrollo, despliegue y gestión de flujos de trabajo de machine learning portables y escalables.
Kubeflow se construye sobre Kubernetes, una plataforma open source para ejecutar y orquestar contenedores. Kubernetes está diseñado para ejecutarse de forma consistente en distintos entornos, lo que es clave para el funcionamiento de Kubeflow. Kubeflow deja que Kubernetes haga lo que mejor sabe hacer y te permite centrarte en definir y ejecutar flujos de trabajo de ML, incluyendo la gestión de datos, la ejecución de notebooks, el entrenamiento de modelos y su puesta en servicio.
Kubeflow evolucionó a partir de un proyecto interno de Google llamado TensorFlow Extended. Empezó como una forma sencilla de ejecutar trabajos de TensorFlow en Kubernetes, pero desde entonces se ha ampliado hasta convertirse en un framework multiarquitectura y multicloud para ejecutar flujos de trabajo de machine learning de extremo a extremo.
Kubeflow es una plataforma para data scientists y ML engineers que combina lo mejor de ambos mundos. Los data scientists pueden usar Kubeflow para experimentar con modelos de ML y orquestar sus experimentos en Kubernetes de la forma más eficiente.
Los ML engineers pueden usar Kubeflow para desplegar sistemas de ML en distintos entornos de desarrollo, pruebas y producción.
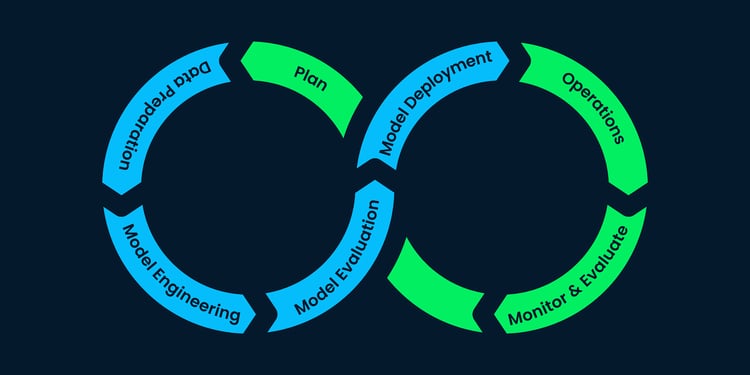
El diagrama siguiente muestra dos fases distintas en un proyecto de machine learning: (i) la fase experimental y (ii) la fase de producción.
Kubeflow incluye muchos componentes para cubrir prácticamente todos los pasos del pipeline de abajo. Por ejemplo, para el ajuste de hiperparámetros, Kubeflow cuenta con un componente llamado "Katib". Más adelante veremos los componentes clave de Kubeflow.

Kubeflow - Machine Learning Workflow
Tienes dos formas de empezar a usar Kubeflow:
Las distribuciones empaquetadas las desarrollan y mantienen sus respectivos responsables. Por ejemplo, Kubeflow en Azure lo mantiene Microsoft. Puedes ver la lista completa de distribuciones en la tabla siguiente:

Kubeflow Packaged Distributions
La composabilidad es un principio de diseño que aborda cómo se relacionan los componentes entre sí. Kubeflow es altamente composable, así que puedes usar distintas versiones de TensorFlow para diferentes partes de tu pipeline de machine learning si lo necesitas.
La portabilidad significa que puedes ejecutar tu proyecto de machine learning dondequiera que tengas Kubeflow. Es agnóstico de plataforma y oculta la complejidad al usuario. Solo tienes que escribir tu código una vez y Kubeflow se encarga de la abstracción para que puedas ejecutarlo en tu portátil o en un clúster en la nube.
La escalabilidad implica que tu proyecto acceda a más recursos cuando los necesita y los libere cuando no. Cada entorno puede tener diferentes recursos de cómputo como CPUs, GPUs y TPUs.

Los componentes de Kubeflow son bloques lógicos que, en conjunto, conforman Kubeflow. En un proyecto de machine learning, normalmente utilizarás uno o varios de estos componentes.
Por encima de todo, el panel central ofrece acceso rápido al resto de componentes de Kubeflow. Algunos de los más útiles son:

Kubeflow incluye un entorno integrado de notebooks Jupyter. Los notebooks son útiles para hacer pruebas rápidas, desarrollar modelos e incluso escribir aplicaciones de ML.
Es habitual que ML engineers y data scientists ejecuten sus notebooks en local y se vean limitados por los recursos. Tener los notebooks en el clúster facilita ejecutar trabajos donde los recursos pueden escalarse de forma dinámica.

Kubeflow Pipelines es un componente potente para crear pipelines de machine learning portables y escalables de extremo a extremo basados en contenedores Docker.
Un Machine Learning Pipeline es un conjunto de pasos capaz de abarcar desde la recogida de datos hasta el servicio de modelos. Cada paso del pipeline es un contenedor Docker, por lo tanto es portable y escalable. Además, cada paso es independiente, lo que permite reutilizar componentes del pipeline.

En este tutorial, vamos a profundizar en el componente Kubeflow Pipelines y veremos un ejemplo de código para crear y ejecutar un pipeline de machine learning con Kubeflow.
Katib es un componente de Kubeflow diseñado para el ajuste automatizado de hiperparámetros a gran escala. El ajuste de hiperparámetros es clave para desarrollar buenos modelos, ya que buscar manualmente en el espacio de hiperparámetros puede requerir mucho esfuerzo.
Katib te ayuda a optimizar los valores de hiperparámetros en torno a una métrica definida (como AUC o RMSE). Es una forma práctica de encontrar y visualizar la configuración óptima para preparar tu modelo para producción.

Un flujo de trabajo de machine learning puede incluir muchos pasos, desde la preparación de datos hasta el entrenamiento y la evaluación del modelo, entre otros. Es difícil llevar el control de todo esto de forma improvisada.
El registro de experimentos y el versionado de modelos sin las herramientas adecuadas es otro reto para los data scientists. Kubeflow Pipelines permite desarrollar flujos de ML usando estándares composables, compartibles y reproducibles.
Kubeflow es una solución nativa de Kubernetes que ayuda a los data scientists a adoptar una mentalidad de pipeline disciplinada al desarrollar código de ML y escalarlo en la nube. Los objetivos principales de Kubeflow Pipelines son:
Con Kubeflow puedes crear soluciones de machine learning de extremo a extremo sin reconstruir cada vez, como si fueran piezas de Lego. Kubeflow también ofrece monitorización de la ejecución, planificación de workflows, registro de metadatos y versionado.

Kubeflow Architectural overview
Un pipeline es una secuencia de pasos claramente definidos en un flujo de trabajo de machine learning (ML). El pipeline debe definir los inputs (parámetros) necesarios para su ejecución y los inputs y outputs de cada componente. Cada componente recibe una entrada, la procesa y entrega la salida al siguiente componente.
Un concepto clave aquí es que cada paso (componente) de un pipeline de Kubeflow es, básicamente, un contenedor Docker. Al ejecutar un pipeline, Kubeflow lanza uno o más Pods de Kubernetes correspondientes a los componentes. Los pods inician el contenedor Docker que, a su vez, ejecuta el código que has escrito en el componente.
Un componente de pipeline es un bloque de código autocontenido que realiza un paso del flujo de ML, como imputación de valores perdidos, escalado de datos o ajuste de un modelo de machine learning.
Un componente en un pipeline de Kubeflow se parece a una función. Por tanto, cada componente tiene un nombre, parámetros de entrada y una salida.
Cada componente del pipeline debe empaquetarse como una imagen Docker para que cada paso sea independiente del resto y puedas combinar distintos frameworks y herramientas en diferentes partes de tus flujos de ML.
Un experimento te permite ejecutar diferentes configuraciones del mismo pipeline y comparar y analizar los resultados. En machine learning, es habitual probar distintos parámetros para ver cuál funciona mejor. El experimento de Kubeflow Pipelines está pensado para eso.
Un grafo es una representación visual en la interfaz de Kubeflow. Muestra los pasos que un run del pipeline ha ejecutado o está ejecutando, con flechas que indican las relaciones padre/hijo entre los componentes representados por cada paso.
Ahora que tienes claro qué son los pipelines de Kubeflow y sus ventajas para diseñar y desplegar flujos de ML en producción, veamos tres formas de crear y desplegar pipelines con Kubeflow.
Puedes usar la UI de Kubeflow para ejecutar pipelines, subir pipelines que alguien haya compartido contigo, ver artefactos y salidas de las ejecuciones y programar ejecuciones automáticas. Así se ve la interfaz de Pipelines:

Kubeflow ofrece un conjunto de librerías de Python para desarrollar y ejecutar programáticamente pipelines de ML. Esta es la forma más habitual de trabajar con Kubeflow Pipelines.
Kubeflow también proporciona APIs REST para sistemas de integración y despliegue continuo. Imagina un caso de uso en el que quieras integrar funcionalidades de Kubeflow Pipelines en sistemas o procesos corporativos aguas abajo.
La forma más sencilla de empezar con Kubeflow es usar una distribución empaquetada, básicamente un servicio gestionado en la nube. Aquí usamos el servicio de Kubeflow en GCP. Puedes seguir esta guía oficial para aprender a desplegar el servicio en GCP.
Una vez completado el despliegue, podrás acceder a este panel desde tu endpoint de GCP.

Kubeflow Dashboard - despliegue en GCP
Kubeflow Pipelines incluye algunos ejemplos. Probemos un pipeline básico de preprocesado de datos en Python. Haz clic en Pipelines en la barra lateral izquierda.

Kubeflow Pipelines - despliegue en GCP
Haz clic en crear experimento:

Kubeflow Pipelines - despliegue en GCP
Sigue los pasos y, en la pantalla de ejecución, pulsa el botón de inicio para lanzar el pipeline.

Kubeflow Pipelines - despliegue en GCP
El experimento aparecerá en el panel:

Kubeflow Pipelines - despliegue en GCP
Haz clic en el experimento para ver la salida cuando termine la ejecución:

Kubeflow Pipelines - despliegue en GCP
Ya sabes cómo ejecutar pipelines desde la UI de Kubeflow. Cada componente del pipeline anterior es un script de Python sencillo y aislado. En el ejemplo, los pasos son simples como "Print Text" o "Sum Numbers".
Veamos ahora un ejemplo más complejo de cómo programar y compilar estos componentes en Python.
En este ejemplo, crearemos un pipeline de Kubeflow con dos componentes:
En teoría, en lugar de dividir este pipeline en dos pasos, podríamos crear una única función que reciba la url, descargue el archivo comprimido y, después, fusione todos los csv en un único archivo.
Sin embargo, hacerlo en dos pasos tiene la ventaja de que puedes crear un paso para la descarga del archivo comprimido y reutilizarlo en otros proyectos.
En Kubeflow, puedes definir el componente como un archivo yaml y usar la función `kfp.components.load_component_from_url` para cargarlo directamente desde la url.
Para el primer paso, carguemos el componente desde esta url open source.
```

web_downloader_op = kfp.components.load_component_from_url(

    'https://raw.githubusercontent.com/kubeflow/pipelines/master/components/web/Download/component-sdk-v2.yaml')

```
Para el segundo paso, definimos una función de Python:
```

@component(

    packages_to_install=['pandas==1.1.4'],

    output_component_file='component.yaml'

)

def merge_csv(tar_data: Input[Artifact], output_csv: Output[Dataset]):

  import glob

  import pandas as pd

  import tarfile


  tarfile.open(name=tar_data.path, mode="r|gz").extractall('data')

  df = pd.concat(

      [pd.read_csv(csv_file, header=None)

       for csv_file in glob.glob('data/*.csv')])

  df.to_csv(output_csv.path, index=False, header=False)


```
Como ves, la función está decorada con la anotación `kfp.dsl.component`. Con esta anotación podemos definir la imagen del contenedor, las dependencias de paquetes (en este ejemplo pandas[1.1.4]) y la ubicación donde guardar la especificación del componente (component.yaml)
Ahora puedes enlazar estos dos componentes en un pipeline usando el operador `pipeline`.
Define un pipeline y crea una tarea a partir de un componente:
@dsl.pipeline(

    name='my-pipeline',

    # You can optionally specify your own pipeline_root

    # pipeline_root='gs://my-pipeline-root/example-pipeline',

)

def my_pipeline(url: str):

  web_downloader_task = web_downloader_op(url=url)

  merge_csv_task = merge_csv(tar_data=web_downloader_task.outputs['data'])

  # The outputs of the merge_csv_task can be referenced using the

  # merge_csv_task.outputs dictionary: merge_csv_task.outputs['output_csv']

```
Una vez definido el pipeline, podemos compilarlo. Hay dos formas de compilarlo. La primera es mediante la UI de Kubeflow.
```

kfp.compiler.Compiler(mode=kfp.dsl.PipelineExecutionMode.V2_COMPATIBLE).compile(

    pipeline_func=my_pipeline,

    package_path='pipeline.yaml')

```
Ahora podemos subir y ejecutar este archivo `pipeline.yaml` desde la interfaz de Kubeflow Pipelines. Alternativamente, podemos ejecutar el pipeline con el cliente del SDK de Kubeflow Pipelines.
```

client = kfp.Client()


client.create_run_from_pipeline_func(

    my_pipeline,

    mode=kfp.dsl.PipelineExecutionMode.V2_COMPATIBLE,

    # You can optionally override your pipeline_root when submitting the run too:

    # pipeline_root='gs://my-pipeline-root/example-pipeline',

    arguments={

        'url': 'https://storage.googleapis.com/ml-pipeline-playground/iris-csv-files.tar.gz'

    })

```
Si queremos ampliar este pipeline para incluir un modelo de machine learning, crearemos una función de Python que reciba `Input[Dataset]` y entrene el modelo con el framework que prefiramos, por ejemplo sklearn, TensorFlow o PyTorch.
Una vez creada la función, editamos `my_pipeline` para incluir la tercera tarea y recompilamos el pipeline usando `kfp.Client` o la UI.
Tutorial reproducido de Kubeflow Official.
Experimentar en un Jupyter Notebook con unos pocos millones de filas es una cosa. Entrenar un modelo de machine learning con miles de millones de filas de forma remota en la nube es otra muy distinta. El machine learning se complica de verdad cuando toca entrenar grandes modelos en entornos escalables y distribuidos.
Kubernetes es uno de los frameworks de orquestación más populares y extendidos para trabajos de machine learning; y Kubeflow es un framework construido sobre Kubernetes que abstrae gran parte de la complejidad para el usuario. Aun así, no es la única opción. Como en casi todo, existen alternativas.
Un ejemplo de este tipo de plataforma es Databricks. Tiene su propio motor de orquestación propietario (distinto de Kubernetes) y ofrece una interfaz muy cuidada con soporte para Notebooks, registro de experimentos, registro de modelos, planificación de jobs y monitorización.
Amazon Sagemaker es otro ejemplo como alternativa a Kubernetes / Kubeflow. Amazon SageMaker es un servicio de machine learning totalmente gestionado que data scientists y desarrolladores pueden usar para crear y entrenar modelos de forma rápida y sencilla y desplegarlos directamente en un entorno alojado listo para producción. Proporciona un entorno integrado de Jupyter Notebook para exploración y análisis.
¿Te sientes abrumado con tantos conceptos de ingeniería que no paran de evolucionar? Tranquilo, Datacamp ofrece el curso Understanding Data Engineering . En él aprenderás las responsabilidades clave de un data engineer, en qué se diferencia de un data scientist y cómo facilita el flujo de datos en una organización. Además, verás cómo los data engineers sientan las bases que hacen posible el trabajo de los data scientists. ¡No necesitas programar!
Cursos de Python y machine learning
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
blog
Matt Crabtree
14 min
blog
Natassha Selvaraj
15 min
blog
Abid Ali Awan
15 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Kevin Babitz
8 min